Por isso, começou a adotar DevOps na sua empresa. Mas como pode saber se isso está a melhorar os seus processos? É necessário medir o sucesso de alguma forma, o que pode fazer através da monitorização de algumas métricas essenciais de DevOps.
Existem muitas formas de avaliar a qualidade de um sistema ou aplicação, mas, neste artigo, vou concentrar-me nas métricas essenciais que ajudam a avaliar a qualidade dos seus processos. Ao acompanhar estes indicadores, pode obter informações mais aprofundadas sobre os seus pontos fortes e fracos, melhorar as suas práticas recomendadas de DevOps e tirar partido das ferramentas e do software certos para uma melhoria contínua.
Porque são importantes as métricas de DevOps?
Como referido acima, pode ser difícil definir objetivos e métricas partilhados para as equipas que implementam DevOps numa empresa. Sem métricas de DevOps, não haveria testes nem medições e não haveria melhorias no desenvolvimento. Seriam apenas iterações do mesmo software baseadas em palpites e ideias, lançando-o para o desconhecido e tentando depois algo novo. Sem feedback ou métricas de sucesso do produto para compreender o desempenho de algo, não existe uma direção.
Por exemplo, os departamentos financeiros querem manter os custos tão baixos quanto possível, enquanto os programadores querem manter o desempenho tão elevado quanto possível. Estes dois objetivos podem não estar alinhados, a menos que os riscos tenham sido avaliados e as equipas compreendam os objetivos umas das outras.
Enquanto os seus programadores podem optar por lançar um produto incompleto e lidar com isso mais tarde, o custo deste impacto origina dívida técnica. A implementação de DevOps pode alinhar os objetivos e as estratégias de ambas as equipas, e pode ajudar os seus programadores a compreender o impacto financeiro das suas decisões técnicas.
Esta é apenas uma pequena parte de DevOps e da importância de métricas partilhadas.
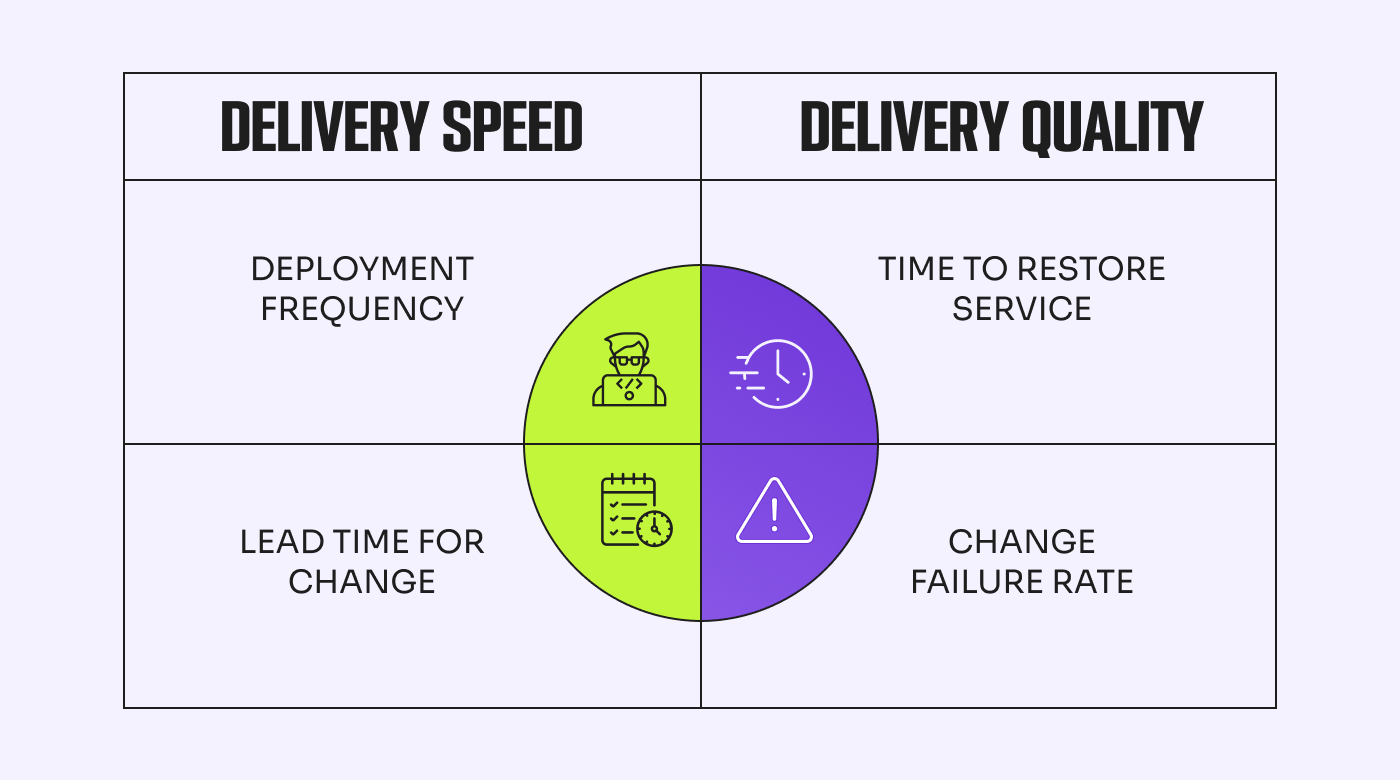
5 métricas essenciais de DevOps (DORA)
Implementar DevOps e compreender estruturas baseadas em princípios é uma coisa, mas é através das métricas de DevOps que começa realmente a perceber os benefícios desta abordagem colaborativa ao ciclo de vida do desenvolvimento de software. Tal como acontece com a maioria das estratégias empresariais, existem inúmeras métricas que pode escolher medir para promover o crescimento, dependendo do seu setor, público e objetivos.
A equipa de Investigação e Avaliação de DevOps (DORA) da Google Cloud é a equipa de investigação deste tipo com mais anos de atividade. Inicialmente, identificou quatro métricas essenciais para medir o desempenho das equipas de DevOps de nível «elite». No entanto, entretanto foi acrescentada uma quinta métrica essencial e a sua análise de agrupamento deteta apenas três níveis de equipas de DevOps: elevado, médio e baixo, sendo o nível «elite» algo do passado.
1. Frequência de implementação (DF)
A DF mede a frequência com que faz lançamentos com sucesso em produção. Esta métrica está relacionada com a consistência e é um excelente indicador da conclusão dos objetivos.
As equipas da categoria «elite» implementavam consistentemente em produção várias vezes por dia, enquanto as equipas com desempenho baixo faziam-no aproximadamente uma vez a cada seis meses.
Melhorar a DF é tão simples como lançar várias atualizações pequenas. A principal vantagem de o fazer é destacar quaisquer bloqueios de processos, estrangulamentos ou projetos complexos que exijam atenção. As equipas maiores podem preferir implementar em intervalos regulares através da criação de comboios de lançamento Ágil; isto ajudará a reduzir a sobrecarga causada por um ritmo extremo e por muitas pessoas.
2. Tempo de execução das alterações (LTC)
O LTC refere-se ao tempo necessário para que uma confirmação chegue à produção. Esta métrica é um bom indicador da capacidade de resposta e agilidade da equipa, uma vez que mede a rapidez com que esta consegue agir perante as necessidades e exigências dos utilizadores.
O antigo padrão de nível «elite» tinha como objetivo um LTC inferior a um dia, enquanto as equipas com desempenho inferior podiam demorar mais de seis meses. Um desempenho na extremidade inferior da escala de LTC deve-se provavelmente a processos ineficientes.
Pode melhorar esta métrica melhorando os processos de automatização, especialmente os testes. Ao melhorar o seu processo de integração contínua e o pipeline de entrega contínua (CI/CD), pode fazer chegar as atualizações à produção mais rapidamente. No entanto, há aqui um risco a que deve estar atento: a sustentabilidade. Se a sua equipa não conseguir manter este ritmo melhorado, poderá enfrentar uma má experiência do utilizador e potenciais vulnerabilidades de segurança.
3. Taxa de falhas das alterações (CFR)
CFR é a percentagem de implementações que causam uma falha em produção. A falha pode ser uma indisponibilidade, reversões ou uma degradação do serviço. Esta métrica mostra-lhe a eficácia da sua equipa ao implementar alterações.
Os valores de referência de desempenho de elite situam-se entre 0 e 15%, enquanto os níveis de desempenho alto, médio e baixo se encontram todos entre 16 e 30%.
Melhorar o CFR passa por privilegiar a qualidade em detrimento da quantidade. As empresas lançam números diferentes de alterações e, por isso, têm números diferentes de falhas. No entanto, as modificações da mais elevada qualidade resultarão em menos falhas, quer implementem alterações duas vezes por ano, quer duas vezes por dia.
4. Tempo médio de recuperação (MTTR)
O MTTR corresponde ao tempo que a sua equipa demora a restaurar o serviço após uma falha ou interrupção. Esta métrica não só mede a agilidade da sua equipa, como também é um bom indicador da estabilidade do seu software.
Se pretende atingir um nível de «elite», o MTTR deverá ser inferior a uma hora. As equipas com baixo desempenho podem demorar mais de seis meses.
Pode reduzir o MTTR ao privilegiar lançamentos pequenos e rápidos, tornando as falhas mais fáceis de encontrar e corrigir. Pode também explorar sinalizadores de funcionalidades para dar à sua equipa mais controlo — especialmente se forem experimentais.
Falta abordar mais uma métrica.
5. Fiabilidade
A quinta métrica de bónus é a fiabilidade. Esta métrica foi identificada mais tarde pela equipa DORA (2021), devido à medição anterior da disponibilidade como referência para software fiável. No entanto, decidiu-se que a fiabilidade engloba melhor a disponibilidade, a latência, o desempenho e a escalabilidade. Essencialmente, consiste em incluir a medição do desempenho operacional juntamente com o desenvolvimento.
Outras métricas comuns de DevOps
Have an account? Log In
Tempo de ciclo
O tempo de ciclo é o tempo total desde o início de uma tarefa até à entrega final. À primeira vista, acompanha a velocidade de trabalho da sua equipa. No entanto, pode analisar esta métrica mais profundamente para encontrar estrangulamentos, como tempos de espera longos e pedidos de integração que permanecem abertos durante muito tempo.
Um tempo de ciclo mais curto indica um fluxo de trabalho eficiente, reduzindo os estrangulamentos e aumentando a velocidade de desenvolvimento.
Como medir o tempo de ciclo
O tempo de ciclo é calculado acompanhando os carimbos de data e hora dos commits, das fusões de código e das implementações em ferramentas como o GitHub, o GitLab ou o Jenkins.
Tempo de ciclo = Tempo de implementação - Tempo do commit
Para melhorar o tempo de ciclo, as equipas devem:
- Otimizar os pipelines de CI/CD para uma integração e implementação mais rápidas.
- Automatizar as compilações e os testes.
- Melhorar a colaboração entre as equipas de desenvolvimento e operações.
- Reduzir as dependências entre tarefas para minimizar os estrangulamentos.
Tempo médio até à deteção (MTTD)
Este é o tempo médio que a sua equipa demora a reconhecer uma falha. Um MTTD baixo indica sistemas eficientes de monitorização e alertas, permitindo uma resposta e resolução rápidas dos incidentes.
Como medir o MTTD
O MTTD pode ser medido acompanhando o tempo médio entre a ocorrência de um problema e a sua deteção pelas ferramentas de monitorização ou através dos relatos dos utilizadores. Reduzir o MTTD implica melhorar a monitorização automatizada, aperfeiçoar os mecanismos de alerta e garantir a deteção proativa de problemas.
Testes automatizados aprovados
É recomendável procurar uma boa cobertura de testes, especialmente de testes automatizados. Neste caso, refiro-me a testes unitários, de integração, de interface do utilizador e de ponta a ponta. No entanto, uma boa cobertura não é suficiente para garantir a qualidade do software. O que importa é a percentagem destes testes que são aprovados.
Naturalmente, o objetivo é ter uma percentagem de testes aprovados tão próxima quanto possível dos 100%. A monitorização desta métrica também pode revelar com que frequência os novos desenvolvimentos interrompem testes existentes.
Como medir a percentagem de testes automatizados aprovados
O cálculo é uma simples percentagem: multiplique o número de testes aprovados por 100 e, em seguida, divida pelo número total de testes. Pode obter esta informação a partir da ferramenta de pipeline que executa as compilações (Jenkins, Azure DevOps, CircleCI, etc.).
O número pode ser um bom indicador da qualidade do produto. No entanto, também pode ser enganador se tiver testes instáveis ou pouco fiáveis.
Taxa de fuga de defeitos
A taxa de fuga de defeitos corresponde ao número de erros que não são detetados durante os testes e são lançados em produção — ou seja, quantos «escaparam». Esta métrica é ideal para acompanhar se pretende melhorar os processos de teste e de automatização.
Num mundo utópico, todas as nossas aplicações seriam isentas de defeitos. No entanto, raramente é esse o caso. Idealmente, os defeitos são detetados durante as fases de desenvolvimento e teste do processo de DevOps, e não em produção.
Esta métrica ajuda a determinar a eficácia dos processos de teste e a qualidade geral do programa. Uma taxa elevada de fuga de defeitos sugere que os procedimentos têm de ser melhorados e que é necessária mais automatização, enquanto uma taxa baixa (idealmente próxima de zero) implica uma aplicação de elevada qualidade.
Como medir a taxa de fuga de defeitos
Para medir este valor, pode utilizar a sua ferramenta de acompanhamento de erros e, para cada defeito aberto, registar onde foi detetado — no ambiente de teste ou de produção (ou em qualquer outro ambiente que possa estar a utilizar, como UAT).
Pedidos dos clientes
A satisfação dos clientes é um elemento impulsionador da inovação, e por boas razões: uma experiência de utilização sem falhas é um bom serviço ao cliente e, normalmente, corresponde a um aumento das vendas. Consequentemente, os pedidos dos clientes, especialmente durante o processo de escalonamento de pedidos, são um bom indicador do progresso da sua transição para DevOps.
Os clientes não devem desempenhar o papel de controlo de qualidade ao comunicar defeitos e erros. Por isso, uma diminuição dos pedidos dos clientes é um bom sinal do bom desempenho da aplicação.
Utilização da CPU e da memória
Identifica tendências na utilização de recursos.
Tempo de resposta
Mede o tempo que a aplicação demora a responder aos pedidos.
Taxa de erros
Acompanha o número de pedidos falhados ao longo do tempo.
Débito
Mede o número de pedidos processados por segundo.
Latência dos pedidos à API
Mede o atraso entre o envio de um pedido e a receção de uma resposta.
Desempenho das consultas à base de dados
Acompanha os tempos de execução das consultas e os possíveis estrangulamentos.
Análise do comportamento dos utilizadores
Monitoriza a adoção de funcionalidades e as tendências de envolvimento.
Tempo médio entre falhas (MTBF)
O MTBF mede o tempo médio decorrido entre falhas do sistema, períodos de inatividade ou incidentes. Esta métrica avalia a fiabilidade e a estabilidade dos seus sistemas de software, destacando a eficácia das suas estratégias de manutenção preventiva e mitigação de erros.
Tempo de mitigação (TTM)
O tempo necessário para corrigir um problema depois de este ser detetado corresponde ao TTM. Esta métrica ajuda a avaliar os processos de resposta e resolução de incidentes, indicando a eficiência das suas equipas na resolução e recuperação de problemas.
Tempo de execução da alteração (CLT)
O CLT fornece uma referência para o processo de implementação de alterações de ponta a ponta, incluindo o desenvolvimento, os testes, a revisão e a implementação. Um CLT mais curto significa ciclos de entrega mais rápidos e maior agilidade.
Como definir KPI com métricas de DevOps
Agora que compreende bem as métricas que pode utilizar para implementar e otimizar o DevOps na sua empresa, deverá explorar os principais indicadores de desempenho (KPI) para definir alguns objetivos e referências para a sua equipa.
Métricas vs. KPI
Pode estar a perguntar-se qual é a diferença entre métricas e KPI. Uma métrica é o que mede. É uma medição quantificável que fornece dados sobre um aspeto específico do desempenho. Nem todas as métricas estão necessariamente associadas a objetivos ou metas específicos.
Por outro lado, os KPI são um tipo de métrica selecionada e definida estrategicamente para refletir os aspetos mais críticos do desempenho e do progresso em direção aos objetivos estratégicos. Os KPI estão normalmente associados a objetivos e têm frequentemente metas, limiares ou referências associadas que devem ser alcançados.
Definir KPIs para a sua equipa de DevOps
O primeiro passo para definir KPIs para a sua equipa de DevOps é associar as métricas de DevOps à estratégia e aos objetivos da sua empresa. Ao dar prioridade às métricas mais essenciais a acompanhar, pode começar a estabelecer metas e referências para uma melhoria contínua. A seleção das métricas adequadas exige que tenha em consideração a dimensão, o produto e o mercado da sua empresa. Concentre-se no que fornecerá as informações mais úteis para a tomada de decisões, evitando a armadilha comum do excesso de métricas.
A monitorização dos seus KPIs é tão importante como a sua definição. Explore ferramentas de visualização de dados para fornecer à sua equipa dados em tempo real através de painéis intuitivos. Isto garante uma visibilidade completa, promove a responsabilização e permite que todos trabalhem em conjunto para alcançar objetivos comuns, alinhando as equipas de desenvolvimento e operações e apoiando a adoção e a maturidade de DevOps.
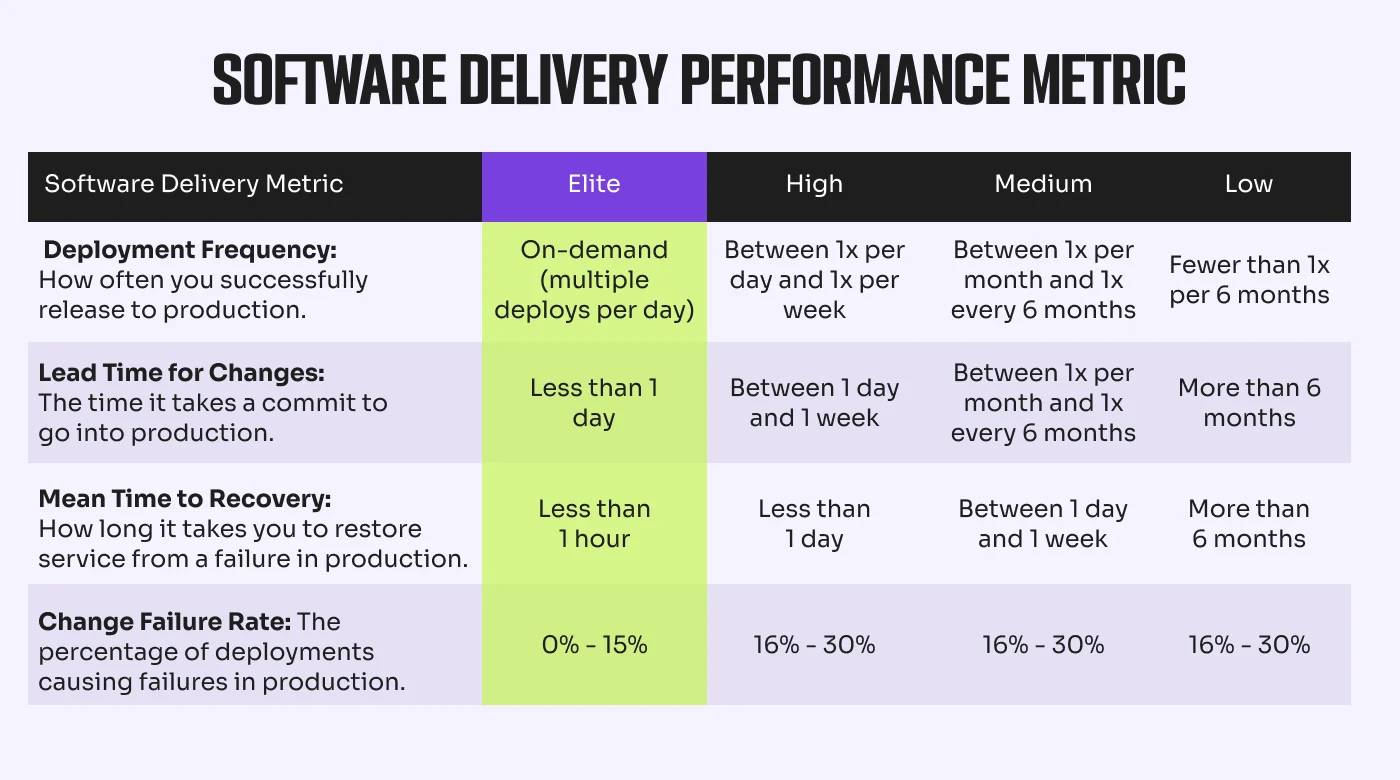
Ao analisar as métricas principais DORA, podemos ver as referências para cada métrica com base nas equipas de desempenho excecional, elevado, médio e baixo. Esta tabela pode ajudá-lo a definir KPIs para a sua própria empresa, dependendo do que considerar prioritário.
Ao definir os seus KPIs, é preferível analisar cuidadosamente a sua equipa e a sua empresa, sem as comparar com outras empresas. Se considerarmos a CFR como exemplo, a referência é a mesma para um desempenho elevado, médio e baixo. Isto dependerá em grande medida da frequência de implementação, mas também a poderá afetar no sentido inverso. Se a sua equipa passar todo o tempo a corrigir falhas, terá menos tempo para desenvolver e lançar atualizações. Os KPIs também podem mudar à medida que a sua equipa de DevOps amadurece. Processos de automatização e teste totalmente fiáveis devem significar automaticamente que pode elevar o nível das suas metas.
More Articles
Como utilizar as métricas de DevOps para crescer
Com o mercado global de DevOps a prever atingir 24,71 mil milhões de dólares até 2027 (uma taxa de crescimento anual composta de 22,9%, com base na dimensão do mercado de 10,84 mil milhões de dólares em 2023), encare isto como um sinal caso esteja à procura da melhor altura para começar a implementá-lo na sua empresa.
O DevOps não só acelera o desenvolvimento, reduzindo o tempo de colocação no mercado, como também melhora a colaboração ao eliminar compartimentos isolados, aumenta a qualidade através de testes contínuos e ciclos de retorno e utiliza os recursos de forma eficiente, o que permite poupar dinheiro. Por fim, é facilmente escalável, apoiando o crescimento da empresa para novos limites, com 83% dos responsáveis pela tomada de decisões de TI a obterem um maior valor empresarial através da implementação de DevOps em 2021.
Medição do desempenho e melhoria contínua
A monitorização do desempenho é fundamental para fazer crescer uma empresa que utiliza DevOps. Trata-se de uma abordagem dinâmica, com um fluxo de produção constante, pelo que a medição e os relatórios devem ser igualmente frequentes. As métricas de DevOps permitem acompanhar o desempenho dos seus processos de desenvolvimento e entrega. Ao quantificar aspetos fundamentais, como a frequência de implementação, o tempo de execução e a taxa de falhas de alterações, pode identificar estrangulamentos, ineficiências e áreas a melhorar. Isto permite-lhe otimizar frequentemente os fluxos de trabalho e os processos.
Acompanhar métricas como a taxa de falhas de alterações e o tempo médio de recuperação ajuda a identificar tendências que permitem detetar problemas numa fase inicial. Esta abordagem proativa significa que pode tomar medidas corretivas e minimizar o impacto nos clientes, proporcionando fiabilidade — outro ingrediente essencial para crescer mantendo uma elevada qualidade.
Por fim, a utilização de métricas de DevOps ajudará a amadurecer a sua equipa de DevOps, promovendo uma cultura de melhoria contínua. Os ciclos de retorno promovem a aprendizagem e o crescimento; deve haver sempre espaço para experimentar abordagens diferentes.
Que métricas de DevOps apoiam o crescimento da empresa?
Ao definir KPIs, a maioria das métricas deve ser considerada no contexto da sua equipa e orientada para o crescimento, em vez de ser comparada com outras empresas e grupos em diferentes níveis de maturidade.
Por exemplo, um LTC baixo pode mostrar que a sua equipa é eficiente, mas, se não conseguir manter o ritmo, tal não será sustentável e poderá acabar por afetar a experiência do utilizador. Esta métrica deve ser medida ao longo do tempo, em vez de definir um KPI que corresponda a uma equipa de DevOps madura, de elevado desempenho ou mesmo de desempenho excecional. Definir KPIs para reduzir o LTC mês após mês, trimestralmente ou anualmente demonstra crescimento dentro da sua equipa e da sua empresa.
O CFR é uma métrica valiosa porque nem todos têm o mesmo número de falhas ou problemas, mas, ao atribuir uma percentagem a isto, pode medir o sucesso das suas implementações. A sua equipa pode ter muito poucas falhas se lançar alterações com pouca frequência, mas, se cada lançamento causar um problema, o CFR será muito elevado. Se seguir práticas de CI/CD, poderá observar um número mais elevado de falhas, mas, se o seu CFR for baixo, terá uma vantagem, porque dispõe de velocidade e qualidade para apoiar o crescimento. O MTTR também deve ser medido ao longo do tempo para garantir um crescimento constante.
A DORA descobriu que as equipas de todos os níveis de desempenho no desenvolvimento obtiveram melhores resultados quando se concentraram no desempenho operacional. Isto pode significar definir KPIs para relatórios de incidentes ou pedidos em aberto, o tempo de atividade e a disponibilidade das aplicações.
Um número elevado de pedidos em aberto pode representar um problema com a satisfação dos seus clientes, mas procurar uma redução ao longo do tempo reflete um crescimento nesta área. Poderá aprofundar a análise e medir os tempos de resposta e de espera na fila para acelerar a melhoria desta métrica.
A métrica que combina integralmente o desenvolvimento e as operações enquanto equipa DevOps é o tempo de ciclo. Isto cria espaço para desenvolver uma cultura de feedback e crescimento. À medida que as outras métricas melhoram e a automatização amadurece, deverá esperar uma redução do tempo de ciclo. Se o seu serviço ao cliente for de elevada qualidade e as falhas de desenvolvimento forem reduzidas, terá encontrado uma combinação vencedora para expandir o seu negócio.
Considerações finais
Tal como qualquer outra metodologia, o DevOps só é bem-sucedido se for implementado corretamente. E não pode conhecer o sucesso até saber como utilizar as métricas DevOps.
É claro que implementar métricas DevOps apresenta os seus desafios. Requer uma mentalidade estratégica, uma cultura de colaboração e um compromisso com a melhoria contínua. No entanto, os resultados são fluxos de trabalho e processos otimizados, sobre os quais pode construir uma base sólida para expandir o seu negócio.
Se quiser manter-se atualizado com notícias e artigos, subscreva a nossa newsletter!