Zarządzanie sztuczną inteligencją nie może być kwestią drugorzędną
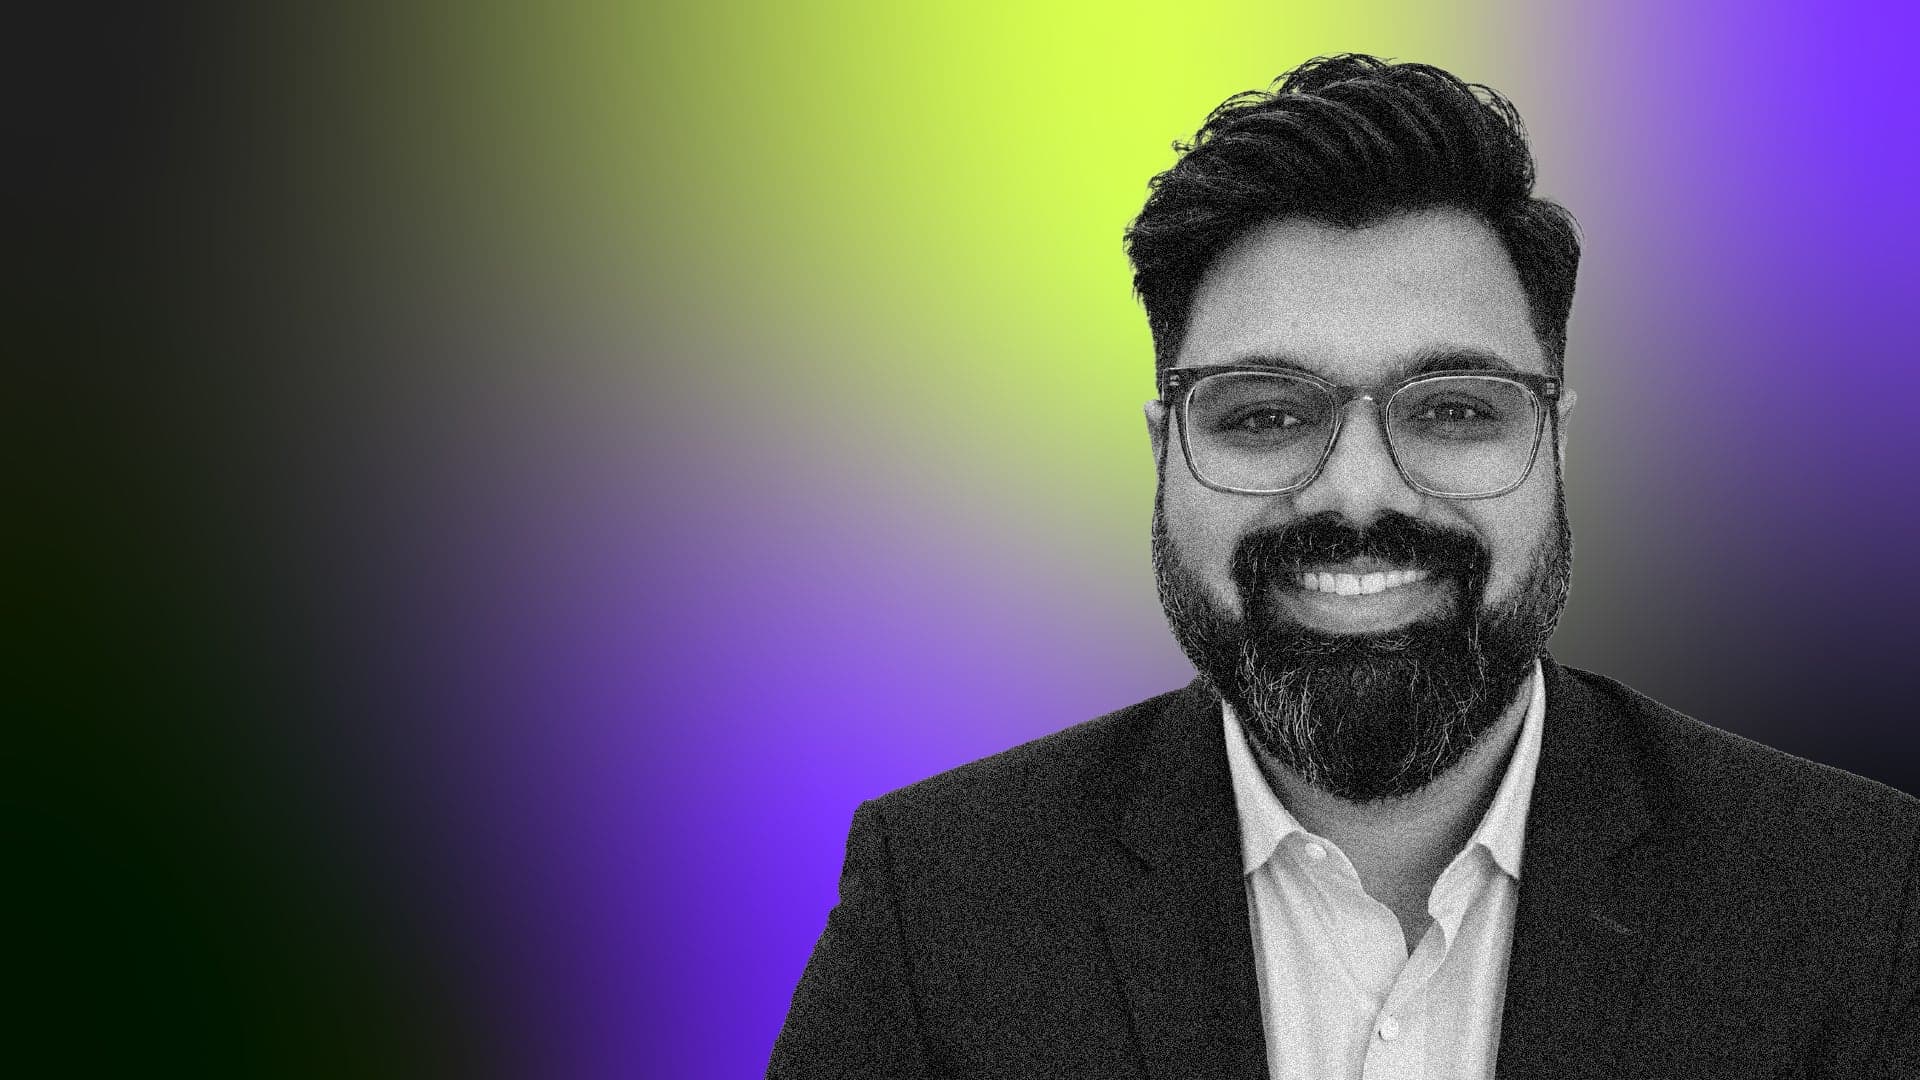
Abhishek Ranjan
Dyrektor techniczny w Apna i Blue Machines
Abhishek Ranjan wyjaśnia, jak zarządzanie sztuczną inteligencją, testowanie i przejrzystość kosztów pomagają zespołom szybciej wdrażać rozwiązania bez poświęcania jakości, niezawodności ani inżynierskiego osądu.
Key Takeaways
Współpraca człowieka ze sztuczną inteligencją: Technologia pomaga ludziom znajdować pracę i rozwijać się gospodarczo, podczas gdy sztuczna inteligencja ewoluuje jako część siły roboczej.
Zarządzanie sztuczną inteligencją: Programowanie wspomagane przez sztuczną inteligencję wymaga zarządzania, aby ograniczać liczbę błędów, usprawniać zapewnianie jakości i zapewniać lepsze praktyki programistyczne.
Zarządzanie poleceniami: Traktuj polecenia dla sztucznej inteligencji jak kod: stosuj wersjonowanie, przeglądy i testy, aby poprawić wydajność i niezawodność.
Małe zespoły: Sztuczna inteligencja przesuwa proces rekrutacji w stronę inżynierów o szerokim zakresie umiejętności, zmniejszając potrzebę tworzenia większych zespołów.
Strategia dyrektora technicznego: Dyrektorzy techniczni powinni szybko integrować sztuczną inteligencję z procesami, stosując odpowiednie zarządzanie w celu zwiększenia możliwości organizacji.
Abhishek Ranjan jest dyrektorem ds. technologii (CTO) w firmach Apna i Blue Machines, gdzie jest głęboko zaangażowany w transformację zarówno ludzkiej siły roboczej, jak i siły roboczej opartej na sztucznej inteligencji.
Usiedliśmy z nim, aby porozmawiać o zarządzaniu w przepływach pracy opartych na sztucznej inteligencji. Oto, co powiedział.
Technologia u boku ludzi
Nazywam się Abhishek Ranjan. Jestem dyrektorem ds. technologii w firmach Apna i Blue Machines. Dwa bardzo powiązane, a jednocześnie różne światy ukształtowały moją drogę do tego momentu transformacji opartej na sztucznej inteligencji.
W Apna tworzymy rozwiązania dla ludzkiej siły roboczej. Apna to jeden z najszybciej rozwijających się indyjskich jednorożców, z ponad 60 milionami użytkowników na platformie. Przy takiej skali bardzo dokładnie obserwujemy indyjską siłę roboczą. Widzimy miliony osób szukających lepszych możliwości, pracodawców próbujących szybciej zatrudniać pracowników, różne języki, różne poziomy umiejętności oraz różny poziom dostępu do technologii cyfrowych i pewności w korzystaniu z nich.
W Blue Machines tworzymy rozwiązania dla siły roboczej opartej na sztucznej inteligencji. Koncentrujemy się na głosowej sztucznej inteligencji dla przedsiębiorstw, obsługując codziennie miliony minut. Tworzymy coś więcej niż tylko boty odpowiadające na pytania. Budujemy pracowników opartych na sztucznej inteligencji, którzy mogą rozmawiać z klientami, rozumieć kontekst, przyjmować informacje zwrotne, doskonalić się z czasem i realizować rzeczywiste przepływy pracy w firmach.
Widziałem, jak technologia pomaga ludziom znaleźć pracę, rozwijać się i uczestniczyć w gospodarce. Teraz widzę, jak sama sztuczna inteligencja staje się nowym rodzajem siły roboczej, która może pracować u boku ludzi.
Dlatego ten moment nie dotyczy dla mnie wyłącznie wykorzystywania sztucznej inteligencji do zwiększania produktywności czy szybszego pisania kodu. Chodzi o ponowne wyobrażenie sobie sposobu funkcjonowania firm i tego, jak sama praca jest wykonywana.
More Articles
Architektura dwóch bardzo różnych firm
Architektura Apna jest zbudowana jak duża platforma handlowa. Mamy systemy konsumenckie, systemy dla pracodawców, platformy danych, systemy sztucznej inteligencji i dopasowywania, wyszukiwanie, komunikację, warstwy zapobiegania oszustwom i budowania zaufania, a także funkcje rekrutera opartego na sztucznej inteligencji oraz przygotowania do rozmów kwalifikacyjnych z wykorzystaniem sztucznej inteligencji. Model wdrażania jest nastawiony na chmurę, wysoce skalowalny i zaprojektowany z myślą o wysokiej dostępności, ponieważ z platformy korzystają miliony użytkowników i tysiące firm.
Organizacja inżynieryjna liczy ponad 100 osób pracujących w zespołach zajmujących się inżynierią produktu, zapleczem, interfejsem użytkownika, urządzeniami mobilnymi, danymi, sztuczną inteligencją, infrastrukturą, bezpieczeństwem i platformą. Koncentrujemy się nie tylko na tworzeniu funkcji, lecz także na budowaniu niezawodnych systemów, które mogą działać na ogromną skalę.
Blue Machines to organizacja technologiczna innego rodzaju. Koncentruje się na głosowej sztucznej inteligencji dla przedsiębiorstw i autonomicznych przepływach pracy. Budujemy pracowników opartych na sztucznej inteligencji, którzy potrafią rozmawiać, rozumować, podejmować działania, integrować się z systemami biznesowymi i doskonalić się dzięki informacjom zwrotnym. Już dziś działamy na znaczną skalę, obsługując codziennie miliony minut rozmów z wykorzystaniem głosowej sztucznej inteligencji.
Architektura Blue Machines jest bardziej oparta na działaniu w czasie rzeczywistym i natywnie wykorzystuje sztuczną inteligencję. Obejmuje infrastrukturę głosową, telefonię, zamianę mowy na tekst, rozumowanie z wykorzystaniem dużych modeli językowych, zamianę tekstu na mowę, orkiestrację przepływów pracy, integracje, analitykę, monitorowanie oraz systemy oceny. Złożoność produktu jest wysoka, ponieważ głosowa sztuczna inteligencja dla przedsiębiorstw musi działać produkcyjnie, w rzeczywistych rozmowach, przy niskich opóźnieniach, wysokiej dokładności, zabezpieczeniach zgodności z przepisami i jasno określonych rezultatach biznesowych.
W Blue Machines podstawowy zespół czterech inżynierów zbudował rozproszoną platformę orkiestracji głosu w ciągu zaledwie kilku tygodni. Mamy również bardzo doświadczony zespół badawczy, który intensywnie pracuje nad głosową sztuczną inteligencją, oceną agentów, rozumowaniem, opóźnieniami, systemami wielojęzycznymi i doskonaleniem agentów z czasem. Ta głębia badawcza jest ważna, ponieważ głosowej sztucznej inteligencji dla przedsiębiorstw nie da się rozwiązać wyłącznie poprzez łączenie modeli. Wymaga ona silnej inżynierii produktu, solidnej inżynierii systemów i zaawansowanych badań nad stosowaną sztuczną inteligencją.
Ogólnie rzecz biorąc, organizacja technologiczna, którą kieruję, znajduje się na styku platform działających na dużą skalę i systemów natywnie wykorzystujących sztuczną inteligencję.
Jak właściwie zarządzana sztuczna inteligencja usprawnia cykl życia oprogramowania
Sztuczna inteligencja może pomóc inżynierom szybciej pisać kod, ale jeśli zarządzanie nie zostanie usprawnione, może również prowadzić do powstawania większej liczby ukrytych błędów, pomijania przypadków brzegowych lub stosowania niewłaściwych abstrakcji.
W ciągu ostatniego roku sztuczna inteligencja zmieniła sposób, w jaki tworzymy, testujemy i wdrażamy technologie.
Wcześniej nasz proces wdrażania był bardziej tradycyjny. Inżynierowie tworzyli funkcje, zgłaszali PR-y, przechodzili wzajemne przeglądy, uruchamiali przypadki testowe, a następnie wdrażali zmiany za pośrednictwem standardowego potoku wdrożeniowego. Działało to, ale tempo zależało od cykli przeglądów przeprowadzanych przez ludzi, ręcznej kontroli jakości i zaufania zespołu do wdrożenia.
Gdy programowanie wspomagane przez sztuczną inteligencję stało się większą częścią prac inżynieryjnych, przyjęliśmy je — i wkrótce zdaliśmy sobie sprawę, że samo zwiększenie szybkości nie wystarczy. Sztuczna inteligencja może pomóc inżynierom szybciej pisać kod, ale jeśli zarządzanie nie zostanie usprawnione, może również prowadzić do powstawania większej liczby ukrytych błędów, pomijania przypadków brzegowych lub stosowania niewłaściwych abstrakcji.
Dlatego zmieniliśmy model operacyjny.
- Dodaliśmy warstwę przeglądu PR wspomaganą przez AI. Każdy PR był sprawdzany pod kątem ryzykownej logiki, pominiętych przypadków brzegowych, naruszeń kontraktów API, problemów z bezpieczeństwem, ryzyka związanego z migracją oraz niewystarczającego pokrycia testami przed przeglądem przez człowieka. Ograniczyło to liczbę oczywistych przeoczeń przed przeglądem.
- Wzmocniliśmy bramki CI. Zmiana nie mogła przejść wyłącznie dlatego, że kod wyglądał poprawnie. Musiała przejść testy jednostkowe, testy integracyjne, lintowanie, kontrole bezpieczeństwa, testy kontraktów API oraz zestawy testów regresji dla odpowiedniego obszaru produktu.
- Stworzyliśmy silniejsze zestawy testów regresji dla krytycznych przepływów pracy. Obejmowało to na przykład dodawanie przypadków testowych dla rzeczywistych scenariuszy użytkowników, przypadków brzegowych, obsługi wielu języków, obsługi błędów oraz rezultatów biznesowych.
- Zmieniliśmy zasady zarządzania promptami. Więcej na ten temat za chwilę.
- Wdrożenia kanarkowe stały się obowiązkowe w obszarach wysokiego ryzyka. Zamiast udostępniać zmianę wszystkim, wdrażamy ją dla niewielkiego odsetka ruchu, monitorujemy błędy, opóźnienia, konwersję, rezygnacje, jakość działania agentów oraz wpływ na klientów, a następnie zwiększamy zakres wdrożenia albo wycofujemy zmianę.
- Dodaliśmy lepszą obserwowalność. Gdy coś się psuło, chcieliśmy dokładnie wiedzieć, która wersja kodu, promptu, modelu, przepływu pracy lub zależności była tego przyczyną.
Wpływ tych zmian jest bardzo widoczny. Nasza szybkość dostarczania wydań znacząco wzrosła. Zespoły, które wcześniej publikowały większe, zbiorcze wydania, przechodzą teraz do mniejszych i częstszych wydań. W niektórych obszarach częstotliwość wydań wzrosła niemal dwu- lub trzykrotnie, ponieważ kontrole są bardziej zautomatyzowane, a poziom pewności jest wyższy. Właśnie w ten sposób czteroosobowy zespół zbudował złożoną, rozproszoną platformę w ciągu zaledwie kilku tygodni.
Liczba problemów na produkcji również spadła, ponieważ każde wydanie jest mniejsze, lepiej przetestowane i łatwiejsze do wycofania. Obserwujemy znaczący spadek liczby błędów produkcyjnych, zwłaszcza tam, gdzie zautomatyzowane testy regresji i wdrożenia kanarkowe są już obowiązkowe. Obecnie liczba defektów jest niemal o 40% niższa niż pierwotnie.
Sama AI zapewnia szybkość. AI połączona z zarządzaniem zapewnia szybkość i jakość.
Dlaczego prompty należy traktować jak kod
Abhishek dzieli się
W przypadku systemów AI również zaczęliśmy traktować prompty jak kod… Była to ważna zmiana na lepsze. Wiemy, który prompt był aktywny, co się zmieniło, co się poprawiło i czy rezultaty osiągane przez klientów się poprawiły.
W przypadku systemów AI również zaczęliśmy traktować prompty jak kod.
Obecnie wersjonujemy, przeglądamy, testujemy i promujemy prompty między środowiskami, a także wdrażamy je etapami. Prompty nie są już traktowane jak niewielkie aktualizacje konfiguracji. Przechodzą testowe rozmowy, testy przypadków brzegowych, kontrole wielojęzyczności, kontrole opóźnień, kontrole zgodności oraz kontrole rezultatów biznesowych.
Możemy najpierw udostępnić nowy prompt lub przepływ pracy agenta niewielkiemu odsetkowi ruchu, obserwować rezultaty, a następnie zwiększyć zakres wdrożenia, jeśli wskaźniki wyglądają lepiej.
Była to ważna zmiana na lepsze. Wcześniej trudno było stwierdzić, czy zmiana promptu poprawiła działanie agenta, czy tylko zmieniła jego zachowanie. Teraz możemy bardziej obiektywnie porównywać wersje. Wiemy, który prompt był aktywny, co się zmieniło, co się poprawiło i czy rezultaty osiągane przez klientów się poprawiły.
Większa zmiana polega na tym, że cały system technologiczny stał się bardziej zautomatyzowany, łatwiejszy do mierzenia i lepiej zarządzany.
Agentowy przepływ pracy związany z wydawaniem oprogramowania
Korzystamy z agentowego przepływu pracy związanego z wydawaniem oprogramowania, w którym ludzie uczestniczą w kluczowych momentach.
Ten przepływ pracy nie sprawdza się w przypadku każdego wydania. Przy bardzo złożonych zmianach platformy, głębokich zmianach architektury lub wrażliwych systemach nadal korzystamy z bardziej tradycyjnego procesu prowadzonego przez ludzi. Jednak w niektórych obszarach produktu, zwłaszcza w przypadku szybciej rozwijających się przepływów pracy, stał się on domyślnym sposobem tworzenia oprogramowania.
Oto ten przepływ pracy:
- Proces rozpoczyna się, gdy pojawia się wymaganie produktowe lub problem inżynieryjny. Agent AI do planowania odczytuje wymaganie, dzieli je na zadania, identyfikuje zależności, wskazuje obszary ryzyka i proponuje plan implementacji. Inżynier przegląda plan, koryguje założenia i podejmuje ostateczną decyzję dotyczącą podejścia.
- Następnie agent programistyczny generuje kod, refaktoryzuje moduły, tworzy kod szablonowy oraz przygotowuje testy jednostkowe i integracyjne. Agent przeglądający sprawdza PR pod kątem ryzykownej logiki, pominiętych przypadków brzegowych, problemów z bezpieczeństwem, naruszeń kontraktów API oraz braków w testach.
- Następnie agent testujący tworzy scenariusze regresji i sprawdza przypadki brzegowe. W przypadku przepływów pracy AI uruchamia również ewaluacje promptów, testy rozmów, kontrole wielojęzyczności, kontrole opóźnień oraz kontrole rezultatów biznesowych.
- Agent odpowiedzialny za wydanie rekomenduje następnie, czy zmiana jest bezpieczna do wdrożenia kanarkowego, na podstawie wyników testów, obszaru wpływu, wcześniejszych awarii oraz gotowości w zakresie obserwowalności. Ludzie nadal jednak zatwierdzają krytyczne zwiększenie zakresu wdrożenia, zwłaszcza jeśli zmiana wpływa na przychody, doświadczenia klientów, bezpieczeństwo lub podstawową infrastrukturę.
- Po wydaniu agent monitorujący obserwuje błędy, opóźnienia, konwersję, rezygnacje, jakość działania agentów oraz wpływ na klientów. Jeśli coś wygląda nieprawidłowo, rekomenduje wycofanie zmiany, otwiera incydent, podsumowuje logi i tworzy pierwszy szkic analizy przyczyny źródłowej.
Ten przepływ pracy jest agentowy, ale nie działa w sposób bezrefleksyjnie autonomiczny. Agenci AI planują, programują, przeglądają, testują, wydają, monitorują i tworzą podsumowania. Ludzie zatwierdzają, kwestionują, ustalają priorytety i ponoszą odpowiedzialność za ostateczną decyzję.
W czym Claude Code i Cursor sprawdzają się najlepiej
Moimi ulubionymi narzędziami są Claude Code i Cursor, zależnie od przepływu pracy.
Cursor sprawdza się doskonale, gdy inżynierowie chcą, aby AI było głęboko zintegrowane z ich środowiskiem IDE na potrzeby codziennego programowania, refaktoryzacji, rozumienia bazy kodu i szybszej implementacji.
Claude Code okazuje się niezwykle przydatny w przypadku bardziej agentowych zadań: rozumienia większych baz kodu, wprowadzania zmian w wielu plikach, generowania testów, naprawiania problemów i iteracyjnej pracy jak partner inżynieryjny.
Dlaczego AI zapewnia wsparcie, a ludzie — osąd
Obecnie w dużym stopniu polegamy na AI w przypadku wszystkiego, co poprawia szybkość, zakres lub spójność, ale nie w zadaniach wymagających osądu, odpowiedzialności lub uwzględniania długoterminowych kompromisów.
Przykładowo AI pomaga nam teraz w przeglądach kodu, generowaniu przypadków testowych, zapewnianiu pokrycia regresji, tworzeniu dokumentacji, debugowaniu, analizie logów, a nawet w triage'u incydentów. Potrafi szybko identyfikować ryzykowne ścieżki kodu, brakujące przypadki brzegowe, potencjalne problemy z bezpieczeństwem lub wzorce w awariach produkcyjnych. W systemach AI pomaga nam również porównywać wersje promptów, oceniać rozmowy i rozumieć, gdzie agent zawodzi.
Jednak ostateczne decyzje nadal podejmują ludzie. Oto kilka przykładów:
- Decyzje dotyczące architektury muszą pozostać domeną ludzi, ponieważ obejmują kompromisy związane ze skalą, kosztami, niezawodnością, możliwościami zespołu i długoterminowym kierunkiem rozwoju produktu.
- Analiza przyczyn źródłowych od początku do końca (RCA) może być wspierana przez AI, ale ludzie nadal muszą połączyć fakty, zweryfikować hipotezę i zdecydować o rozwiązaniu.
- Priorytetyzacja backlogu pozostaje domeną ludzi, ponieważ wymaga znajomości kontekstu klienta, strategii biznesowej i osądu dotyczącego tego, co naprawdę ma znaczenie.
- W przeglądach bezpieczeństwa wykorzystujemy AI, ale niezbędny jest osąd eksperta. AI może wskazywać problemy, ale może też generować fałszywe alarmy lub pomijać ryzyka związane z kontekstem biznesowym. Odpowiedzialność pozostaje po stronie ludzi, ponieważ ryzyko i zakres odpowiedzialności są zbyt duże.
Rzeczywiste przykłady błędów AI w osądzie technicznym
…AI nadal ma trudności. Potrafi odczytywać logi, podsumowywać ślady, sugerować poprawki i przyspieszać debugowanie. Jednak w złożonych systemach rozproszonych może nie dostrzec związków przyczynowych, zależności czasowych i kontekstu na poziomie całego systemu.
Oto kilka przykładów znaczenia ludzkiego osądu.
Pierwszy dotyczył skoków opóźnień na poziomie milisekund w naszym potoku głosowym. AI prawidłowo skomentowała problem i zidentyfikowała, że opóźnienie w jednej ze ścieżek może stać się problemem. Jednak zaproponowany przez nią kod był błędny. Wyglądał przejrzyście, ale pod obciążeniem doprowadziłby do powstania innego wąskiego gardła. Ludzki inżynier wkroczył do działania, zrozumiał zachowanie systemu w czasie wykonywania i prawidłowo naprawił problem.
Inny przykład pojawił się podczas triage'u problemu na produkcji. Wiele systemów zależnych ulegało awariom, a AI wciąż analizowała te systemy niezależnie i sugerowała optymalizacje. My jednak już wiedzieliśmy, że prawdziwym problemem była zależność nadrzędna, która uległa awarii jako pierwsza. AI myliła widoczne awarie z przyczyną źródłową.
W tym miejscu AI nadal ma trudności. Potrafi odczytywać logi, podsumowywać ślady, sugerować poprawki i przyspieszać debugowanie. Jednak w złożonych systemach rozproszonych może nie dostrzec związków przyczynowych, zależności czasowych i kontekstu na poziomie całego systemu.
Dlaczego zespoły stają się mniejsze i bardziej wszechstronne
AI zmieniła profil zatrudnianych osób bardziej niż strukturę organizacyjną.
Wcześniej zatrudnialiśmy osoby o węższej specjalizacji funkcjonalnej: backend, frontend, QA, DevOps, dane itd. Te umiejętności nadal mają znaczenie, ale teraz bardziej cenię inżynierów, którzy potrafią działać w całym stosie technologicznym, dogłębnie wykorzystywać AI i przejść od problemu do wdrożenia przy znacznie mniejszym wsparciu.
Najlepsi inżynierowie nie tylko piszą teraz kod. Projektują przepływy pracy, wykorzystują AI do implementacji, generują testy, przeglądają wyniki, szybciej debugują i myślą o jakości wydań.
Dlatego poprzeczka rekrutacyjna przesunęła się w stronę inżynierów o wysokim poczuciu odpowiedzialności i umiejętności trafnego osądu. Ludzi, którzy potrafią zadawać właściwe pytania, weryfikować wyniki AI, dogłębnie rozumieć systemy i samodzielnie dostarczać rozwiązania.
W niektórych obszarach zmniejszyło to również zapotrzebowanie na duże zespoły. Mniejszy zespół, odpowiednio wspierany przez AI, może teraz wykonać pracę, która wcześniej wymagała znacznie większej liczby osób.
Dlaczego AI utrudnia szkolenie początkujących inżynierów
Abhishek dzieli się
Nie uważam, że zakaz używania AI lub zmuszanie ludzi do programowania tak, jakby był rok 2010, jest właściwą odpowiedzią. To byłoby błędem. Nie sądzę jednak również, że w pełni rozwiązaliśmy problem budowania głębokiego osądu inżynierskiego w sytuacji, gdy AI wykonuje tak dużą część pracy wstępnej. Na razie najlepszą odpowiedzią jest dla mnie uczynienie zrozumienia widocznym.
Jak szkolić początkujących inżynierów w erze AI? Nie mam jeszcze idealnej odpowiedzi.
Kiedy zaczynaliśmy, pomagały nam środowiska IDE. Potem pomagał nam Google. Następnie pomagał nam Stack Overflow. Jednak we wszystkich tych etapach nadal trzeba było samodzielnie zmierzyć się z problemem. Trzeba było zrozumieć odpowiedź, dostosować ją, debugować i nauczyć się, dlaczego działała.
Dzięki AI i kodowaniu na wyczucie możemy pominąć tę trudną część. Początkujący inżynier może wygenerować działający kod, nie rozumiejąc tak naprawdę systemu, kompromisów ani scenariuszy awarii. To mnie niepokoi.
Nie uważam, że zakaz używania AI lub zmuszanie ludzi do programowania tak, jakby był rok 2010, jest właściwą odpowiedzią. To byłoby błędem. Nie sądzę jednak również, że w pełni rozwiązaliśmy problem budowania głębokiego osądu inżynierskiego w sytuacji, gdy AI wykonuje tak dużą część pracy wstępnej.
Na razie moją najlepszą odpowiedzią jest uczynienie procesu zrozumiałym. Inżynierowie powinni potrafić wyjaśnić, dlaczego kod działa, gdzie może zawieść, które testy mają znaczenie, co dzieje się przy dużej skali oraz jak diagnozowaliby problemy w środowisku produkcyjnym.
Jak zarządzać wykorzystaniem tokenów
Koszty również stanowią wyzwanie związane ze sztuczną inteligencją.
Wykorzystanie tokenów na początku wydaje się niegroźne, ale gdy sztuczna inteligencja zaczyna być wykorzystywana do programowania, przeglądów kodu, testowania, debugowania i pracy agentowej, koszty mogą bardzo szybko wzrosnąć.
Dlatego teraz musimy mierzyć zwrot z inwestycji dla poszczególnych procesów i stosować bardziej przemyślaną orkiestrację. Nie każde zadanie wymaga najdroższego modelu.
Przyszłość wiąże się z używaniem odpowiedniego modelu do odpowiedniego zadania.
Dlaczego dyrektorzy ds. technologii muszą działać szybko — zachowując kontrolę
Oto moja rada: Twórz szybko. Eksperymentuj szybko. Wdrażaj sztuczną inteligencję w rzeczywistych procesach inżynieryjnych, produktowych, wsparcia, sprzedaży, operacyjnych i wewnętrznych. Nie udawaj, że to nie działa. To działa, czasami zaskakująco dobrze.
Ale nie stawaj się bezkrytycznym wyznawcą. Sztuczna inteligencja jest potężna, ale nie jest magią. Potrzebujesz kontroli, zarządzania, testowania, obserwowalności i jasno określonej odpowiedzialności. W przeciwnym razie po prostu stworzysz chaos — tylko szybciej.
Właściwe podejście nie polega ani na przekonaniu, że „sztuczna inteligencja zastąpi wszystko”, ani na twierdzeniu, że „sztuczna inteligencja jest przereklamowana”. Właściwe podejście brzmi: „jak mogę wykorzystać tę technologię, aby zwiększyć możliwości mojej organizacji dziesięciokrotnie?”
Śledź nasze publikacje
Śledź Abhisheka Ranjana na platformie LinkedIn. Zajrzyj również do jego newslettera Hacktivate.
Na The CTO Club pojawi się więcej wywiadów z ekspertami!