

Narzędzia do obserwowalności LLM śledzą przepływy pracy AI, monitorują zachowanie w środowisku produkcyjnym i oceniają jakość modeli. Ten przewodnik porównuje najlepsze opcje do debugowania agentów wieloetapowych, śledzenia promptów i wersji modeli, mierzenia opóźnień i wykorzystania tokenów oraz wykrywania regresji przed wdrożeniem. Znajdziesz tu platformy o otwartym kodzie źródłowym, do samodzielnego hostowania, korporacyjne, oparte na OpenTelemetry oraz przeznaczone dla deweloperów, dopasowane do Twojej architektury technicznej, potrzeb związanych z zarządzaniem i przepływu pracy dostarczania.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza: narzędzia do obserwowalności LLM
Porównaj ceny i specyfikacje najlepszych platform z mojej listy, zestawiając je obok siebie.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepszy wybór do śledzenia natywnie opartego na OTel i open source | Dostępny bezpłatny plan i bezpłatna prezentacja | Ceny dostępne na żądanie | Website | |
| 2 | Najlepszy wybór do samoobsługowej oceny o otwartym kodzie źródłowym na dużą skalę | Dostępny bezpłatny plan | Cena na żądanie | Website | |
| 3 | Najlepszy do oceny LLM w całym cyklu życia wraz z operacjami bramy | Dostępny bezpłatny plan i bezpłatna wersja demonstracyjna | Ceny na żądanie | Website | |
| 4 | Najlepszy do oceniania i śledzenia w oprogramowaniu o otwartym kodzie źródłowym | Dostępny bezpłatny plan + bezpłatne demo | Od 19 USD/miesiąc | Website | |
| 5 | Najlepszy do łączenia wersji promptów z produkcyjnymi śladami | Darmowy plan + dostępna bezpłatna wersja demonstracyjna | Od $49/miesiąc | Website | |
| 6 | Najlepsze rozwiązanie do obserwowalności agentów korporacyjnych na dużą skalę | Dostępny bezpłatny plan i bezpłatne demo | Ceny dostępne na żądanie | Website | |
| 7 | Najlepsze rozwiązanie do scalania promptów w CI/CD po pomyślnym przejściu ewaluacji | Dostępny plan bezpłatny i bezpłatne demo | Od 200 USD/miesiąc | Website | |
| 8 | Najlepsze rozwiązanie dla LLMOps natywnych dla bramy z hostingiem VPC | Website | |||
| 9 | Najlepsze do sprawdzania halucynacji i dryfu | Bezpłatne w użyciu | Bezpłatne w użyciu | Website | |
| 10 | Najlepsze do wieloturowej symulacji agentów i śledzenia | Website |


Recenzje narzędzi do obserwowalności LLM
Poniżej znajdują się szczegółowe podsumowania najlepszych propozycji z mojej listy. Każda recenzja obejmuje najważniejsze funkcje, przypadki użycia i integracje, aby pomóc Ci znaleźć rozwiązanie najlepiej dopasowane do Twoich potrzeb.
 Najlepszy wybór do śledzenia natywnie opartego na OTel i open source
- Dostępny bezpłatny plan i bezpłatna prezentacja
- Ceny dostępne na żądanie
Visit WebsiteCustomer Rating:5/5
Traceloop pozwala użytkownikom analizować szczegóły śladów LLM, prompty i wykorzystanie tokenów. Traceloop firmy ServiceNow jest oparty na OpenTelemetry, co zapewnia rejestrowanie śladów oparte na spanach, ocenę jakości wyników, rejestr promptów z wdrożeniami zależnymi od środowiska, monitory produkcyjne oraz bramki jakości CI/CD.
Dla kogo Traceloop jest najlepszym wyborem?
Traceloop jest odpowiedni dla inżynierów platform i DevOps, którzy potrzebują zgodnego z wymaganiami, samodzielnie hostowanego monitorowania LLM na Kubernetesie lub w infrastrukturze odizolowanej od sieci.
Dlaczego wybrałem Traceloop
Uwzględniłem Traceloop wśród najlepszych rozwiązań, ponieważ jest w całości oparty na OpenTelemetry za pośrednictwem pakietu SDK OpenLLMetry o otwartym kodzie źródłowym, co oznacza, że każde wywołanie LLM, zapytanie do wektorowej bazy danych i etap działania agenta są rejestrowane jako natywny span OTel, który można eksportować do ponad 25 systemów. Szczególnie podoba mi się potok ewaluacyjny: te same kontrole jakości można jednocześnie uruchamiać jako bramki CI/CD dla żądań przeglądu, jako wbudowane reguły ochronne w środowisku produkcyjnym oraz jako monitory w czasie rzeczywistym dla aktywnego ruchu. Rejestr promptów z wdrożeniami zależnymi od środowiska pozwala również wdrażać zmiany promptów najpierw w środowisku deweloperskim, a dopiero potem produkcyjnie, zapewniając ścisłą kontrolę wersji w całym cyklu życia.
Najważniejsze funkcje Traceloop
- Wbudowane ewaluatory: Automatycznie sprawdzają wierność, trafność i bezpieczeństwo aktywnego ruchu bez konieczności ręcznej konfiguracji.
- Kontrole ewaluacyjne ukierunkowane na agentów: Oceniają wyniki agentów pod kątem poprawności, wykorzystania narzędzi, zachowania pamięci, realizacji zadań i bezpieczeństwa.
- Monitory produkcyjne: Uruchamiają ewaluatory w czasie rzeczywistym dla każdego spanu pasującego do filtra, aby wykrywać halucynacje i pogorszenie jakości.
- Wbudowane reguły ochronne: Wykonują kontrole bezpieczeństwa w czasie rzeczywistym podczas inferencji, bezpośrednio na podstawie skonfigurowanych ewaluatorów.
Integracje Traceloop
Traceloop obsługuje ponad 20 dostawców LLM, w tym Axiom, Braintrust, BMC, Google Cloud, Highlight, Honeycomb, Instana, OpenTelemetry Collector, Datadog, Oracle Cloud i Tenant Cloud. Dostępne jest również API do tworzenia niestandardowych ewaluatorów LLM oceniających wyniki.
Pros and Cons
Pros:
- Natywne śledzenie ogranicza uzależnienie od dostawcy
- Ewaluacje obejmują okres od CI/CD po środowisko produkcyjne
- Samodzielne hostowanie obsługuje wdrożenia w infrastrukturze odizolowanej od sieci
Cons:
- Przejęcie przez ServiceNow powoduje niepewność dotyczącą dalszego kierunku rozwoju
- Publicznie dostępne informacje o przypisywaniu kosztów pozostają ograniczone
Learn more about Traceloop: Najlepszy wybór do samoobsługowej oceny o otwartym kodzie źródłowym na dużą skalę
- Dostępny bezpłatny plan
- Cena na żądanie

MLflow śledzi ślady LLM wraz z wynikami poprawności i ugruntowania w źródłach. MLflow to platforma o otwartym kodzie źródłowym do obserwowalności AI, która łączy rejestrowanie śladów, ocenę jakości wyników, wersjonowanie promptów, śledzenie kosztów i tokenów oraz monitorowanie produkcyjne aplikacji LLM i agentów AI.
Dla kogo MLflow jest najlepszym wyborem?
MLflow jest odpowiedni dla inżynierów ML/AI i analityków danych, którzy potrzebują pełnej kontroli nad infrastrukturą obserwowalności oraz chcą uniknąć opłat za poszczególne ślady i uzależnienia od dostawcy.
Dlaczego wybrałem MLflow
Uwzględniłem MLflow wśród najlepszych propozycji, ponieważ jest to jedyne opisane tutaj narzędzie stworzone od podstaw jako oprogramowanie o otwartym kodzie źródłowym na licencji Apache 2.0, co oznacza, że dane o śladach nigdy nie opuszczają własnej infrastruktury. Podoba mi się, że Rejestr promptów bezpośrednio łączy każdą wersję promptu z wynikami jej oceny, dzięki czemu można przeprowadzać testy A/B wariantów i porównywać obok siebie wyniki jakości, opóźnień i bezpieczeństwa przed wdrożeniem dowolnego wariantu na produkcję. Asynchroniczne mechanizmy oceny LLM również stale oceniają próbkowane ślady bez spowalniania ruchu na żywo.
Najważniejsze funkcje MLflow
- Rejestr promptów: Wersjonowanie, testowanie i porównywanie promptów obok siebie wraz ze śledzeniem pochodzenia oraz automatyczną optymalizacją promptów w celu algorytmicznego dostrajania ich treści.
- Mechanizmy ochrony i wykrywanie zagrożeń: Ocena w czasie rzeczywistym wykrywa wstrzykiwanie promptów, wycieki danych osobowych i próby obejścia zabezpieczeń za pomocą detektorów deterministycznych oraz opartych na LLM, a zestaw SDK umożliwia redagowanie danych osobowych.
- Zarządzanie zbiorami danych do oceny: Tworzenie i przechowywanie zbiorów danych przypadków testowych na podstawie śladów produkcyjnych, przy czym uporządkowane informacje zwrotne od użytkowników i ekspertów dziedzinowych są wykorzystywane do kalibracji mechanizmów oceny.
- Bramka AI z zasadami budżetowymi: Ustawianie progów wydatków dziennych, tygodniowych lub miesięcznych dla różnych dostawców oraz konfigurowanie alertów webhook do narzędzi takich jak Slack lub PagerDuty po przekroczeniu limitów.
Integracje MLflow
MLflow integruje się z ponad 40 modelami LLM i agentami AI, w tym OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry i TypeScript. Interfejs API REST jest również dostępny na potrzeby niestandardowych połączeń.
Pros and Cons
Pros:
- Samodzielnie hostowane ślady utrzymują dane we własnej infrastrukturze
- Mechanizmy oceny produkcyjnej oceniają halucynacje i dryf
- Pochodzenie promptów łączy zmiany z ocenami
Cons:
- Zagnieżdżone ślady agentów mogą stać się mylące
- Opcje alertów są nadal słabiej udokumentowane
Learn more about MLflow: Najlepszy do oceny LLM w całym cyklu życia wraz z operacjami bramy
- Dostępny bezpłatny plan i bezpłatna wersja demonstracyjna
- Ceny na żądanie

Bifrost śledzi rankingi modeli, koszty i opóźnienia u różnych dostawców AI. Bifrost to platforma do monitorowania LLM, która obejmuje cały cykl życia tworzenia, łącząc rozproszone śledzenie, wersjonowanie promptów i eksperymentowanie, automatyczną ocenę oraz ocenę z udziałem człowieka, a także bramę LLM o otwartym kodzie źródłowym.
Dla kogo Bifrost jest najlepszy?
Bifrost świetnie sprawdza się w regulowanych zespołach korporacyjnych, które potrzebują wdrożenia w VPC, zgodności z SOC 2 Type II i HIPAA oraz oceny z udziałem człowieka w ramach jednej platformy.
Dlaczego wybrałem Bifrost
To kompleksowe pokrycie całego cyklu życia sprawia, że Bifrost pozostaje na mojej krótkiej liście. Używam go do przeprowadzania testów A/B wersji promptów w środowisku Prompt IDE, a następnie przenoszę te same zestawy danych bezpośrednio do oceny w środowisku produkcyjnym, bez konieczności ręcznego eksportu. Szczególnie przydatne jest dla mnie to, że brama Bifrost o otwartym kodzie źródłowym umożliwia śledzenie budżetu dla każdego zespołu lub klucza wirtualnego oraz stosowanie limitów częstotliwości na poziomie bramy, dzięki czemu mogę zarządzać kontrolą kosztów i monitorowaniem w ramach jednego połączonego rozwiązania, zamiast korzystać z dwóch oddzielnych narzędzi.
Najważniejsze funkcje Bifrost
- Środowisko Prompt IDE z porównywaniem wersji: Multimodalny obszar roboczy do tworzenia promptów, w którym można przeprowadzać eksperymenty z różnymi kombinacjami promptów, modeli, kontekstu i narzędzi, a także porównywać różnice między wersjami obok siebie.
- Symulacja agentów: Testuj interakcje agentów w różnych scenariuszach i z różnymi personami użytkowników, w tym agentów głosowych, przed wdrożeniem zmian w środowisku produkcyjnym.
- Integracja z potokiem CI/CD: Włączaj uruchomienia ocen bezpośrednio do potoku wdrożeniowego; w planie Business i wyższych dostępne są również zaplanowane uruchomienia.
- Zgodność z OpenTelemetry: Eksportuj dane śledzenia do zewnętrznych platform, takich jak New Relic i Snowflake, korzystając z przekazywania natywnego dla OTel oraz zestawów SDK dla języków Python, TypeScript, Go i Java.
Integracje Bifrost
Bifrost obsługuje integrację z zestawami SDK AI, platformami do zarządzania sekretami i systemami tożsamości, w tym OpenAI, Anthropic, Google GenAI, AWS Bedrock, LiteLLM, AWS Secrets Manager, Google Secret Manager i Okta. Dostępne jest również API umożliwiające tworzenie niestandardowych połączeń.
Pros and Cons
Pros:
- Łączy eksperymentowanie, ocenę i monitorowanie
- Śledzi sesje, żądania i poszczególne zakresy śledzenia
- Łączy automatyczne ocenianie z oceną przez człowieka
Cons:
- Krótki okres przechowywania ogranicza analizę danych historycznych
- Szczegółowe przypisywanie kosztów pozostaje niejasne
Learn more about Bifrost: 4Najlepszy do oceniania i śledzenia w oprogramowaniu o otwartym kodzie źródłowym
Opik
- Dostępny bezpłatny plan + bezpłatne demo
- Od 19 USD/miesiąc

Opik pozwala użytkownikom śledzić wywołania LLM wraz z pełnymi szczegółami segmentów i wykorzystania tokenów. Opik to platforma obserwowalności LLM obejmująca rejestrowanie śladów, ocenę jakości wyników, wersjonowanie promptów oraz śledzenie kosztów w aplikacjach LLM, agentach i potokach RAG.
Dla kogo Opik jest najlepszym wyborem?
Opik świetnie sprawdzi się w przypadku inżynierów ML/AI oraz zespołów LLMOps, które chcą korzystać z elastyczności oprogramowania o otwartym kodzie źródłowym z możliwością skalowania do w pełni zarządzanego wdrożenia klasy korporacyjnej.
Dlaczego wybrałem Opik
Wybrałem Opik jako jedno z najlepszych rozwiązań, ponieważ jego rdzeń o otwartym kodzie źródłowym jest naprawdę funkcjonalny, a nie stanowi jedynie okrojonej wersji demonstracyjnej. Podoba mi się, że można hostować go samodzielnie z nieograniczoną liczbą użytkowników, segmentów śledzenia i okresem przechowywania danych, korzystając z tej samej bazy kodu co w wersji chmurowej. Szczególnie pod względem głębi oceniania Opik oferuje ponad 30 metryk oceny przez LLM w roli sędziego oraz zestawy testów, które wykonują asercje zaliczenia/niezaliczenia, testy A/B i testy regresji względem wersjonowanych promptów, co ułatwia wykrywanie regresji jakości wyników, zanim trafią one do środowiska produkcyjnego.
Najważniejsze funkcje Opik
- Interfejs eksperckiego adnotowania: Przeglądaj pojedyncze ślady i pełne rozmowy wieloturowe wraz z wieloma członkami zespołu, korzystając z niestandardowych etykiet do przekazywania informacji zwrotnych na temat jakości z udziałem człowieka.
- Mechanizmy zabezpieczające: Blokuj naruszenia dotyczące treści, ujawnianie danych osobowych i zagrożenia związane ze zgodnością w czasie rzeczywistym, korzystając z wbudowanych typów zabezpieczeń dotyczących PII, tematów i niestandardowych reguł.
- Pulpit analizy kosztów: Śledź w czasie rzeczywistym wydatki na Claude Code i Codex, z podziałem na programistów i zespoły, korzystając z audytowania konfiguracji i rekomendacji dotyczących oszczędności.
- Optymalizator agentów: Automatyzuj tworzenie promptów za pomocą jednego z sześciu wbudowanych algorytmów, a wyniki porównuj bezpośrednio w interfejsie użytkownika.
Integracje Opik
Opik obsługuje ponad 40 połączeń z frameworkami AI i dostawcami modeli, w tym LlamaIndex, OpenAI, Google ADK, Haystack, CrewAI i OpenTelemetry. Obsługuje również interfejs REST API oraz webhooki do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Rdzeń o otwartym kodzie źródłowym umożliwia nieograniczone korzystanie z rozwiązania hostowanego samodzielnie
- Dogłębne ocenianie obejmuje ponad 30 metryk jakości
- Ollie łączy diagnozowanie śladów z naprawianiem regresji
Cons:
- Alertowanie produkcyjne pozostaje stosunkowo podstawowe
- Mechanizmy zabezpieczające nie obejmują jawnego wykrywania prób obejścia zabezpieczeń
Learn more about Opik: Najlepszy do łączenia wersji promptów z produkcyjnymi śladami
- Darmowy plan + dostępna bezpłatna wersja demonstracyjna
- Od $49/miesiąc

PromptLayer umożliwia użytkownikom ocenę wyników LLM za pomocą kolumn ocen i przebiegów zbiorczych. PromptLayer to platforma inżynierii AI, która łączy zarządzanie wersjami promptów, obserwowalność i śledzenie LLM oraz mechanizm ewaluacji do testowania zmian promptów i modeli na danych produkcyjnych.
Dla kogo PromptLayer jest najlepszym wyborem?
PromptLayer doskonale sprawdzi się w zespołach inżynierii ML/AI, które potrzebują powiązać każde produkcyjne żądanie LLM z dokładną wersją promptu, która je wygenerowała.
Dlaczego wybrałem PromptLayer
PromptLayer znalazł się na mojej krótkiej liście, ponieważ każde żądanie produkcyjne jest powiązane z dokładną wersją promptu, która je wygenerowała, dzięki czemu mogę grupować koszty, opóźnienia i wskaźniki jakości według wersji oraz natychmiast sprawdzać, kiedy zmiana wpłynęła na wyniki. Podoba mi się również to, że wdrożenia A/B są wbudowane: mogę stopniowo kierować ruch do nowej wersji promptu i porównywać jej wskaźniki z poprzednią wersją w tym samym widoku. Odtwarzanie śladu w środowisku testowym to praktyczny dodatek, który pozwala odtworzyć błędny wynik i iterować nad promptem bez zgadywania, jaki był pierwotny kontekst.
Najważniejsze funkcje PromptLayer
- Śledzenie natywne dla OpenTelemetry: PromptLayer przyjmuje ślady za pośrednictwem natywnego punktu końcowego OTLP/HTTP działającego asynchronicznie, więc nie zwiększa opóźnienia żądań LLM.
- Dane produkcyjne w wersjonowanych zbiorach danych: Filtruj żądania produkcyjne według wyniku, metadanych lub modelu i bezpośrednio konwertuj je na zbiory danych do wykorzystania w potokach ewaluacyjnych i testach wstecznych.
- Porównywanie modeli i promptów: Uruchamiaj zadania zbiorczego porównywania, aby testować różne modele lub ustawienia parametrów na tych samych danych wejściowych w ramach jednego przebiegu ewaluacji.
- Edytor promptów bez kodu: Umożliwia nietechnicznym członkom zespołu edytowanie, przeglądanie i wdrażanie zmian promptów bez modyfikowania kodu aplikacji.
Integracje PromptLayer
Natywne integracje obejmują OpenTelemetry, LangChain, LlamaIndex, OpenAI, Cohere, Hugging Face, Mistral, Amazon Bedrock i Gemini Enterprise Agent Platform. Narzędzie obsługuje również SDK, REST API oraz webhooki do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Łączenie promptów z produkcyjnymi śladami
- Odtwarzanie nieudanych śladów w środowisku testowym
- Testy wsteczne na rzeczywistych danych produkcyjnych
Cons:
- Natywne alerty pozostają ograniczone
- Brak wbudowanego wykrywania zagrożeń bezpieczeństwa
Learn more about PromptLayer: Najlepsze rozwiązanie do obserwowalności agentów korporacyjnych na dużą skalę
- Dostępny bezpłatny plan i bezpłatne demo
- Ceny dostępne na żądanie
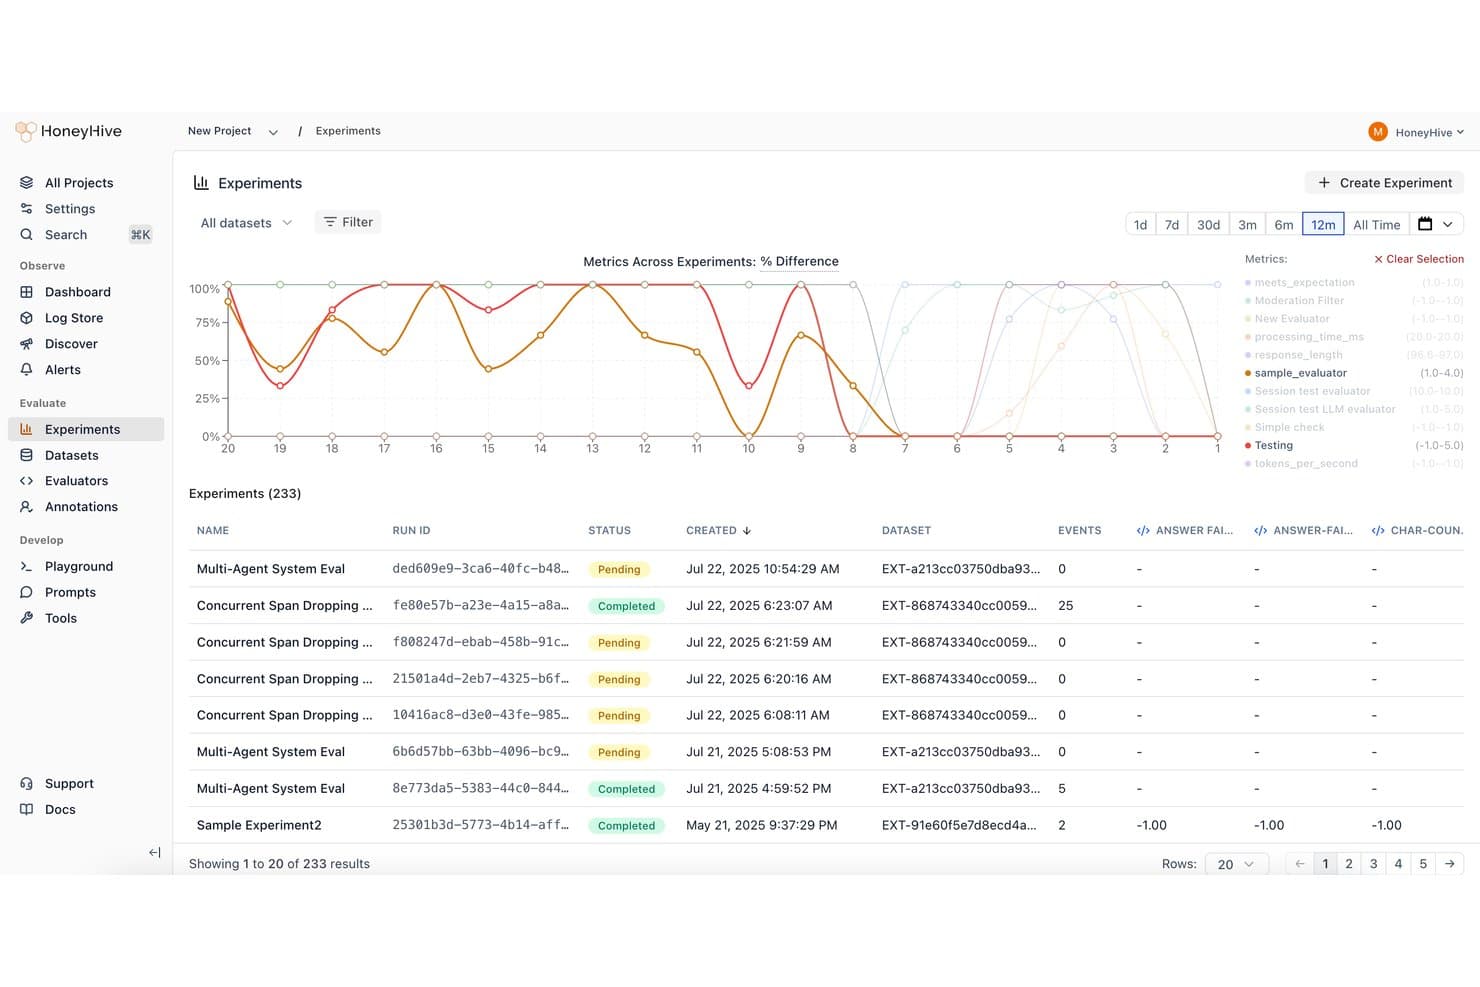
HoneyHive śledzi w czasie metryki eksperymentów LLM i ich przebiegi w różnych zbiorach danych. HoneyHive to platforma obserwowalności i oceny agentów, obejmująca rejestrowanie rozproszonych śladów, ocenę jakości online, wersjonowanie promptów, zarządzanie zbiorami danych oraz monitorowanie produkcyjne aplikacji LLM i wieloetapowych agentów AI.
Dla kogo HoneyHive jest najlepszym wyborem?
HoneyHive to dobry wybór dla inżynierów ML/AI i LLMOps w przedsiębiorstwach, którzy potrzebują obserwowalności klasy zarządzania dla agentów produkcyjnych działających na dużą skalę.
Dlaczego wybrałem HoneyHive
HoneyHive znalazł się na mojej krótkiej liście, ponieważ jest jedną z niewielu platform obserwowalności LLM stworzonych specjalnie z myślą o skali i wymaganiach związanych z zarządzaniem produkcyjnymi agentami w przedsiębiorstwach. Szczególnie podoba mi się natywne dla OTel śledzenie rozproszone, które pozwala odtwarzać krok po kroku długotrwałą sesję agenta, w tym ponowienia prób, pętle i przekazania trwające wiele dni, aby dokładnie wskazać miejsce wystąpienia problemu. W połączeniu z ewaluatorami online oceniającymi dokładność użycia narzędzi i spójność trajektorii na rzeczywistym ruchu otrzymujemy poziom widoczności klasy produkcyjnej, który trudno znaleźć w lżejszych alternatywach.
Najważniejsze funkcje HoneyHive
- Automatyczne ewaluatory: Oceniaj wyniki agentów na żywo za pomocą kontroli opartych na kodzie lub metod z LLM jako sędzią, obejmujących dokładność użycia narzędzi, trafność kontekstu i spójność trajektorii.
- Kolejki adnotacji wykonywanych przez ludzi: Kieruj oznaczone ślady do ekspertów dziedzinowych w celu ich przeglądu, korzystając z niestandardowych kryteriów i uporządkowanych przepływów pracy związanych z adnotacjami.
- Selekcja i eksport zbiorów danych: Twórz zestawy testów regresyjnych na podstawie awarii produkcyjnych i eksportuj dane w formatach OTLP, Parquet lub JSONL do Snowflake, Databricks, BigQuery i innych systemów.
- Zarządzanie CI/CD jako kodem: Zarządzaj ewaluatorami, zbiorami danych, promptami i alertami za pomocą CLI, korzystając z wersjonowania w Git oraz automatyzacji CI do blokowania wdrożeń.
Integracje HoneyHive
HoneyHive obsługuje ponad 50 bibliotek instrumentacji, w tym AWS Strands Agents, CrewAI, n8n, Devin, Databricks i OpenAI Agents SDK. Oferuje również API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Natywne dla OTel śledzenie odtwarza długotrwałe sesje agentów
- Ewaluatory produkcyjne obejmują dokładność użycia narzędzi
- Zestawy testów regresyjnych powiększają się dzięki awariom produkcyjnym
Cons:
- Ocena wydaje się słabsza niż monitorowanie produkcyjne
- Szczegółowość przypisywania kosztów pozostaje nieudokumentowana
Learn more about HoneyHive: Najlepsze rozwiązanie do scalania promptów w CI/CD po pomyślnym przejściu ewaluacji
- Dostępny plan bezpłatny i bezpłatne demo
- Od 200 USD/miesiąc
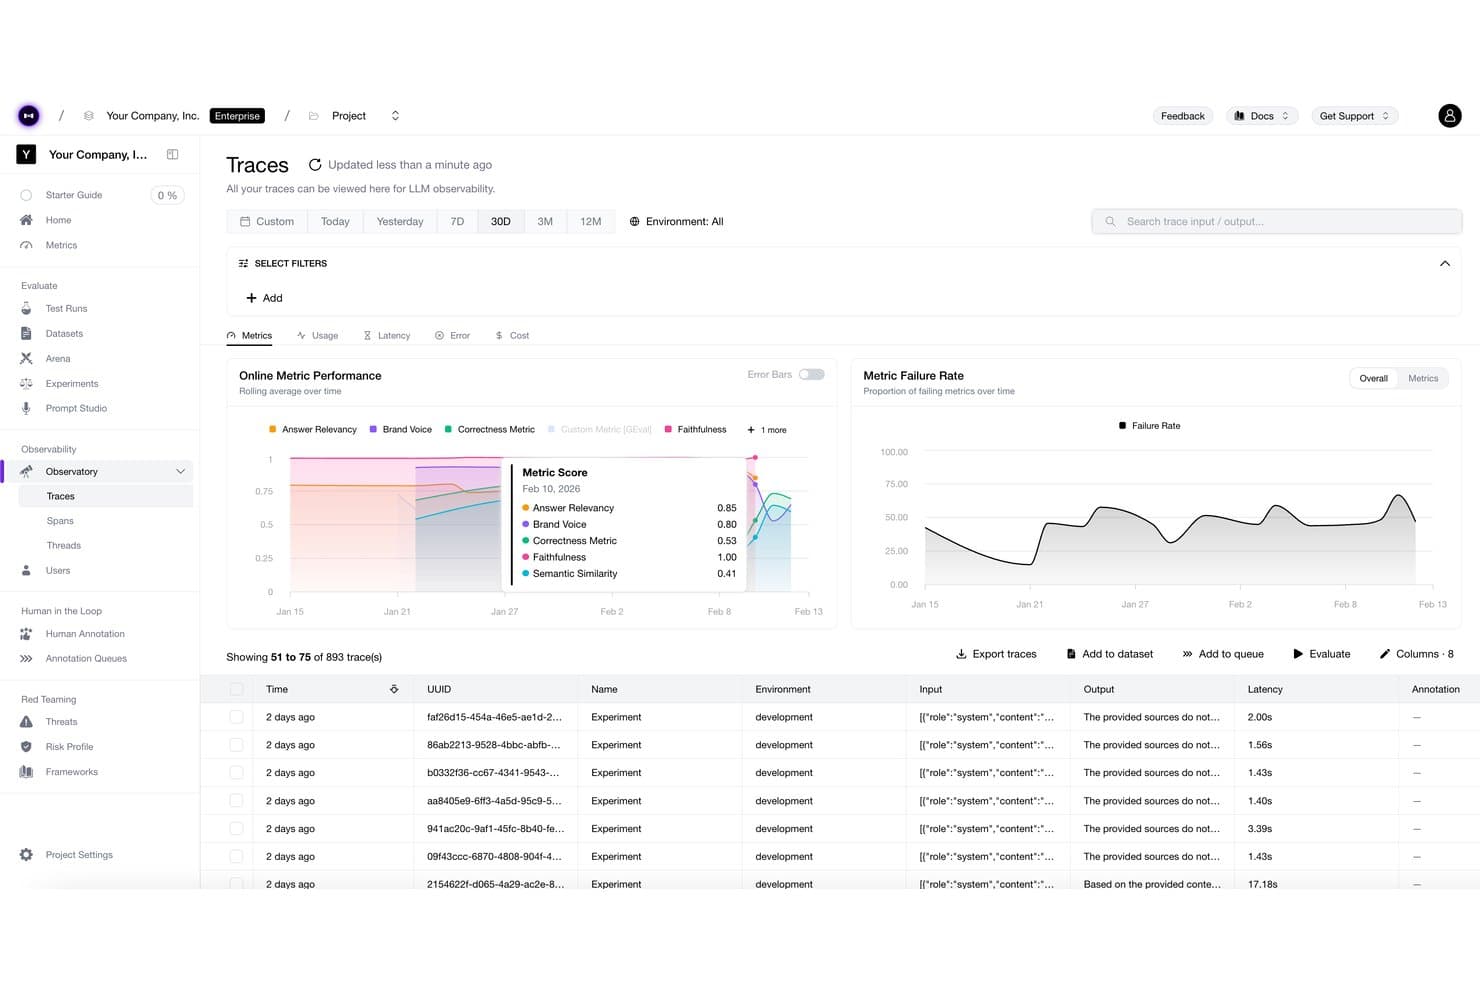
Confident AI śledzi w czasie metryki śladów LLM, takie jak wierność i opóźnienie. Confident AI to platforma do obserwowalności i ewaluacji LLM, która łączy rejestrowanie śladów, ocenianie jakości wyników, wersjonowanie promptów oraz oparte na Git przepływy pracy ewaluacji CI/CD w jednym interfejsie.
Dla kogo najlepiej nadaje się Confident AI?
Confident AI to doskonały wybór dla zespołów inżynieryjnych wdrażających aplikacje LLM, które traktują ewaluację jako część procesu wdrażania, a nie działanie wykonywane po fakcie.
Dlaczego wybrałem Confident AI
Wybrałem Confident AI jako jedno z najlepszych rozwiązań, ponieważ jego przepływy pracy z promptami oparte na Git są czymś, czego nie widziałem dotąd tak ściśle zrealizowanego w innych miejscach: prompty są rozgałęziane, przechodzą przez pull requesty i mogą zostać scalone wyłącznie wtedy, gdy wyniki ewaluacji faktycznie spełniają wymagania. Oznacza to, że regresja współczynnika halucynacji lub wyniku spójności automatycznie blokuje scalenie. Jego ewaluacje online są również niezawodne — uruchamiają ponad 30 wbudowanych metryk na rzeczywistym ruchu produkcyjnym, dzięki czemu spadki jakości są wykrywane, zanim zgłoszą je użytkownicy.
Najważniejsze funkcje Confident AI
- Testowanie symulacji rozmów: Uruchamiaj symulacje wieloetapowych rozmów w tysiącach scenariuszy, oceniając wyniki pod kątem spójności, współczynnika halucynacji i innych wbudowanych metryk.
- Automatyczne tworzenie zbiorów danych: Ślady produkcyjne są automatycznie przekształcane w oznaczone zbiory danych i bezpośrednio zasilają kolejną rundę ewaluacji, bez konieczności ręcznego eksportowania.
- Kolejki adnotacji wykonywanych przez ludzi: Przekierowuj oznaczone wyniki do recenzentów za pomocą niestandardowych kryteriów i formularzy, łącząc informacje zwrotne od ludzi z automatycznym ocenianiem w jednym przepływie pracy.
- Śledzenie wykonania: Śledź pełny cykl życia żądań LLM, aby wskazać miejsca występowania błędów.
Integracje Confident AI
Confident AI opisuje ponad 20 integracji, w tym OpenAI, LlamaIndex, Vercel AI SDK, CrewAI i Google ADK. Obsługuje również framework obserwowalności OpenTelemetry. Oferuje także REST API do tworzenia niestandardowych połączeń.
Pros and Cons
Pros:
- Scalanie promptów uzależnione od ewaluacji wykrywa regresje
- Ślady produkcyjne stają się zbiorami danych do ewaluacji
- Symulacje wieloetapowe ujawniają błędy w rozmowach
Cons:
- Brak udokumentowanych integracji z systemami obsługi incydentów w funkcji alertów
- Limity przechowywania śladów komplikują wdrożenia o dużym wolumenie
Learn more about Confident AI: Najlepsze rozwiązanie dla LLMOps natywnych dla bramy z hostingiem VPCVisit WebsiteCustomer Rating:4.6/5
 Learn more about Portkey:
 Najlepsze do sprawdzania halucynacji i dryfu
- Bezpłatne w użyciu
- Bezpłatne w użyciu
Learn more about Evidently AI: Learn more about LangWatch:
Inne narzędzia do obserwowalności LLM
Oto kilka dodatkowych platform, które nie trafiły na moją listę, ale nadal warto je sprawdzić:
Jak oceniam narzędzia do obserwowalności LLM
Podzieliłem swoją ocenę na podstawowe kryteria, które każde narzędzie musi spełniać — takie jak rejestrowanie śladów i ocena jakości wyników — oraz wyróżniki, które odróżniają najlepsze narzędzia od pozostałych.
Podstawowe funkcje (wymagania minimalne dla tej listy)
Wybierając narzędzia do swojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcji) do 5 (wyróżnia się w tym obszarze) pod kątem każdej z wymienionych poniżej podstawowych funkcji. Następnie przeliczam łączny wynik narzędzia na wartość procentową i wykorzystuję ją do oceny jego ogólnego dopasowania do listy.
- Rejestrowanie i wizualizacja śladów: Sprawdzam, czy narzędzie potrafi renderować zagnieżdżone, wieloetapowe ślady obejmujące wywołania agentów, pobieranie danych RAG i korzystanie z narzędzi, a nie tylko płaskie dzienniki żądań.
- Ocena jakości wyników: Szukam wbudowanego punktowania, niestandardowych ewaluatorów i opcji weryfikacji przez człowieka, które wykrywają halucynacje lub spadki trafności wyników na produkcji.
- Wersjonowanie instrukcji i modeli: Każde narzędzie powinno łączyć zmiany instrukcji lub modeli ze zmianami opóźnienia, kosztu lub jakości, aby można było wskazać, co spowodowało regresję.
- Alerty i monitorowanie w czasie rzeczywistym: Oceniam, czy platforma wykrywa anomalie w bieżącym ruchu i przekazuje alerty do narzędzi takich jak Slack lub PagerDuty bez konieczności ręcznego odpytywania.
- Śledzenie kosztów i tokenów: Szczegółowe zestawienia według wywołania, modelu lub projektu mają tu znaczenie — same zagregowane dane o zużyciu tokenów nie wystarczą do zarządzania wydatkami w zespołach.
- Zarządzanie zbiorami danych i opiniami: Szukam możliwości tworzenia zestawów testowych na podstawie produkcyjnych śladów oraz przekazywania opinii użytkowników z powrotem do pętli oceny w celu ciągłego doskonalenia.
Gdy mam już listę narzędzi spełniających kryteria, zastanawiam się, co wyróżnia każdą platformę.
Czynniki różnicujące (co wyróżnia dostawców)
Oto sposób, w jaki porównuję i przeciwstawiam sobie różnych dostawców:
Wyróżniające się funkcje
Szukam mechanizmów ochronnych i funkcji wykrywania zagrożeń, które w czasie rzeczywistym sygnalizują próby wstrzyknięcia instrukcji, wyciek danych osobowych (PII) i toksyczne treści — szczególnie gdy zespół obsługuje agentów skierowanych do klientów, gdzie pojedyncze obejście zabezpieczeń może spowodować poważne szkody. Opcje wdrożenia z własnym hostingiem i lokalnie są równie ważne, ponieważ zespoły z branż regulowanych potrzebują pełnej kontroli nad miejscem przechowywania instrukcji i uzupełnień. Oceniam również możliwości środowiska testowego instrukcji i porównywania różnic, sprawdzając, czy można zestawiać wersje instrukcji obok siebie wraz z wynikami na żywo przed wdrożeniem zmian na produkcję.
Nie tylko funkcje
Sprawdzam, czy narzędzie może działać w konfiguracji VPC lub lokalnie, ponieważ zespoły przetwarzające dane medyczne lub finansowe często nie mogą wysyłać instrukcji do współdzielonej chmury. Model cenowy jest równie ważny — rozliczanie oparte na użyciu i powiązane z liczbą śladów może szybko wymknąć się spod kontroli po zakończeniu etapu prototypowania, dlatego szukam przejrzystych poziomów cenowych lub opcji otwartoźródłowych, które pozwalają prognozować koszty przed podjęciem zobowiązania. Oceniam również, jak dobrze każda platforma pasuje do istniejących stosów technologicznych, sprawdzając natywne wsparcie SDK dla Python i JS oraz gotowe konektory do struktur takich jak LangChain lub LlamaIndex.
Jak wybrać odpowiednie narzędzie do obserwowalności LLM
Porównaj poniższe najważniejsze możliwości, aby znaleźć narzędzie odpowiadające Twoim priorytetom.
| Jeśli Twoim priorytetem jest | Poszukaj |
|---|---|
| Jeśli Twoim priorytetem jestOdtwarzanie awarii agentów | PoszukajEksportowalne zagnieżdżone ślady z informacjami o pobieraniu danych, narzędziach i zdarzeniach modelu |
| Jeśli Twoim priorytetem jestUdowodnienie jakości wyników | PoszukajOdtwarzalne zapisy ocen z kryteriami punktacji i uwagami recenzentów |
| Jeśli Twoim priorytetem jestKontrolowanie zmian promptów | PoszukajHistoria wersji łącząca prompty, modele, wyniki i rezultaty ocen |
| Jeśli Twoim priorytetem jestZarządzanie ryzykiem operacyjnym | PoszukajSpisane warunki dotyczące przechowywania danych, kontroli dostępu, usuwania i wdrażania |
| Jeśli Twoim priorytetem jestPrognozowanie wydatków | PoszukajZapisy dla poszczególnych żądań pokazujące tokeny, modele i mające zastosowanie jednostki użycia |
Jak zweryfikować swoją listę
- Przeprowadź określony test: Wyślij jeden wieloetapowy przepływ pracy agenta z wywołaniem pobierania danych i błędem narzędzia, a następnie sprawdź wyeksportowany ślad w ciągu 30 minut.
- Poproś o materiał z ewaluacji: Poproś o przykładowy raport pokazujący kryteria oceniającego, obliczenia punktacji, adnotacje człowieka oraz ślad źródłowy dla 10 wyników.
- Utwórz zgłoszenie do pomocy technicznej: Prześlij możliwe do odtworzenia pytanie dotyczące śledzenia i wymagaj pisemnej odpowiedzi, wskazania osoby odpowiedzialnej za eskalację oraz docelowego terminu rozwiązania w ciągu pięciu dni roboczych.
- Poproś o zapisy umowne: Uzyskaj pisemne klauzule obejmujące przechowywanie danych, termin usunięcia, dostęp podwykonawców oraz informację, czy prompty służą do trenowania modeli dostawcy.
- Wybierz kompromis: Wybierz kontrolę zapewnianą przez rozwiązanie o otwartym kodzie źródłowym lub hostowane samodzielnie zamiast wygody zarządzanej usługi albo zaakceptuj infrastrukturę zarządzaną przez dostawcę w zamian za mniejszą odpowiedzialność operacyjną.
Czym są narzędzia do obserwowalności LLM?
Narzędzia do obserwowalności LLM to platformy, które śledzą, monitorują i oceniają aplikacje wykorzystujące duże modele językowe. Rejestrują prompty, odpowiedzi, wywołania modeli, etapy wyszukiwania, użycie narzędzi, opóźnienia, tokeny, koszty i błędy w wieloetapowych procesach. Zespoły wykorzystują te dane do badania awarii, mierzenia jakości wyników, wykrywania problemów w środowisku produkcyjnym oraz łączenia zmian promptów lub modeli z rezultatami operacyjnymi.
Funkcje
Podczas oceny różnych platform zwróć uwagę na następujące kluczowe funkcje:
- Rejestrowanie i wizualizacja śladów: Rejestruje zagnieżdżone zdarzenia podczas wywołań modeli, etapów wyszukiwania, przetwarzania promptów, użycia narzędzi i logiki aplikacji. Wizualne osie czasu pomagają lokalizować awarie i rozumieć, jak każdy etap wpłynął na końcową odpowiedź.
- Ocena jakości wyników: Stosuje predefiniowane lub niestandardowe kryteria oceniania do wygenerowanych odpowiedzi. Zespoły mogą oceniać dokładność, trafność, bezpieczeństwo i inne miary jakości w zestawach danych testowych oraz przykładach produkcyjnych.
- Wersjonowanie promptów i modeli: Przechowuje razem szablony promptów, konfiguracje modeli i historię zmian. Pozwala to porównywać wersje i ustalać, czy zmiana wpłynęła na jakość, opóźnienia, liczbę błędów lub koszty użycia.
- Monitorowanie w czasie rzeczywistym i alerty: Śledzi działanie aplikacji na żywo i sygnalizuje problemy, takie jak rosnący współczynnik błędów, skoki opóźnień lub nietypowe użycie. Kierowanie alertów może wysyłać powiadomienia do narzędzi obsługi incydentów i współpracy.
- Śledzenie liczby tokenów i kosztów: Rejestruje tokeny wejściowe, tokeny wyjściowe, użycie modeli i powiązane opłaty dla poszczególnych żądań. Filtrowanie według projektu, środowiska, użytkownika lub modelu pomaga zespołom analizować wzorce wydatków.
- Zarządzanie zestawami danych i opiniami: Przekształca wybrane ślady produkcyjne w zestawy danych do oceny i przechowuje opinie recenzentów wraz z każdym przykładem. Tworzy to powtarzalny zapis umożliwiający testowanie zmian i śledzenie jakości w czasie.
- Wyszukiwanie i filtrowanie: Umożliwia znajdowanie śladów według identyfikatora żądania, użytkownika, modelu, wersji promptu, statusu, opóźnienia, tagów lub metadanych. Szczegółowe filtrowanie skraca czas potrzebny do wyizolowania konkretnego incydentu.
- Kontrola dostępu do danych i ich przechowywania: Określa, kto może wyświetlać, eksportować, usuwać lub przechowywać prompty i odpowiedzi. Mechanizmy te pomagają zespołom stosować wewnętrzne zasady bezpieczeństwa i zarządzać wrażliwymi zapisami produkcyjnymi.
- Obsługa integracji: Łączy się ze strukturami aplikacji, zestawami SDK języków programowania, standardami telemetrii i systemami współpracy. Szeroka obsługa integracji pozwala zespołom dodać obserwowalność bez przebudowy istniejących procesów.
Typowe funkcje AI
Oprócz wymienionych powyżej standardowych funkcji narzędzi do obserwowalności LLM wiele rozwiązań wykorzystuje AI za pomocą takich funkcji jak:
- Wyszukiwanie śladów w języku naturalnym: Umożliwia wysyłanie zapytań dotyczących danych śladów za pomocą codziennego języka, bez pisania filtrów ani zapytań do bazy danych. AI interpretuje żądanie i zwraca odpowiednie żądania, błędy, użytkowników lub etapy procesu.
- Automatyczna analiza przyczyn źródłowych: Bada powiązane zdarzenia podczas wywołań modeli, etapów wyszukiwania, użycia narzędzi i obsługi błędów aplikacji. Identyfikuje prawdopodobne przyczyny, takie jak nieudane wywołanie wyszukiwania, zmiana promptu lub czas i schemat odpowiedzi modelu.
- Podsumowania śladów generowane przez AI: Platforma przekształca długie, wieloetapowe ślady w krótkie wyjaśnienia tego, co się wydarzyło. Podsumowania te pomagają zespołom wsparcia i infrastruktury analizować incydenty bez ręcznego odczytywania każdego zdarzenia.
- Grupowanie semantyczne: Grupuje ślady według znaczenia, zamiast opierać się wyłącznie na tagach, kodach statusu lub dokładnych dopasowaniach tekstu. Zespoły mogą wykorzystywać te grupy do znajdowania powtarzających się typów żądań, wzorców awarii lub nieoczekiwanych pytań użytkowników.
- Wykrywanie wstrzyknięć promptów: Analizuje dane wejściowe użytkowników i interakcje z modelami pod kątem instrukcji zaprojektowanych w celu zastąpienia promptów systemowych lub manipulowania działaniem agenta. Wyniki wykrywania mogą wspierać analizę, reguły blokowania i przeglądy bezpieczeństwa.
- Wykrywanie danych wrażliwych: Identyfikuje dane osobowe, finansowe, zdrowotne lub poufne w promptach i odpowiedziach. Zespoły mogą wykorzystywać te ustalenia do anonimizowania zapisów, analizowania naruszeń zasad i ograniczania ujawnienia danych w przechowywanych śladach.
Korzyści
Platforma do obserwowalności LLM oferuje wiele korzyści dla zespołu i firmy. Oto kilka z nich:
- Szybsze badanie incydentów: Zagnieżdżone ślady łączą prompty, wywołania modeli, etapy wyszukiwania, narzędzia, opóźnienia i błędy na jednej osi czasu.
- Wyższa jakość wyników: Wbudowane ewaluatory, niestandardowe kryteria oceniania, zbiory danych i oceny dokonywane przez ludzi pomagają identyfikować halucynacje, problemy z trafnością i kwestie bezpieczeństwa.
- Bezpieczniejsze przepływy pracy w środowisku produkcyjnym: Wykrywanie wstrzyknięć promptów i danych wrażliwych może oznaczać ryzykowne dane wejściowe, odpowiedzi i interakcje agentów do dalszej analizy.
- Wyraźniejszy wpływ zmian: Historia wersji promptów i modeli łączy zmiany konfiguracji ze zmianami jakości, opóźnień, liczby błędów i wykorzystania tokenów.
- Lepsza kontrola wydatków: Rejestry tokenów i kosztów dla poszczególnych żądań pokazują, jak wykorzystanie różni się w zależności od modelu, projektu, środowiska lub użytkownika.
- Sprawniejsze reagowanie operacyjne: Monitorowanie w czasie rzeczywistym, przeszukiwalne ślady i alerty pomagają zespołom wykrywać anomalie i kierować incydenty do kanałów reagowania.
Cennik
Wybór odpowiedniego narzędzia wymaga zrozumienia dostępnych modeli cenowych i planów. Koszty różnią się w zależności od funkcji, wielkości zespołu, dodatków i skali wykorzystania. Poniższa tabela przedstawia typowe plany, średnie ceny i najczęściej uwzględniane funkcje oprogramowania do obserwowalności LLM.
Tabela porównawcza planów narzędzi do obserwowalności LLM
| Typ planu | Średnia cena | Typowe funkcje |
|---|---|---|
| Typ planuPlan bezpłatny | Średnia cena$0/month | Typowe funkcjePodstawowe rejestrowanie śladów, ograniczony czas przechowywania, wsparcie społeczności i limity wykorzystania. |
| Typ planuPlan osobisty | Średnia cena$10-$50/user/month | Typowe funkcjeWizualizacja śladów, śledzenie tokenów, monitorowanie promptów, zarządzanie zbiorami danych i pomoc przez e-mail. |
| Typ planuPlan biznesowy | Średnia cena$100-$500/month | Typowe funkcjeZaawansowane ewaluacje, alerty w czasie rzeczywistym, uprawnienia zespołowe, integracje i wydłużony czas przechowywania danych. |
| Typ planuPlan dla przedsiębiorstw | Średnia cena$500-$5,000/month | Typowe funkcjeNiestandardowe limity wykorzystania, jednokrotne logowanie, dzienniki audytowe, opcje wdrożenia prywatnego, dedykowane wsparcie i ustalane umownie zasady przechowywania danych. |
Najczęściej zadawane pytania
Oto odpowiedzi na niektóre często zadawane pytania dotyczące narzędzi do obserwowalności LLM:
Czy narzędzia do obserwowalności LLM zastępują tradycyjne monitorowanie aplikacji?
Nie, narzędzia do obserwowalności uzupełniają tradycyjne monitorowanie aplikacji, rejestrując prompty, odpowiedzi, ustawienia modeli, etapy wyszukiwania i wyniki ewaluatorów. Połącz oba rozwiązania podczas badania incydentów produkcyjnych. Na przykład ślad LLM może ujawnić nieprawidłowe zapytanie wyszukiwania, podczas gdy dzienniki aplikacji pokażą przekroczenie czasu oczekiwania bazy danych, które nastąpiło później. Razem te informacje pomagają oddzielić zachowanie modelu od problemów aplikacji lub infrastruktury.
Czy narzędzia do obserwowalności LLM mogą obsługiwać wrażliwe dane produkcyjne?
Tak, niektóre narzędzia do obserwowalności LLM obsługują mechanizmy kontroli wrażliwych danych produkcyjnych. Przed wdrożeniem sprawdź okresy przechowywania, procedury usuwania, szczegóły szyfrowania, uprawnienia dostępu i mechanizmy kontroli eksportu. Zapytaj, czy dostawca wykorzystuje prompty lub odpowiedzi do trenowania swoich modeli. Potwierdź również dostęp podprocesorów i dostępne modele wdrożenia. Wdrożenie samodzielnie hostowane lub prywatne może ograniczyć zakres, w jakim dane śladów są przesyłane. Podczas oceny przesyłaj zredagowane rekordy testowe i sprawdź, jak maskowanie jest prezentowane w przechowywanych śladach, eksportach i wynikach ewaluatorów.
Czy należy wybrać narzędzie do obserwowalności LLM o otwartym kodzie źródłowym czy zarządzane?
Wybierz oprogramowanie o otwartym kodzie źródłowym, gdy najważniejsze są kontrola nad wdrożeniem, dostęp do kodu źródłowego i przewidywalna odpowiedzialność za infrastrukturę. Wybierz zarządzaną platformę, gdy zespół potrzebuje hostowanego przez dostawcę przechowywania danych, aktualizacji i wsparcia. Porównuj więcej niż tylko cenę subskrypcji. Uwzględnij czas pracy inżynierów potrzebny na wdrożenie, aktualizacje, kontrolę dostępu, kopie zapasowe i zasady przechowywania danych. Następnie przetestuj ten sam przepływ pracy w obu opcjach. Sprawdź szczegółowość śladów, konfigurację ewaluatorów, dostarczanie alertów i formaty eksportu. Lepszy wybór odpowiada wymaganiom bezpieczeństwa i dostępnej zdolności operacyjnej.
Jak przetestować narzędzie do obserwowalności LLM przed zakupem?
Przeprowadź test z wieloetapowym przepływem pracy obejmującym wyszukiwanie, wywołania narzędzi i błędy. Upewnij się, że ślad zachowuje kolejność zdarzeń, dane wejściowe, dane wyjściowe, opóźnienia, tokeny i szczegóły błędów. Następnie przejrzyj wyniki ewaluatorów i śledzenie wersji promptów. Na koniec wyeksportuj rekordy i sprawdź nazwy pól, znaczniki czasu oraz sposób redagowania danych. Taka próba ujawnia luki, które demonstracje produktów często ukrywają.