

Narzędzia do jezior danych pozwalają przechowywać, organizować i analizować ogromne ilości ustrukturyzowanych i nieustrukturyzowanych danych w całej firmie. Jeśli porównujesz najlepsze narzędzia do jezior danych, nie możesz pozwolić sobie na zgadywanie — która platforma zapewni Twojemu zespołowi kontrolę nad kosztami, zgodnością i wydajnością w miarę wzrostu ilości danych?
W tym przewodniku przedstawię sprawdzone rozwiązania, które pomagają liderom IT zapewnić zarządzanie, skalowalność, integrację i gotowość na przyszłość, aby można było z przekonaniem wybrać odpowiednią podstawę dla obciążeń analitycznych i AI w 2026.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza narzędzi do jezior danych
Ta tabela porównawcza przedstawia szczegóły cenowe wybranych przeze mnie najlepszych narzędzi do jezior danych:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepszy wybór dla automatycznie optymalizowanych środowisk łączących jezioro danych z hurtownią danych Apache Iceberg | Dostępna bezpłatna wersja próbna | Od $300/miesiąc (rozliczane rocznie) | Website | |
| 2 | Najlepszy wybór do zarządzania hybrydowym jeziorem danych w regulowanych przedsiębiorstwach | Dostępny 60-dniowy bezpłatny okres próbny | Od $0.04/CCU/godz. | Website | |
| 3 | Najlepszy wybór dla otwartego lakehouse'a Iceberg bez uzależnienia od dostawcy | 30-dniowy bezpłatny okres próbny | Od $0.20/DCU | Website | |
| 4 | Najlepsze rozwiązanie do zarządzania jeziorem danych w branżach regulowanych | Dostępna bezpłatna prezentacja | Ceny dostępne na żądanie | Website | |
| 5 | Najlepszy do zapewniania nadzoru nad otwartymi tabelami jeziora danych z wielu silników | 90-dniowy bezpłatny okres próbny | Od $0.12 za godzinę DCU | Website | |
| 6 | Najlepszy do magazynowania obiektów stanowiącego podstawę jezior danych AWS | Niedostępna | Od 0,023 USD/GB/miesiąc | Website | |
| 7 | Najlepsze rozwiązanie dla firmowych jezior danych opartych na technologiach Microsoft | Kredyt w wysokości 200 USD na 30 dni (brak dedykowanego bezpłatnego planu) | Od 0,023 USD/GB/miesiąc | Website | |
| 8 | Najlepsze rozwiązanie dla otwartego lakehouse z dostępem do danych mainframe | Dostępny bezpłatny plan | Od 83,30 USD/miesiąc | Website | |
| 9 | Najlepsze rozwiązanie do integracji jeziora danych ze stosem Microsoft | Bezpłatny 60-dniowy okres próbny | Od $262.80/miesiąc | Website | |
| 10 | Najlepsze rozwiązanie do federacyjnego SQL w ramach jezior danych w wielu chmurach | 30-dniowy bezpłatny okres próbny + dostępny bezpłatny plan | Od $0.50/kredyt | Website |




Recenzje narzędzi do jezior danych
Poniżej znajdują się moje szczegółowe podsumowania najlepszych narzędzi do jezior danych, które znalazły się na mojej krótkiej liście. W recenzjach szczegółowo omawiam funkcje, możliwości i najlepsze zastosowania każdej platformy, aby pomóc Ci znaleźć rozwiązanie najlepiej dopasowane do Twoich potrzeb.
 1Najlepszy wybór dla automatycznie optymalizowanych środowisk łączących jezioro danych z hurtownią danych Apache Iceberg
Qlik
- Dostępna bezpłatna wersja próbna
- Od $300/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.4/5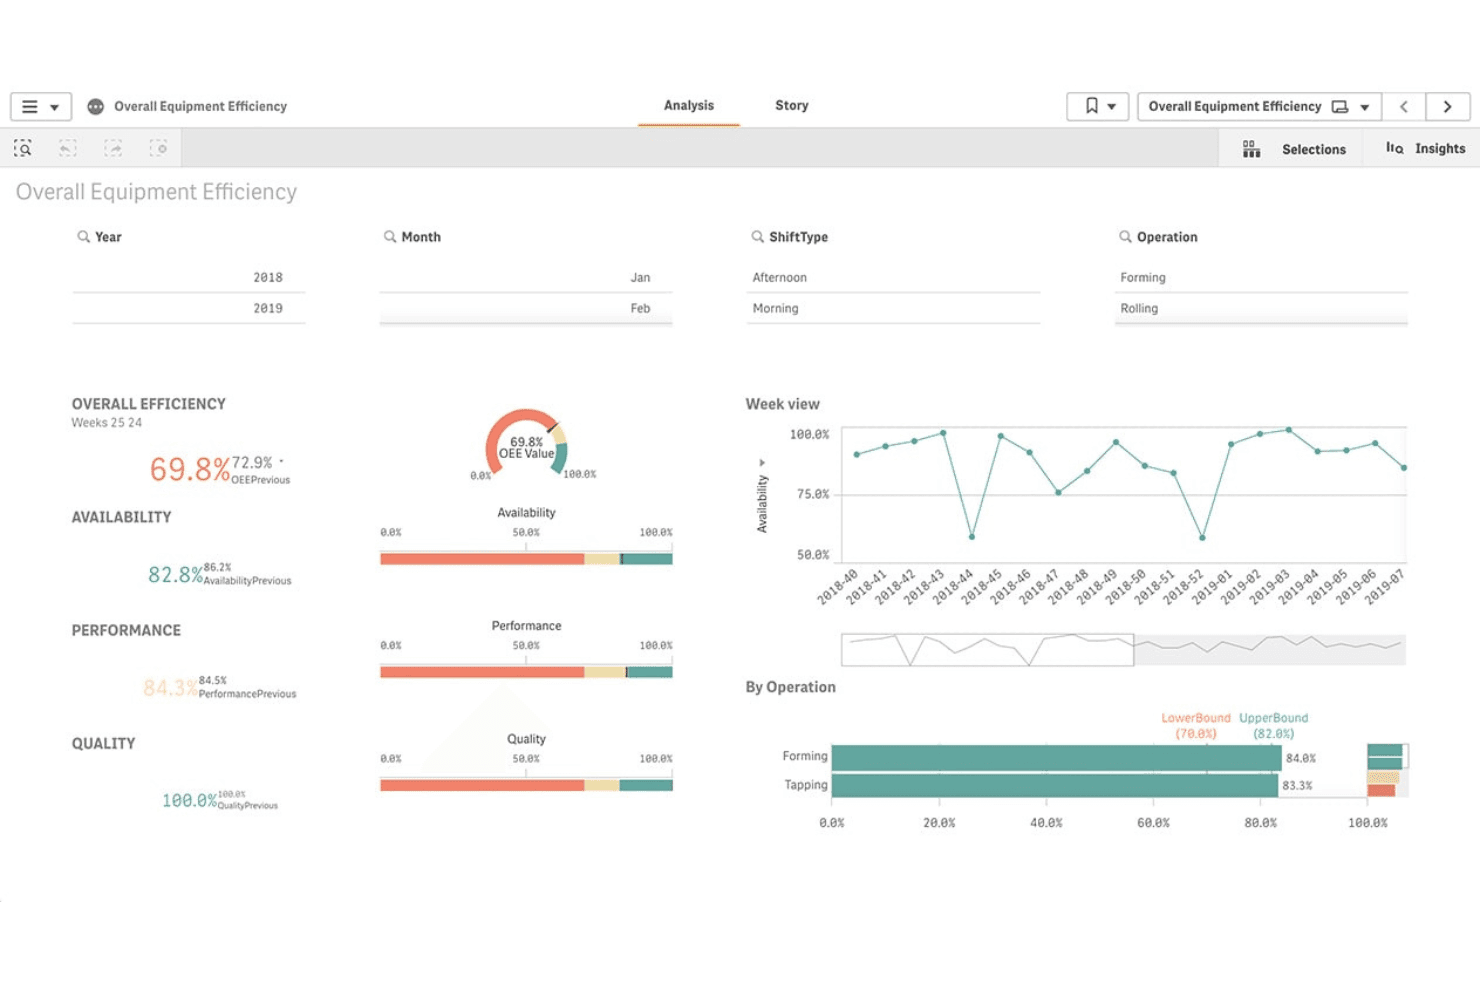
Qlik śledzi ogólną efektywność wyposażenia za pomocą pulpitów nawigacyjnych KPI z danymi na żywo. Qlik jest platformą integracji danych i środowiskiem łączącym jezioro danych z hurtownią danych, zbudowanym natywnie na Apache Iceberg. Łączy pozyskiwanie danych oparte na CDC, automatyczną ewolucję schematów, potoki danych obsługujące wiele formatów oraz wbudowane mechanizmy zarządzania w środowiskach korzystających z chmurowej pamięci obiektowej.
Dla kogo Qlik jest najlepszym wyborem?
Qlik doskonale sprawdza się w dużych przedsiębiorstwach z regulowanych branż, które potrzebują kompleksowej integracji danych, zarządzania nimi i obsługi środowiska łączącego jezioro danych z hurtownią danych na jednej platformie.
Dlaczego wybrałem Qlik
Wybrałem Qlik, ponieważ jego adaptacyjny optymalizator Iceberg go wyróżnia: stale przeprowadza kompaktowanie, indeksowanie i czyszczenie migawek w tabelach Iceberg bez konieczności ręcznego dostrajania, zapewniając od 2,5 do 5 razy większą szybkość zapytań oraz do 50% oszczędności na kosztach pamięci masowej. Korzystam również z replikacji bez kopiowania, aby przesyłać aktywne tabele Iceberg bezpośrednio do Snowflake bez duplikowania danych i zwiększania złożoności potoków.
Najważniejsze funkcje Qlik
- Replikacja CDC oparta na dziennikach: Qlik Replicate przechwytuje zmiany bezpośrednio z dzienników transakcji baz danych, bez konieczności stosowania agentów, dzięki czemu dane w środowisku łączącym jezioro danych z hurtownią danych pozostają aktualne bez wpływu na wydajność systemu źródłowego.
- Potok pozyskiwania danych obsługujący wiele formatów: Pozyskuj dane w formatach Parquet, Avro, ORC, JSON i CSV z ponad 200 źródeł — w tym baz danych, aplikacji SaaS, systemów SAP, komputerów mainframe oraz platform strumieniowych, takich jak Kafka i Kinesis.
- Pochodzenie danych na poziomie kolumn i analiza wpływu: Śledź dane od źródła do miejsca wykorzystania na poziomie kolumn, uzyskując przejrzysty ślad audytowy na potrzeby zarządzania danymi i raportowania zgodności.
- Automatyczne zarządzanie strefami brązową, srebrną i złotą: Qlik Compose for Data Lakes automatyzuje generowanie schematów, tworzenie katalogu Hive oraz ciągłe aktualizacje stref za pośrednictwem CDC — eliminując konieczność ręcznego kodowania potoków w wielopoziomowych architekturach łączących jezioro danych z hurtownią danych.
Integracje Qlik
Qlik obsługuje ponad 200 źródeł pozyskiwania danych, w tym Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP i Salesforce. Jego tabele Iceberg integrują się z rozwiązaniami Spark, Amazon Athena, Trino, Presto, Databricks, Dremio i Tableau.
Pros and Cons
Pros:
- Automatycznie optymalizowane zarządzanie tabelami Apache Iceberg
- Zaawansowana replikacja CDC w czasie rzeczywistym oparta na dziennikach
- Rozbudowane mechanizmy zgodności i zarządzania danymi dla przedsiębiorstw
Cons:
- Złożona platforma o wysokich wymaganiach technicznych
- Nieprzejrzysty proces licencjonowania i szacowania kosztów
Learn more about Qlik: Najlepszy wybór do zarządzania hybrydowym jeziorem danych w regulowanych przedsiębiorstwach
- Dostępny 60-dniowy bezpłatny okres próbny
- Od $0.04/CCU/godz.
Visit WebsiteCustomer Rating:4.1/5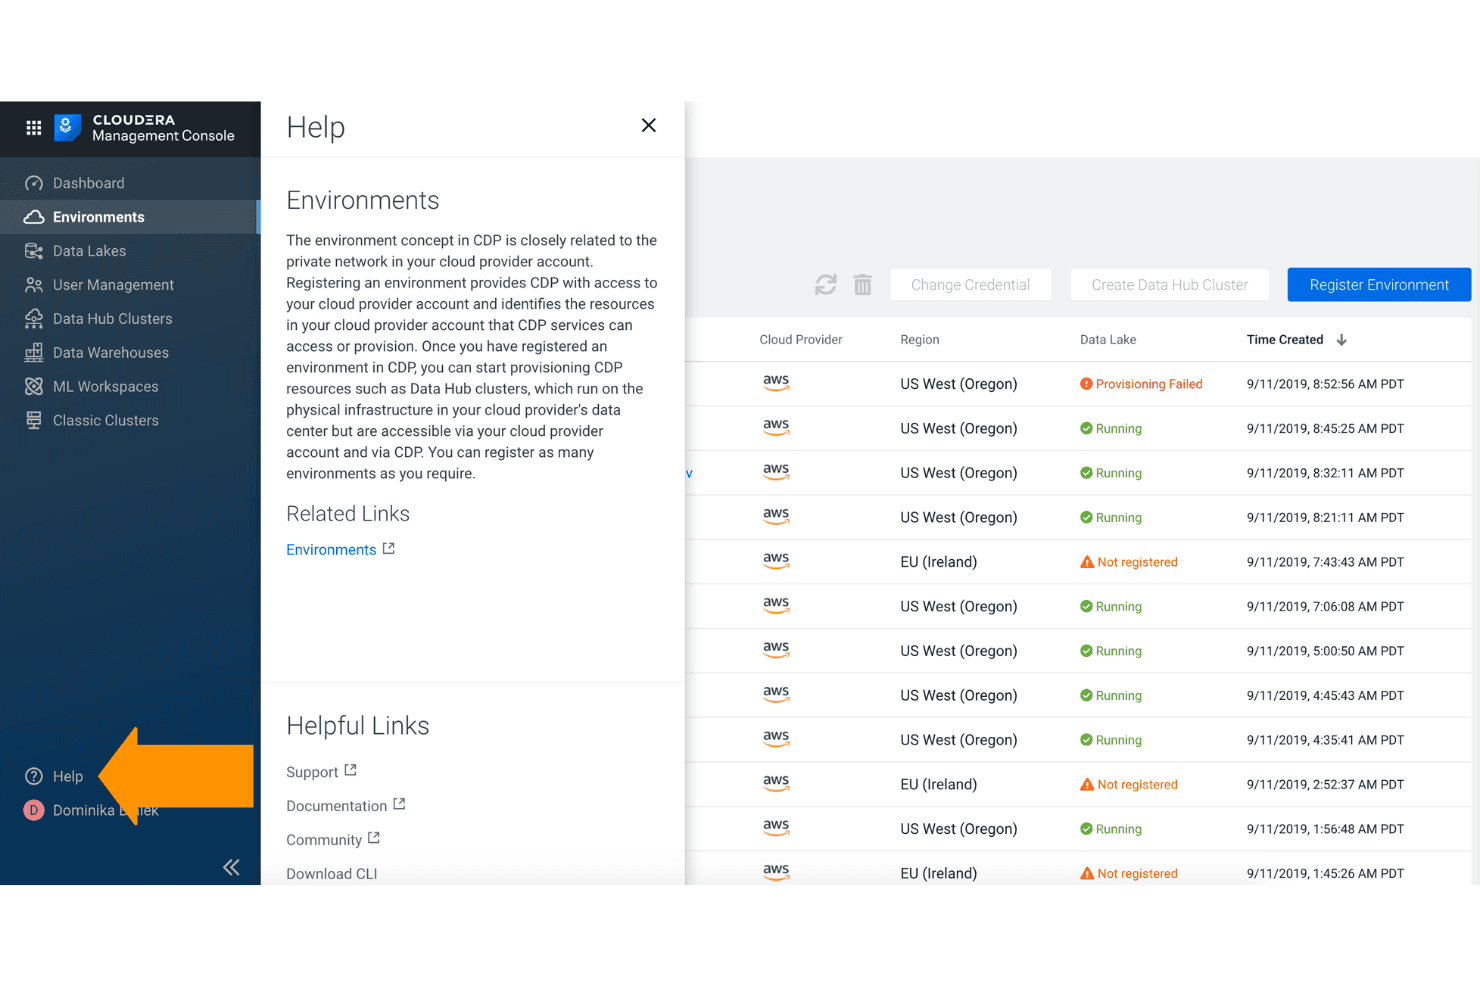
Cloudera umożliwia użytkownikom zarządzanie środowiskami chmurowymi i monitorowanie ich w różnych regionach. Cloudera to otwarta platforma jeziora danych typu lakehouse, obejmująca skalowalne przechowywanie danych w wielu chmurach i lokalnie, pozyskiwanie danych w wielu formatach za pośrednictwem ponad 450 konektorów, schemat na odczyt oparty na Apache Iceberg oraz scentralizowane zarządzanie w środowiskach hybrydowych.
Dla kogo Cloudera jest najlepszym wyborem?
Cloudera dobrze sprawdza się w dużych przedsiębiorstwach z regulowanych branż — bankowości, administracji publicznej i telekomunikacji — które potrzebują ujednoliconego zarządzania w środowiskach lokalnych i wielu chmur.
Dlaczego wybrałem Cloudera
Cloudera znalazła się na mojej krótkiej liście, ponieważ żadna inna platforma nie dorównuje jej pod względem głębi zarządzania w środowiskach hybrydowych. Szczególnie imponuje mi Cloudera SDX, która pozwala raz zastosować zasady Apache Ranger i Apache Atlas, a następnie egzekwować je wszędzie — niezależnie od tego, czy dane znajdują się w lokalnym klastrze HDFS, Azure ADLS czy AWS S3. Banki i agencje rządowe korzystające ze zróżnicowanej infrastruktury mogą centralnie definiować reguły maskowania na poziomie kolumn oraz zasady ABAC, a certyfikaty FedRAMP Moderate i PCI DSS 4.0 dodatkowo potwierdzają zgodność z wymogami.
Najważniejsze funkcje Cloudera
- Podróż w czasie Apache Iceberg: Wysyłaj zapytania dotyczące historycznych migawek danych z dowolnego momentu, korzystając z wbudowanego wersjonowania i funkcji podróży w czasie Iceberg.
- Optymalizator lakehouse: Automatyzuje kompaktowanie tabel Iceberg, porządkowanie Z oraz przycinanie partycji, aby poprawić wydajność zapytań i zmniejszyć koszty obliczeniowe.
- Wizualny kreator potoków Cloudera Data Flow (NiFi): Projektuj i wdrażaj potoki pozyskiwania danych za pomocą interfejsu typu „przeciągnij i upuść”, korzystając z ponad 450 gotowych procesorów i konektorów.
- Udostępnianie danych bez kopiowania za pośrednictwem Iceberg REST Catalog: Zewnętrzne silniki, takie jak Databricks, Snowflake i Athena, mogą bezpośrednio odpytywać zarządzane przez Cloudera tabele Iceberg bez przenoszenia ani powielania danych.
Integracje Cloudera
Cloudera Data Flow oferuje ponad 450 gotowych konektorów, w tym Apache Kafka, MongoDB, Salesforce, Snowflake i Google BigQuery. Integruje się również z AWS, Microsoft Azure, Google Cloud Platform, Databricks, Tableau i Power BI za pośrednictwem Iceberg REST Catalog.
Pros and Cons
Pros:
- Niezrównana obsługa środowisk hybrydowych i lokalnych
- Zarządzanie klasy korporacyjnej na potrzeby rygorystycznych wymogów zgodności
- Udostępnianie bez kopiowania między zewnętrznymi silnikami zapytań
Cons:
- Początkowa konfiguracja często wymaga specjalistycznych umiejętności
- Zadowolenie z zarządzania metadanymi poniżej średniej konkurencji
Learn more about Cloudera: Najlepszy wybór dla otwartego lakehouse'a Iceberg bez uzależnienia od dostawcy
- 30-dniowy bezpłatny okres próbny
- Od $0.20/DCU
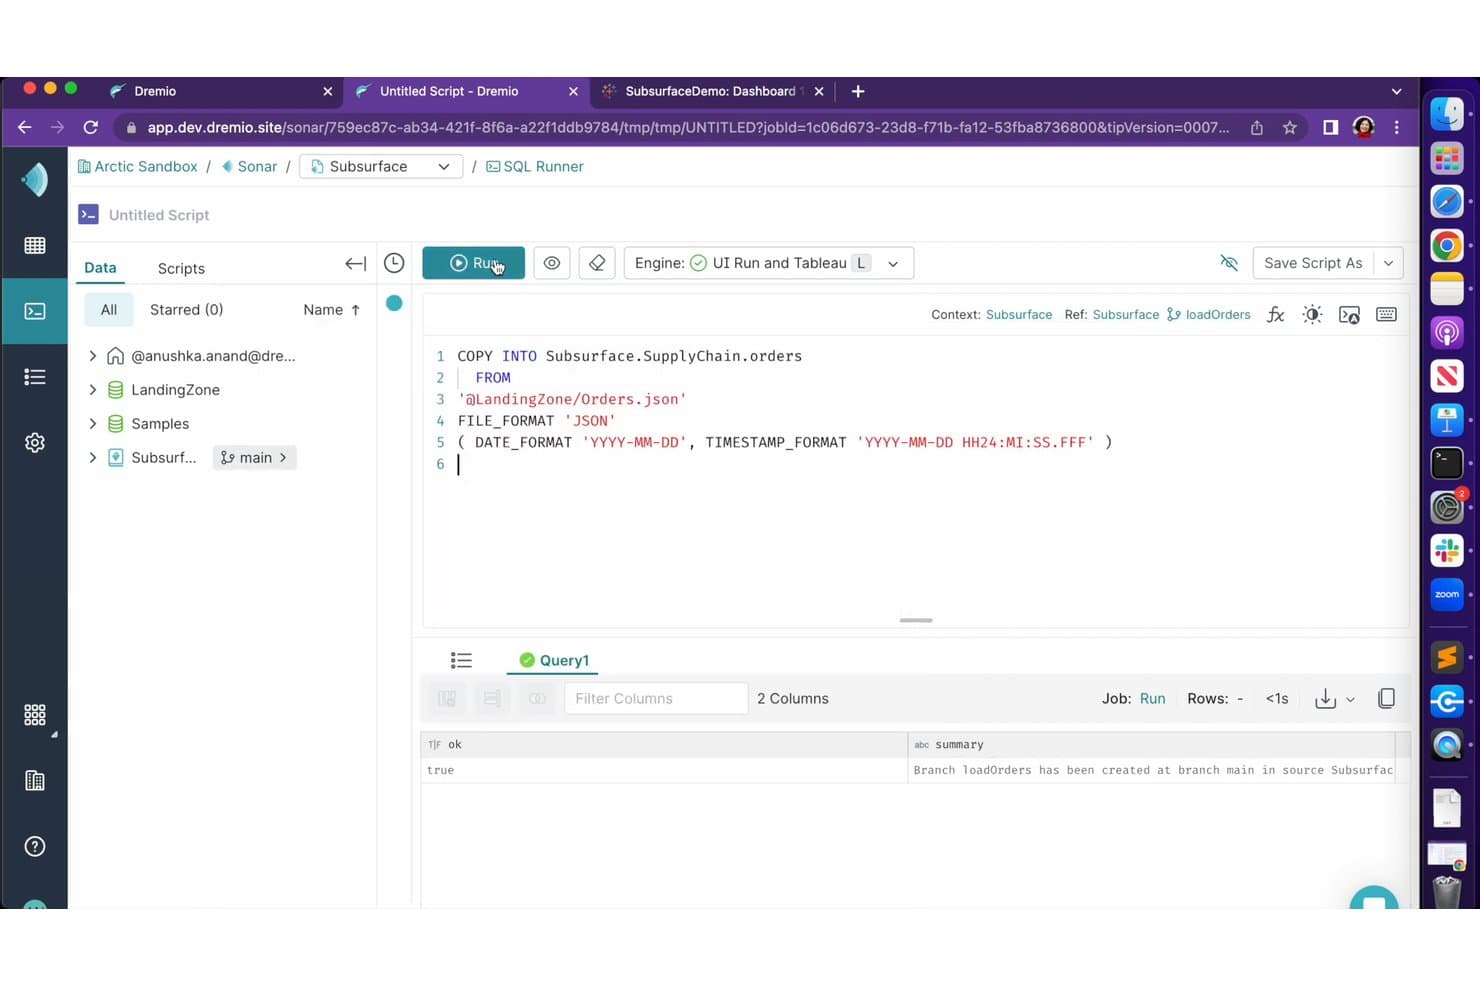
Dremio umożliwia użytkownikom ładowanie danych JSON do tabel za pomocą poleceń SQL COPY INTO. Dremio to otwarta platforma lakehouse zbudowana natywnie na Apache Iceberg i Apache Arrow, łącząca silnik zapytań SQL, sfederowany dostęp do danych, automatyczne przyspieszanie zapytań, przechowywanie wersji danych w stylu Git oraz otwarty katalog obsługujący wiele silników.
Dla kogo Dremio jest najlepszym wyborem?
Dremio doskonale sprawdzi się w zespołach zajmujących się inżynierią danych i architekturą, które budują otwarte lakehouse'y na Apache Iceberg i potrzebują dostępu do zapytań z wielu silników bez uzależnienia od zastrzeżonego katalogu lub formatu przechowywania.
Dlaczego wybrałem Dremio
Dremio znalazło się na mojej krótkiej liście, ponieważ zostało zbudowane natywnie na Apache Iceberg, co oznacza, że dane pozostają w należących do Ciebie zasobnikach S3 lub ADLS, a każdy silnik (Spark, Flink, Trino, DuckDB) może je odczytywać i zapisywać za pośrednictwem otwartego katalogu Polaris bez konwersji formatu. Szczególnie podoba mi się funkcja Autonomous Reflections, która dyskretnie analizuje wzorce zapytań i w tle materializuje przyspieszenia, dzięki czemu pulpity BI zwracają wyniki szybko, bez konieczności ręcznego dostrajania lub korzystania z zastrzeżonych ekstraktów.
Najważniejsze funkcje Dremio
- Otwarty katalog (Apache Polaris): Katalog obsługujący wiele silników, zbudowany na Apache Polaris, który pozwala narzędziom Spark, Flink, Trino i DuckDB odczytywać i zapisywać tabele Iceberg za pośrednictwem standardowego interfejsu REST.
- Rozgałęzianie danych jako kodu: Kontrola wersji w stylu Git za pośrednictwem Project Nessie tworzy izolowane gałęzie danych bez kopiowania danych na potrzeby programowania, testowania i eksperymentów uczenia maszynowego, zapewniając atomowe scalanie i wycofywanie zmian.
- Pozyskiwanie za pomocą COPY INTO: Natywne polecenie SQL, które zbiorczo ładuje pliki CSV, JSON i Parquet z magazynu obiektowego bezpośrednio do tabel Iceberg, z obsługą ewolucji schematu i partycjonowania.
- Szczegółowa kontrola dostępu: Bezpieczeństwo na poziomie wierszy i maskowanie kolumn wymuszane w czasie wykonywania zapytania, stosowane spójnie we wszystkich silnikach odpytujących katalog.
Integracje Dremio
Dremio integruje się z Apache Spark, Apache Flink, Trino, DuckDB, Tableau, Power BI, dbt Core, Amazon S3, Azure Data Lake Storage i Google Cloud Storage. Jego interfejsy Polaris REST Catalog, ODBC, JDBC i Arrow Flight obsługują połączenia z niestandardowymi silnikami i aplikacjami.
Pros and Cons
Pros:
- Natywne przetwarzanie Apache Iceberg bez konwersji
- Rozgałęzianie danych w stylu Git na potrzeby podróży w czasie
- Otwarty katalog REST łączy się z dowolnym silnikiem zapytań
Cons:
- Administracja bardziej złożona niż w konkurencyjnych narzędziach
- Brak dedykowanego wbudowanego magazynu funkcji uczenia maszynowego
Learn more about Dremio: Najlepsze rozwiązanie do zarządzania jeziorem danych w branżach regulowanych
- Dostępna bezpłatna prezentacja
- Ceny dostępne na żądanie
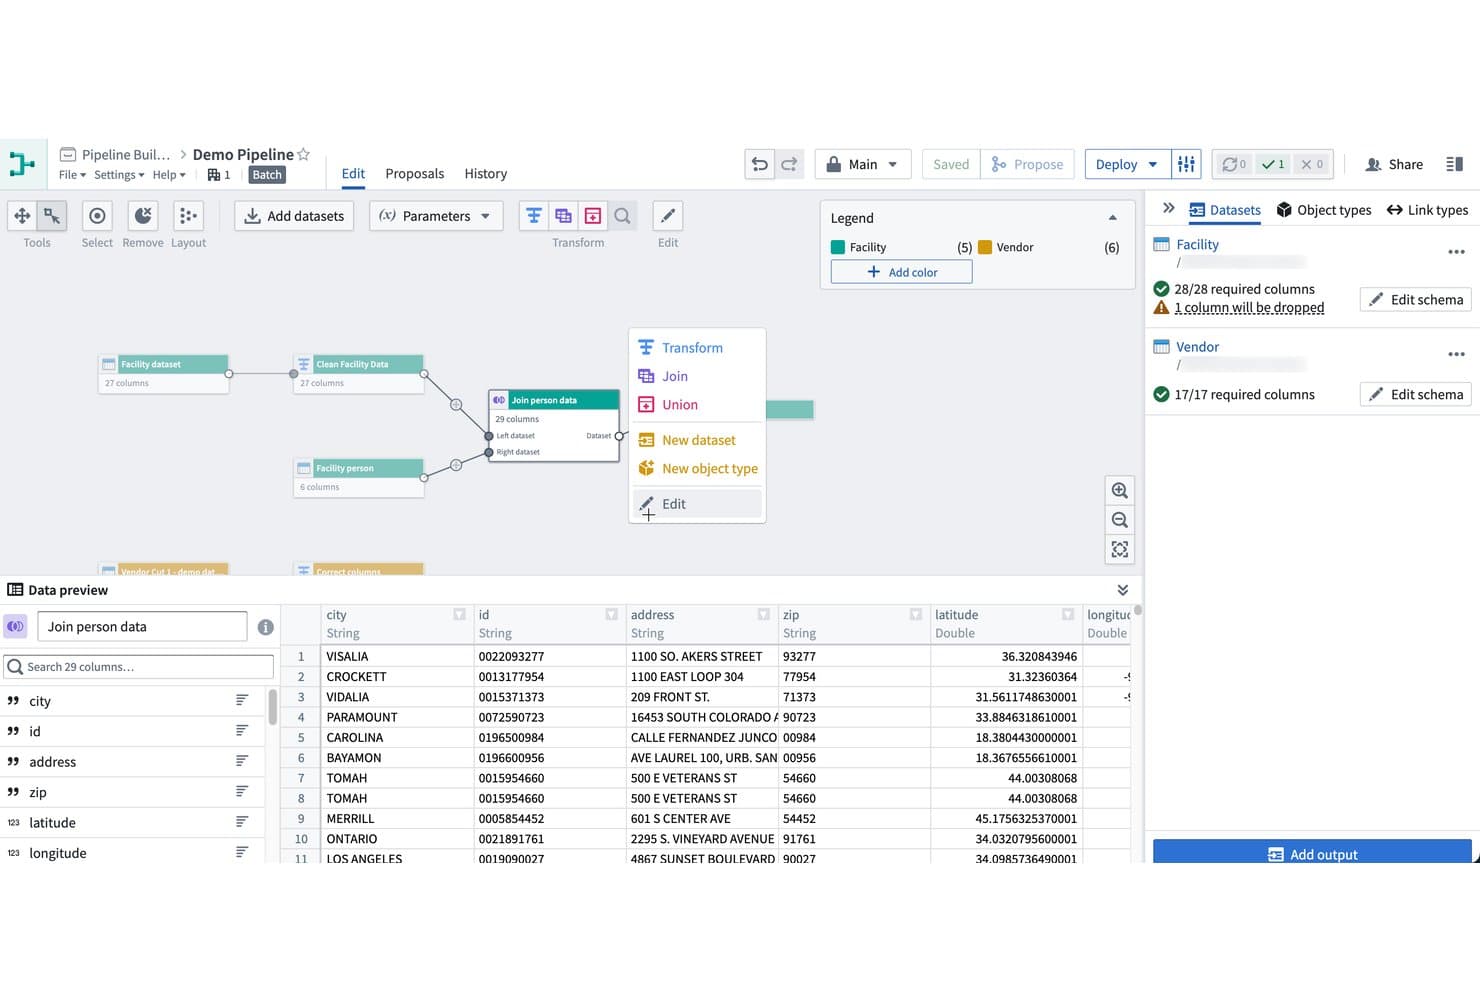
Palantir Foundry umożliwia użytkownikom wizualne tworzenie zbiorów danych i łączenie ich w potokach. Palantir Foundry to platforma jeziora danych, która łączy pozyskiwanie danych w wielu formatach, orkiestrację potoków, semantyczne modelowanie danych za pośrednictwem warstwy Ontology oraz wbudowane mechanizmy zarządzania w środowiskach chmurowych, lokalnych i odizolowanych od sieci.
Dla kogo Palantir Foundry jest najlepszym wyborem?
Palantir Foundry został stworzony z myślą o dużych przedsiębiorstwach z branż regulowanych — finansowej, opieki zdrowotnej, obronnej i administracji publicznej — które potrzebują szczegółowego zarządzania danymi w złożonych środowiskach korzystających z wielu źródeł.
Dlaczego wybrałem Palantir Foundry
Wybrałem Palantir Foundry, ponieważ jego architektura zarządzania danymi naprawdę nie ma sobie równych w branżach regulowanych. Platforma łączy mechanizmy kontroli dostępu oparte na przeznaczeniu, klasyfikacji i rolach, a oznaczenia danych są automatycznie propagowane wzdłuż pochodzenia danych, dzięki czemu znacznik PII przypisany do źródłowego zbioru danych podąża za danymi przez każdą kolejną transformację. Dodajmy do tego certyfikaty FedRAMP High, HIPAA, ITAR i SOC 2 Type 2 oraz warstwę Ontology, która odwzorowuje surowe dane z jeziora na możliwe do audytowania obiekty biznesowe — otrzymujemy platformę stworzoną od podstaw z myślą o środowiskach, w których zarządzanie danymi nie jest opcjonalne.
Najważniejsze funkcje Palantir Foundry
- Ponad 200 gotowych konektorów danych: Łącz się z bazami danych, hurtowniami danych, platformami strumieniowymi, systemami ERP, pamięcią masową w chmurze, źródłami IoT i narzędziami geoprzestrzennymi za pośrednictwem jednego interfejsu pozyskiwania danych.
- Katalog REST Apache Iceberg: Udostępniaj zbiory danych Foundry zewnętrznym silnikom obliczeniowym zgodnym z Iceberg — w tym Trino, Spark, Flink, Databricks i Snowflake — bez duplikowania danych.
- Wirtualne tabele do federacji bez kopiowania: Wykonuj zapytania dotyczące zewnętrznych tabel w Databricks, Snowflake i magazynach zgodnych z S3 bezpośrednio z Foundry, bez pozyskiwania ani przenoszenia bazowych danych.
- Studio modeli AIP: Twórz, trenuj, oceniaj i udostępniaj modele ML w Foundry, korzystając z natywnego dostępu do LLM oraz środowisk programistycznych obsługujących Python i R.
Integracje Palantir Foundry
Palantir Foundry oferuje ponad 200 natywnych konektorów danych, w tym Amazon S3, Snowflake, Databricks, PostgreSQL, SAP, Apache Kafka, Amazon Kinesis, Tableau i Power BI. Obsługuje także niestandardową łączność za pośrednictwem zgodnego z S3 interfejsu API, katalogu REST Iceberg i wirtualnych tabel.
Pros and Cons
Pros:
- Najlepsze w swojej klasie zarządzanie danymi na potrzeby zgodności
- Warstwa Ontology zapewnia użytkownikom biznesowym dostęp do danych
- Udostępnianie danych bez kopiowania za pomocą wirtualnych tabel
Cons:
- Wysokie ceny umowne przy niejasnych kosztach całkowitych
- Ryzyko uzależnienia od platformy z powodu zastrzeżonych modeli
Learn more about Palantir Foundry: Najlepszy do zapewniania nadzoru nad otwartymi tabelami jeziora danych z wielu silników
- 90-dniowy bezpłatny okres próbny
- Od $0.12 za godzinę DCU
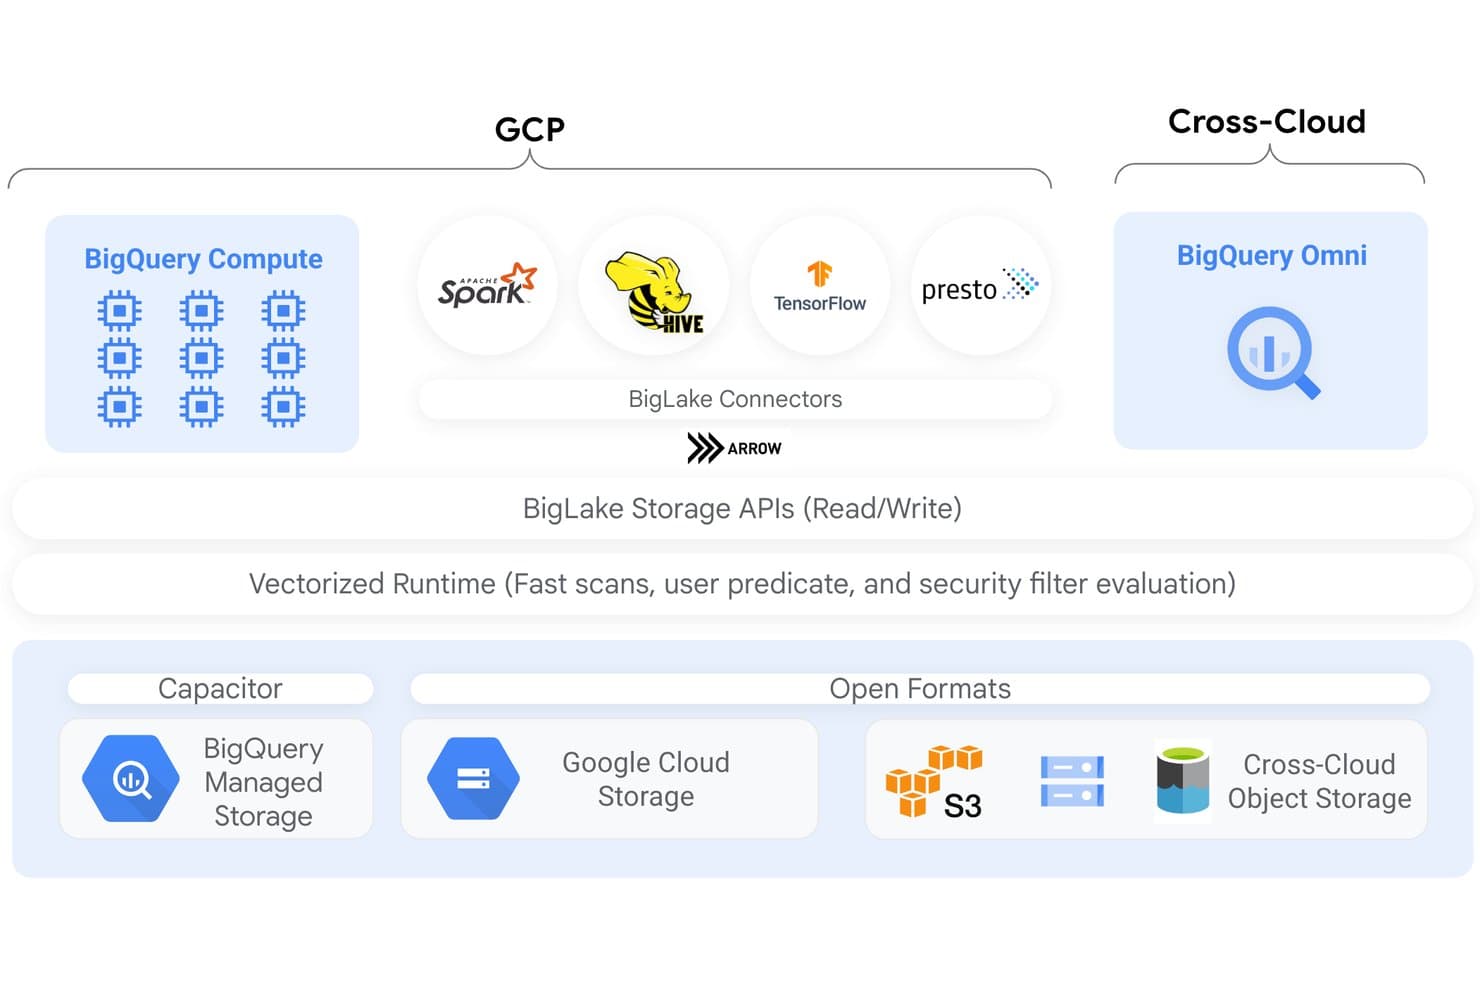
BigLake ujednolica moc obliczeniową i pamięć masową w środowiskach GCP oraz między chmurami. BigLake to platforma łącząca jezioro danych i hurtownię w Google Cloud, która rozszerza BigQuery o obsługę tabel w otwartych formatach, dostęp do zapytań z różnych silników, ujednolicone zarządzanie metadanymi oraz szczegółowe mechanizmy nadzoru w usługach GCS, S3 i Azure Blob Storage.
Dla kogo BigLake jest najlepszym wyborem?
BigLake doskonale sprawdzi się w zespołach inżynierii danych i architektury, które już korzystają z Google Cloud i potrzebują spójnego nadzoru nad wieloma silnikami zapytań oraz otwartymi formatami tabel.
Dlaczego wybrałem BigLake
Wybrałem BigLake jako jedno z najlepszych rozwiązań, ponieważ jest to jedyna znana mi platforma łącząca jezioro danych i hurtownię, która konsekwentnie egzekwuje zasady dostępu na poziomie wierszy i kolumn w BigQuery, Spark, Trino i Presto, a nie tylko w obrębie pojedynczego silnika. Oznacza to, że znacznik zasad zastosowany do poufnej kolumny pozostaje powiązany z danymi niezależnie od tego, za pomocą którego silnika zespół wykonuje zapytania. Katalog REST Iceberg dla platformy łączącej jezioro danych i hurtownię umożliwia to, działając jako pojedynczy punkt końcowy uwzględniający zasady nadzoru dla wszystkich silników otwartoźródłowych odczytujących i zapisujących te same tabele Iceberg.
Najważniejsze funkcje BigLake
- Automatyczna konserwacja tabel: BigLake automatycznie obsługuje kompaktowanie plików, klastrowanie, usuwanie nieużywanych danych oraz generowanie metadanych dla tabel Iceberg przechowywanych w GCS.
- Pozyskiwanie danych w wielu formatach: Pozyskuj dane w formatach Parquet, ORC, Avro, CSV, JSON oraz w otwartych formatach tabel, takich jak Apache Iceberg, Delta Lake i Apache Hudi, za pośrednictwem plików manifestu.
- Zapytania między chmurami BigQuery Omni: Uruchamiaj zapytania SQL BigQuery bezpośrednio na danych przechowywanych w Amazon S3 lub Azure Data Lake Storage Gen 2, bez przenoszenia ich do GCS.
- Replikacja przechwytywania zmian danych: Przesyłaj dane operacyjne z Cloud Spanner, AlloyDB i Cloud SQL bezpośrednio do tabel BigLake, aby uzyskać analitykę niemal w czasie rzeczywistym.
Integracje BigLake
BigLake oferuje natywne integracje z BigQuery, Apache Spark, Apache Flink, Trino, Presto, Google Cloud Storage, Amazon S3, Azure Data Lake Storage Gen2, Looker i Vertex AI. Jego katalog REST Iceberg łączy silniki otwartoźródłowe ze współdzielonymi tabelami jeziora danych.
Pros and Cons
Pros:
- Zabezpieczenia na poziomie wierszy i kolumn egzekwowane we wszystkich silnikach
- Otwarte formaty tabel z pełną obsługą Iceberg
- Federacja katalogów do zarządzania metadanymi w wielu chmurach
Cons:
- DML nie jest obsługiwany w przypadku zewnętrznych tabel innych niż Iceberg
- CMEK niedostępny dla buforowanych tabel w S3 lub Azure
Learn more about BigLake: Najlepszy do magazynowania obiektów stanowiącego podstawę jezior danych AWS
- Niedostępna
- Od 0,023 USD/GB/miesiąc
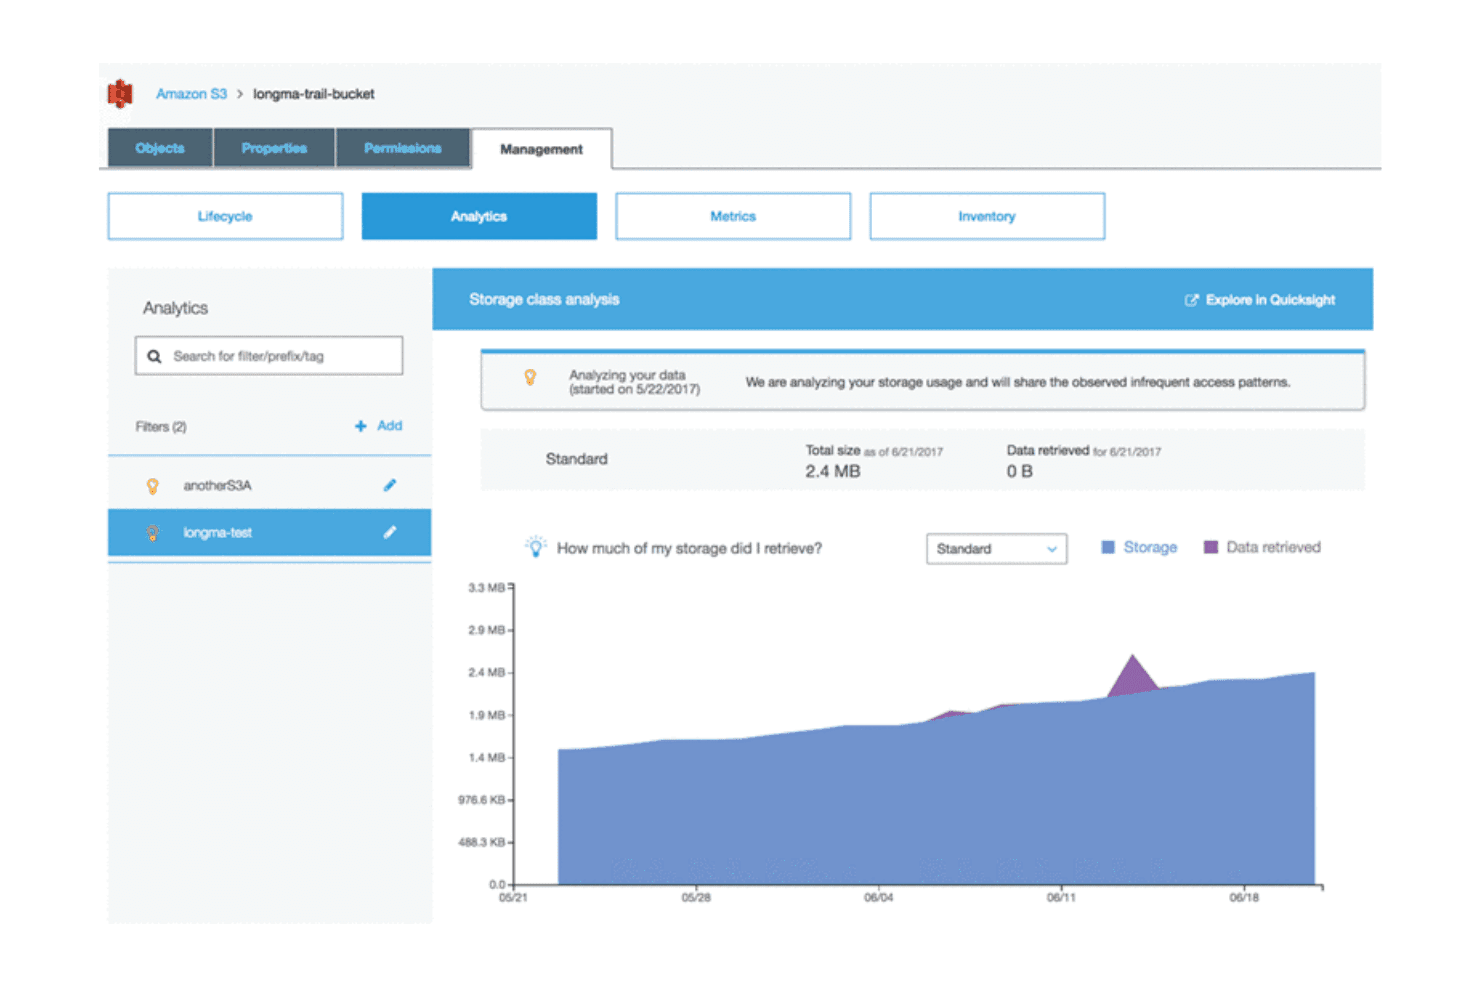
Amazon S3 analizuje wzorce wykorzystania magazynowania, aby zoptymalizować koszty pobierania danych. Amazon S3 to usługa magazynowania obiektów AWS, która pełni funkcję podstawowej warstwy magazynowania dla jezior danych, obsługując dowolny format danych w skali eksabajtów dzięki warstwowym klasom magazynowania, natywnemu zarządzaniu tabelami Apache Iceberg za pośrednictwem S3 Tables oraz ścisłej integracji z całym ekosystemem analitycznym AWS.
Dla kogo Amazon S3 jest najlepszym wyborem?
Amazon S3 to właściwy wybór dla zespołów inżynierii danych i infrastruktury tworzących potoki analityczne w AWS, które potrzebują sprawdzonej podstawy magazynowania w skali eksabajtów, bezpośrednio połączonej z resztą ekosystemu AWS.
Dlaczego wybrałem Amazon S3
Amazon S3 znalazł się na mojej krótkiej liście, ponieważ jest warstwą magazynowania obiektów, na której opiera się już większość produkcyjnych jezior danych. Podoba mi się, że S3 Tables zapewnia natywną obsługę Apache Iceberg z wbudowanymi transakcjami ACID, funkcją podróży w czasie i automatyczną kompaktacją, rozwiązując problem małych plików, który dotyka większość architektur jezior danych. Połączenie tego z funkcją S3 Intelligent-Tiering, która automatycznie przenosi rzadko używane dane do warstwy kosztującej 0,00099 USD/GB/miesiąc, zapewnia skuteczną kontrolę kosztów magazynowania bez konieczności ręcznej interwencji.
Najważniejsze funkcje Amazon S3
- Pobieranie danych w wielu formatach: S3 akceptuje dowolny typ pliku — Parquet, ORC, Avro, JSON, CSV oraz formaty nieustrukturyzowane — za pośrednictwem przesyłania wsadowego, strumieniowania przez Kinesis i MSK lub wyzwalaczy sterowanych zdarzeniami z użyciem S3 Event Notifications.
- Precyzyjna kontrola dostępu w Lake Formation: Egzekwuj zasady dostępu do danych na poziomie tabeli, kolumny, wiersza i komórki w całym jeziorze danych opartym na S3, bez duplikowania danych.
- S3 Vectors: Natywna usługa przechowywania i przeszukiwania indeksów wektorowych, wbudowana bezpośrednio w S3, zaprojektowana do obsługi wyszukiwania semantycznego i obciążeń związanych z generowaniem wspomaganym wyszukiwaniem, przy kosztach do 90% niższych niż w przypadku tradycyjnych rozwiązań.
- S3 Inventory: Generuj zaplanowane raporty dotyczące atrybutów obiektów, klasy magazynowania, stanu szyfrowania i stanu replikacji we wszystkich zasobnikach na potrzeby procesów audytu i zarządzania.
Integracje Amazon S3
Amazon S3 oferuje natywne integracje z usługami AWS, w tym AWS Glue, Amazon Athena, Amazon EMR, AWS Lake Formation, Amazon Kinesis, Amazon Redshift Spectrum i Amazon SageMaker. Łączy się również z Apache Spark, Trino, Snowflake, Databricks, Tableau i Power BI za pośrednictwem udokumentowanych konektorów i interfejsów API.
Pros and Cons
Pros:
- Magazyn obiektów w skali eksabajtów obsługujący dowolny format danych
- Wbudowane tabele ACID Iceberg z automatyczną kompaktacją
- 143 certyfikaty zgodności i kontrola dostępu na poziomie obiektów
Cons:
- Cennik jest złożony i wymaga ścisłego zarządzania
- Budowa jeziora danych wymaga połączenia wielu usług AWS
Learn more about Amazon S3: Najlepsze rozwiązanie dla firmowych jezior danych opartych na technologiach Microsoft
- Kredyt w wysokości 200 USD na 30 dni (brak dedykowanego bezpłatnego planu)
- Od 0,023 USD/GB/miesiąc
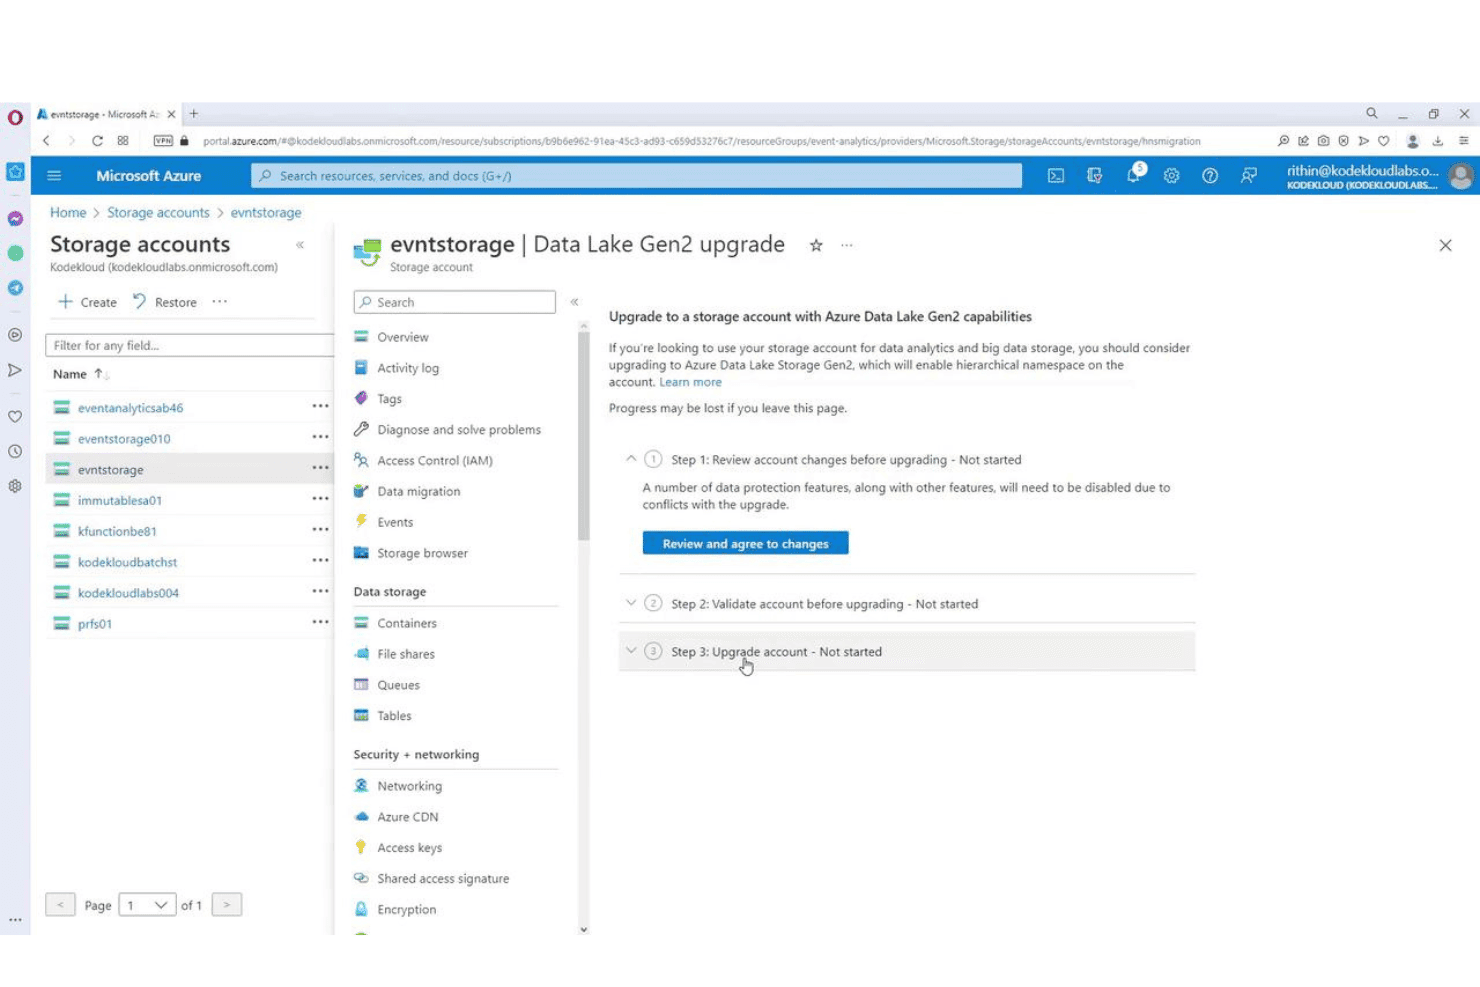
Azure Storage pozwala użytkownikom uaktualnić konta do funkcji Data Lake Gen2. Azure Data Lake Storage Gen2 to oparta na chmurze usługa magazynowania jezior danych firmy Microsoft, zbudowana na bazie Azure Blob Storage z hierarchiczną przestrzenią nazw, obsługująca magazynowanie na skalę eksabajtową, pozyskiwanie danych w wielu formatach, mechanizmy kontroli dostępu zgodne z POSIX oraz natywną integrację z ekosystemem analityki i uczenia maszynowego platformy Azure.
Dla kogo najlepiej nadaje się usługa Azure Data Lake Storage?
Azure Data Lake Storage Gen2 to naturalny wybór dla firmowych zespołów IT i zespołów danych, które już działają w środowisku Microsoft Azure i potrzebują magazynowania na skalę eksabajtową, ściśle zintegrowanego z usługami Synapse, Databricks i Microsoft Fabric.
Dlaczego wybrałem usługę Azure Data Lake Storage
Wybrałem Azure Data Lake Storage Gen2 jako jedno z najlepszych rozwiązań, ponieważ stanowi natywną podstawę magazynowania dla całego stosu analitycznego firmy Microsoft, a ta ścisła integracja ma znaczenie w skali przedsiębiorstwa. Gdy organizacja korzysta z usług Synapse, Databricks i Microsoft Fabric, ADLS Gen2 już stanowi warstwę bazową dla wszystkich tych usług, co oznacza, że każda z nich może odpytywać jedną kopię danych za pośrednictwem sterownika ABFS. Szczególnie podobają mi się listy kontroli dostępu zgodne z POSIX, które pozwalają ustawiać uprawnienia do odczytu/zapisu/wykonywania na poziomie pojedynczych plików i katalogów, a nie tylko kontenera.
Najważniejsze funkcje usługi Azure Data Lake Storage
- Automatyczne przypisywanie warstw cyklu życia: Ustaw zasady, które automatycznie przenoszą dane do warstwy gorącej, chłodnej, zimnej lub archiwalnej na podstawie wieku danych lub czasu ostatniego dostępu, aby zarządzać kosztami magazynowania na dużą skalę.
- Zgodność ze sterownikiem ABFS: Sterownik Azure Blob File System zapewnia natywny dostęp do odczytu i zapisu w ADLS Gen2 dla obciążeń opartych na Hadoop, Spark, Hive i HDFS bez zmian w kodzie.
- Skróty OneLake: Twórz aktywne odwołania do danych w innych obszarach roboczych OneLake, Amazon S3 lub kontenerach Azure Blob Storage bez kopiowania ani przenoszenia danych źródłowych.
- Integracja magazynu danych z usługą Azure Machine Learning: Rejestruj kontenery ADLS Gen2 bezpośrednio jako magazyny danych w obszarach roboczych Azure ML, zapewniając analitykom danych bezpośredni dostęp do danych w jeziorze na potrzeby trenowania modeli i eksperymentów.
Integracje usługi Azure Data Lake Storage
Azure Data Lake Storage oferuje natywne integracje w całym ekosystemie Microsoft, w tym z usługami Azure Data Factory, Azure Databricks, Azure Synapse Analytics, Microsoft Fabric, Microsoft Purview, Azure Machine Learning i Azure Event Hubs. Obsługuje również Apache Spark i Kafka za pośrednictwem udokumentowanych konektorów, a także ABFS i interfejsy API na potrzeby niestandardowego dostępu do danych.
Pros and Cons
Pros:
- Natywna integracja z narzędziami analitycznymi firmy Microsoft
- Hierarchiczna przestrzeń nazw obsługuje szczegółową kontrolę dostępu
- Otwarte formaty tabel obsługiwane przez warstwę obliczeniową
Cons:
- Do zaawansowanego katalogowania danych wymagana jest usługa Purview
- Dostępna wyłącznie w usłudze Microsoft Azure
Learn more about Azure Data Lake Storage: Najlepsze rozwiązanie dla otwartego lakehouse z dostępem do danych mainframe
- Dostępny bezpłatny plan
- Od 83,30 USD/miesiąc
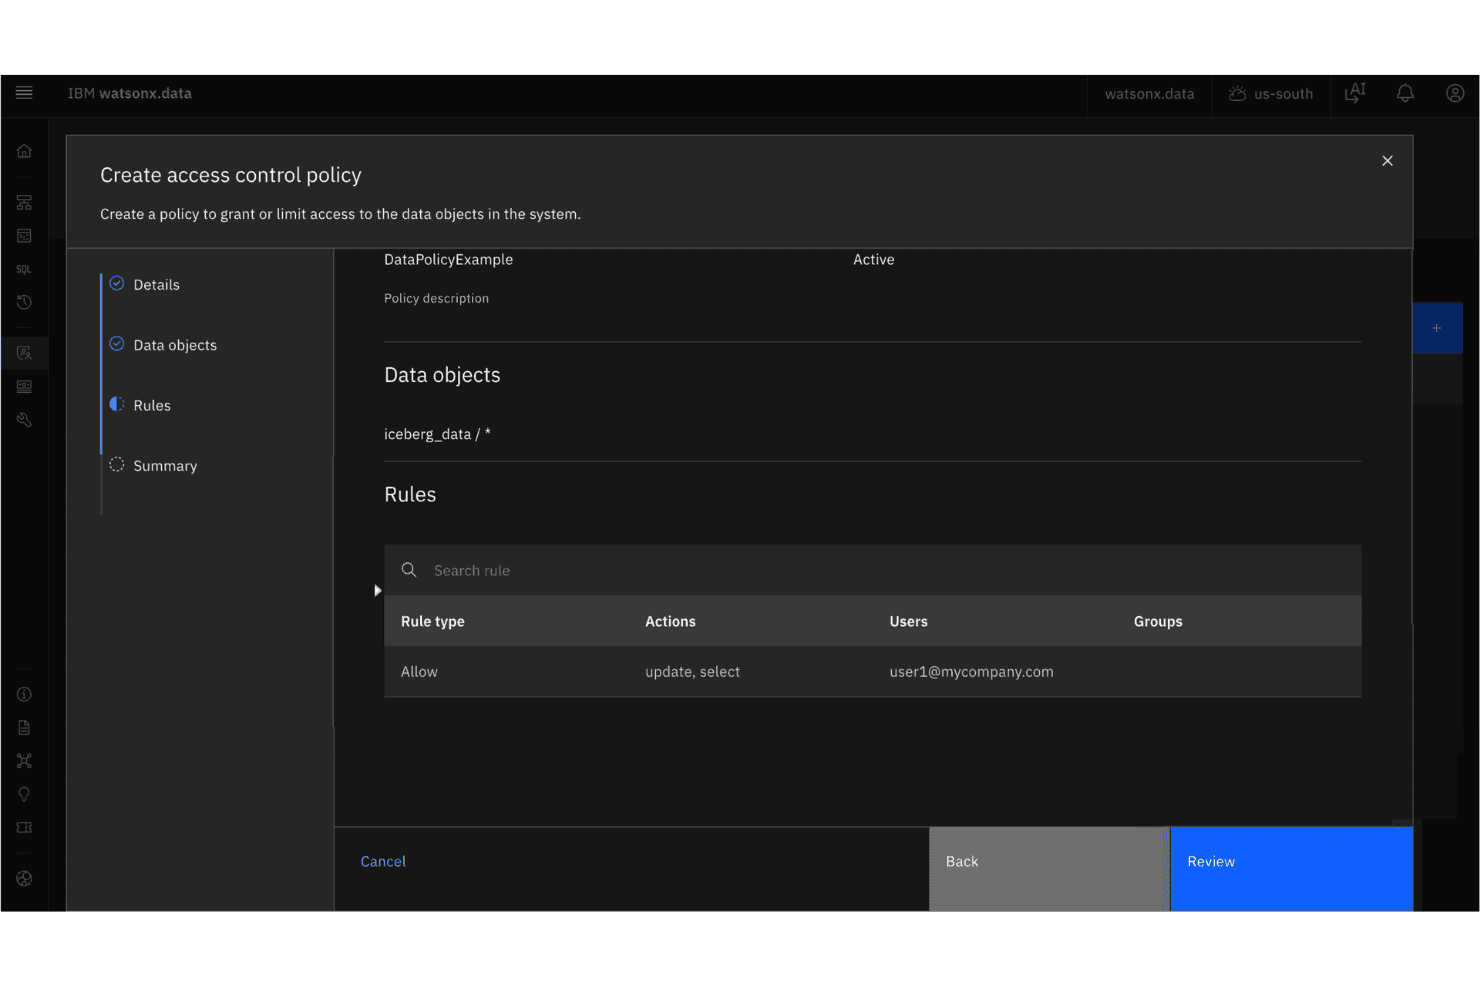
IBM watsonx.data umożliwia użytkownikom definiowanie zasad kontroli dostępu dla obiektów danych. IBM watsonx.data to otwarta platforma lakehouse, która łączy wykonywanie zapytań w wielu silnikach, pamięć masową opartą na Apache Iceberg, sfederowany dostęp do danych oraz wbudowaną obsługę wektorowych baz danych na potrzeby analityki i obciążeń AI.
Dla kogo IBM watsonx.data jest najlepszym wyborem?
IBM watsonx.data doskonale sprawdza się w dużych przedsiębiorstwach korzystających z infrastruktury IBM — szczególnie w tych, które mają środowiska mainframe i potrzebują ujednolicić analitykę, AI oraz zarządzany dostęp do danych w ramach wdrożeń hybrydowych i wielochmurowych.
Dlaczego wybrałem IBM watsonx.data
IBM watsonx.data znalazło się na mojej krótkiej liście ze względu na sposób obsługi danych mainframe w połączeniu z nowoczesnymi obciążeniami lakehouse. IBM Data Gate udostępnia transakcyjne dane IBM zSystems bezpośrednio na potrzeby analityki i AI, czego większość konkurencyjnych platform po prostu nie potrafi natywnie. Korzystam również ze sfederowanego dostępu bez kopiowania danych do Databricks Unity Catalog, Snowflake i Salesforce Data Cloud, aby odpytywać zewnętrzne źródła bez przenoszenia danych. Wielosilnikowa konfiguracja dopasowana do zastosowania, w której Presto, Spark i Milvus działają na współdzielonej pamięci masowej Iceberg, pozwala utrzymać przewidywalne koszty w miarę różnicowania obciążeń.
Najważniejsze funkcje IBM watsonx.data
- Pozyskiwanie danych w wielu formatach: Obsługuje wsadowe pozyskiwanie danych w formatach Parquet, ORC, Avro, CSV, JSON i innych, a także CDC za pośrednictwem Debezium i Apache Kafka na potrzeby potoków przechwytywania zmian danych.
- Zarządzanie tabelami Apache Iceberg: Zapewnia transakcje ACID, podróże w czasie, ewolucję schematu oraz wbudowaną kompakcję danych bezpośrednio w pamięci masowej obiektów.
- Maskowanie danych na poziomie kolumn: Wymusza filtrowanie na poziomie wierszy i zaciemnianie na poziomie kolumn dla pól wrażliwych za pośrednictwem zintegrowanych mechanizmów zasad Apache Ranger i IBM Knowledge Catalog.
- Wektorowa baza danych Milvus: Wbudowany magazyn wektorów obsługujący wyszukiwanie podobieństwa dla ponad 100 mln wektorów na potrzeby obciążeń generatywnej AI i RAG działających na danych lakehouse.
Integracje IBM watsonx.data
Udokumentowane integracje obejmują dbt, Databricks Unity Catalog, Snowflake, Salesforce Data Cloud, Confluent Tableflow, IBM Knowledge Catalog, Tableau, Power BI, Looker i Qlik. Platforma łączy się również z Amazon S3, Azure Data Lake Storage Gen2, Google Cloud Storage oraz IBM Cloud Object Storage.
Pros and Cons
Pros:
- Natywnie obsługuje dane mainframe i hybrydowe
- Obsługuje ACID, ewolucję schematu i podróże w czasie
- Umożliwia zapytania bez kopiowania danych między głównymi platformami
Cons:
- Złożona konfiguracja początkowa dla mniejszych zespołów
- Liczba gotowych konektorów może być ograniczona
Learn more about IBM watsonx.data: Najlepsze rozwiązanie do integracji jeziora danych ze stosem Microsoft
- Bezpłatny 60-dniowy okres próbny
- Od $262.80/miesiąc
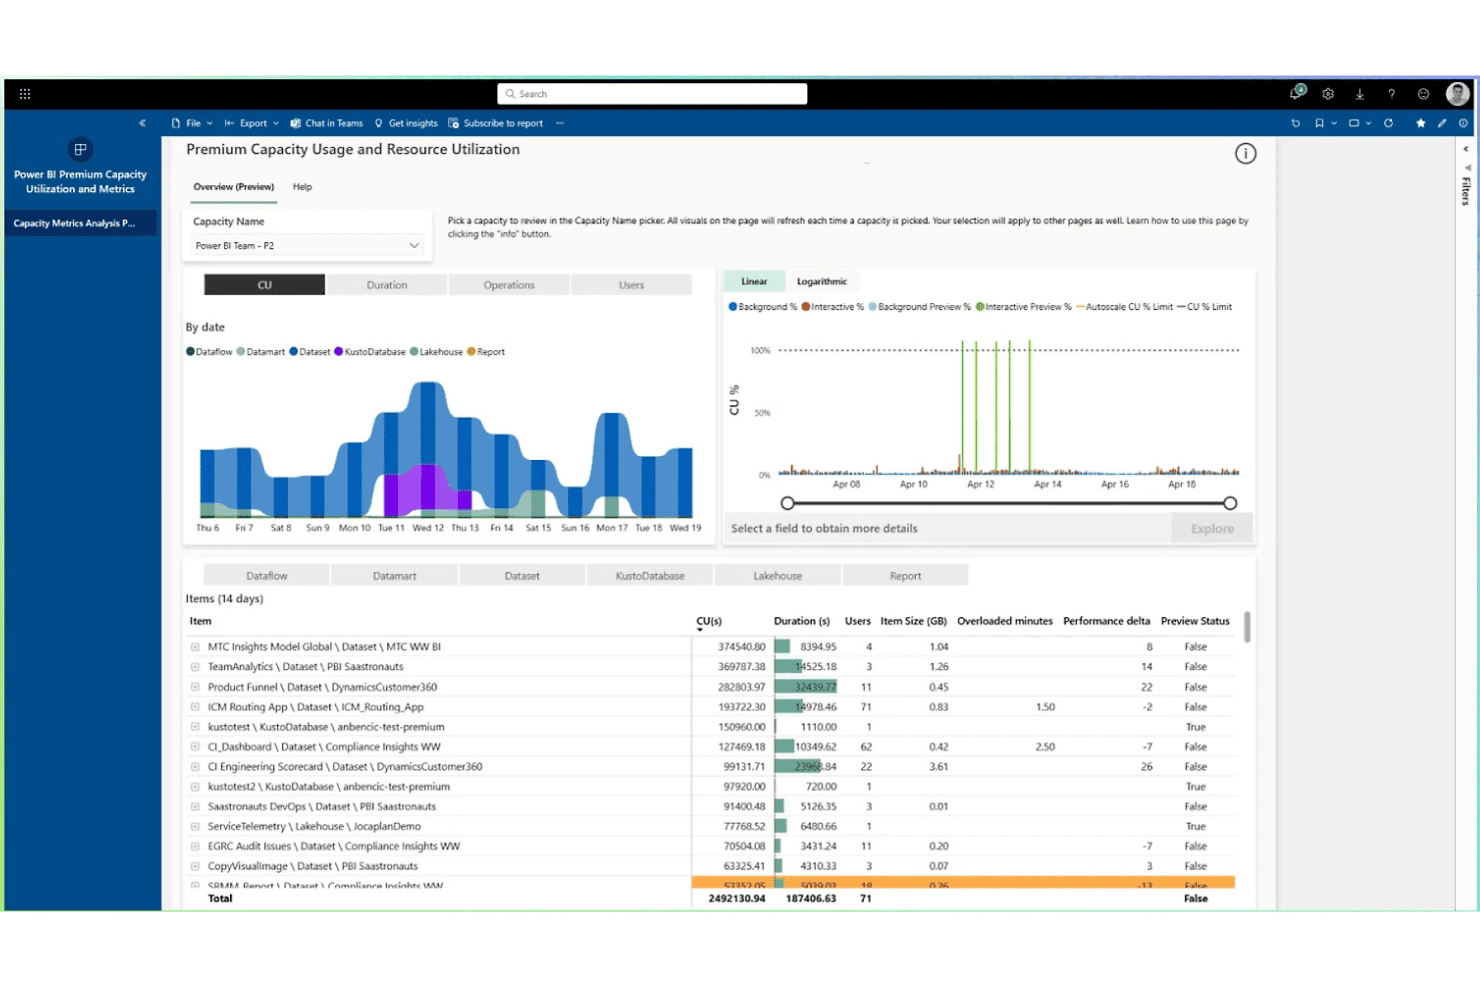
Microsoft Fabric śledzi wykorzystanie pojemności Premium i metryki wykorzystania zasobów. Microsoft Fabric to ujednolicona platforma jezior danych SaaS, która łączy inżynierię danych, potoki ETL/ELT, analitykę w czasie rzeczywistym, hurtownie danych i analitykę biznesową w jednym środowisku opartym na współdzielonej warstwie pamięci masowej OneLake, z obsługą formatów Delta Lake i Apache Iceberg.
Dla kogo Microsoft Fabric jest najlepszym wyborem?
Microsoft Fabric to doskonały wybór dla przedsiębiorstw, które już korzystają z platformy Azure, usługi Power BI lub pakietu Microsoft 365 i chcą używać jednej platformy do inżynierii danych, hurtowni danych i analityki biznesowej bez łączenia oddzielnych narzędzi.
Dlaczego wybrałem Microsoft Fabric
Uwzględniłem Microsoft Fabric wśród najlepszych rozwiązań, ponieważ jest to jedyna znana mi platforma, która zapewnia zespołom korzystającym z natywnych usług Azure jedną współdzieloną warstwę jeziora danych (OneLake), z której wszystkie obciążenia — od notesów Spark po zapytania Power BI Direct Lake — odczytują dane i zapisują je bez ich duplikowania. Szczególnie podoba mi się to, że Fabric Mirroring replikuje dane ze źródeł takich jak Snowflake lub Azure SQL bezpośrednio do OneLake jako tabele Delta Parquet niemal w czasie rzeczywistym, bez konieczności tworzenia niestandardowych potoków. Dla firm już korzystających z Azure, Entra ID i Power BI taki poziom natywnej spójności jest naprawdę trudny do odtworzenia gdzie indziej.
Najważniejsze funkcje Microsoft Fabric
- Skróty OneLake: Twórz wirtualne odnośniki do danych w Amazon S3, Google Cloud Storage lub ADLS Gen2 bez fizycznego przenoszenia ani kopiowania danych do OneLake.
- Fabric Mirroring: Stale replikuj dane z zewnętrznych źródeł, takich jak Snowflake, Google BigQuery i Azure SQL, do OneLake jako tabele Delta Parquet niemal w czasie rzeczywistym.
- Dostęp do zapytań z wielu silników: Uruchamiaj zapytania Spark, T-SQL, KQL i Power BI Direct Lake na tych samych danych OneLake bez duplikowania zbiorów danych między silnikami.
- Integracja z Git i potoki wdrażania: Połącz obszary robocze Fabric z Azure DevOps lub GitHubem w celu kontroli wersji, a następnie promuj obciążenia między środowiskami programistycznymi, testowymi i produkcyjnymi za pomocą wbudowanych potoków CI/CD.
Integracje Microsoft Fabric
Microsoft Fabric obejmuje ponad 200 natywnych łączników Data Factory, w tym Amazon S3, Azure SQL Database, Google BigQuery, Snowflake, PostgreSQL, Oracle, Salesforce i ServiceNow. Łączy się z usługami Microsoft 365 i Azure, obsługuje narzędzia zgodne z ADLS Gen2 oraz oferuje interfejsy API do obsługi metadanych, zarządzania i automatyzacji.
Pros and Cons
Pros:
- Otwarta obsługa formatów Delta Lake i Iceberg
- Wirtualny dostęp do zewnętrznych chmur bez kopiowania danych
- Szczegółowe zabezpieczenia na poziomie wierszy i kolumn
Cons:
- Brak warstw pamięci masowej dla danych rzadko używanych lub archiwalnych
- Tylko Azure, brak wdrożenia lokalnego
Learn more about Microsoft Fabric: Najlepsze rozwiązanie do federacyjnego SQL w ramach jezior danych w wielu chmurach
- 30-dniowy bezpłatny okres próbny + dostępny bezpłatny plan
- Od $0.50/kredyt
Visit WebsiteCustomer Rating:4.3/5 Learn more about Starburst:
Inne narzędzia do jezior danych
Oto kilka dodatkowych narzędzi do jezior danych, które nie znalazły się na mojej krótkiej liście, ale nadal warto się z nimi zapoznać:
- 11Alibaba Cloud Hybrid CloudNajlepsze rozwiązanie dla wdrożeń hybrydowych jezior danych w chmurze w regionie APAC
- 12Teradata VantageNajlepsze do obciążeń AI/ML na danych w jeziorze danych w skali petabajtowej
- 13MinIONajlepsze rozwiązanie do przechowywania danych lakehouse dla AI i środowisk lokalnych
How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
Jak wybrać narzędzia do jeziora danych
Jakie czynniki faktycznie wpływają na to, czy narzędzie do jeziora danych może zapewnić skalę, zarządzanie i integrację potrzebne Twojemu zespołowi w rzeczywistych obciążeniach analitycznych?
| Jeśli Twoim priorytetem jest... | Poszukaj... |
|---|---|
| Jeśli Twoim priorytetem jest...Zgodność z przepisami | Poszukaj...Wbudowanego rejestrowania audytów i zasad dostępu |
| Jeśli Twoim priorytetem jest...Wdrożenie w wielu chmurach lub środowisku hybrydowym | Poszukaj...Natywnej obsługi wielu dostawców chmury |
| Jeśli Twoim priorytetem jest...Niezależność od dostawcy | Poszukaj...Zgodności z otwartymi formatami tabel |
| Jeśli Twoim priorytetem jest...Wydajność analityki przy dużej skali | Poszukaj...Warstwowego przechowywania i natywnej integracji z zapytaniami |
| Jeśli Twoim priorytetem jest...Gotowość na AI i ML | Poszukaj...Bezpośrednich konektorów do narzędzi i silników AI/ML |
Jak zweryfikować swoją krótką listę
- Potwierdź funkcje zarządzania: Poproś o zrzuty ekranu konsoli administracyjnej przedstawiające kontrolę dostępu opartą na rolach i konfigurację dziennika audytów.
- Przetestuj obsługę otwartych formatów: Przeprowadź na żywo import plików Parquet lub Iceberg i sprawdź ewolucję schematu w środowisku próbnym.
- Zweryfikuj deklaracje dotyczące wielu chmur: Poproś o publiczną dokumentację pokazującą kroki wdrożenia u co najmniej dwóch dostawców chmury.
- Sprawdź integrację z analityką: Poproś o przykład przepływu pracy lub konfigurację dla Spark, Trino albo Presto wraz z udokumentowanymi wynikami zapytań.
- Kompromis — pakiet dla przedsiębiorstw czy otwarte jezioro danych: Zdecyduj, czy potrzebujesz gotowego pakietu zapewniającego zgodność i wsparcie, czy też większą wartość dla Twojej architektury mają elastyczność i zgodność z otwartym stosem.
Czym są narzędzia do jezior danych?
Narzędzia do jezior danych to platformy i oprogramowanie, które pomagają przechowywać, zarządzać i analizować duże ilości ustrukturyzowanych i nieustrukturyzowanych danych w centralnym repozytorium. Narzędzia te pozwalają zespołowi importować surowe dane, stosować schemat w razie potrzeby i organizować zasoby na potrzeby projektów analitycznych lub AI. Można oczekiwać funkcji wspierających zarządzanie, skalowalność oraz integrację z popularnymi silnikami zapytań i platformami analitycznymi.
Funkcje narzędzi jeziora danych
Wybierając narzędzia jeziora danych, zwróć uwagę na następujące kluczowe funkcje:
- Skalowalne przechowywanie obiektowe: Umożliwia przechowywanie i zarządzanie petabajtami ustrukturyzowanych i nieustrukturyzowanych danych, z opcjami przechowywania warstwowego lub zimnego, aby kontrolować koszty w miarę wzrostu potrzeb w zakresie pamięci masowej.
- Obsługa schematu podczas odczytu: Umożliwia najpierw zapisanie surowych danych, a następnie zastosowanie schematu w czasie wykonywania zapytania, co ułatwia obsługę różnorodnych i zmieniających się zbiorów danych bez konieczności ponownego ładowania.
- Pobieranie danych w wielu formatach: Obsługuje importowanie danych w różnych formatach, takich jak Parquet, Avro, JSON, ORC i CSV, a także źródła danych zarówno wsadowych, jak i strumieniowych, zapewniając większą elastyczność sposobu dostarczania danych.
- Integracja z silnikami zapytań: Zapewnia zgodność z silnikami takimi jak Spark, Trino, Presto lub Athena, dzięki czemu można uruchamiać zadania analityczne i raportowe bezpośrednio na jeziorze danych, bez dodatkowego oprogramowania pośredniczącego.
- Zarządzanie metadanymi i katalogiem: Obejmuje narzędzia do katalogowania danych, wyszukiwania zasobów, śledzenia pochodzenia danych i tagowania, pomagając utrzymać porządek w danych oraz ułatwiając ich odnajdywanie w miarę dodawania nowych zbiorów danych.
- Mechanizmy zarządzania i kontroli dostępu: Oferuje szczegółowe uprawnienia, szyfrowanie i rejestrowanie audytowe, dzięki czemu można kontrolować, kto ma dostęp do poszczególnych danych, monitorować ich wykorzystanie i spełniać wymagania regulacyjne.
- Wersjonowanie danych i podróże w czasie: Umożliwia śledzenie zmian, przywracanie wcześniejszych wersji zbiorów danych i zachowywanie widoków historycznych, co jest przydatne podczas audytów, odzyskiwania danych i zapewniania odtwarzalności.
- Integracja z narzędziami orkiestracji: Łączy się natywnie z orkiestratorami przepływów pracy, takimi jak Apache Airflow, umożliwiając automatyzację potoków danych i koordynowanie zadań w różnych systemach.
- Narzędzia do monitorowania i zarządzania kosztami: Udostępnia pulpity nawigacyjne i alerty dotyczące wykorzystania pamięci masowej, wzorców dostępu i kosztów, dzięki czemu można utrzymać wydajność środowiska oraz kontrolować budżet.
- Obsługa otwartych formatów tabel: Obsługuje formaty takie jak Delta Lake lub Apache Iceberg, umożliwiając korzystanie z zaawansowanych funkcji, takich jak transakcje ACID i współdziałanie z wieloma narzędziami analitycznymi.
Typowe funkcje AI narzędzi jeziora danych
Oprócz wymienionych powyżej standardowych funkcji narzędzi jeziora danych wiele z tych rozwiązań wykorzystuje AI, oferując takie funkcje jak:
- Automatyczna klasyfikacja danych: Wykorzystuje modele AI do skanowania i kategoryzowania napływających danych na podstawie ich treści, wrażliwości lub wymagań dotyczących zgodności. Pomaga to zespołowi szybciej organizować zasoby i stosować odpowiednie mechanizmy kontroli dostępu bez ręcznego tagowania.
- Wykrywanie anomalii w jakości danych: Stosuje algorytmy uczenia maszynowego do monitorowania strumieni danych i oznaczania nietypowych wzorców, brakujących wartości lub wartości odstających. Umożliwia to wczesne wykrywanie problemów z integralnością danych i ograniczenie ryzyka błędnych analiz lub błędów w kolejnych etapach przetwarzania.
- Predykcyjna optymalizacja obciążeń: Wykorzystuje AI do analizowania historycznych wzorców zapytań i wykorzystania pamięci masowej, a następnie rekomenduje lub automatycznie stosuje optymalizacje, takie jak partycjonowanie, buforowanie lub skalowanie zasobów. Pomaga to utrzymać wydajność i kontrolować koszty w miarę wzrostu wykorzystania.
- Interfejsy zapytań w języku naturalnym: Integruje narzędzia czatu lub wyszukiwania oparte na AI, które umożliwiają użytkownikom zadawanie pytań dotyczących danych w prostym języku. Obniża to próg wejścia dla użytkowników nietechnicznych, którzy mogą eksplorować zbiory danych i uzyskiwać wnioski bez pisania zapytań SQL ani kodu.
- Automatyczne wzbogacanie metadanych: Wykorzystuje AI do wyodrębniania z surowych danych kontekstu, relacji i terminów biznesowych, a następnie uzupełnia katalog danych o bogatsze opisy i informacje o pochodzeniu danych. Ułatwia to zespołom odkrywanie, zaufanie do danych i ponowne wykorzystywanie zasobów danych.
Korzyści z narzędzi jeziora danych
Wdrożenie narzędzi jeziora danych zapewnia zespołowi i firmie wiele korzyści. Oto kilka z nich:
- Scentralizowane zarządzanie danymi: Narzędzia jeziora danych pozwalają przechowywać dane ustrukturyzowane i nieustrukturyzowane w jednym miejscu, ułatwiając organizowanie zasobów oraz obsługę projektów analitycznych lub projektów AI.
- Skalowalność dla obciążeń o skali petabajtów: Platformy te mogą obsługiwać ogromne ilości danych oraz wspierać warstwy pamięci masowej w chmurze i lokalne, dzięki czemu można dostosować się do rosnących wymagań bez przeprojektowywania architektury.
- Elastyczne pozyskiwanie danych: Można pozyskiwać dane z szerokiej gamy formatów i źródeł oraz obsługiwać zarówno strumienie wsadowe, jak i przesyłane w czasie rzeczywistym, dzięki wbudowanym konektorom i obsłudze różnych formatów.
- Szczegółowe zarządzanie i kontrola dostępu: Uprawnienia z dokładną kontrolą poziomu dostępu, szyfrowanie i rejestrowanie audytów pomagają utrzymywać bezpieczeństwo oraz zgodność ze standardami takimi jak HIPAA, SOC 2 i GDPR.
- Integracja z narzędziami analitycznymi i AI: Natywna kompatybilność z silnikami zapytań, takimi jak Spark, Trino i Presto, a także bezpośrednie konektory do narzędzi AI/ML oznaczają, że można analizować dane bez opóźnień i dodatkowych prac integracyjnych.
- Zautomatyzowane zarządzanie metadanymi i jakością danych: Wiele platform obejmuje katalogi, śledzenie pochodzenia danych oraz narzędzia oparte na AI, które pomagają wzbogacać metadane, klasyfikować dane i wykrywać anomalie w celu utrzymania integralności danych.
- Obsługa otwartych formatów tabel i zaawansowanych zastosowań: Funkcje takie jak zgodność z Delta Lake lub Apache Iceberg umożliwiają obsługę transakcji ACID, wersjonowanie danych i udostępnianie danych bez ich kopiowania, wspierając bardziej zaawansowaną analitykę oraz architektury wielochmurowe.
Koszty i ceny narzędzi jeziora danych
Wybór narzędzi jeziora danych wymaga zrozumienia różnych dostępnych modeli cenowych i planów. Koszty różnią się w zależności od funkcji, wielkości zespołu, dodatków i innych czynników. Poniższa tabela podsumowuje popularne plany, ich średnie ceny oraz typowe funkcje uwzględniane w rozwiązaniach jeziora danych:
Tabela porównawcza planów narzędzi jeziora danych
| Typ planu | Średnia cena | Typowe funkcje |
|---|---|---|
| Typ planuPlan bezpłatny | Średnia cena$0 | Typowe funkcjePodstawowa pamięć masowa obiektów, ograniczone pozyskiwanie danych, obsługa schematu podczas odczytu oraz integracja z jednym silnikiem zapytań. |
| Typ planuPlan osobisty | Średnia cena$50–$300/miesiąc | Typowe funkcjeWiększe limity pamięci masowej, obsługa wielu formatów danych, podstawowe katalogowanie oraz integracja z narzędziami analitycznymi. |
| Typ planuPlan biznesowy | Średnia cena$1,000–$5,000/miesiąc | Typowe funkcjePamięć masowa o skali petabajtów, zaawansowane mechanizmy zarządzania, opcje wielochmurowe oraz funkcje katalogowania danych. |
| Typ planuPlan dla przedsiębiorstw | Średnia cena$10,000+/miesiąc | Typowe funkcjeNieograniczona pamięć masowa, pełne funkcje zgodności, automatyzacja oparta na AI, integracja z narzędziami do orkiestracji oraz pomoc techniczna klasy premium. |
Najczęściej zadawane pytania dotyczące narzędzi do jezior danych
Oto odpowiedzi na często zadawane pytania dotyczące narzędzi do jezior danych:
W jaki sposób narzędzia do jezior danych obsługują wymagania dotyczące bezpieczeństwa i zgodności?
Narzędzia do jezior danych zapewniają bezpieczeństwo dzięki mechanizmom kontroli dostępu, szyfrowaniu i rejestrowaniu audytów. Większość wiodących platform obsługuje szczegółowe uprawnienia aż do poziomu wiersza lub kolumny, a także integracje z SSO i dostawcami tożsamości. W zakresie zgodności warto szukać certyfikatów dostawców, takich jak SOC 2, HIPAA lub GDPR, oraz opcji korzystania z kluczy szyfrowania zarządzanych przez klienta. Funkcje te pomagają spełniać wymogi regulacyjne bez konieczności tworzenia dodatkowych warstw.
Czy narzędzia do jezior danych można integrować z istniejącymi platformami analitycznymi lub BI?
Tak, większość narzędzi do jezior danych oferuje bezpośrednie konektory do platform analitycznych i BI. Należy oczekiwać gotowej obsługi Spark, Trino, Presto i Athena, a także integracji z Tableau i Power BI. Jeśli zespoły korzystają ze specjalistycznych narzędzi, warto sprawdzić dostępność otwartych interfejsów API lub sterowników ODBC/JDBC, które umożliwiają łączenie niestandardowych przepływów pracy.
Czym różnią się narzędzia do jezior danych od hurtowni danych?
Narzędzia do jezior danych koncentrują się na przechowywaniu danych surowych, częściowo ustrukturyzowanych i nieustrukturyzowanych przy użyciu schematu określanego podczas odczytu, natomiast hurtownie danych przechowują dane ustrukturyzowane ze wstępnie zdefiniowanymi schematami, określanymi podczas zapisu. Jeziora danych lepiej sprawdzają się w przypadku elastycznego pozyskiwania danych oraz obciążeń AI/ML, podczas gdy hurtownie są odpowiednie dla uporządkowanych analiz z zoptymalizowaną wydajnością zapytań. Niektórzy dostawcy oferują obecnie architektury łączące oba podejścia.
Czy narzędzia do jezior danych obsługują wiele formatów danych i typów pozyskiwania danych?
Tak, większość narzędzi do jezior danych akceptuje szeroki zakres formatów, takich jak Parquet, Avro, JSON, ORC i CSV. Dostępna jest również obsługa zarówno źródeł danych przetwarzanych wsadowo, jak i strumieniowo, co umożliwia obsługę wszystkiego — od codziennych zadań pozyskiwania danych po strumienie zdarzeń w czasie rzeczywistym — za pomocą gotowych lub niestandardowych konektorów.
Jak oceniać narzędzia do jezior danych pod kątem skalowalności?
Analizuję opcje magazynowania obiektów oferowane przez każdą platformę, wydajność przy obciążeniach na poziomie petabajtów oraz obsługę wielu chmur. Kluczowe znaczenie ma możliwość warstwowania magazynu, przetwarzania danych w różnych regionach oraz unikania wąskich gardeł dzięki formatom takim jak Delta Lake lub Iceberg. Należy sprawdzić udokumentowane wyniki testów porównawczych i zebrać referencje od klientów dysponujących podobnymi ilościami danych.
Czy otwarte formaty tabel, takie jak Delta Lake lub Apache Iceberg, są ważne?
Tak, otwarte formaty tabel mają znaczenie, jeśli potrzebujesz transakcji ACID, wersjonowania i zarządzania danymi niezależnego od dostawcy. Umożliwiają włączanie funkcji takich jak podróże w czasie i udostępnianie danych bez ich kopiowania. Jeśli dążysz do modelu łączącego jezioro danych z hurtownią lub chcesz zabezpieczyć architekturę na przyszłość, wymagaj zgodności narzędzia do jeziora danych z otwartymi formatami.