Zapewnienie jakości wymaga połączenia proaktywnych działań i skutecznych procedur reaktywnych. Dzięki odpowiedniej równowadze możesz zapewnić użytkownikom doskonałą obsługę i funkcjonalność na serwerze dostępnym przez cały rok. Jedynym sposobem na osiągnięcie tej równowagi jest zidentyfikowanie najistotniejszych wskaźników monitorowania serwera.
Ale jakie mogłyby one być? Zależy to od oczekiwanych przez Ciebie cech, w tym tych określonych w modelu dojrzałości jakościowej, oraz celów monitorowania. Istnieje jednak kilka wskaźników kondycji i wydajności, które inżynierowie QA powinni zawsze śledzić, niezależnie od sytuacji.
Wybierając idealne wskaźniki monitorowania serwera od samego początku, możesz opracować bazowy poziom wydajności, który posłuży jako punkt odniesienia, gdy nieuchronnie pojawią się problemy z kondycją i wydajnością.
W tym krótkim przewodniku przyjrzymy się temu, dlaczego warto śledzić te kluczowe wskaźniki. Ponadto uzyskasz dodatkowe informacje na temat ich znaczenia oraz sposobów ich śledzenia.
1. Wykorzystanie procesora
Jedną z głównych przyczyn monitorowania serwera jest kontrolowanie kondycji infrastruktury i podstawowej wydajności serwera. Kluczową częścią tych działań jest proaktywna diagnostyka i ograniczanie potencjalnych problemów z wydajnością. Pomiar wykorzystania procesora i dysku ma centralne znaczenie dla tych działań. Dlatego wykorzystanie procesora jest jednym z najbardziej podstawowych i najczęściej monitorowanych wskaźników wydajności.
Ten wskaźnik jest uznawany za „oparty na hoście”, ponieważ rejestruje zdolność pojedynczej maszyny do działania i zachowania stabilności. Monitorowanie wykorzystania procesora obejmuje jednak połączenie monitorowania pasywnego i aktywnego. To drugie jest szczególnie przydatne podczas kontrolowanych testów obciążeniowych, natomiast pierwsze zbiera pomiary na urządzeniu docelowym podczas rzeczywistego ruchu.
Jak mierzyć wykorzystanie procesora
Zanim zaczniesz, musisz:
- Wybrać konkretne dyski, które chcesz monitorować.
- Ustalić, gdzie znajdują się te dyski.
- Upewnić się, że moduł zbierający dane ma dostęp do procesów komputera.
Po skonfigurowaniu wszystkiego musisz określić częstotliwość próbkowania, z jaką chcesz śledzić te wskaźniki. Możesz na przykład mierzyć wykorzystanie procesora co 30 sekund lub co minutę.
Istnieje kilka różnych sposobów śledzenia wykorzystania procesora, na przykład za pomocą menedżera zadań lub polecenia takiego jak wmic CPU get load percentage w systemach Windows. Jednak gdy próbujesz uzyskać ogólny obraz serwera, najlepiej wyświetlać te dane na pulpicie nawigacyjnym.
Pamiętaj: Na wydajność procesora wpływają warunki sprzętowe, takie jak temperatura procesora i prędkość wentylatora. Możesz monitorować te czynniki razem z wykorzystaniem, wyrażonym jako wartość procentowa, w tych dwóch stanach, pomijając stan bezczynności.
Dwa kluczowe elementy, które należy dokładnie monitorować, to czas uprzywilejowany i czas użytkownika, ponieważ ich suma daje czas procesora. Definicje poszczególnych wartości są następujące:
- Czas uprzywilejowany: Procent czasu, który procesory wykorzystują na wykonywanie procesów innych niż użytkownika (tj. procesów jądra)
- Czas użytkownika: Procent czasu, który procesory wykorzystują na wykonywanie procesów użytkownika (np. powłoki poleceń, serwera poczty e-mail, kompilatora)
- Czas procesora: Całkowity czas, przez który procesor był zajęty
Pamiętaj, że przekroczenie 100% nie zawsze oznacza przeciążenie systemu. Jeśli na przykład masz system wieloprocesorowy, oznacza to jedynie, że suma wartości dwóch lub większej liczby procesorów przekracza 100% (np. 50% i 60%). Obserwuj ich wydajność indywidualnie, aby utrzymać prawidłową kondycję systemu.
Oprócz wykorzystania procesora i dysku, oczekiwania są również uznawane za istotny element monitorowania kondycji i wydajności infrastruktury.
Have an account? Log In
Oczekiwania
Oczekiwania pomagają określić, jak skutecznie wykonywane są zadania, i ostrzegają o możliwych wąskich gardłach. Sama wiedza o oczekiwaniach nie przyniesie jednak żadnych korzyści. Konieczne będzie przeprowadzenie dodatkowych analiz w celu zidentyfikowania dokładnego problemu z wydajnością.
Wysokie wartości oczekiwania są dopuszczalne w krótkich okresach, ponieważ mogą być spowodowane wykonywaniem intensywnych zadań, ale wszystko, co wykracza poza to, zwykle stanowi powód do niepokoju.
2. Dostępność serwera
Serwer jest bezużyteczny, jeśli nie jest dostępny dla użytkowników. Dlatego monitorowanie dostępności serwera jest niezbędne. Za każdym razem, gdy dostępność serwera spada poniżej 99.999% (standard znany jako „pięć dziewiątek”), masz do czynienia z poważnym problemem.
Skorzystaj z poniższych wzorów, aby uzyskać zrozumiałe i przydatne informacje z działań monitorujących.
Jak mierzyć dostępność serwera
Oto kilka podstawowych pojęć, które warto znać podczas monitorowania dostępności serwera:
- Dostępność: Czas, przez który usługa lub aplikacja jest aktywna i dostępna dla użytkowników. Wzór: (Całkowity czas - Przestój)/Całkowity czas
- Średni czas między awariami (MTBF): Średni czas między incydentami przestoju. Wzór: (Całkowity czas - Przestój)/Liczba incydentów przestoju
- Średni czas rozwiązania (MTTR): Średni czas potrzebny do usunięcia awarii. Wzór: Całkowity czas przestoju/Liczba incydentów przestoju
- Średni czas potwierdzenia (MTTA): Średni czas potrzebny na potwierdzenie trwającej awarii. Wzór: Całkowity czas do potwierdzenia/Liczba incydentów przestoju
Wszystkie te metryki pomagają stworzyć pełny obraz niezawodności infrastruktury i szybkości reakcji zespołu.
Na przykład prawidłowe wartości MTTR i MTTA to dobry znak. Jeśli jednak jednocześnie wartość MTBF jest wysoka, trzeba dokładniej zbadać przyczyny źródłowe przestojów serwera. W przeciwnym razie firmie nadal grożą znaczne straty finansowe i utrata zaufania użytkowników.
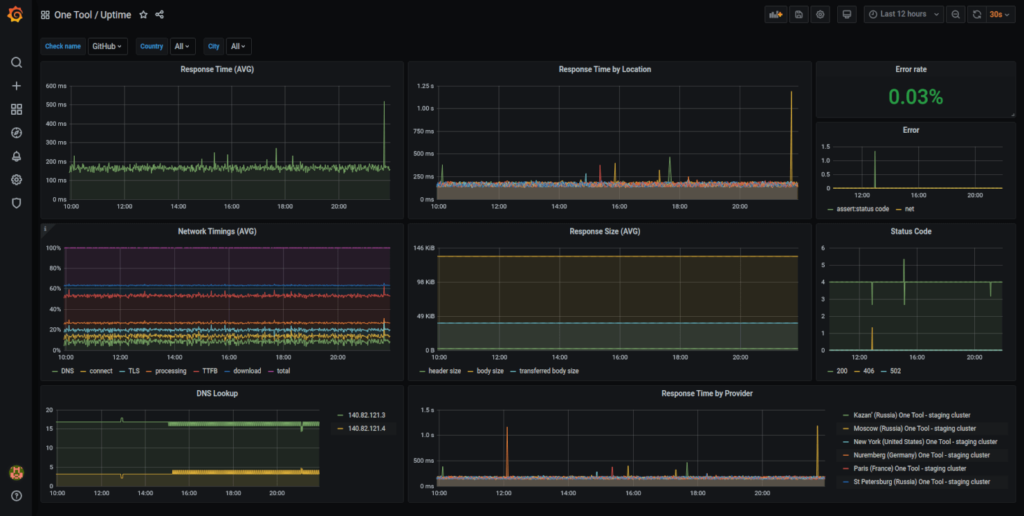
Ostatecznie należy dążyć do „pięciu dziewiątek”, ograniczając przestoje do około pięciu minut rocznie. Oprogramowanie do monitorowania serwerów Grafana i Prometheus jest powszechnie polecane jako przyjazne dla użytkownika i łatwo dostępne narzędzia do tego aspektu monitorowania wydajności.
3. Transakcje (i współczynniki błędów)
Potrzebujesz jasnego obrazu tego, jak duży ruch Twoja infrastruktura obsługuje w danym momencie. Dlatego należy uważnie monitorować transakcje — czyli liczbę żądań na sekundę — oraz odpowiadający im średni czas odpowiedzi. Informacje te pomagają określić ilość zasobów i przepustowość potrzebne do płynnego działania serwera.
Jednocześnie śledzenie współczynnika błędów, czyli odsetka nieudanych żądań w stosunku do wszystkich otrzymanych żądań, może dostarczyć dodatkowych informacji na temat możliwości obsługi obciążenia przez usługę. Aby zmaksymalizować wartość tej metryki, najlepiej z czasem opracować wartość bazową za pomocą monitorowania pasywnego.
Ma to kluczowe znaczenie dla możliwości monitorowania trendów. Jeśli możesz spojrzeć wstecz i określić maksymalną przepustowość oraz zasoby potrzebne do płynnego działania, możesz proaktywnie przydzielić te zasoby, zidentyfikować problemy z infrastrukturą, aby zmniejszyć obserwowane współczynniki błędów, oraz zoptymalizować średni czas odpowiedzi.
Jak monitorować transakcje i współczynniki błędów
Poniżej przedstawiono niezawodne narzędzia do pasywnych technik monitorowania wydajności:
- Analizatory ruchu: Są przeznaczone do zbierania pomiarów na „poziomie mikroskopowym” poprzez „podsłuchiwanie” przepływu ruchu w sieciach przewodowych i bezprzewodowych. Wireshark jest jednym z najpowszechniej uznawanych standardów i gromadzi dane dotyczące takich atrybutów jak znacznik czasu, adres MAC i adres IP, czas życia pakietu oraz inne. Można go używać online lub offline.
- Mechanizmy rejestrowania: Są one zwykle zintegrowane z systemami operacyjnymi i aplikacjami. Gromadzą przede wszystkim informacje o działaniach i zdarzeniach generowanych przez aplikacje do wykorzystania offline.
Jednym z dziesięciu najlepszych narzędzi do monitorowania serwerów internetowych, szczególnie przydatnym do monitorowania transakcji, jest Monitis. To kompleksowy system monitorowania serwerów, witryn internetowych i aplikacji. Działa dobrze zarówno w systemach Windows, jak i Linux, i idealnie nadaje się do monitorowania podstawowych parametrów, w tym dostępności.
Cel i zakres działań monitorujących wpływają na dokładne pomiary oraz sposób wykorzystania tych technik.
More Articles
Inne metryki do monitorowania wraz z transakcjami
Czas odpowiedzi i łączna liczba wątków są bezpośrednio związane z transakcjami. Informują o tym, ile czasu serwer potrzebuje na odpowiedź na żądanie oraz ile wątków (które realizują transakcje) jest używanych do obsługi wszystkich tych żądań.
Każdy wątek zużywa czas procesora i pamięć RAM. Zbyt duża ich liczba może prowadzić do niezadowalającej wydajności. W przypadku tych parametrów należy monitorować między innymi:
- Łączną liczbę wątków w serwerze internetowym lub puli kontenerów, w tym następujące typy:
- Aktywne
- Bezczynne
- Zablokowane
- Gotowe
- Oczekujące żądania użytkowników i długość kolejki
Zazwyczaj można mierzyć czas odpowiedzi serwera jako czas do pierwszego bajtu (TTFB). Jest to liczba milisekund potrzebnych przeglądarce na otrzymanie pierwszego bajtu odpowiedzi serwera. Ogólnie rzecz biorąc, wszystko powyżej pięciu sekund ma znaczenie krytyczne.
Wybór odpowiednich wskaźników do monitorowania wydajności serwera
Istnieje długa lista wskaźników, które można monitorować podczas śledzenia kondycji i wydajności serwera, ale konkretne cele zależą przede wszystkim od założeń działań monitorujących.
Niektóre z nich najlepiej sprawdzają się przy uzyskiwaniu informacji na temat możliwości obciążeniowych sprzętu i systemu operacyjnego, podczas gdy inne idealnie nadają się do obserwowania aktywności użytkowników. W każdym przypadku procesor, czas działania i transakcje to podstawowe elementy, których nie można pominąć.
W miarę jak rozwijasz się jako lider QA, a Twoje cele nieuchronnie się zmieniają, bez wątpienia dodasz do swojego pulpitu nawigacyjnego więcej wskaźników monitorowania serwera. Aby uzyskać więcej eksperckich informacji na temat tego, jakie powinny być i jak nimi zarządzać, zasubskrybuj newsletter.