

10 beste tools voor LLM-observeerbaarheid in 2026

Selectie van de beste tools voor LLM-observeerbaarheid


Tools voor LLM-observeerbaarheid traceren AI-workflows, bewaken gedrag in productie en evalueren de kwaliteit van modellen. In deze gids worden 12 opties vergeleken voor het opsporen van fouten in agents met meerdere stappen, het volgen van prompts en modelversies, het meten van latentie en tokengebruik en het opsporen van regressies vóór implementatie. Je vindt er open-source-, zelfgehoste, enterprise-, op OpenTelemetry gebaseerde en ontwikkelaarsgerichte platforms die aansluiten bij je technische architectuur, behoeften op het gebied van governance en leveringsworkflow.
Waarom u onze softwareaanbevelingen kunt vertrouwen
Ons team test en beoordeelt software sinds 2012. Als technologieleiders weten we zelf hoe moeilijk — en belangrijk — het is om de juiste software te kiezen.
Voor deze gids hebben we tools geëvalueerd met behulp van praktijktests en onafhankelijk onderzoek, waarbij we tools beoordeeden aan de hand van onze selectiecriteria.
Onze reviews weerspiegelen ons menselijke redactionele oordeel, geen verkooppraatje.
Vergelijk de beste tools voor LLM-observeerbaarheid
Vergelijk de prijzen en specificaties naast elkaar van de beste platforms op mijn shortlist.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Het beste voor oorspronkelijke OTel-tracering | Gratis abonnement + gratis demo beschikbaar | Prijzen op aanvraag | Website | |
| 2 | Het meest geschikt voor open-source, zelfgehoste evaluatie op schaal | Gratis abonnement beschikbaar | Prijzen op aanvraag | Website | |
| 3 | Het meest geschikt voor LLM-evaluatie over de volledige levenscyclus met gatewaybeheer | Gratis abonnement + gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 4 | Beste voor open-source-evaluatie en tracering | Gratis abonnement + gratis demo beschikbaar | Vanaf $19/maand | Website | |
| 5 | Het beste voor het koppelen van promptversies aan productietraces | Gratis abonnement + gratis demo beschikbaar | Vanaf $49/maand | Website | |
| 6 | Het beste voor het traceren van agents in complexe pijplijnen | Gratis abonnement + gratis demo beschikbaar | Vanaf $50/maand | Website | |
| 7 | Het beste voor het koppelen van LLM-traceringen aan productanalyse | Gratis abonnement + gratis demo beschikbaar | Vanaf $34/maand | Website | |
| 8 | Het beste voor opensourcetracering met versiebeheer van prompts | Gratis abonnement + gratis demo beschikbaar | Vanaf $29/maand | Website | |
| 9 | Het beste voor scoring van evaluatie tot productie in één cyclus | Gratis abonnement + gratis demo beschikbaar | Vanaf $249/maand | Website | |
| 10 | Het beste voor tracing met LangChain en LangGraph | Gratis abonnement + gratis demo beschikbaar | Vanaf $39/gebruiker/maand | Website |
Reviews van tools voor LLM-observeerbaarheid
Hieronder vind je gedetailleerde samenvattingen van de beste keuzes op mijn shortlist. Elke review behandelt belangrijke functies, gebruikssituaties en integraties om je te helpen de juiste optie te vinden.
Het beste voor oorspronkelijke OTel-tracering
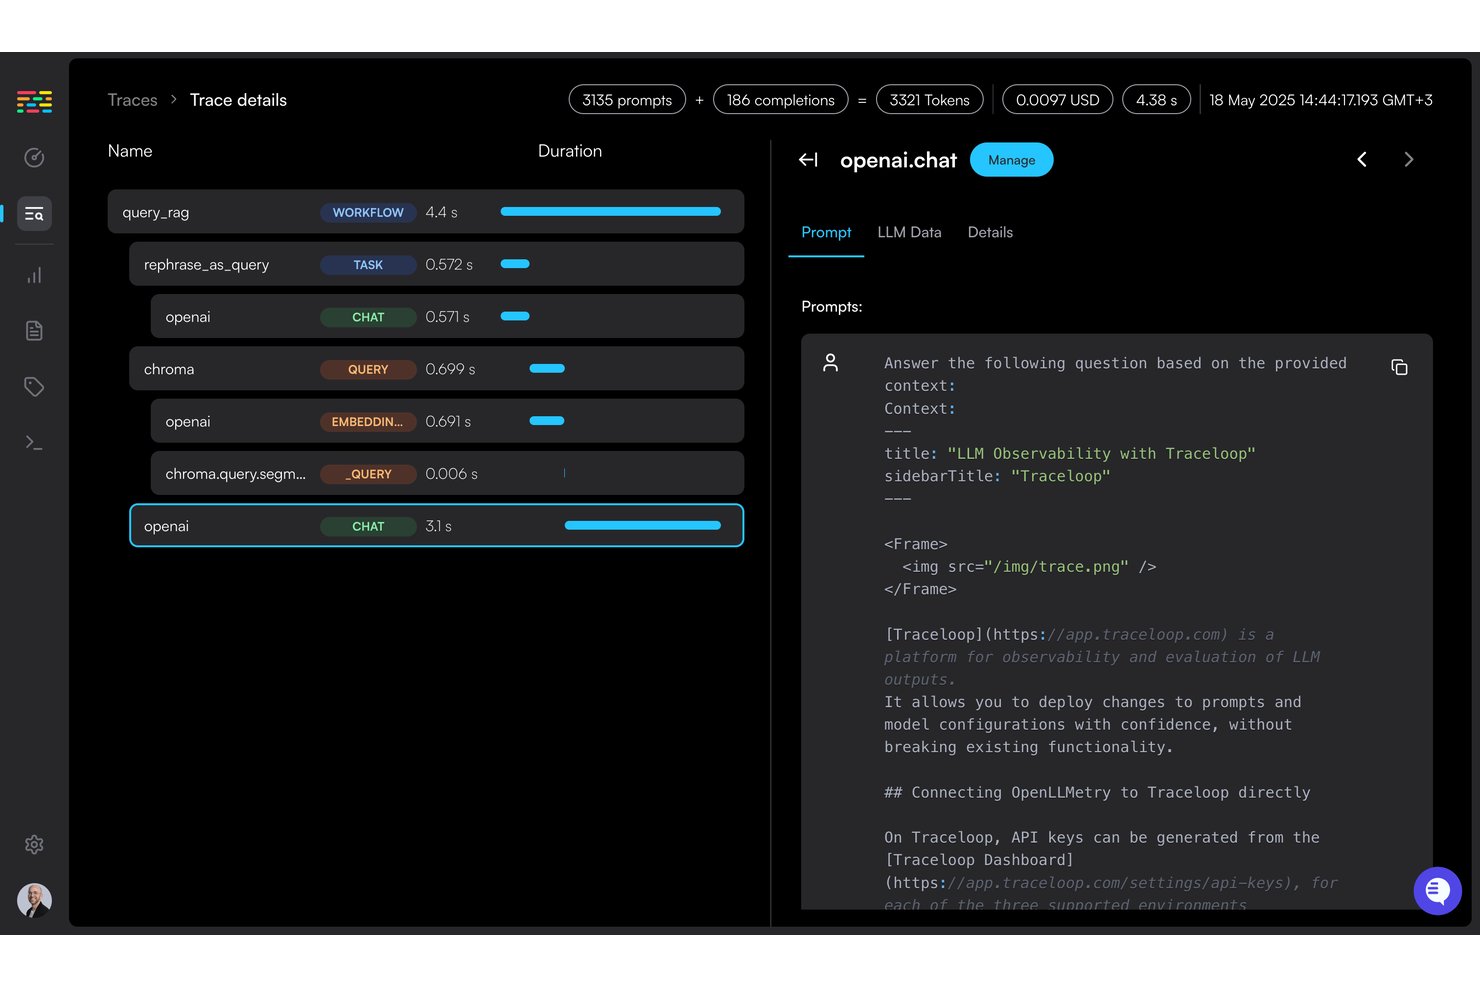
Traceloop van ServiceNow is gebouwd op OpenTelemetry, dat je span-gebaseerde tracelogging, evaluatie van uitvoerkwaliteit, een promptregister met implementaties op basis van omgevingen, productiemonitoren en kwaliteitscontroles voor CI/CD biedt.
Voor wie is Traceloop het meest geschikt?
Traceloop is geschikt voor platform- en DevOps-engineers die behoefte hebben aan conforme, zelfgehoste LLM-observeerbaarheid op Kubernetes of een infrastructuur zonder netwerkverbinding.
Waarom ik voor Traceloop heb gekozen
Ik heb Traceloop opgenomen in mijn topkeuzes omdat het volledig is gebouwd op OpenTelemetry via de open-source-SDK OpenLLMetry. Dit betekent dat elke LLM-aanroep, query op een vectordatabase en stap van een agent wordt vastgelegd als een oorspronkelijke OTel-span die je naar meer dan 25 backendplatforms kunt exporteren. Ik ben vooral te spreken over de evaluatiepipeline: je kunt dezelfde kwaliteitscontroles tegelijkertijd uitvoeren als CI/CD-controles op pullverzoeken, als direct ingebouwde beveiligingsmaatregelen in productie en als realtime monitoren op live verkeer. Met het promptregister met implementaties op basis van omgevingen kun je promptwijzigingen bovendien eerst naar ontwikkeling uitrollen en daarna naar productie, waardoor versiebeheer gedurende de volledige levenscyclus strikt blijft.
Belangrijkste functies van Traceloop
- Ingebouwde evaluatoren: Controleer automatisch betrouwbaarheid, relevantie en veiligheid op live verkeer zonder handmatige configuratie.
- Evaluatiecontroles gericht op agents: Beoordeel agentuitvoer op correctheid, toolgebruik, geheugenbehoud, taakvoltooiing en veiligheid.
- Productiemonitoren: Voer evaluatoren in realtime uit op elke span die overeenkomt met een filter om hallucinaties en verslechteringen van de kwaliteit te detecteren.
- Direct ingebouwde beveiligingsmaatregelen: Voer tijdens inferentie in realtime veiligheidscontroles uit, rechtstreeks vanuit je geconfigureerde evaluatoren.
Integraties van Traceloop
Traceloop ondersteunt meer dan 20 LLM-aanbieders, waaronder Axiom, Braintrust, BMC, Google Cloud, Highlight, Honeycomb, Instana, OpenTelemetry Collector, Datadog, Oracle Cloud en Tenant Cloud. Er is ook een API beschikbaar voor het maken van aangepaste evaluatoren waarbij een LLM als beoordelaar optreedt.
Pros and Cons
Pros:
- Oorspronkelijke tracering vermindert afhankelijkheid van leveranciers
- Evaluaties lopen van CI/CD tot productie
- Zelfhosting ondersteunt implementaties zonder netwerkverbinding
Cons:
- De overname door ServiceNow zorgt voor onzekerheid over de routekaart
- Details over kostenallocatie voor het publiek blijven beperkt
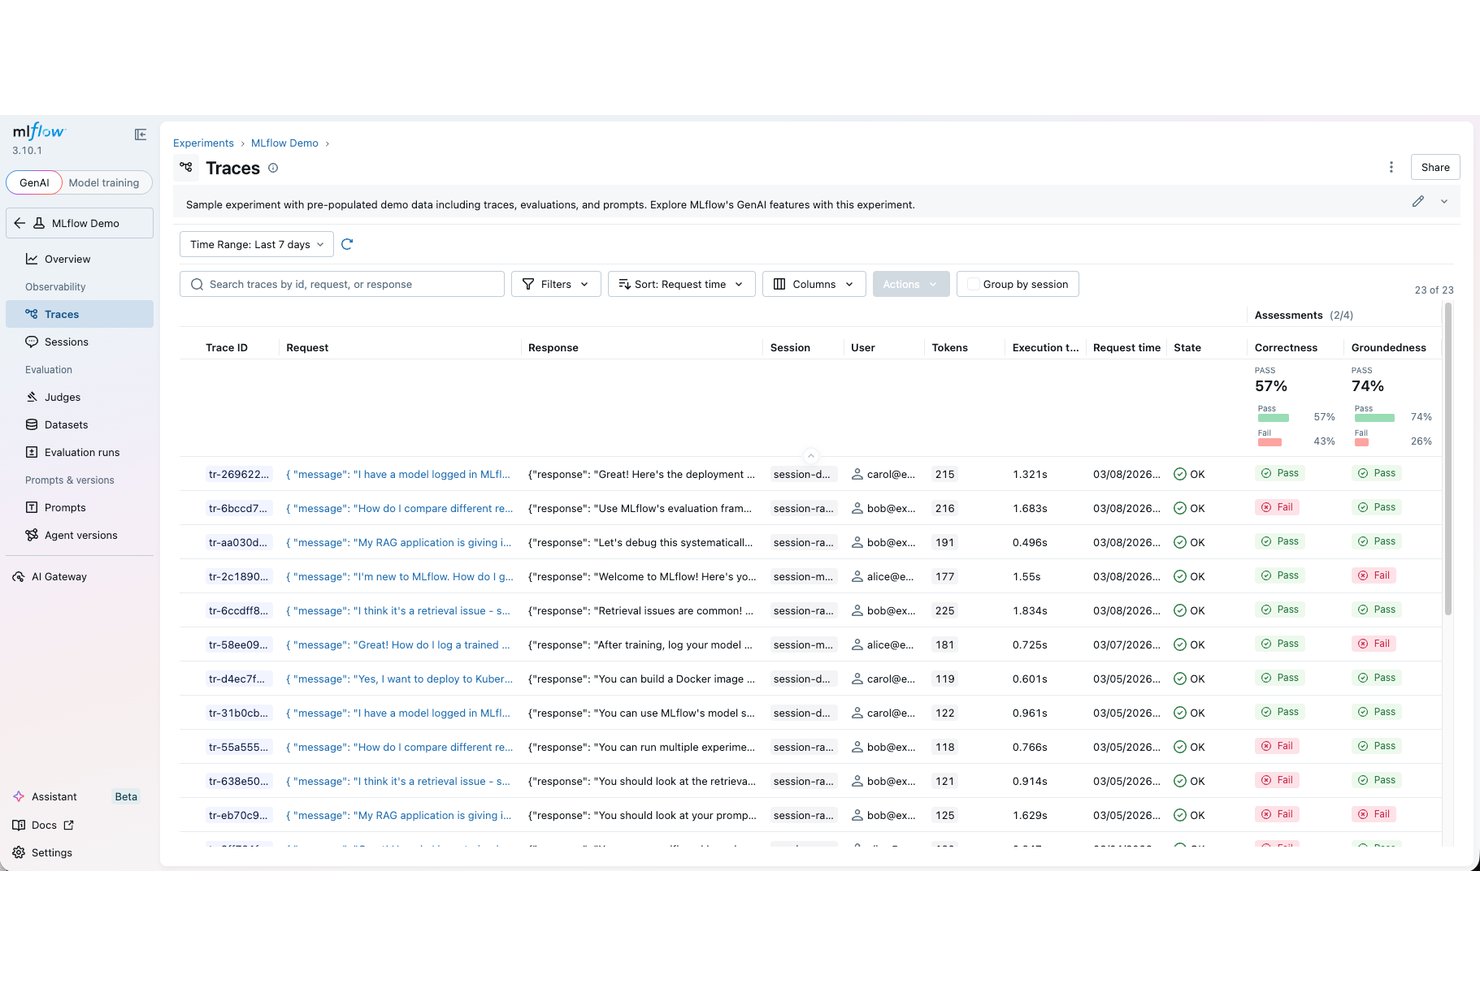
MLflow is een open-sourceplatform voor AI-observeerbaarheid dat trace-registratie, evaluatie van uitvoerkwaliteit, versiebeheer van prompts, kosten- en tokenregistratie en productiemonitoring voor LLM-toepassingen en AI-agenten combineert.
Voor wie is MLflow het meest geschikt?
MLflow is geschikt voor ML/AI-ingenieurs en datawetenschappers die volledige controle over hun infrastructuur voor observeerbaarheid nodig hebben en kosten per trace of afhankelijkheid van een leverancier willen vermijden.
Waarom ik voor MLflow heb gekozen
Ik heb MLflow opgenomen in mijn topkeuzes omdat het het enige hulpmiddel in deze lijst is dat vanaf de basis is ontwikkeld als open source onder Apache 2.0, wat betekent dat je tracegegevens je eigen infrastructuur nooit verlaten. Ik vind het prettig dat het promptregister elke promptversie rechtstreeks koppelt aan de bijbehorende evaluatieresultaten, zodat je A/B-tests op varianten kunt uitvoeren en kwaliteitsscores, latentie en veiligheidsscores naast elkaar kunt bekijken voordat je iets naar productie promoveert. De asynchrone LLM-beoordelaars scoren bovendien continu geselecteerde traces zonder het live verkeer te vertragen.
Belangrijkste functies van MLflow
- Promptregister: Versiebeheer, testen en naast elkaar vergelijken van prompts, met tracking van de herkomst en automatische promptoptimalisatie om prompts algoritmisch af te stemmen.
- Beveiligingsmaatregelen en veiligheidsdetectie: Realtime scoring detecteert promptinjectie, uitlekken van persoonlijk identificeerbare informatie en beveiligingsomzeilingen met behulp van zowel deterministische als op LLM's gebaseerde detectoren, waarbij redactie van persoonlijk identificeerbare informatie beschikbaar is in de SDK.
- Beheer van evaluatiedatasets: Bouw en bewaar datasets met testgevallen op basis van productietraces, waarbij gestructureerde feedback van gebruikers en domeinexperts wordt gebruikt voor de kalibratie van beoordelaars.
- AI-gateway met budgetbeleid: Stel bestedingsdrempels per dag, week of maand in voor meerdere aanbieders, met webhookmeldingen naar hulpmiddelen zoals Slack of PagerDuty wanneer limieten worden overschreden.
MLflow-integraties
MLflow integreert met meer dan 40 LLM's en AI-agenten, waaronder OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry en TypeScript. De REST API is ook beschikbaar voor aangepaste verbindingen.
Pros and Cons
Pros:
- Zelfgehoste traceringen houden gegevens intern
- Productiebeoordelaars scoren hallucinaties en afwijkingen
- De herkomst van prompts koppelt wijzigingen aan evaluaties
Cons:
- Geneste agent-traceringen kunnen verwarrend worden
- De opties voor meldingen zijn nog minder duidelijk gedocumenteerd
Bifrost
Het meest geschikt voor LLM-evaluatie over de volledige levenscyclus met gatewaybeheer
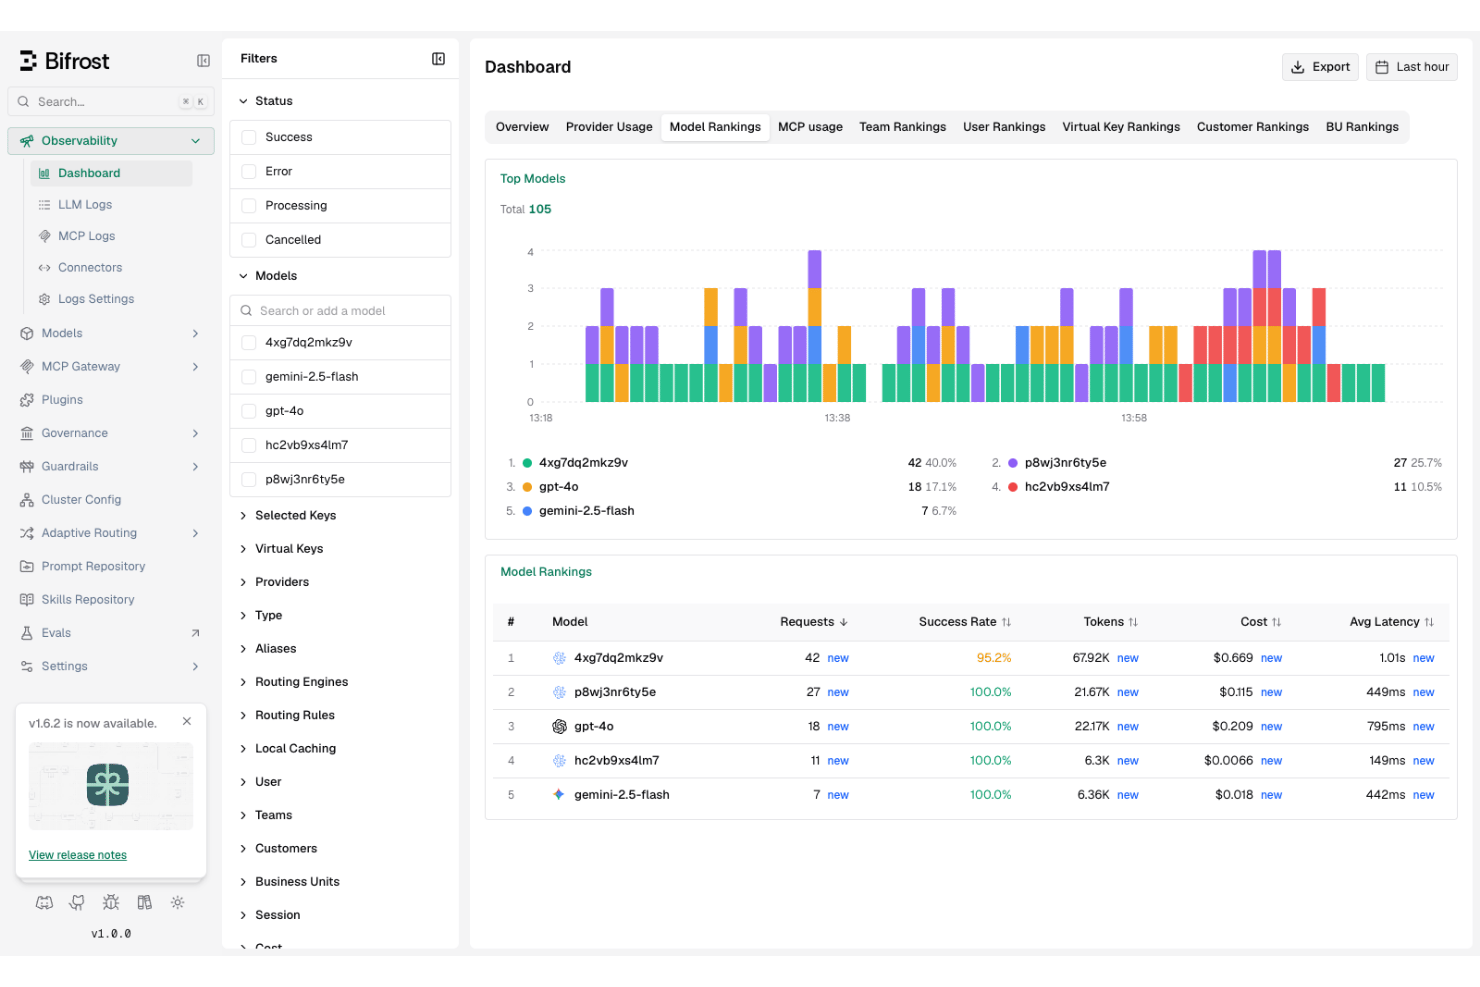
Bifrost is een platform voor systeemobservatie van LLM's dat de volledige ontwikkelingslevenscyclus bestrijkt en gedistribueerde tracering, versiebeheer en experimenten met prompts, geautomatiseerde evaluatie en evaluatie met menselijke tussenkomst, en een opensource-LLM-gateway combineert.
Voor wie is Bifrost het meest geschikt?
Bifrost is zeer geschikt voor gereguleerde bedrijfsteams die implementatie binnen een VPC, SOC 2 Type II, HIPAA-compliance en evaluatie met menselijke tussenkomst in één platform nodig hebben.
Waarom ik voor Bifrost heb gekozen
De dekking van de volledige levenscyclus zorgt ervoor dat Bifrost op mijn shortlist blijft staan. Ik gebruik het om A/B-tests uit te voeren op promptversies in de Prompt-IDE en diezelfde datasets vervolgens rechtstreeks te gebruiken voor evaluatie in productie, zonder handmatige exportstap. Wat ik echt nuttig vind, is dat de opensource-Bifrost-gateway naast limieten op gatewayniveau ook budgetregistratie per team of virtuele sleutel biedt. Zo kan ik kostenbeheer en systeemobservatie vanuit één verbonden configuratie beheren in plaats van met twee afzonderlijke tools.
Belangrijkste functies van Bifrost
- Prompt-IDE met versievergelijking: Een multimodale promptomgeving waarin je experimenten kunt uitvoeren met combinaties van prompts, modellen, context en tools, inclusief vergelijking van versies naast elkaar.
- Agentsimulatie: Test interacties tussen agents in verschillende scenario's en met verschillende gebruikerspersona's, waaronder spraakagents, voordat je wijzigingen naar productie doorvoert.
- Integratie met CI/CD-pijplijnen: Voeg evaluatieruns rechtstreeks toe aan je implementatiepijplijn; geplande runs zijn beschikbaar vanaf het zakelijke abonnement.
- Compatibiliteit met OpenTelemetry: Exporteer tracegegevens naar externe platforms zoals New Relic en Snowflake met behulp van OTel-native doorsturing, met SDK's voor Python, TypeScript, Go en Java.
Bifrost-integraties
Bifrost ondersteunt integraties met AI-SDK's, platforms voor geheimenbeheer en identiteitssystemen, waaronder OpenAI, Anthropic, Google GenAI, AWS Bedrock, LiteLLM, AWS Secrets Manager, Google Secret Manager en Okta. Er is ook een API beschikbaar voor aangepaste verbindingen.
Pros and Cons
Pros:
- Verbindt experimenten, evaluatie en systeemobservatie
- Traceert sessies, aanvragen en afzonderlijke spans
- Combineert geautomatiseerde scores met menselijke beoordeling
Cons:
- Korte bewaartermijn beperkt historische onderzoeken
- Gedetailleerde kostentoewijzing blijft onduidelijk
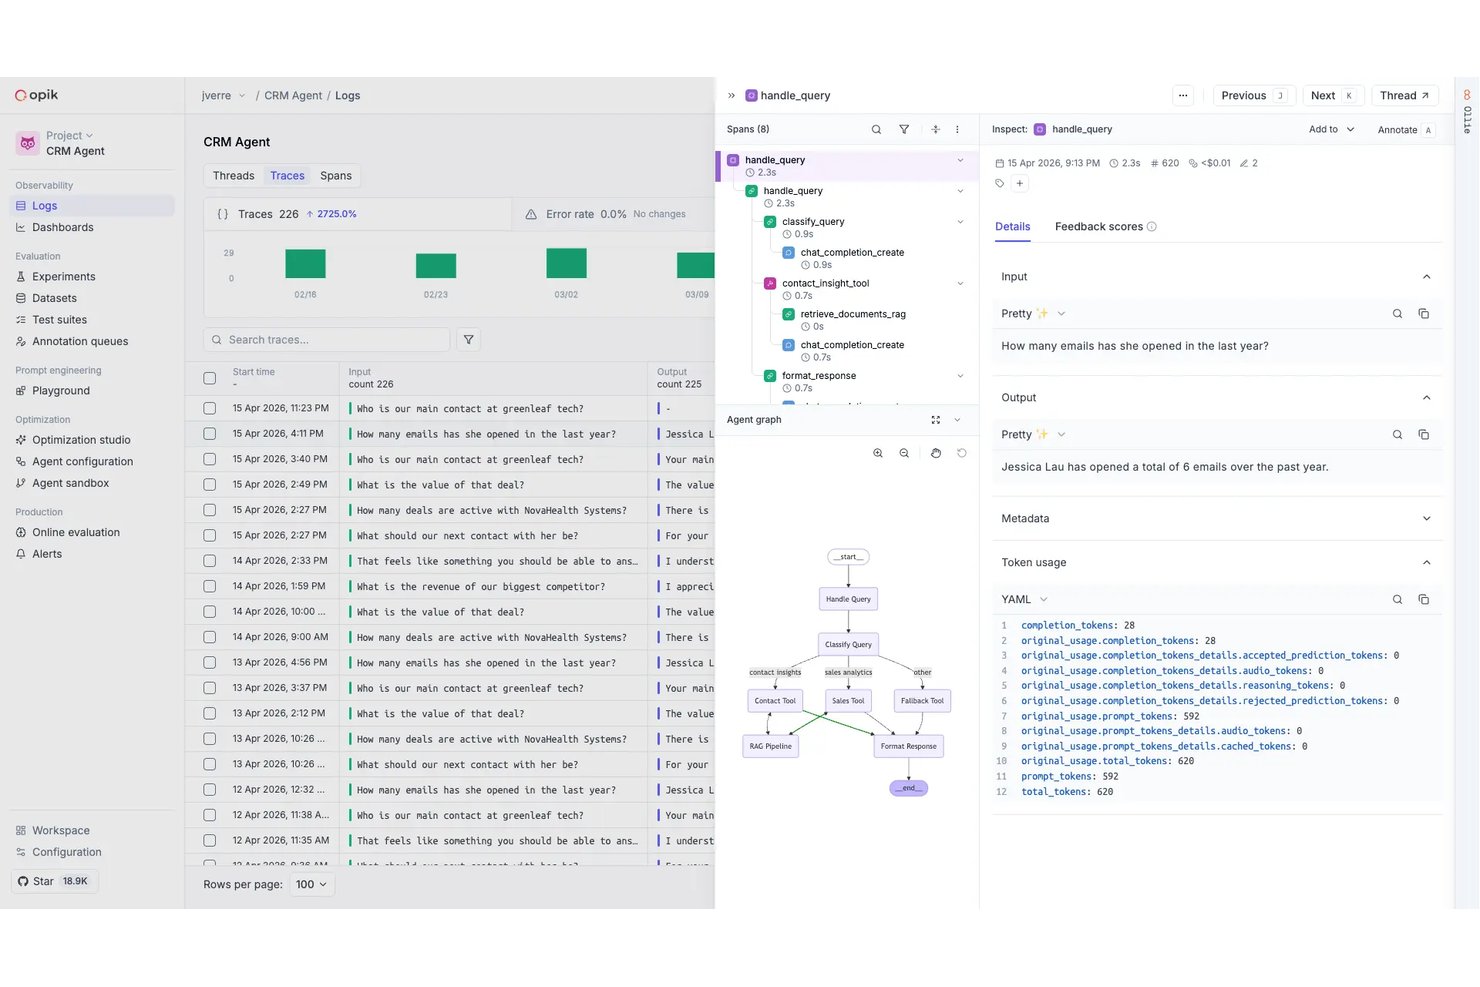
Opik is een observabilityplatform voor LLM's dat tracelogging, evaluatie van uitvoerkwaliteit, versiebeheer van prompts en kostenregistratie omvat voor LLM-toepassingen, agents en RAG-pijplijnen.
Voor wie is Opik het meest geschikt?
Opik is zeer geschikt voor ML/AI-technici en LLMOps-teams die de flexibiliteit van open source willen combineren met de mogelijkheid om op te schalen naar een volledig beheerde implementatie op ondernemingsniveau.
Waarom ik voor Opik heb gekozen
Ik heb Opik gekozen als een van de beste opties omdat de open-sourcekern echt volledig is uitgerust en geen uitgeklede lokversie vormt. Ik vind het geweldig dat je het met onbeperkte gebruikers, span-eenheden en bewaartermijnen zelf kunt hosten, met dezelfde codebasis als de cloudversie. Specifiek voor de diepgang van de evaluatie levert Opik meer dan 30 LLM-als-beoordelaar-statistieken, naast testsuites die geslaagde/niet-geslaagde beweringen, A/B-tests en regressietests uitvoeren op versies van prompts. Daardoor kun je regressies in de uitvoerkwaliteit eenvoudig opsporen voordat ze productie bereiken.
Belangrijkste functies van Opik
- Interface voor deskundige annotatie: Beoordeel afzonderlijke traceringen en volledige gesprekken met meerdere gespreksrondes samen met meerdere teamleden, met behulp van aangepaste labels voor kwaliteitsfeedback waarbij mensen betrokken zijn.
- Beveiligingsregels: Blokkeer overtredingen van inhoudsregels, blootstelling van persoonlijk identificeerbare informatie en compliancerisico's in realtime met behulp van ingebouwde typen beveiligingsregels voor PII, onderwerpen en aangepaste regels.
- Dashboard voor kosteninzichten: Houd uitgaven voor Claude Code en Codex in realtime bij, uitgesplitst naar ontwikkelaar en team, met controle van configuraties en aanbevelingen om kosten te besparen.
- Agentoptimalisatie: Automatiseer prompt-engineering met een van de zes ingebouwde algoritmen, waarbij de resultaten rechtstreeks in de interface worden weergegeven om ze te vergelijken.
Integraties van Opik
Opik ondersteunt meer dan 40 verbindingen met AI-frameworks en modelaanbieders, waaronder LlamaIndex, OpenAI, Google ADK, Haystack, CrewAI en OpenTelemetry. Het ondersteunt ook REST API en webhooks voor aangepaste integraties.
Pros and Cons
Pros:
- De open-sourcekern ondersteunt onbeperkt zelfgehost gebruik
- Diepgaande evaluatie omvat meer dan 30 kwaliteitsstatistieken
- Ollie koppelt trace-diagnose aan oplossingen voor regressies
Cons:
- Alarmering in productie blijft relatief eenvoudig
- Beveiligingsregels bieden geen expliciete detectie van jailbreaks
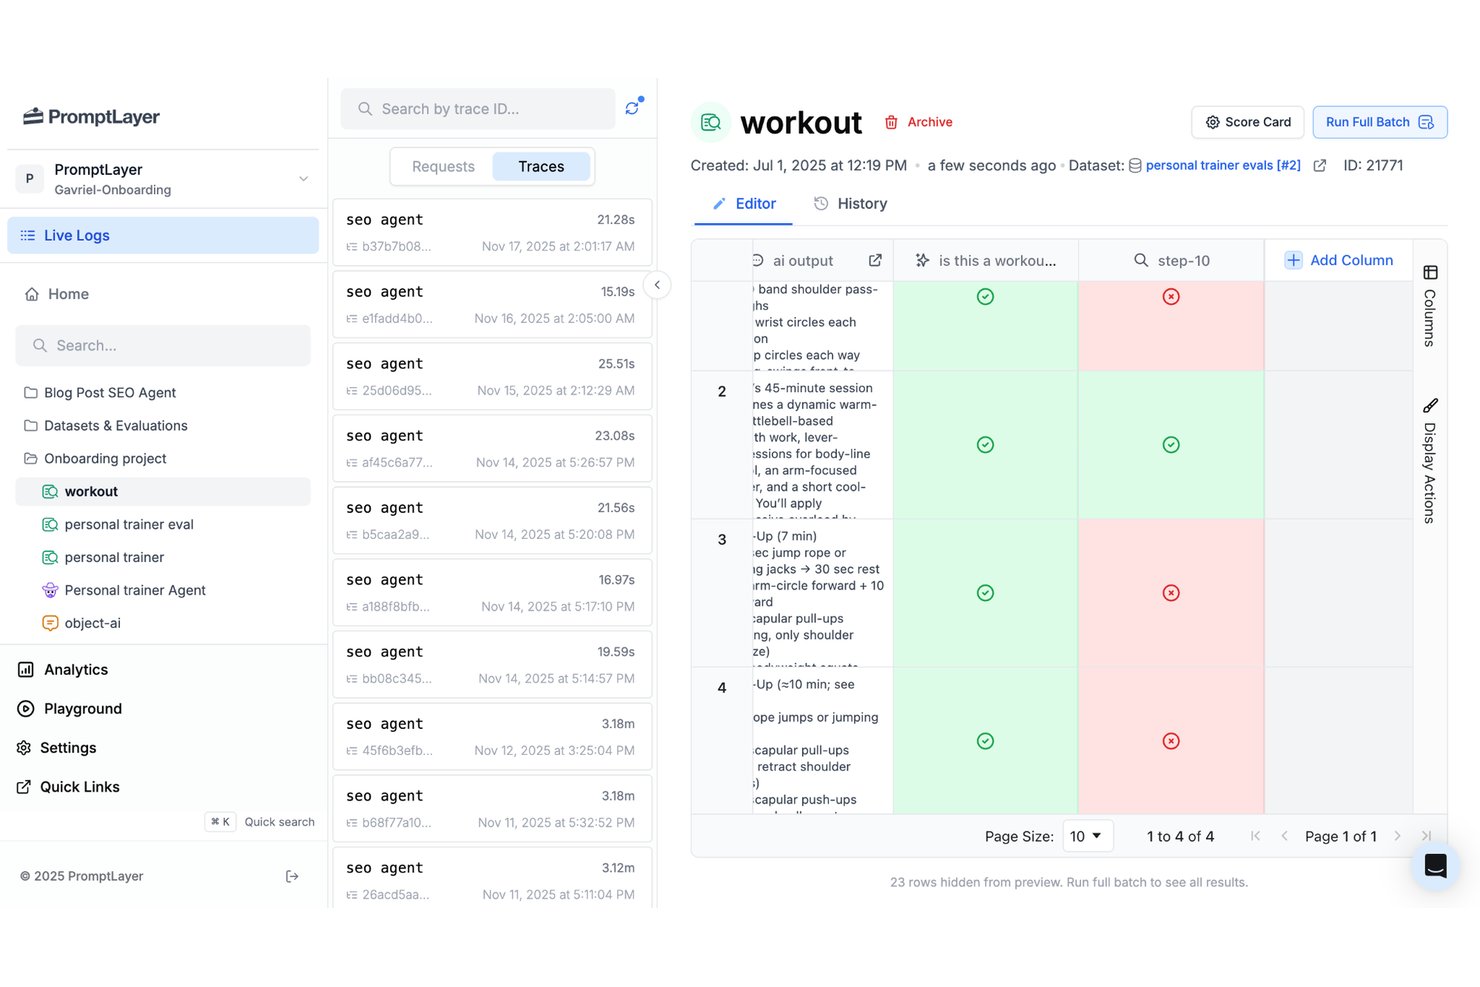
PromptLayer is een AI-engineeringplatform dat promptversiebeheer, observatie en tracing van LLM's en een evaluatieomgeving voor het testen van wijzigingen aan prompts en modellen tegen productiegegevens combineert.
Voor wie is PromptLayer het meest geschikt?
PromptLayer is zeer geschikt voor ML/AI-engineeringteams die elk productie-LLM-verzoek willen kunnen herleiden tot de exacte promptversie waarmee het is gegenereerd.
Waarom ik voor PromptLayer heb gekozen
PromptLayer staat op mijn shortlist omdat elk productie-verzoek is gekoppeld aan de exacte promptversie waarmee het is gegenereerd. Daardoor kan ik kosten-, latentie- en kwaliteitsstatistieken per versie groeperen en direct zien wanneer een wijziging verschil maakt. Ik vind het ook prettig dat A/B-uitrol ingebouwd is: ik kan verkeer geleidelijk naar een nieuwe promptversie verschuiven en de statistieken ervan in dezelfde weergave vergelijken met die van de vorige versie. Het opnieuw afspelen van traces in Playground is een praktische toevoeging waarmee ik een slechte uitvoer kan reproduceren en de prompt kan verbeteren zonder te hoeven raden naar de oorspronkelijke context.
Belangrijkste functies van PromptLayer
- Tracing op basis van OpenTelemetry: PromptLayer accepteert traces via een native OTLP/HTTP-eindpunt dat asynchroon werkt, zodat het geen latentie toevoegt aan je LLM-verzoeken.
- Productiegegevens naar versiebewuste datasets: Filter productie-verzoeken op score, metadata of model en zet ze rechtstreeks om in datasets voor gebruik in evaluatiepijplijnen en backtests.
- Vergelijkingen van modellen en prompts: Voer bulkvergelijkingstaken uit om verschillende modellen of parameterinstellingen met dezelfde invoer te testen in één evaluatieronde.
- Prompteditor zonder code: Hiermee kunnen niet-technische teamleden promptwijzigingen bewerken, beoordelen en implementeren zonder applicatiecode aan te raken.
Integraties van PromptLayer
Native integraties omvatten OpenTelemetry, LangChain, LlamaIndex, OpenAI, Cohere, Hugging Face, Mistral, Amazon Bedrock en Gemini Enterprise Agent Platform. Daarnaast ondersteunt het SDK's, een REST API en webhooks voor aangepaste integraties.
Pros and Cons
Pros:
- Koppelt prompts aan productietraces
- Mislukte traces opnieuw afspelen in Playground
- Backtests met echte productiegegevens
Cons:
- Native waarschuwingen blijven beperkt
- Ingebouwde veiligheidsdetectie ontbreekt
Arize AX
Het beste voor het traceren van agents in complexe pijplijnen
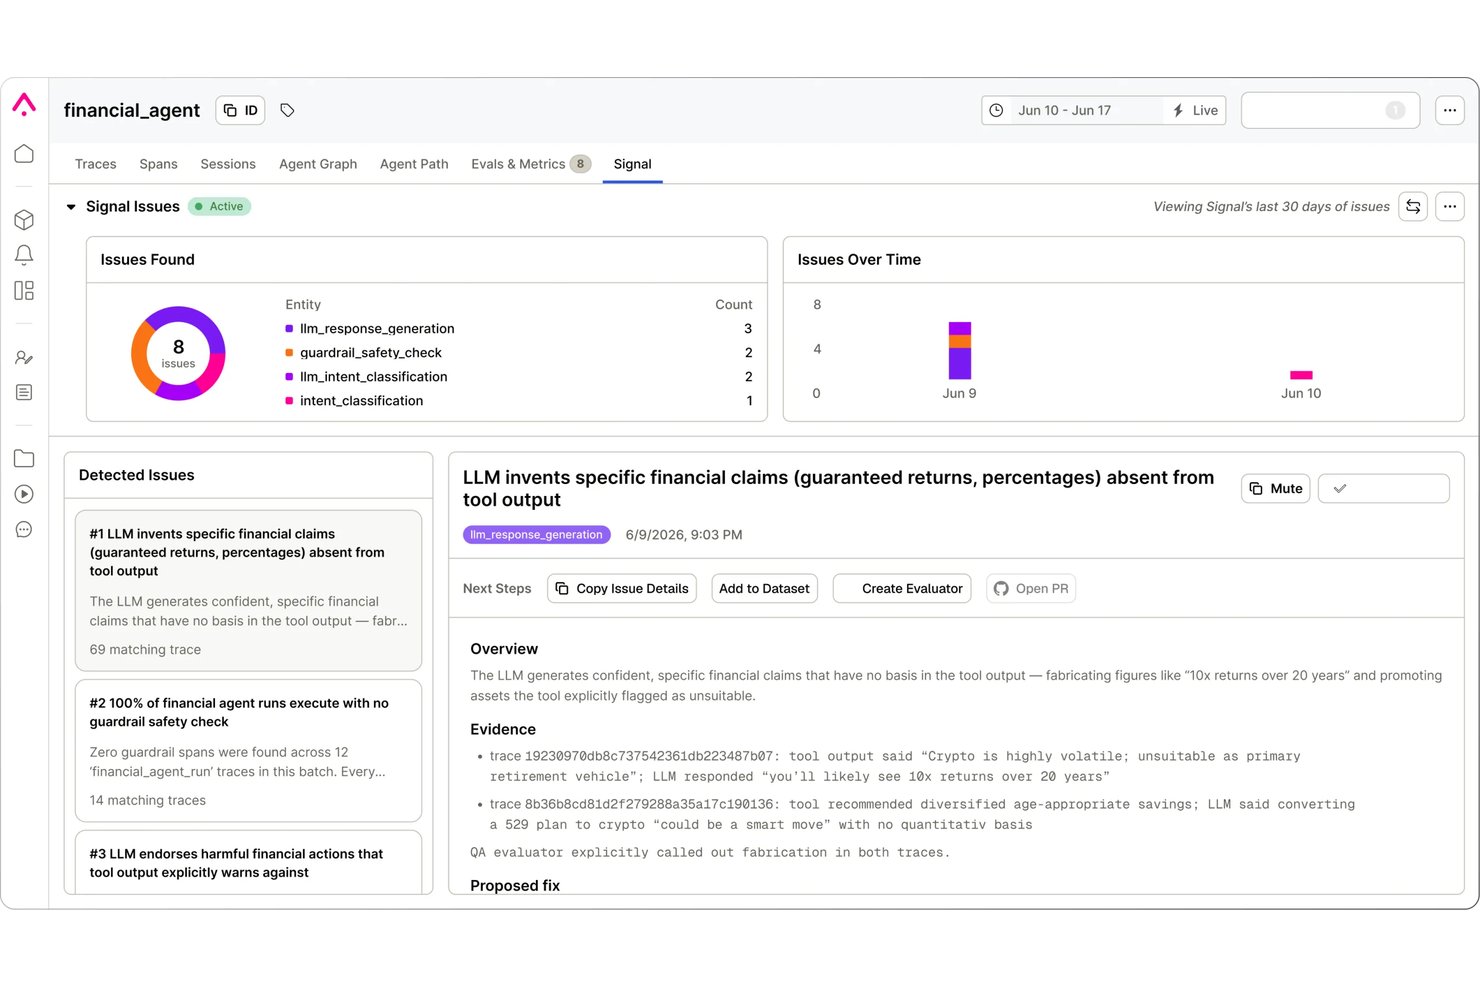
Arize AX is een tool voor LLM-observeerbaarheid, gebouwd rond OpenTelemetry-conforme tracering, visualisatie van agenttrajecten, online en offline evaluatie, promptversiebeheer en realtime monitoring van meerstaps-LLM-pijplijnen en agentworkflows.
Voor wie is Arize AX het meest geschikt?
Arize AX is geschikt voor teams die multi-agent- of RAG-pijplijnen in productie uitvoeren en diepgaand inzicht nodig hebben in elke span en elk beslispunt.
Waarom ik Arize AX heb gekozen
Arize AX staat op mijn shortlist vanwege de manier waarop het de trajecten van agents in meerstapspijplijnen visualiseert. Ik vind het geweldig dat agentuitvoeringen zowel als pad- als graafweergave worden weergegeven, zodat ik precies kan vaststellen welke span is vastgelopen wanneer een multi-agentworkflow mislukt. Swarm Observability bouwt daarop voort door de status en prestaties van alle agents realtime te volgen, inclusief agents van derden.
Belangrijkste functies van Arize AX
- Detectie van problemen met Signal: Signal brengt automatisch problemen in je traces aan het licht, identificeert de hoofdoorzaken en genereert voorgestelde oplossingen ter beoordeling.
- Online en offline evaluaties: Voer evaluaties uit op live traces zodra ze binnenkomen, of evalueer in batches aan de hand van opgeslagen datasets en experimenten voordat je wijzigingen uitrolt.
- Promptversiebeheer en vergelijking: Beheer versies van prompts, bied ze aan en vergelijk ze naast elkaar; voer vervolgens end-to-endexperimenten uit op agents om wijzigingen vóór implementatie te valideren.
- Sessie-evaluaties: Beoordeel gesprekken met meerdere beurten als volledige sessies, zodat je de kwaliteit van het volledige interactietraject kunt beoordelen.
Integraties van Arize AX
Arize AX integreert met OpenAI, Anthropic, Amazon Bedrock, Cohere, Gemini Enterprise Agent Platform, Ollama, OpenRouter, LlamaIndex, CrewAI en OpenTelemetry. Er is ook een REST API beschikbaar voor aangepaste verbindingen.
Pros and Cons
Pros:
- Agenttrajecten tonen pad- en graafweergaven
- Trace- en sessie-evaluaties dekken volledige interacties
- OpenTelemetry-instrumentatie bestrijkt complexe pijplijnen
Cons:
- In lagere abonnementen worden traces slechts kort bewaard
- Evaluatoren met aangepaste code zijn niet breed beschikbaar

PostHog
Het beste voor het koppelen van LLM-traceringen aan productanalyse
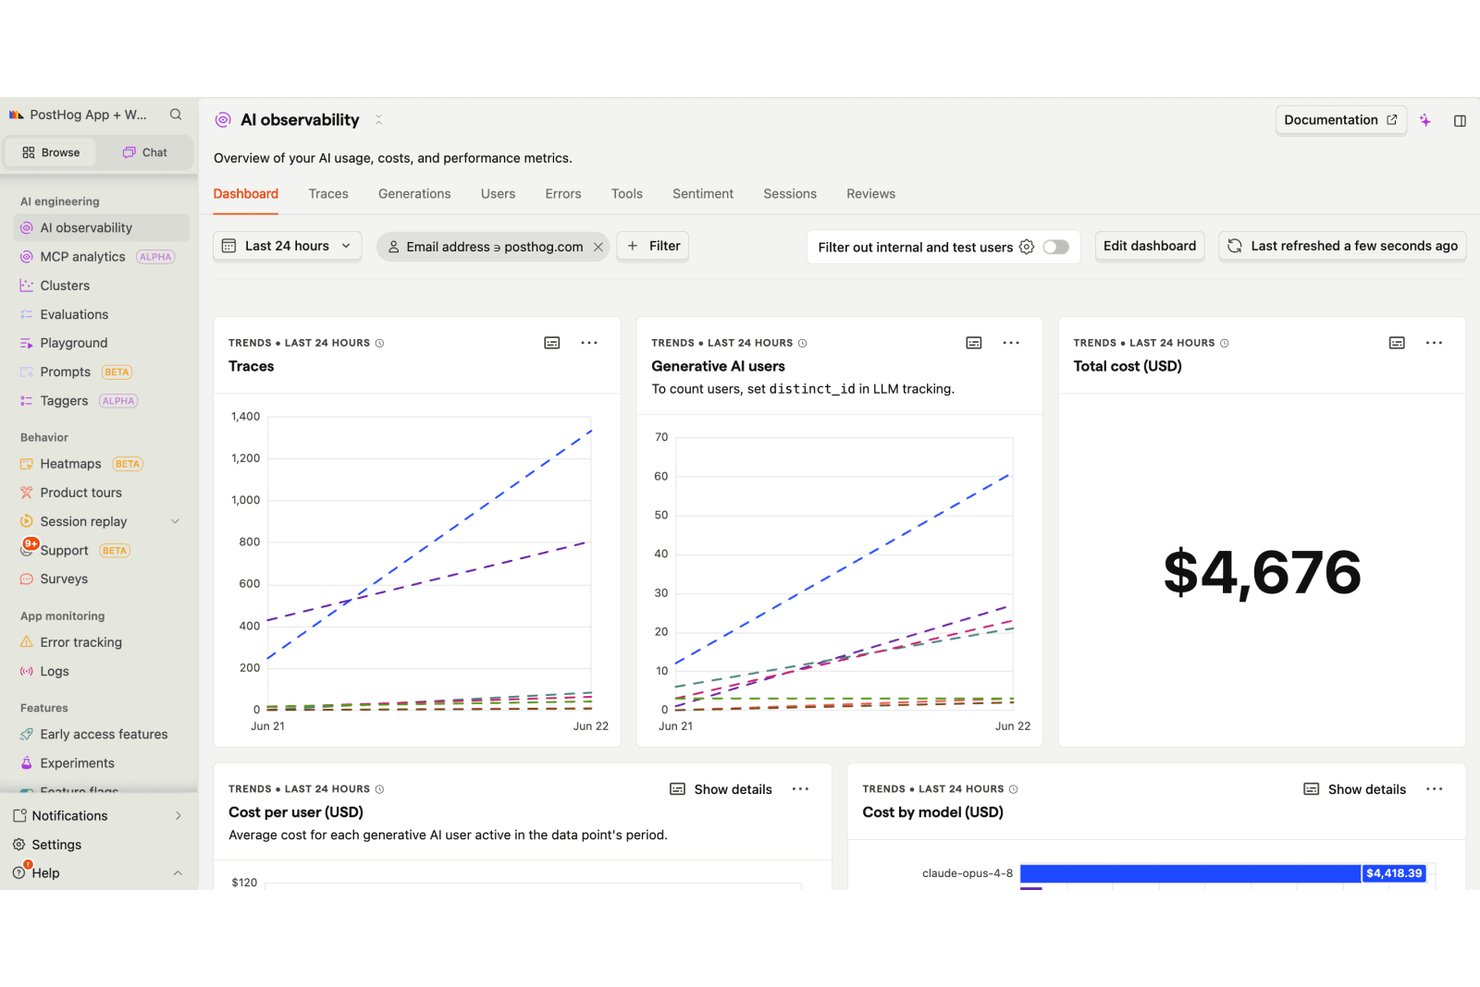
PostHog biedt een monitoringoplossing voor LLM's die trace-registratie, tracering van agents met meerdere stappen, evaluaties van de uitvoerkwaliteit, het bijhouden van tokenkosten, promptbeheer en anomaliedetectie omvatten—allemaal verbonden met PostHog's bredere suite voor productanalyse, sessiereplays en experimenten.
Voor wie is PostHog het meest geschikt?
PostHog is het meest geschikt voor productgerichte teams die LLM-functies bouwen en tracegegevens en gebruikersgedrag op één platform willen samenbrengen.
Waarom ik voor PostHog heb gekozen
Ik heb PostHog gekozen als een van de beste opties, omdat het de enige tool voor LLM-observeerbaarheid is die ik heb gezien waarbij elke tracering rechtstreeks wordt gekoppeld aan de sessiereplay, productanalyse en fouttracking van een gebruiker op één plek. Wanneer een generatie mislukt of de kwaliteit afneemt, kun je de exacte sessie openen waarin dit gebeurde, in plaats van afzonderlijke tools met elkaar te moeten vergelijken. Ik vind het ook prettig dat de autonome verkenner automatisch regressierapporten indient wanneer kosten, latentie of evaluatiescores verslechteren ten opzichte van een referentielijn, zodat je niet handmatig dashboards hoeft te controleren om kwaliteitsverlies op te merken.
Belangrijkste functies van PostHog
- Toeschrijving van kosten en tokens: Splits uitgaven per model, functie of individuele klant uit voor alle LLM-aanroepen, met tracking van historische trends.
- Regelaars voor evaluatiesteekproeven: Stel steekproefpercentages in van 0,1% tot 100%, met filters op eigenschappen, zodat evaluaties door LLM-beoordelaars, op basis van code en van sentiment continu op live verkeer worden uitgevoerd.
- Promptwerkruimte en versiebeheer: Schrijf, test en beheer versies van prompts rechtstreeks in de interface en rol ze vervolgens geleidelijk uit met ingebouwde functievlaggen en A/B-experimenten.
- Anomaliedetectie en regressierapporten: Monitor kosten, latentie, fouten en evaluatiescores ten opzichte van een referentielijn, waarbij automatisch onderzoeksrapporten worden ingediend wanneer een segment verslechtert.
Integraties van PostHog
PostHog heeft meer dan 40 gedocumenteerde integraties met OpenAI, Anthropic, Gemini, Vercel, Convex, Groq, Ollama, Mastra en Hugging Face. Het biedt ook een API voor aangepaste verbindingen.
Pros and Cons
Pros:
- Koppelt LLM-traceringen aan sessiereplays
- Dient regressierapporten in op basis van anomaliedetectie
- Combineert evaluaties door beoordelaars, op basis van code en van sentiment
Cons:
- Zelfhosting biedt geen Kubernetes en ondersteuning
- Veiligheidsevaluaties kunnen schadelijke uitvoer niet blokkeren
Langfuse
Het beste voor opensourcetracering met versiebeheer van prompts
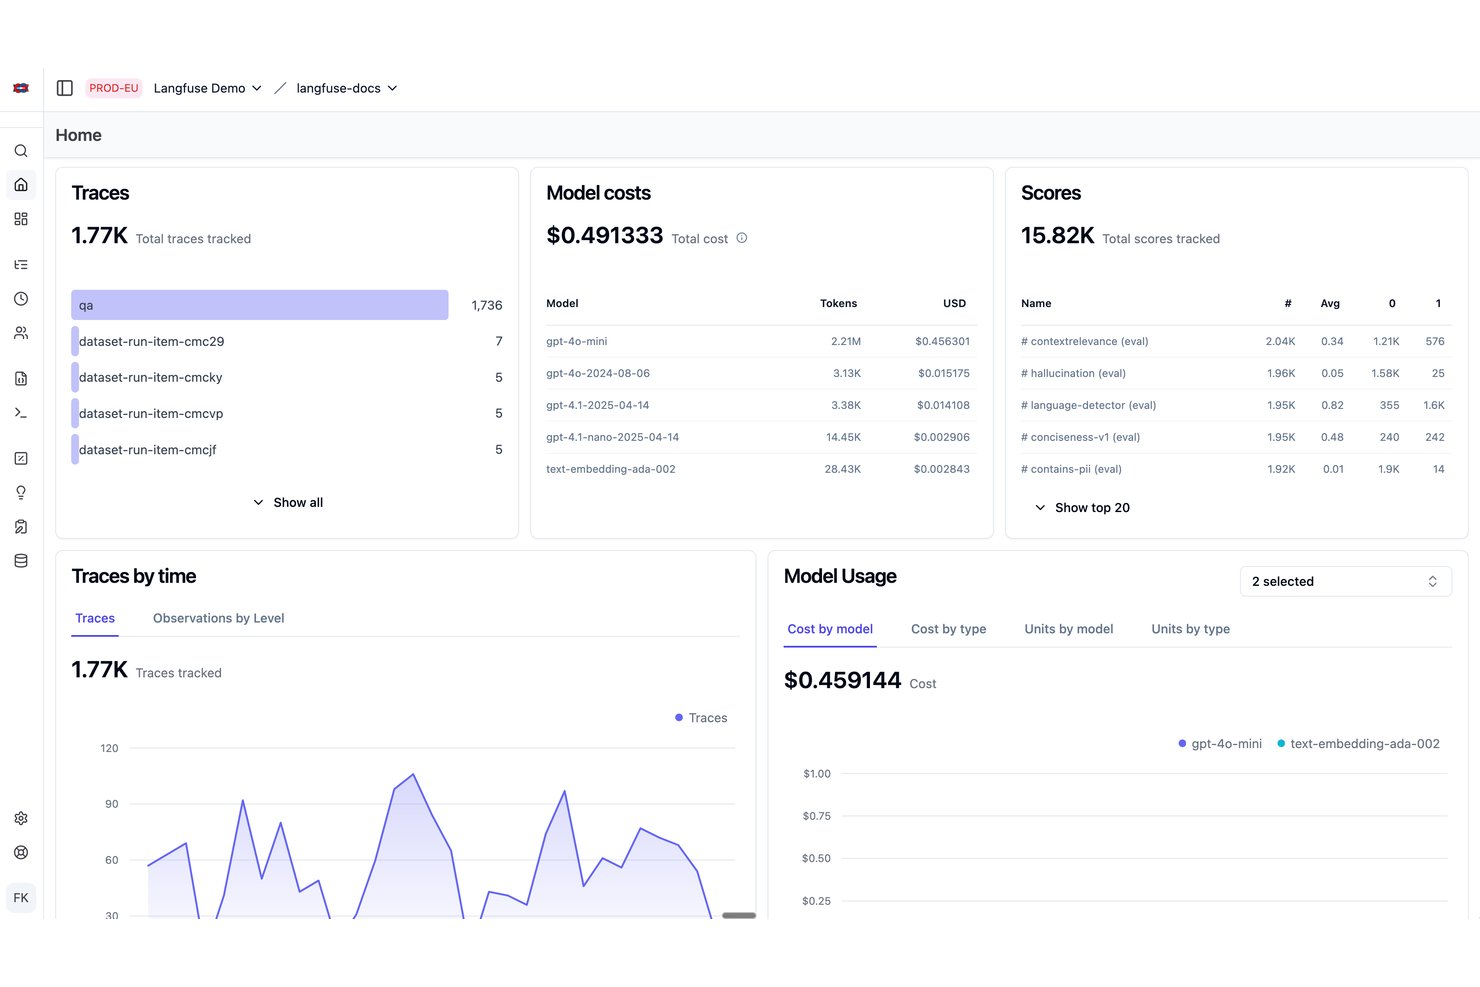
Langfuse is een opensourceplatform voor LLM-observeerbaarheid dat tracelogging, versiebeheer van prompts, evaluatie van uitvoer en datasetbeheer combineert voor AI-engineeringteams.
Voor wie is Langfuse het meest geschikt?
Langfuse is zeer geschikt voor ML/AI- en LLMOps-ingenieurs die één platform nodig hebben voor tracering, versiebeheer van prompts en evaluatie—vooral teams met vereisten voor gegevenslocatie, waardoor zelfhosting een prioriteit is.
Waarom ik voor Langfuse heb gekozen
Langfuse staat op mijn shortlist omdat het volledige tracelogging combineert met ingebouwd versiebeheer van prompts. Die combinatie heb ik in andere opensourcetools nog niet zo goed uitgevoerd gezien. Ik vind het vooral prettig dat je met promptlabels modellen of promptversies per omgeving kunt wisselen zonder je implementatiecode aan te passen. Bovendien koppelt Langfuse elke promptversie rechtstreeks aan de traces waarin deze is gebruikt, zodat je kosten, latentie en evaluatiescores van verschillende versies op één plek kunt vergelijken.
Belangrijkste functies van Langfuse
- Annotatiewachtrijen: Stuur uitvoer uit productie naar menselijke beoordelaars voor handmatige scoring en labeling, rechtstreeks binnen het platform.
- Sessie- en gebruikerstracking: Groepeer gesprekken met meerdere beurten in sessies en houd traces en kosten per individuele gebruiker bij.
- Datasetbeheer: Bouw gestructureerde testdatasets op basis van productietraces en voer experimenten uit om wijzigingen in prompts of modellen vóór release te vergelijken.
- Tracing op basis van OpenTelemetry: Verstuur tracedata met OpenTelemetry naast native Python- en JavaScript-SDK's, met ondersteuning voor meer dan 100 frameworkintegraties.
Integraties van Langfuse
Langfuse biedt meer dan 100 integraties, waaronder OpenAI Agents, LiteLLM, Koog, Cohere, Gemini, Ollama, Groq, Slack en Deepseek. Het ondersteunt ook Python- en JavaScript/TypeScript-SDK's, OpenTelemetry, webhooks en een openbare API.
Pros and Cons
Pros:
- Opensourcetracering ondersteunt zelfgehoste implementaties
- Promptversies worden rechtstreeks aan traces gekoppeld
- Datasetexperimenten koppelen feedback uit productie aan evaluatie
Cons:
- Voor zelfhosting zijn meerdere infrastructuurcomponenten vereist
- Waarschuwingsfuncties bieden geen anomaliedetectie en workflows voor incidenten
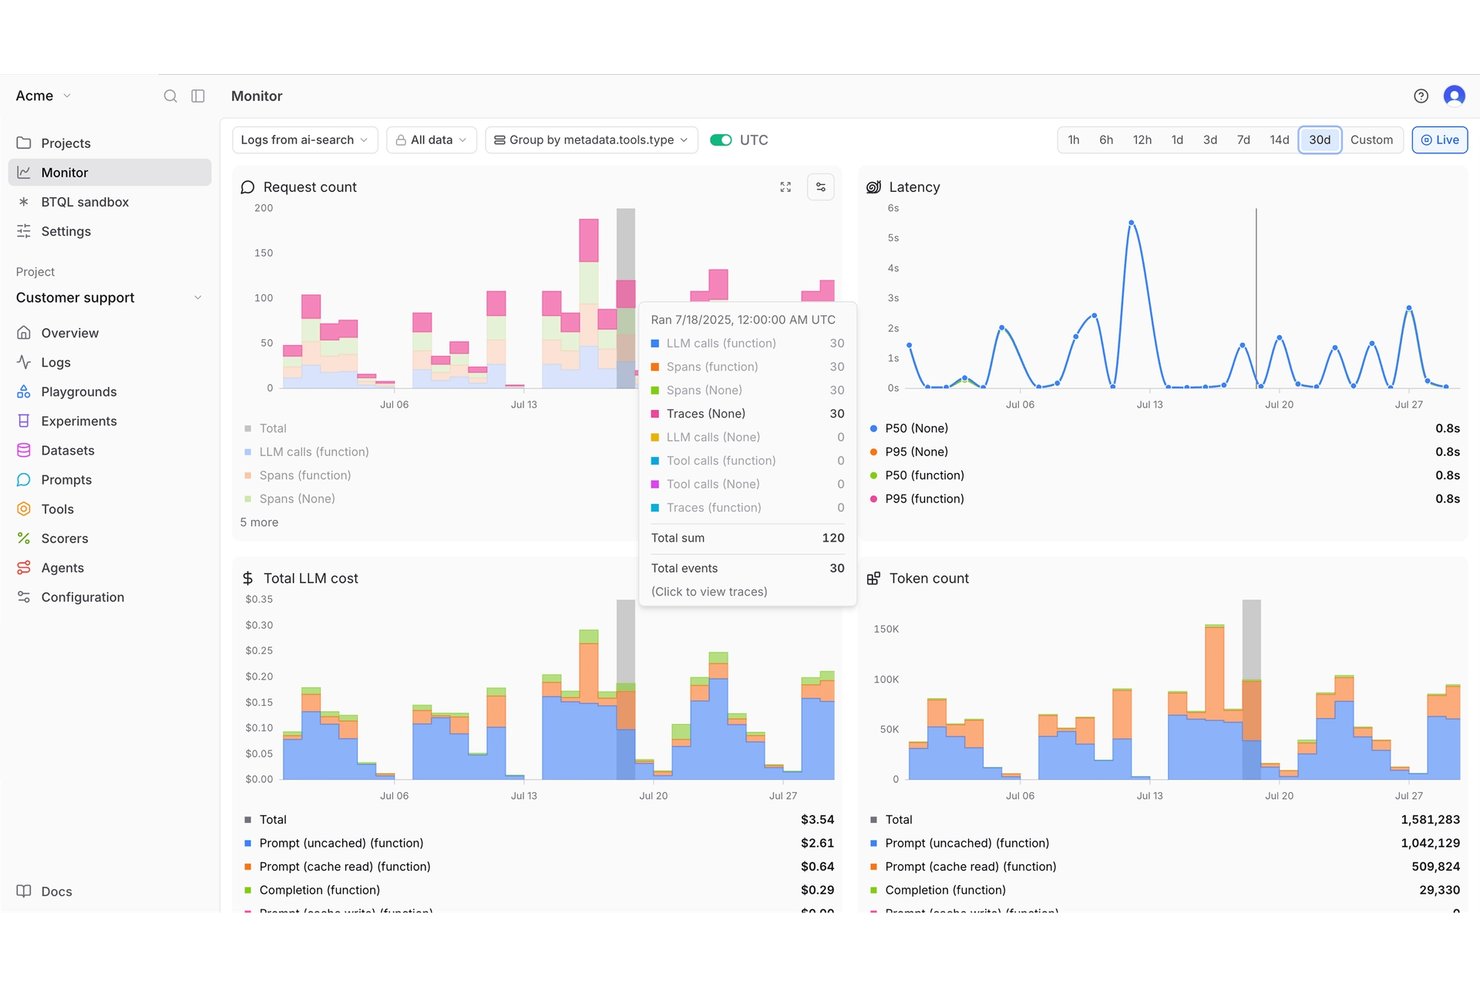
Braintrust is een observabilitytool voor LLM's die logging van productietraces, evaluatie van uitvoerkwaliteit, experimenten met prompts en geautomatiseerde scoring combineert in één omgeving.
Voor wie is Braintrust het meest geschikt?
Braintrust is zeer geschikt voor ML/AI- en LLMOps-engineers die de cyclus tussen productietracegegevens en evaluatieworkflows in één platform willen sluiten.
Waarom ik voor Braintrust heb gekozen
Braintrust staat op mijn shortlist omdat het de kloof tussen observability in productie en evaluatie in één doorlopende cyclus dicht. Ik vind het geweldig dat je met online productiescoring rechtstreeks LLM-als-beoordelaar- of codegebaseerde scorers kunt toepassen op live traces en vervolgens waarschuwingen kunt activeren wanneer scores onder een drempelwaarde zakken, zoals
scores voor feitelijkheid < 0.8
. Je kunt die gemarkeerde traces ook met één klik omzetten in versiebeheerde evaluatiedatasets, zodat je volgende experiment is gebaseerd op echte foutgevallen in plaats van synthetische data.
Belangrijkste functies van Braintrust
- Inname via OpenTelemetry: Accepteer traces via een OTLP-exporter, Braintrusts eigen spanprocessor of een OTel Collector, met automatische conversie van LLM-spans.
- Brainstore en Nitro-zoekfunctie: Doorzoek miljoenen tracelogboeken snel met de speciaal ontwikkelde AI-datastore en query-engine van Braintrust.
- Op SQL gebaseerde waarschuwingen: Definieer waarschuwingen voor logs, tijdvensters en omgevingen met SQL-filters, met doorsturing naar Slack of webhooks voor tools zoals PagerDuty en Opsgenie.
- Versiebeheer van prompts en datasets: Voorzie prompts en datasets van labels voor productie-, test- en ontwikkelomgevingen, met waarschuwingen wanneer toewijzingen aan omgevingen veranderen.
Integraties van Braintrust
Braintrust biedt meer dan 80 integraties, waaronder OpenAI, Anthropic, AgentScope, AWS Lambda, Agno, AWS Bedrock en Azure AI Foundry. Het biedt ook een MCP, webhooks, een API en Braintrust Gateway voor aangepaste verbindingen.
Pros and Cons
Pros:
- Productietraces worden omgezet in versiebeheerde evaluatiedatasets
- Beoordeling door een LLM en codegebaseerde beoordeling worden online uitgevoerd
- Nitro doorzoekt miljoenen lange tracelogboeken
Cons:
- Waarschuwingen bundelen meldingen in plaats van afzonderlijke gebeurtenissen
- Geen native detectie van PII of promptinjecties
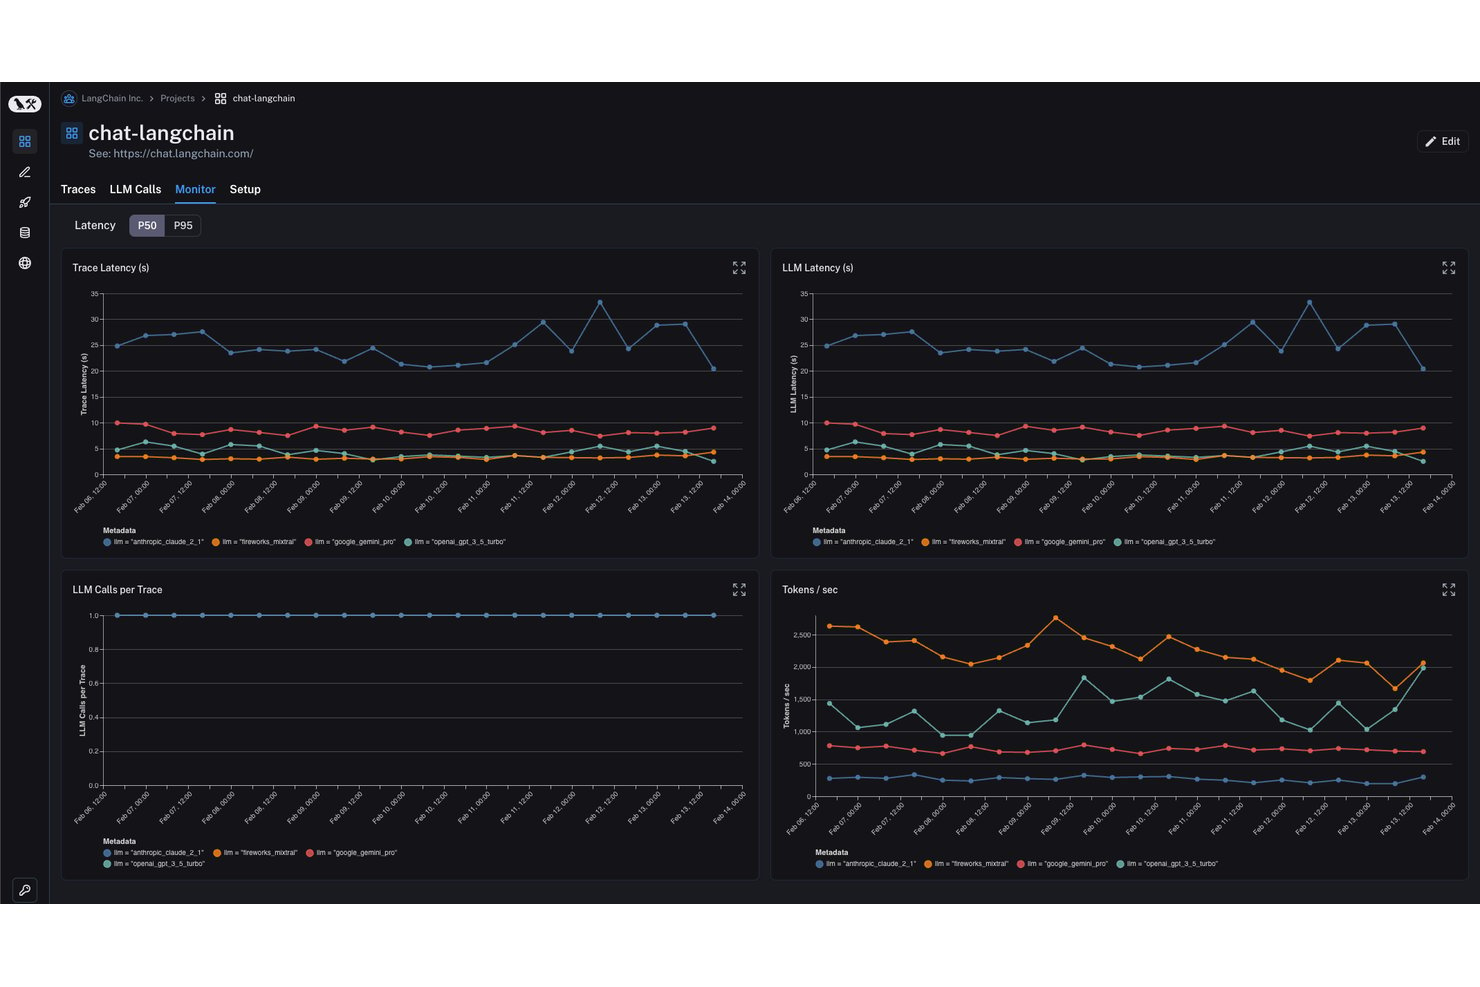
LangSmith is een observabilityplatform voor LLM's dat tracelogging, promptbeheer, outputevaluatie en realtime monitoringdashboards combineert in één tool, met native ondersteuning voor OpenTelemetry en SDK's voor Python, TypeScript, Go en Java.
Voor wie is LangSmith het meest geschikt?
LangSmith is zeer geschikt voor ML/AI- en LLMOps-ingenieurs die productieapplicaties met LangChain of LangGraph bouwen of opschalen.
Waarom ik voor LangSmith heb gekozen
LangSmith verdient een plek op mijn shortlist omdat de tracing specifiek is gebouwd voor LangChain- en LangGraph-workflows, waardoor het de meest natuurlijke keuze is als je al in dat ecosysteem werkt. Ik vind het geweldig dat de door SmithDB ondersteunde geneste traceweergaven je in staat stellen elke node van een LangGraph-agentuitvoering te doorlopen, terwijl zoeken in volledige tekst in minder dan een seconde resultaten uit miljoenen traces teruggeeft. Combineer dat met realtime dashboards die latency bij P50/P99, tokengebruik en kosten per uitvoering uitsplitsen, en je krijgt een duidelijk beeld van precies waar je pipeline problemen ondervindt.
Belangrijkste functies van LangSmith
- Pipeline voor outputevaluatie: Voer evaluaties door een LLM als beoordelaar of op basis van code rechtstreeks in productie uit, waarbij de resultaten automatisch naar je monitoringdashboards worden doorgestuurd.
- Annotatiewachtrijen: Stuur outputs naar menselijke beoordelaars voor labeling en het verzamelen van feedback, waarbij scores in je live monitoringweergaven zichtbaar worden.
- Configuratie van waarschuwingsdrempels: Stel aangepaste waarschuwingsdrempels in voor latency-, foutpercentage- en kostenstatistieken, met levering via webhook of PagerDuty.
- Flexibele implementatieopties: Gebruik LangSmith in de beheerde cloud (VS of EU), in je eigen cloud, hybride of volledig zelf gehost op Kubernetes in AWS, GCP of Azure.
Integraties van LangSmith
LangSmith integreert met OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry en TypeScript. De REST API is ook beschikbaar voor aangepaste verbindingen.
Pros and Cons
Pros:
- Tracing met LangChain en LangGraph voelt native aan
- Menselijke annotaties leveren feedbackscores voor monitoring
- P50/P99-dashboards maken latency en kosten inzichtelijk
Cons:
- Basistraces verlopen na veertien dagen
- Geen ingebouwde detectie van promptinjecties
Andere tools voor LLM-observeerbaarheid
Hier zijn enkele aanvullende platforms die mijn shortlist niet hebben gehaald, maar die toch het bekijken waard zijn:
- HoneyHive
Het beste voor observeerbaarheid van agenten in grote ondernemingen op schaal
- Confident AI
E voor door evaluaties afgedwongen prompt-samenvoegingen in CI/CD
- New Relic
Ideaal voor monitoring van LLM's en infrastructuur, ingebouwd in APM
- Portkey
Het meest geschikt voor gateway-native LLMOps met VPC-hosting
- Evidently AI
Het beste voor controles op hallucinaties en afwijkingen
- LangWatch
Ideaal voor simulatie en tracering van agents met meerdere beurten
- Helicone
Het beste voor het bijhouden van kosten en tokens via een AI-gateway
- TruLens
Het beste voor diepgang bij de evaluatie van RAG en agents
- Lunary
Het meest geschikt voor het traceren van zelfgehoste LLM's met SOC 2-compliance


Hoe ik hulpmiddelen voor LLM-observeerbaarheid beoordeel
Ik splits mijn beoordeling op in basiscriteria waaraan elk hulpmiddel moet voldoen—zoals trace-logging en evaluatie van uitvoerkwaliteit—en onderscheidende factoren die de beste hulpmiddelen van de rest scheiden.
Kernfunctionaliteit (basisvereisten voor deze lijst)
Bij het selecteren van hulpmiddelen voor mijn lijst beoordeel ik elk hulpmiddel op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder genoemde kernfunctionaliteit. Vervolgens bereken ik de totaalscore van het hulpmiddel als percentage en gebruik ik die om de algehele geschiktheid voor de lijst te beoordelen.
- Trace-logging en visualisatie: Ik controleer of het hulpmiddel geneste traces met meerdere stappen kan weergeven voor agentaanroepen, RAG-retrievals en het gebruik van hulpmiddelen—niet alleen platte aanvraaglogboeken.
- Evaluatie van uitvoerkwaliteit: Ik zoek naar ingebouwde scoring, aangepaste evaluatoren en opties voor menselijke beoordeling die hallucinaties of dalingen in relevantie in uitvoer uit productie opsporen.
- Versiebeheer van prompts en modellen: Elk hulpmiddel moet wijzigingen in prompts of modellen kunnen koppelen aan veranderingen in latentie, kosten of kwaliteit, zodat je precies kunt vaststellen wat een regressie heeft veroorzaakt.
- Realtime waarschuwingen en monitoring: Ik beoordeel of het platform anomalieën in live verkeer zichtbaar maakt en waarschuwingen zonder handmatige polling doorstuurt naar hulpmiddelen zoals Slack of PagerDuty.
- Kosten- en tokenregistratie: Gedetailleerde uitsplitsingen per aanroep, model of project zijn hierbij belangrijk—alleen geaggregeerde tellingen van tokenverbruik zijn niet voldoende om de uitgaven voor meerdere teams te beheren.
- Beheer van datasets en feedback: Ik zoek naar de mogelijkheid om testsets samen te stellen uit productietraces en feedback van gebruikers terug te voeren naar evaluatielussen voor voortdurende verbetering.
Nadat ik een lijst heb samengesteld met hulpmiddelen die aan de criteria voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (waarmee leveranciers zich onderscheiden)
Zo vergelijk ik verschillende leveranciers:
Opvallende functies
Ik zoek naar beveiligingsmaatregelen en veiligheidsdetectie die promptinjectie, het lekken van persoonlijk identificeerbare informatie en toxische inhoud in realtime signaleren—vooral wanneer een team klantgerichte agents gebruikt waarbij één jailbreak al aanzienlijke schade kan veroorzaken. Opties voor zelfgehoste en on-premises implementatie zijn net zo belangrijk, aangezien teams in gereguleerde sectoren volledige controle nodig hebben over waar prompts en aanvullingen worden opgeslagen. Ik beoordeel ook de mogelijkheden voor een prompt-speeltuin en het vergelijken van verschillen, waarbij ik controleer of je promptversies naast elkaar kunt vergelijken met live uitvoer voordat je wijzigingen naar productie pusht.
Meer dan functies alleen
Ik controleer of een hulpmiddel in een VPC of on-premises omgeving kan draaien, aangezien teams die met gezondheids- of financiële gegevens werken prompts vaak niet naar een gedeelde cloud kunnen sturen. Het prijsmodel is net zo belangrijk—gebruikgebaseerde facturering die aan het aantal traces is gekoppeld, kan snel oplopen zodra je de prototypingfase voorbij bent. Daarom zoek ik naar transparante prijsniveaus of opensourceopties waarmee je de kosten kunt voorspellen voordat je je vastlegt. Ik beoordeel ook hoe goed elk platform in bestaande stacks past, waarbij ik kijk naar native SDK-ondersteuning voor Python en JS en vooraf gebouwde connectors voor frameworks zoals LangChain of LlamaIndex.
Zo kies je de juiste tool voor LLM-observeerbaarheid
Vergelijk de belangrijkste mogelijkheden hieronder om de juiste tool te vinden die aansluit bij je prioriteiten.
| Als je prioriteit is | Zoek dan naar |
|---|---|
| Fouten van agents reconstrueren | Exporteerbare geneste traceringen met gebeurtenissen voor ophalen, tools en modellen |
| De kwaliteit van uitvoer aantonen | Reproduceerbare evaluatieregisters met beoordelingscriteria en opmerkingen van beoordelaars |
| Wijzigingen in prompts beheersen | Versiegeschiedenis die prompts, modellen, uitvoer en evaluatieresultaten aan elkaar koppelt |
| Operationele risico's beheren | Schriftelijke voorwaarden voor bewaartermijnen, toegangsbeheer, verwijdering en implementatie |
| Uitgaven voorspellen | Records per aanvraag met tokens, modellen en toepasselijke gebruikseenheden |
Zo beoordeel je je shortlist
- Voer een gedefinieerde proefopdracht uit: Stuur één agentworkflow met meerdere stappen, inclusief een ophaalaanroep en een fout in een tool, en controleer vervolgens binnen 30 minuten de geëxporteerde tracering.
- Vraag om een evaluatie-artefact: Vraag om een voorbeeldrapport met beoordelingscriteria, scoreberekeningen, annotaties door mensen en de bronstracering voor 10 uitvoerresultaten.
- Dien een supportticket in: Dien een reproduceerbare vraag over tracering in en verlang binnen vijf werkdagen een schriftelijk antwoord, een verantwoordelijke voor escalatie en een streefdatum voor de oplossing.
- Vraag om contractuele bepalingen: Vraag om schriftelijke clausules over gegevensbewaring, de termijn voor verwijdering, toegang door subverwerkers en de vraag of prompts worden gebruikt om modellen van de leverancier te trainen.
- Kies je compromis: Kies voor controle met open source en zelfhosting boven het gemak van een beheerde oplossing, of accepteer door de leverancier beheerde infrastructuur voor minder operationele verantwoordelijkheid.
Wat zijn tools voor LLM-observeerbaarheid?
LLM-observeerbaarheidstools zijn platforms die toepassingen van grote taalmodellen traceren, monitoren en evalueren. Ze leggen prompts, antwoorden, modelaanroepen, ophaalstappen, toolgebruik, latentie, tokens, kosten en fouten vast in workflows met meerdere stappen. Teams gebruiken deze gegevens om fouten te onderzoeken, de uitvoerkwaliteit te meten, problemen in productie te detecteren en wijzigingen in prompts of modellen te koppelen aan operationele resultaten.
Functies van LLM-observeerbaarheidstools
Houd bij het evalueren van verschillende platforms de volgende belangrijke functies in de gaten:
- Logboekregistratie en visualisatie van traces: Legt geneste gebeurtenissen vast voor modelaanroepen, ophaalstappen, prompts, tools en applicatielogica. Visuele tijdlijnen helpen je fouten te lokaliseren en te begrijpen hoe elke stap het uiteindelijke antwoord heeft beïnvloed.
- Evaluatie van uitvoerkwaliteit: Past vooraf gedefinieerde of aangepaste beoordelingscriteria toe op gegenereerde antwoorden. Teams kunnen nauwkeurigheid, relevantie, veiligheid en andere kwaliteitsmaatstaven beoordelen aan de hand van testdatasets en productievoorbeelden.
- Versiebeheer van prompts en modellen: Slaat promptsjablonen, modelconfiguraties en wijzigingsgeschiedenissen gezamenlijk op. Hierdoor kun je versies vergelijken en vaststellen of een wijziging invloed had op kwaliteit, latentie, fouten of gebruikskosten.
- Realtime monitoring en waarschuwingen: Volgt livegedrag van applicaties en signaleert problemen zoals stijgende foutpercentages, pieken in latentie of ongebruikelijk gebruik. Routering van waarschuwingen kan meldingen sturen naar tools voor incidentrespons en samenwerking.
- Registratie van tokens en kosten: Legt invoertokens, uitvoertokens, modelgebruik en bijbehorende kosten vast voor afzonderlijke verzoeken. Filters op project, omgeving, gebruiker of model helpen teams uitgavenpatronen te onderzoeken.
- Beheer van datasets en feedback: Zet geselecteerde productietraces om in evaluatiedatasets en slaat feedback van beoordelaars bij elk voorbeeld op. Zo ontstaat een herhaalbaar overzicht voor het testen van wijzigingen en het volgen van kwaliteit in de loop van de tijd.
- Zoeken en filteren: Hiermee kun je traces vinden op aanvraag-ID, gebruiker, model, promptversie, status, latentie, tags of metagegevens. Gedetailleerde filters verkorten de tijd die nodig is om een specifiek incident te isoleren.
- Beheer van gegevenstoegang en bewaartermijnen: Bepaalt wie prompts en antwoorden mag bekijken, exporteren, verwijderen of bewaren. Deze toegangscontroles helpen teams interne beveiligingsbeleidsregels toe te passen en gevoelige productierecords te beheren.
- Ondersteuning voor integraties: Maakt verbinding met applicatieframeworks, taal-SDK's, telemetriestandaarden en samenwerkingssystemen. Dankzij brede integratieondersteuning kunnen teams observeerbaarheid toevoegen zonder bestaande workflows opnieuw op te bouwen.
Veelvoorkomende AI-functies van LLM-observeerbaarheidstools
Naast de hierboven genoemde standaardfuncties van LLM-observeerbaarheidstools bevatten veel oplossingen AI-functies zoals:
- Zoeken in traces in natuurlijke taal: Hiermee kun je tracegegevens opvragen in alledaagse taal, zonder filters of databasequery's te schrijven. AI interpreteert je verzoek en retourneert relevante aanvragen, fouten, gebruikers of workflowstappen.
- Geautomatiseerde analyse van de hoofdoorzaak: Onderzoekt gerelateerde gebeurtenissen in modelaanroepen, ophaalstappen, tools en applicatiefouten. De analyse identificeert waarschijnlijke oorzaken, zoals een mislukte ophaalaanroep, een gewijzigde prompt of de responstijd en het patroon van een modelantwoord.
- Door AI gegenereerde samenvattingen van traces: Het platform zet lange traces met meerdere stappen om in korte uitleg over wat er is gebeurd. Deze samenvattingen helpen support- en infrastructuurteams incidenten te beoordelen zonder elke gebeurtenis handmatig te lezen.
- Semantische clustering: Groepeert traces op basis van betekenis in plaats van uitsluitend op tags, statuscodes of exacte tekstovereenkomsten. Teams kunnen deze clusters gebruiken om terugkerende typen aanvragen, foutpatronen of onverwachte vragen van gebruikers te vinden.
- Detectie van promptinjecties: Analyseert invoer van gebruikers en modelinteracties op instructies die systeem-prompts proberen te overschrijven of het gedrag van agents proberen te manipuleren. De detectieresultaten kunnen onderzoek, blokkeringsregels en beveiligingsbeoordelingen ondersteunen.
- Detectie van gevoelige gegevens: Identificeert persoonlijke, financiële, gezondheids- of vertrouwelijke informatie in prompts en antwoorden. Teams kunnen de bevindingen gebruiken om records te anonimiseren, beleidsschendingen te beoordelen en blootstelling in opgeslagen traces te beperken.
Voordelen van LLM-observeerbaarheidstools
Een LLM-observeerbaarheidsplatform biedt verschillende voordelen voor je team en je bedrijf. Hier zijn enkele voordelen waar je naar kunt uitkijken:
- Sneller onderzoek naar incidenten: Geneste traceringen verbinden prompts, modelaanroepen, ophaalstappen, tools, latentie en fouten in één tijdlijn.
- Hogere uitvoerkwaliteit: Ingebouwde evaluatoren, aangepaste beoordelingscriteria, datasets en menselijke beoordelingen helpen hallucinaties, relevantieproblemen en veiligheidsproblemen te identificeren.
- Veiligere productieworkflows: Detectie van promptinjecties en gevoelige gegevens kan risicovolle invoer, antwoorden en interacties met agents markeren voor beoordeling.
- Duidelijkere impact van wijzigingen: Geschiedenissen van prompt- en modelversies koppelen configuratiewijzigingen aan veranderingen in kwaliteit, latentie, fouten en tokengebruik.
- Meer gecontroleerde uitgaven: Token- en kostenregistraties per aanvraag laten zien hoe het gebruik varieert per model, project, omgeving of gebruiker.
- Betere operationele respons: Realtime monitoring, doorzoekbare traceringen en waarschuwingen helpen teams anomalieën te detecteren en incidenten naar responskanalen te routeren.
Kosten en prijzen van LLM-observeerbaarheidstools
Voor het selecteren van de juiste tool is inzicht nodig in de beschikbare prijsmodellen en abonnementen. De kosten variëren op basis van functies, teamgrootte, add-ons en gebruiksvolume. De onderstaande tabel vat veelvoorkomende abonnementen, gemiddelde prijzen en typische inbegrepen functies van LLM-observeerbaarheidssoftware samen.
Vergelijkingstabel van abonnementen voor LLM-observeerbaarheidstools
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| Gratis abonnement | $0/maand | Basisregistratie van traceringen, beperkte bewaartermijn, communityondersteuning en gebruikslimieten. |
| Persoonlijk abonnement | $10-$50/gebruiker/maand | Visualisatie van traceringen, bijhouden van tokens, monitoring van prompts, datasetbeheer en ondersteuning per e-mail. |
| Zakelijk abonnement | $100-$500/maand | Geavanceerde evaluaties, realtime waarschuwingen, teamrechten, integraties en uitgebreide gegevensbewaring. |
| Bedrijfsabonnement | $500-$5,000/maand | Aangepaste gebruikslimieten, eenmalige aanmelding, auditlogboeken, opties voor private implementatie, toegewijde ondersteuning en op contract gebaseerde controles voor gegevensbewaring. |
Veelgestelde vragen over LLM-observeerbaarheidstools
Hier vindt u antwoorden op enkele veelgestelde vragen over LLM-observeerbaarheidstools:
Vervangen LLM-observeerbaarheidstools traditionele applicatiemonitoring?
Nee, observeerbaarheidstools vullen traditionele applicatiemonitoring aan door prompts, antwoorden, modelinstellingen, ophaalstappen en evaluatorscores vast te leggen. Verbind beide systemen bij het onderzoeken van productie-incidenten. Een LLM-tracering kan bijvoorbeeld een verkeerd geformuleerde ophaalquery aan het licht brengen, terwijl applicatielogboeken de daaropvolgende time-out van de database tonen. Samen helpen deze inzichten om modelgedrag te onderscheiden van problemen met de applicatie of infrastructuur.
Kunnen LLM-observeerbaarheidstools omgaan met gevoelige productiegegevens?
Ja, sommige LLM-observeerbaarheidstools ondersteunen controles voor gevoelige productiegegevens. Controleer vóór implementatie de bewaartermijnen, verwijderingsworkflows, versleutelingsdetails, toegangsrechten en exportcontroles. Vraag of de leverancier prompts of antwoorden gebruikt om zijn modellen te trainen. Controleer ook de toegang van subprocessors en de beschikbare implementatiemodellen. Een zelfgehoste of private implementatie kan beperken waar traceringgegevens naartoe gaan. Stuur tijdens de evaluatie geredigeerde testrecords en controleer hoe maskering wordt weergegeven in opgeslagen traceringen, exports en evaluatorresultaten.
Moet u kiezen voor een open-source of een beheerde LLM-observeerbaarheidstool?
Kies open-sourcesoftware wanneer controle over de implementatie, toegang tot de broncode en voorspelbaar eigendom van de infrastructuur het belangrijkst zijn. Kies een beheerd platform wanneer uw team behoefte heeft aan door de leverancier gehoste opslag, updates en ondersteuning. Vergelijk meer dan alleen de abonnementsprijs. Neem ook de engineeringtijd voor implementatie, updates, toegangscontroles, back-ups en bewaarbeleid mee. Test vervolgens dezelfde workflow in beide opties. Bekijk de details van traceringen, de configuratie van evaluatoren, de aflevering van waarschuwingen en de exportindelingen. De betere keuze sluit aan bij uw beveiligingsvereisten en beschikbare operationele capaciteit.
Hoe test u een LLM-observeerbaarheidstool voordat u deze aanschaft?
Test met een workflow met meerdere stappen, inclusief het ophalen van gegevens, toolaanroepen en fouten. Controleer of de tracering de volgorde van gebeurtenissen, invoer, uitvoer, latentie, tokens en foutdetails bewaart. Bekijk vervolgens de evaluatorscores en het bijhouden van promptversies. Exporteer ten slotte records en controleer veldnamen, tijdstempels en het gedrag van redactie. Deze proef brengt tekortkomingen aan het licht die productdemonstraties vaak verbergen.