

10 beste tools voor het implementeren van ML-modellen in 2026
Overzicht van de beste tools voor de implementatie van ML-modellen


Met tools voor de implementatie van ML-modellen kun je getrainde machinelearningmodellen omzetten in productierijpe services die je daadwerkelijk kunt gebruiken. Als je zoekt naar manieren om je AI-aangedreven apps betrouwbaar te lanceren, te monitoren en te beheren, is het belangrijk om het juiste implementatieplatform te kiezen. Beveiliging, schaalbaarheid, automatisering en transparantie kunnen je workflow maken of breken.
In deze lijst bespreek ik de tools voor de implementatie van ML-modellen die ik het meest vertrouw en laat ik precies zien waar elk ervan in je stack past, zodat je het platform kunt kiezen dat aansluit bij de behoeften van je project en de verwachtingen van je team.
Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Samenvatting van de beste tools voor de implementatie van ML-modellen
Deze vergelijkingsgrafiek vat de prijsgegevens samen van mijn belangrijkste keuzes voor tools voor de implementatie van ML-modellen, zodat je de beste optie voor je budget en zakelijke behoeften kunt vinden.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Beste voor Kubernetes-native modelorkestratie | Gratis abonnement beschikbaar | Gratis te gebruiken | Website | |
| 2 | Het beste voor gestandaardiseerde inferentie-API's op Kubernetes | Gratis abonnement beschikbaar | Gratis te gebruiken | Website | |
| 3 | Het meest geschikt voor het verpakken van modellen als productie-API's | Gratis abonnement + gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 4 | Het beste voor het hosten van transformatormodellen op schaal | Gratis abonnement + gratis demo beschikbaar | Vanaf $9/maand | Website | |
| 5 | Het beste voor het implementeren van serverloze Python-functies | Gratis abonnement beschikbaar | Vanaf $250 + rekenkracht/maand | Website | |
| 6 | Het beste voor geautomatiseerd beheer van modellen van begin tot eind | Gratis abonnement beschikbaar | Vanaf $0.204/uur | Website | |
| 7 | Het meest geschikt voor geïntegreerde data- en AI-werkstromen | Gratis abonnement beschikbaar | Vanaf $0.085/uur | Website | |
| 8 | Het meest geschikt voor het bouwen van aangepaste webinterfaces voor modellen | Gratis abonnement beschikbaar | Prijzen op aanvraag | Website | |
| 9 | Het beste voor gedistribueerde modelservering met Python en Ray | Gratis tegoed van $100 beschikbaar | Prijs op aanvraag | Website | |
| 10 | Beste voor het beheren van modellen in gereguleerde sectoren | Not available | Prijzen op aanvraag | Website |
Beoordelingen van de beste tools voor de implementatie van ML-modellen
Hieronder staan mijn gedetailleerde samenvattingen van de beste tools voor de implementatie van ML-modellen die op mijn shortlist terecht zijn gekomen. Mijn beoordelingen bieden een gedetailleerd overzicht van de functies, integraties en beste gebruiksscenario’s van elk platform, zodat je de beste optie voor jou kunt vinden.

Kubeflow is een open-source ML-platform gebouwd op Kubernetes dat orkestratie van pipelines, modeltraining, hyperparameterafstemming en het beschikbaar stellen van modellen met meerdere frameworks omvat voor cloud- en on-premisesinfrastructuur.
Voor wie is Kubeflow het meest geschikt?
Kubeflow is zeer geschikt voor ML-engineeringteams die al Kubernetes gebruiken en grootschalige trainingstaken en het beschikbaar stellen van productiemodellen op hun eigen infrastructuur moeten beheren.
Waarom ik voor Kubeflow heb gekozen
Ik heb Kubeflow gekozen als een van de beste opties omdat het speciaal rond Kubernetes is gebouwd, wat betekent dat elk onderdeel als een native Kubernetes-workload wordt uitgevoerd. Ik vind het prettig dat Kubeflow Pipelines me in staat stelt end-to-end ML-workflows als gecontaineriseerde DAG's te definiëren, zodat elke stap onafhankelijk kan schalen. Kubeflow Trainer verzorgt gedistribueerde training met PyTorch, JAX en DeepSpeed zonder aangepaste clusterconfiguratie. Ik kan Katib ook gebruiken om geautomatiseerde hyperparametersweeps rechtstreeks uit te voeren op actieve trainingstaken binnen hetzelfde cluster.
Belangrijkste functies van Kubeflow
- KServe: Implementeer getrainde modellen als schaalbare inferentieservices op Kubernetes met vooraf gebouwde uitvoeringsomgevingen voor TensorFlow, PyTorch en scikit-learn.
- Modellenregister: Sla geregistreerde modellen op, beheer versies en houd ze bij in verschillende trainingsruns voordat je ze naar omgevingen voor het beschikbaar stellen van modellen promoveert.
- Notebookservers: Start Jupyter-notebookinstanties rechtstreeks op het cluster met configureerbare toewijzingen van CPU, GPU en geheugen.
- Isolatie van meerdere gebruikers: Beheer afzonderlijke namespaces en toegangscontroles voor verschillende teams of projecten binnen een gedeeld cluster.
Integraties van Kubeflow
Kubeflow biedt geen traditionele native integraties; in plaats daarvan werkt het binnen het Kubernetes-ecosysteem en ondersteunt het ML-frameworks zoals TensorFlow, PyTorch, JAX, XGBoost, HuggingFace en Apache Spark via de operators van zijn deelprojecten. Je kunt het ook implementeren op beheerde Kubernetes-services van AWS, Google Cloud, Microsoft Azure en Red Hat OpenShift.
Pros and Cons
Pros:
- Kan worden geïmplementeerd bij alle grote cloudproviders met Kubernetes
- Elke pipeline-stap wordt uitgevoerd in een geïsoleerde container
- Scoort hoog op het gebied van gedistribueerde training en orkestratie
Cons:
- De complexe eerste configuratie vereist expertise in Kubernetes
- Vereist een toegewijd platformteam voor het onderhoud


KServe is een open-source, Kubernetes-native platform voor modelinferentie dat modelbediening voor meerdere softwareframeworks, canary-uitrol, automatische schaling en uitlegbaarheid van modellen afhandelt via een gestandaardiseerde inferentie-API-laag.
Voor wie is KServe het meest geschikt?
KServe is zeer geschikt voor ML-engineeringteams bij middelgrote tot grote organisaties die modellen op schaal op Kubernetes bedienen en een frameworkonafhankelijke inferentielaag nodig hebben.
Waarom ik voor KServe heb gekozen
Ik heb KServe gekozen als een van de beste opties, omdat het is opgebouwd rond het Open Inference Protocol (V2), een gestandaardiseerde API-specificatie waarmee mijn team backends voor modelbediening, zoals Triton of vLLM, kan verwisselen zonder clientcode te herschrijven. Ik vertrouw ook op de InferenceService CRD om canary-uitrollen declaratief te definiëren, waarbij een percentage van het live verkeer naar een nieuwe modelversie wordt geleid voordat deze volledig wordt uitgerold. Zowel REST- als gRPC-inferentie-eindpunten worden ondersteund, dus ik ben niet gebonden aan één transportlaag.
Belangrijkste functies van KServe
- Automatische schaling naar nul: Door Knative aangedreven automatische schaling schaalt inferentiepods terug naar nul wanneer ze inactief zijn en weer omhoog wanneer dat nodig is.
- Verzoek-/antwoordtransformators: Voor- en nabewerkingslogica wordt uitgevoerd in een afzonderlijke transformercontainer naast de modelserver.
- Canary-uitrollen: Verplaatst geleidelijk verkeer naar een nieuwe modelversie, zodat je wijzigingen in productie kunt testen zonder volledige blootstelling.
- Payloadlogboekregistratie: Inferentieverzoeken en -reacties worden geregistreerd in configureerbare doelopslagplaatsen voor audittrails en modelmonitoring.
Integraties van KServe
KServe bevat native integraties met Knative, Istio en de Kubernetes Gateway API voor serverloze schaling en ingress-routering. Het wordt geleverd met ingebouwde runtimes voor modelbediening van vLLM, llm-d, NVIDIA Triton Inference Server, Seldon MLServer, TorchServe en Hugging Face, en ondersteunt modelopslag vanuit Amazon S3, Google Cloud Storage en Azure Blob Storage. Er zijn een Python-SDK voor modelbediening en REST-/gRPC-inferentie-API's beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Automatische schaling naar nul verlaagt de kosten van inactieve GPU's
- Frameworkonafhankelijke serving via een gestandaardiseerd inferentieprotocol
- Ingebouwde canary-uitrollen voor veilige updates
Cons:
- Vereist expertise in het beheer van Kubernetes-clusters
- De serverless-modus beperkt de aanpassing van volumekoppelingen

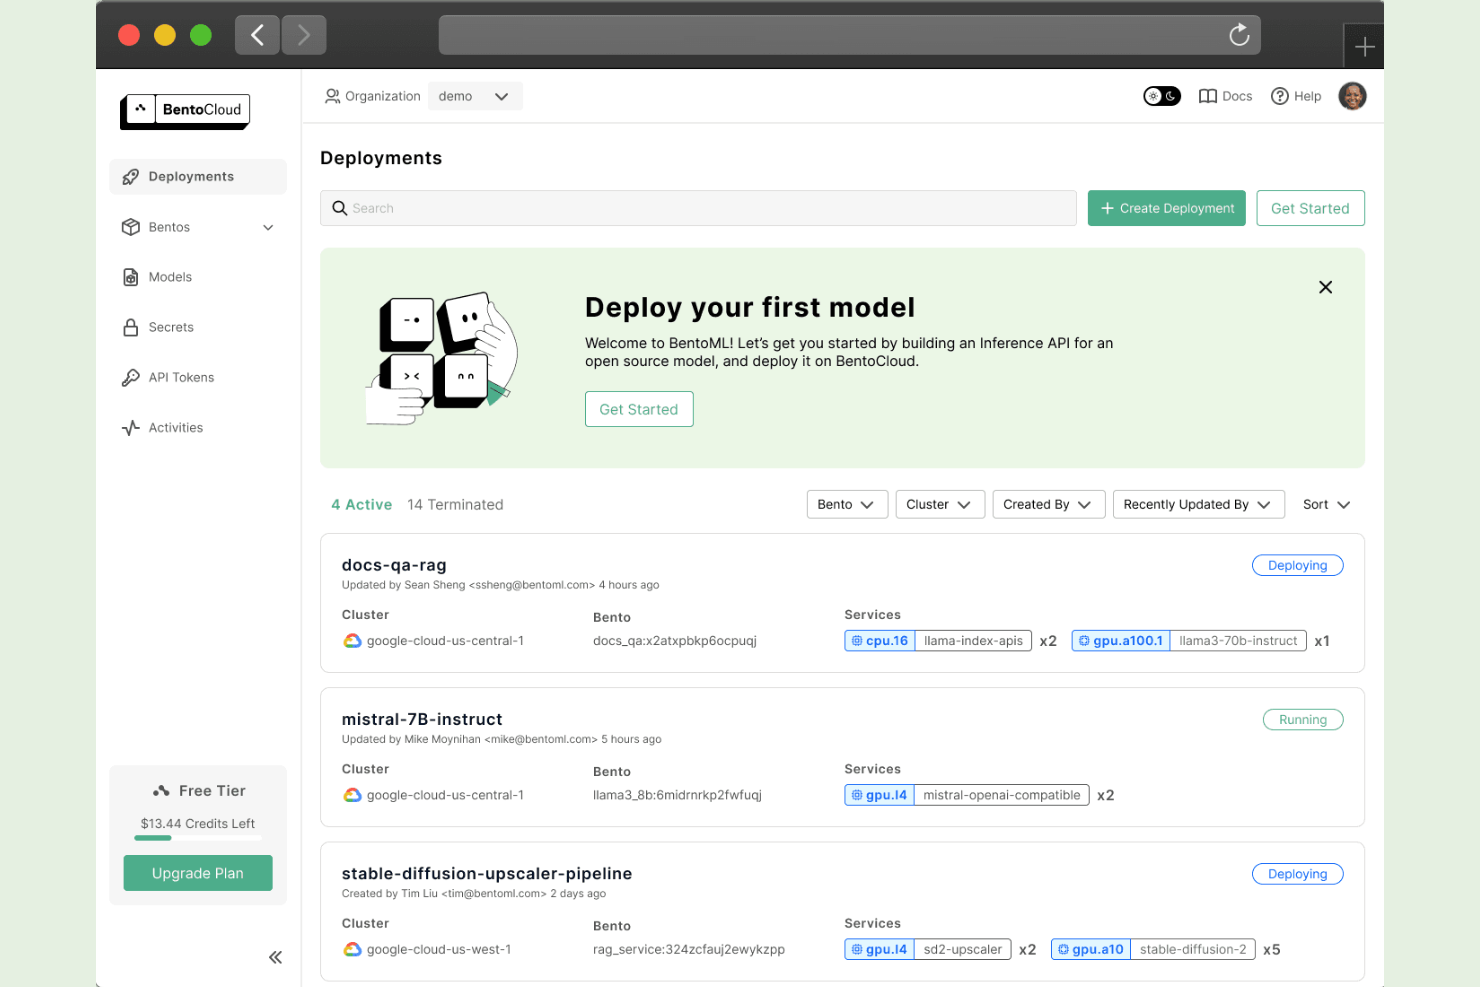
Gebaseerd op het concept van een 'Bento'-artefact, is BentoML een Python-native raamwerk voor modelbediening dat de servicedefinitie, containerisatie en het verpakken van modellen uit meerdere frameworks voor implementatie in productie afhandelt.
Voor wie is BentoML het meest geschikt?
BentoML is zeer geschikt voor ML-teams bij bedrijven in de groeifase die snel van een getraind model naar een productieklare API moeten gaan zonder een speciaal MLOps-platform.
Waarom ik BentoML heb gekozen
Ik heb BentoML opgenomen in mijn beste keuzes omdat het een van de weinige raamwerken is die het modelartefact en de laag voor modelbediening behandelt als één versie-eenheid. Ik vind het prettig dat BentoML automatisch zowel REST- als gRPC-eindpunten genereert vanuit dezelfde servicedefinitie, zodat mijn team geen afzonderlijke API-specificaties hoeft te onderhouden. Dankzij de abstractie voor uitvoerders kan ik elk model ook in een eigen proces isoleren, wat betekent dat een CPU-gebaseerde voorbewerkingsstap niet hoeft te concurreren om resources met een GPU-modeluitvoerder.
Belangrijkste functies van BentoML
- Adaptieve batchverwerking: Groepeert gelijktijdige inferentieverzoeken automatisch in één batch, waardoor de GPU-overhead per verzoek wordt verlaagd zonder codewijzigingen.
- Ingebouwde Prometheus-metrieken: Stelt standaard een /metrics-eindpunt beschikbaar, zodat je de latentie en doorvoer van verzoeken kunt monitoren zonder aangepaste instrumentatie.
- LLM-gateway: Biedt een uniforme API-interface voor meerdere LLM-providers, zodat je gecentraliseerde controle hebt over routering en kosten.
- Bouwen van een containerimage: Genereert rechtstreeks vanuit een Bento-artefact een productieklare Docker-image met één CLI-opdracht.
BentoML-integraties
BentoML biedt gedocumenteerde integraties met tools uit het MLOps-ecosysteem, waaronder Airflow, MLflow, Ray, Spark, Arize AI, Flink en Triton Inference Server. Het integreert ook met Datadog voor het verzamelen van metrieken van BentoML-services. Er is een API beschikbaar voor aangepaste integraties en de gecontaineriseerde uitvoer van BentoML werkt standaard met Kubernetes en Docker voor flexibele implementatie.
Pros and Cons
Pros:
- Ingebouwde versiebeheer en registratie van terugdraaiingen van modellen
- Genereert Docker-containers vanuit een YAML-configuratie
- Verwerkt gelijktijdige verzoeken via schaling van werkprocessen
Cons:
- Configuratiebestanden kunnen onnodig complex aanvoelen
- Aangepaste modelladers vereisen extra configuratie

Het beste voor het hosten van transformatormodellen op schaal
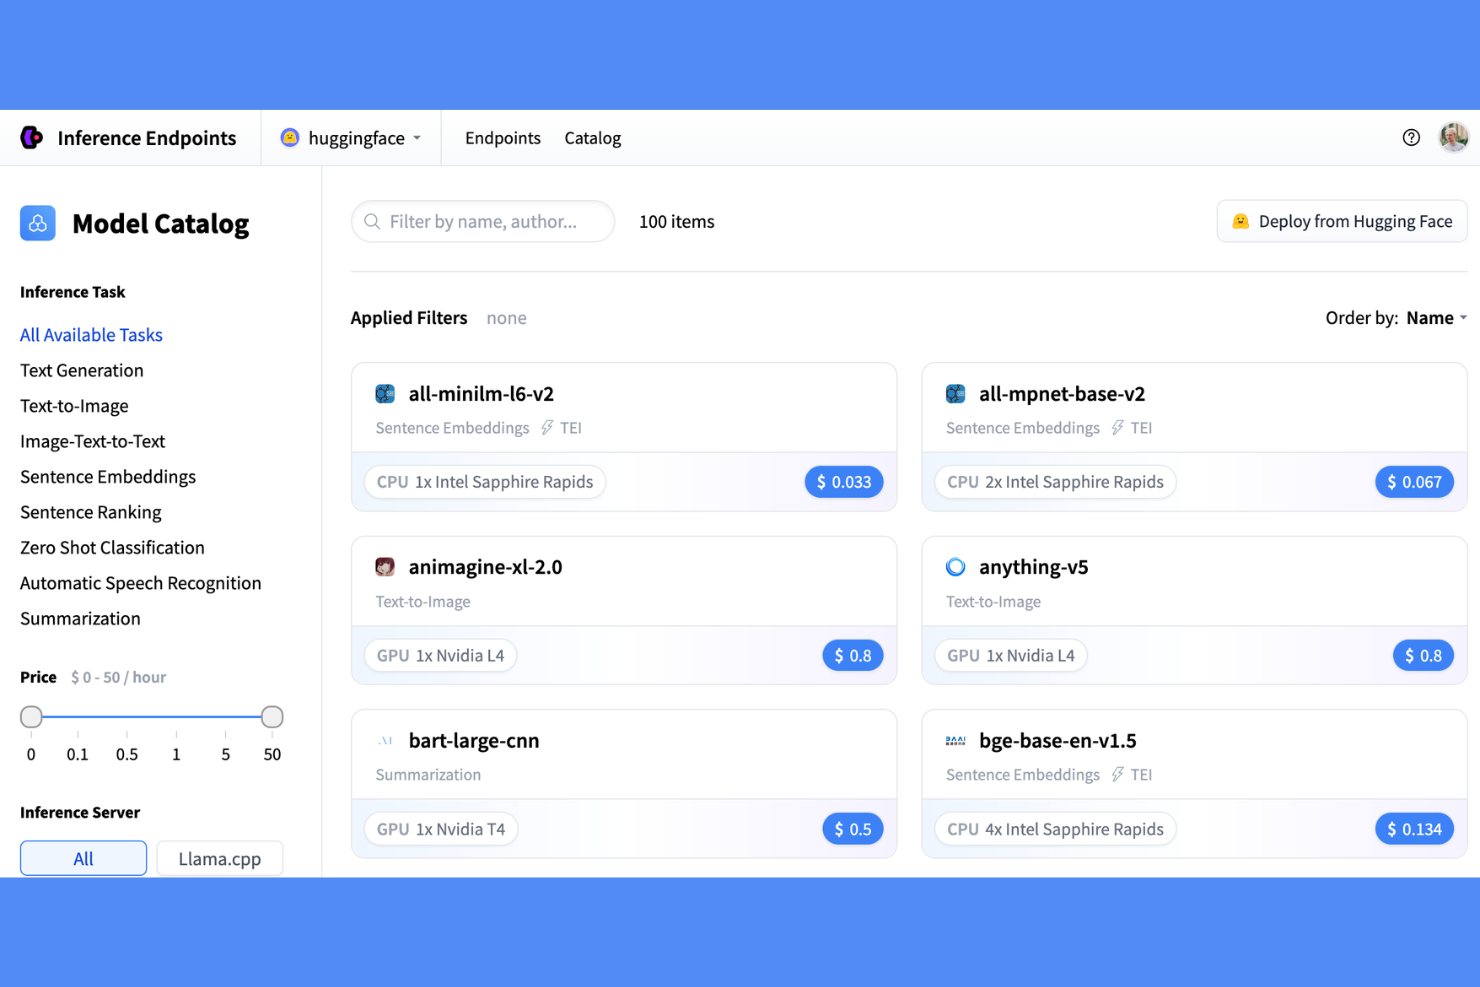
Een beheerd inferentieplatform dat boven op de Hugging Face Hub is gebouwd. Hugging Face Inference Endpoints verzorgt speciale cloudimplementatie, eindpuntconfiguratie en hardwareselectie voor ML-modellen in AWS, Azure en Google Cloud.
Voor wie zijn Hugging Face Inference Endpoints het meest geschikt?
Het is zeer geschikt voor AI-gerichte startups en middelgrote technologiebedrijven die productieklare modelhosting nodig hebben zonder hun eigen infrastructuur voor modelservering te hoeven bouwen en onderhouden.
Waarom ik voor Hugging Face Inference Endpoints heb gekozen
Hugging Face Inference Endpoints staat op mijn voorkeurslijst omdat het speciaal is ontwikkeld voor het ecosysteem van transformatormodellen, op een manier die geen ander implementatieplatform biedt. Mijn team kan elk model uit de Hub gebruiken, waaronder grootschalige LLM's en multimodale transformatormodellen, en dit op productieschaal aanbieden met configureerbare regels voor automatisch schalen die reageren op werkelijk verkeer. Ik waardeer ook de snelheid van model naar eindpunt: een model waarvoor handmatig containeriseren en implementeren dagen zou duren, is binnen enkele minuten actief.
Belangrijkste functies van Hugging Face Inference Endpoints
- Implementatie in meerdere clouds: Kies ervoor om je eindpunt in AWS, Azure of Google Cloud te implementeren zonder afzonderlijke cloudaccounts te beheren.
- Privénetwerken: Sluit eindpunten op in een speciale VPC, zodat alleen je interne systemen toegang hebben tot de model-API.
- Tokengebaseerde authenticatie: Beveilig elk eindpunt met een API-token om te bepalen welke services of gebruikers inferentieverzoeken kunnen verzenden.
- Gebruiksmonitoring: Houd het aantal verzoeken, de latentie en foutpercentages rechtstreeks vanuit het configuratiescherm van het eindpunt in realtime bij.
Integraties van Hugging Face Inference Endpoints
Hugging Face Inference Providers werkt met een groeiend ecosysteem van ontwikkelaarstools, frameworks en platforms, en tools zonder expliciete ondersteuning zijn vaak nog steeds compatibel via de OpenAI-compatibele API. Gedocumenteerde integraties omvatten AWS Bedrock en SageMaker, het Google Gemini Enterprise Agent Platform en Azure AI Foundry, evenals LLM-frameworks zoals LangChain, LlamaIndex, Haystack, CrewAI en PydanticAI. Inference Endpoints kan volledig via de API worden beheerd, waarbij eindpunten via Swagger worden gedocumenteerd, zodat je aangepaste integraties kunt bouwen. Ondersteuning voor Zapier is niet duidelijk gedocumenteerd.
Pros and Cons
Pros:
- Implementatie met één klik vanuit de Hugging Face Hub
- Ondersteunt meerdere achterliggende systemen voor inferentie-engines
- Automatisch schalen met facturering tot nul bij inactiviteit
Cons:
- Koude starts bij het opschalen vanaf nul
- GPU-computerkosten stijgen snel op schaal


Modal is een serverloos cloudplatform voor het uitvoeren van op Python gebaseerde ML-werklasten, waaronder GPU-versnelde inferentie, batchtaken, trainingsruns en geplande taken, zonder container- of infrastructuurbeheer.
Voor wie is Modal het meest geschikt?
Het is bijzonder geschikt voor startende bedrijven en teams in de groeifase die ML-modellen snel moeten uitbrengen zonder gespecialiseerde infrastructuuringenieurs in dienst te nemen.
Waarom ik voor Modal heb gekozen
Ik heb Modal opgenomen in mijn topkeuzes omdat het de kloof wegneemt tussen het schrijven van Python en het op schaal uitvoeren ervan op GPU's. Ik kan specifieke hardware, zoals een A100 of H100, rechtstreeks in mijn functiedefinitie aanvragen, waarna Modal deze op aanvraag beschikbaar stelt. Er is geen cluster om te beheren en er hoeft geen YAML te worden geschreven. Ik vind het ook prettig dat dezelfde functie lokaal en in productie identiek wordt uitgevoerd, wat de tijd die aan foutopsporing wordt besteed aanzienlijk verkort.
Belangrijkste functies van Modal
- Aangepaste containerimages: Definieer afhankelijkheden, omgevingsvariabelen en systeempakketten rechtstreeks in code, zodat uitvoeringsomgevingen bij verschillende implementaties consistent blijven.
- Persistente volumes: Koppel cloudopslagvolumes om modelgewichten tussen uitvoeringen te cachen en zo de opstarttijd bij herhaalde implementaties te verkorten.
- Geheimenbeheer: Sla API-sleutels en inloggegevens veilig op en voeg ze tijdens runtime toe zonder ze hardgecodeerd in je codebase op te nemen.
- Parallelle batchuitvoering: Gebruik .map() om inferentie op grote datasets parallel uit te voeren in meerdere containers tegelijk.
Modal-integraties
Modal biedt een kleine set gedocumenteerde integraties die gericht zijn op observeerbaarheid en meldingen, waaronder Datadog, elke OpenTelemetry-compatibele provider, Slack en Okta SSO. Het ondersteunt ook koppelingen met cloudopslag voor AWS S3, Google Cloud Storage en Cloudflare R2, plus CI/CD-werkstromen via GitHub Actions. Ondersteuning voor Zapier is niet gedocumenteerd, maar Modal biedt een Python-SDK en webeindpunten die aangepaste integraties ondersteunen.
Pros and Cons
Pros:
- Geen Dockerfiles of Kubernetes-configuratie nodig
- Verwerkt training, batchverwerking en inferentie
- Werklasten worden over cloudomgevingen en regio's verdeeld
Cons:
- Code op basis van decorators leidt tot leveranciersafhankelijkheid
- Voor enterprisefuncties is een premium prijsniveau vereist
Het beste voor geautomatiseerd beheer van modellen van begin tot eind
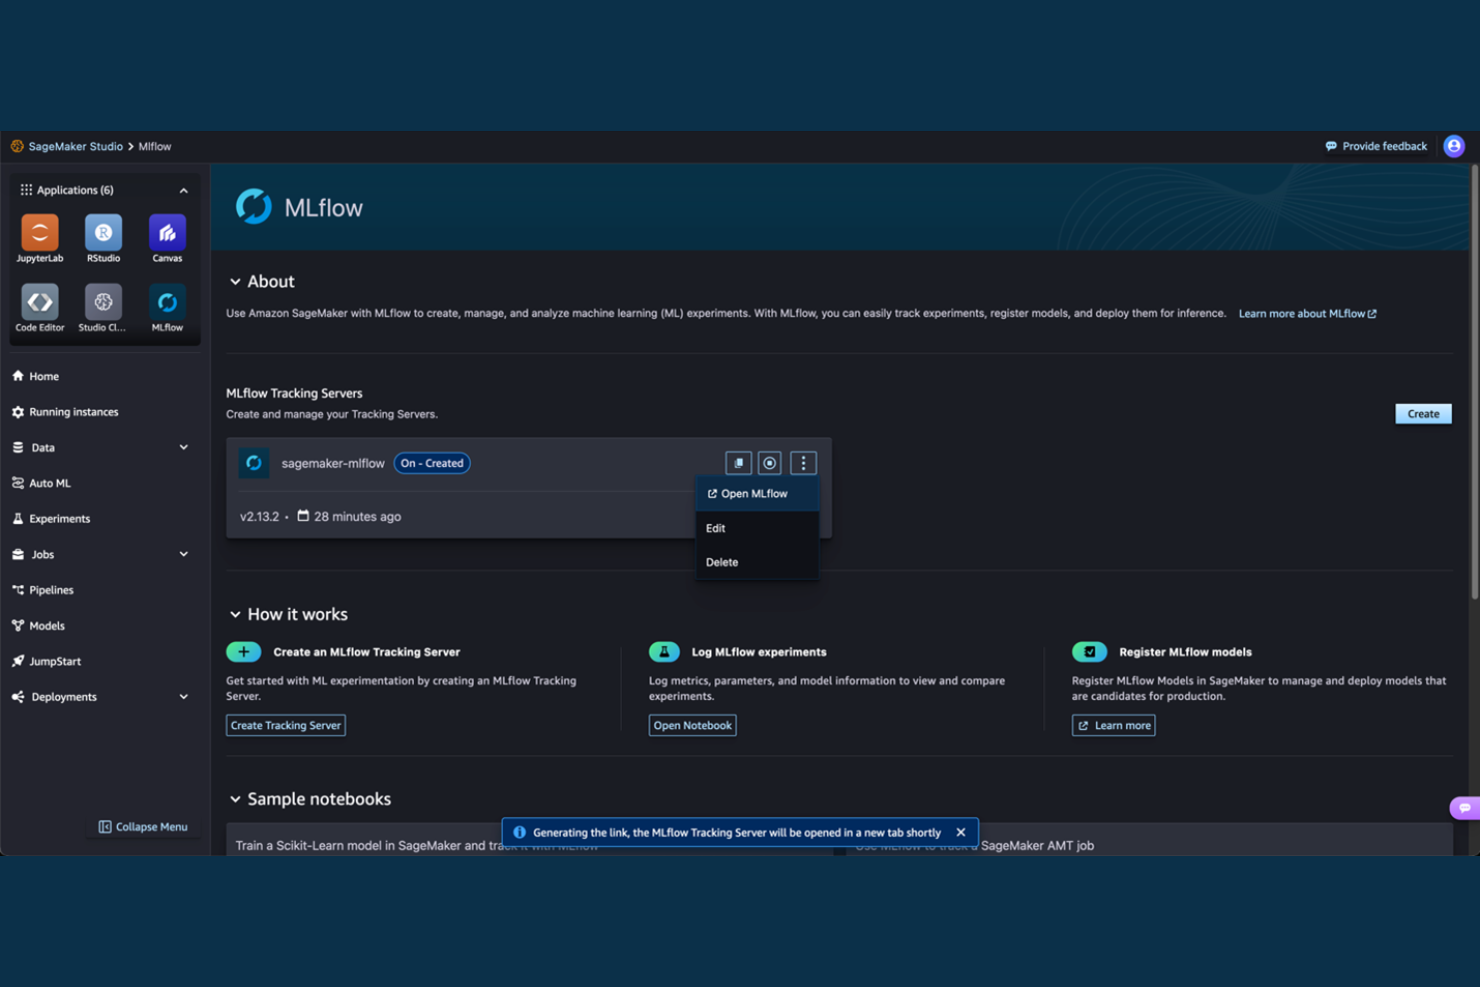
Amazon SageMaker (ook bekend als AWS Sagemaker) is een AWS-platform voor machine learning dat de volledige levenscyclus van modellen omvat—van training en fijnafstemming tot implementatie, monitoring en governance—binnen een uniforme ontwikkelomgeving die is gebouwd op een lakehouse-architectuur.
Voor wie is Amazon SageMaker het meest geschikt?
Amazon SageMaker is zeer geschikt voor teams voor datawetenschap en ML-engineering die al binnen het AWS-ecosysteem werken.
Waarom ik Amazon SageMaker heb gekozen
Amazon SageMaker verdient zijn plaats als een van de beste oplossingen op mijn shortlist, omdat het geautomatiseerd beheer van modellen van begin tot eind biedt zonder dat je afzonderlijke tools aan elkaar hoeft te koppelen. Ik ben vooral te spreken over SageMaker MLOps, dat pijplijnorkestratie, een modellenregister en het volgen van implementaties op één plek afhandelt. Ik vertrouw ook op de ingebouwde mogelijkheden van SageMaker AI voor inferentie, AI-beheer en inzicht in de werking om modellen na implementatie te monitoren en drift te detecteren voordat dit een productieprobleem wordt.
Belangrijkste functies van Amazon SageMaker
- SageMaker JumpStart: Krijg toegang tot meer dan 1.000 vooraf gebouwde AI-modellen van toonaangevende aanbieders en implementeer of verfijn ze rechtstreeks binnen SageMaker.
- SageMaker HyperPod: Schaal trainings- en fijnafstemmingstaken over clusters met honderden of duizenden AI-versnellers, met geautomatiseerd clusterbeheer.
- Inferentie in meerdere modi: Implementeer modellen met realtime-, serverloze, asynchrone of batchinferentie op meer dan 70 instantietypen.
- Beheerde MLflow: Volg, orden en vergelijk iteratieve experimenten zonder infrastructuur te hoeven inrichten of servers te beheren.
Integraties van Amazon SageMaker
Amazon SageMaker integreert standaard binnen het AWS-ecosysteem, waaronder met Amazon S3, Amazon Redshift, Amazon Athena, Amazon EMR en AWS Glue, evenals met Amazon Bedrock en Amazon Q Developer. Het werkt ook met tools van derden, zoals Datadog, Hugging Face, MLflow en Pinecone. Er is een API beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Meerdere inferentiemodi voor verschillende werklasten
- Ingebouwde AutoML en afstemming van hyperparameters
- Schaduwtesten voor veilige modelimplementaties
Cons:
- Sterk gekoppeld aan het AWS-ecosysteem
- Het opsporen van fouten in mislukte trainingstaken is moeilijk

Het meest geschikt voor geïntegreerde data- en AI-werkstromen

Gemini Enterprise Agent Platform (voorheen Vertex AI) is het ML-platform van Google Cloud van begin tot eind dat modeltraining, fijn afstemmen, evaluatie, implementatie en de ontwikkeling van AI-agents omvat binnen één beheerde omgeving.
Voor wie is Gemini Enterprise Agent Platform het meest geschikt?
Gemini Enterprise Agent Platform is een natuurlijke keuze voor ML-engineering- en datawetenschapsteams die hun data-infrastructuur al op Google Cloud Platform uitvoeren.
Waarom ik voor Gemini Enterprise Agent Platform heb gekozen
Ik heb Gemini Enterprise Agent Platform aan mijn toplijst toegevoegd omdat het de kloof tussen data- en modelbeheer daadwerkelijk verkleint. Ik vind vooral prettig hoe Gemini Enterprise Agent Platform Pipelines rechtstreeks verbinding maakt met BigQuery, waardoor mijn team trainingspijplijnen kan bouwen op basis van live data uit het datawarehouse zonder iets te exporteren. Met de Feature Store van Gemini Enterprise Agent Platform kunnen we kenmerken ook consistent definiëren, aanbieden en monitoren voor zowel training als inferentie, waardoor een belangrijke bron van verschillen tussen training en gebruik wordt geëlimineerd.
Belangrijkste functies van Gemini Enterprise Agent Platform
- Modelregister van Gemini Enterprise Agent Platform: Een centrale opslagplaats om modellen gedurende hun volledige levenscyclus, voor en na implementatie, te versieseren, organiseren en beheren.
- Eindpunten voor onlinevoorspellingen: Implementeer modellen op speciale eindpunten die realtimevoorspellingen leveren, met configureerbare rekenkracht en verkeersverdeling tussen modelversies.
- Modelmonitoring van Gemini Enterprise Agent Platform: Detecteert kenmerkafwijkingen en voorspellingsdrift in geïmplementeerde modellen door live verkeer te vergelijken met een basislijn van trainingsgegevens.
- Experimenten van Gemini Enterprise Agent Platform: Houdt iteratieve trainingsruns bij, vergelijkt en visualiseert ze om teams te helpen de best presterende modelconfiguraties te identificeren.
Integraties van Gemini Enterprise Agent Platform
Gemini Enterprise Agent Platform integreert standaard met het Google Cloud-ecosysteem, waaronder BigQuery, Cloud Storage, Dataflow en Pub/Sub, en biedt daarnaast ondersteuning voor Kubeflow Pipelines en vooraf gebouwde containers voor TensorFlow, scikit-learn, XGBoost en PyTorch. De gegevensopslag ondersteunt ook gegevensconnectoren van derden voor tools zoals Jira en Shopify. Het is beschikbaar op Zapier en er is een API beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Model Garden biedt meer dan 200 implementeerbare modellen
- Implementatie op basis van eindpunten vanuit Model Garden is eenvoudig
- Ingebouwde integratie met BigQuery voor datawerkstromen
Cons:
- Inactieve speciale eindpunten brengen nog steeds kosten met zich mee
- Niet-overeenkomende regiokoppelingen leiden tot onduidelijke foutmeldingen

Baseten
Het meest geschikt voor het bouwen van aangepaste webinterfaces voor modellen
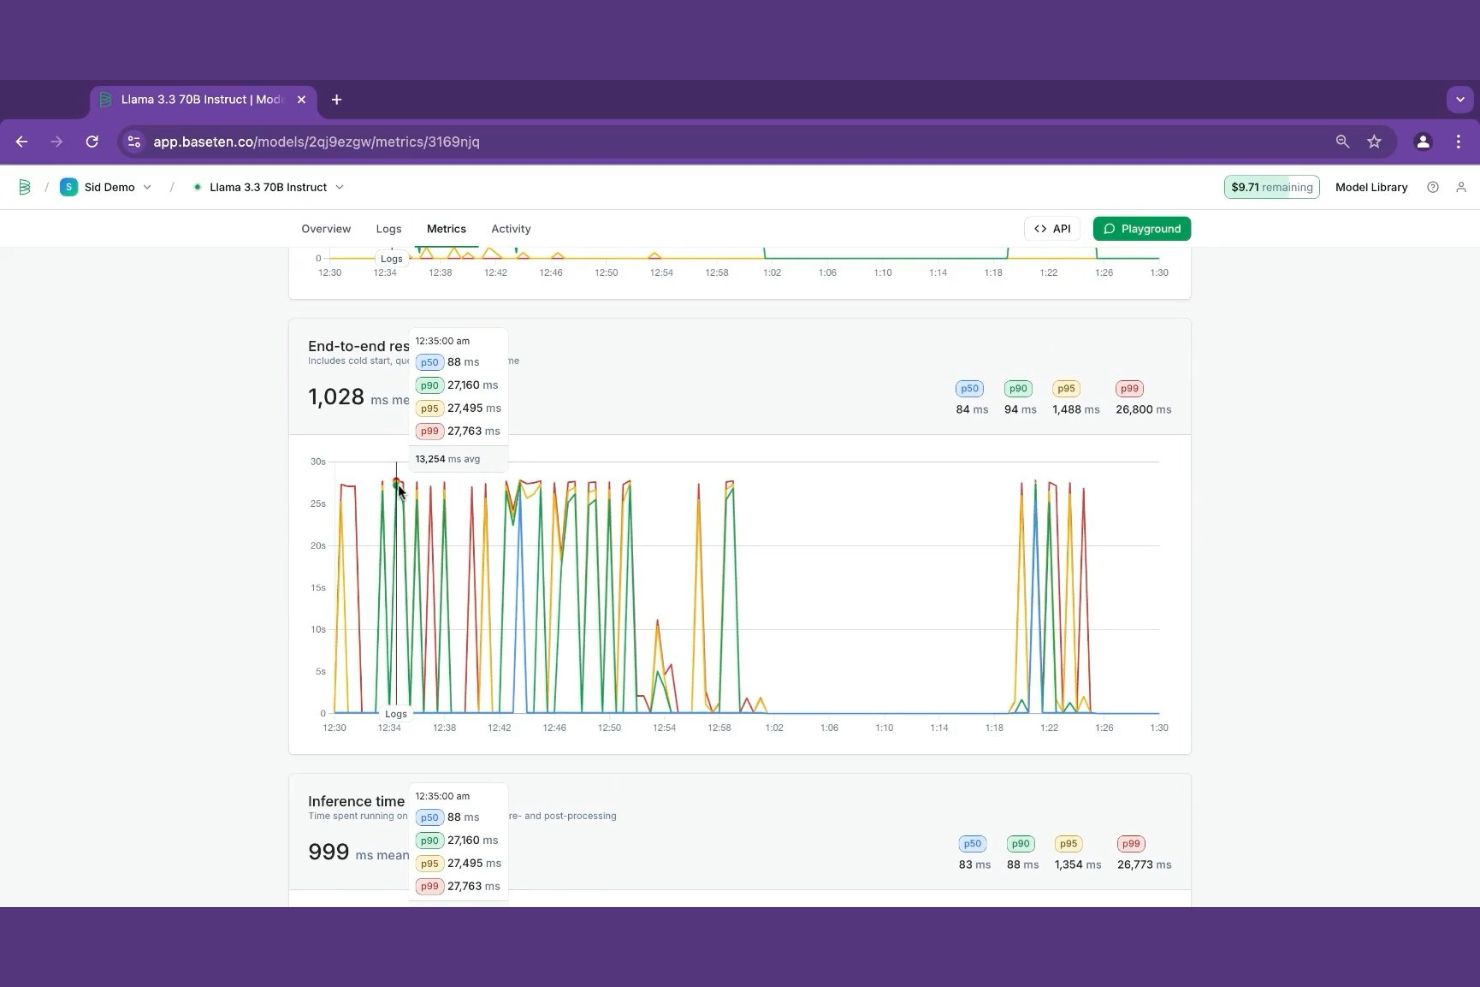
Baseten is een modelinferentieplatform waarmee ML-teams aangepaste, open-source en fijn afgestemde modellen kunnen implementeren met GPU-versnelde uitvoering, automatisch schalen en hulpmiddelen voor prestatieoptimalisatie die rechtstreeks in het platform zijn ingebouwd.
Voor wie is Baseten het meest geschikt?
Baseten is geschikt voor AI-productteams bij bedrijven in de groeifase die volledige controle nodig hebben over de inferentieprestaties voor modelimplementaties met lage latentie of hoge verwerkingscapaciteit.
Waarom ik Baseten heb gekozen
Baseten staat op mijn shortlist omdat je hiermee aangepaste webinterfaces boven op je modellen kunt bouwen en implementeren binnen hetzelfde platform, zonder een afzonderlijke front-endtechnologiestack nodig te hebben. Ik gebruik de applicatiebouwer van Baseten om interactieve interfaces te maken die rechtstreeks model-eindpunten aanroepen, wat handig is voor interne tools of demo's voor belanghebbenden. Het model en de bijbehorende interface blijven samen versiebeheerd en geïmplementeerd.
Belangrijkste functies van Baseten
- Truss-modelverpakking: Verpak elk aangepast of fijn afgestemd model als een reproduceerbaar Python-artefact met ingebouwd afhankelijkheidsbeheer en direct opnieuw laden voor lokaal testen.
- Baseten-ketens: Bouw meervoudige samengestelde AI-workflows waarin elke stap wordt uitgevoerd op onafhankelijk geconfigureerde hardware met een eigen beleid voor automatisch schalen.
- Geheimbeheer: Sla API-sleutels en omgevingsreferenties op en injecteer ze rechtstreeks in modelimplementaties, zonder ze hard te coderen in je uitvoeringscode.
- A/B-verkeerssplitsing: Leid live-inferentieverkeer gelijktijdig over meerdere modelversies om prestaties te vergelijken voordat je een nieuwe implementatie volledig uitrolt.
Integraties van Baseten
Baseten ondersteunt het exporteren van statistieken naar Prometheus, Datadog, Grafana Cloud en New Relic via het op OpenTelemetry gebaseerde eindpunt voor statistieken. Het is volledig compatibel met OpenAI, zodat je het kunt verbinden met elke client of gateway die de OpenAI SDK gebruikt, waaronder LiteLLM, LlamaIndex en Cloudflare AI Gateway. Er is een API beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Truss-verpakking als open source vereenvoudigt modelimplementatie
- Implementatie met één klik vanuit trainingscontrolepunten
- Koude starts op GPU-exemplaren in minder dan een seconde
Cons:
- Op gebruik gebaseerde prijzen kunnen onvoorspelbaar oplopen
- Vereist expertise in ML-techniek om te beheren

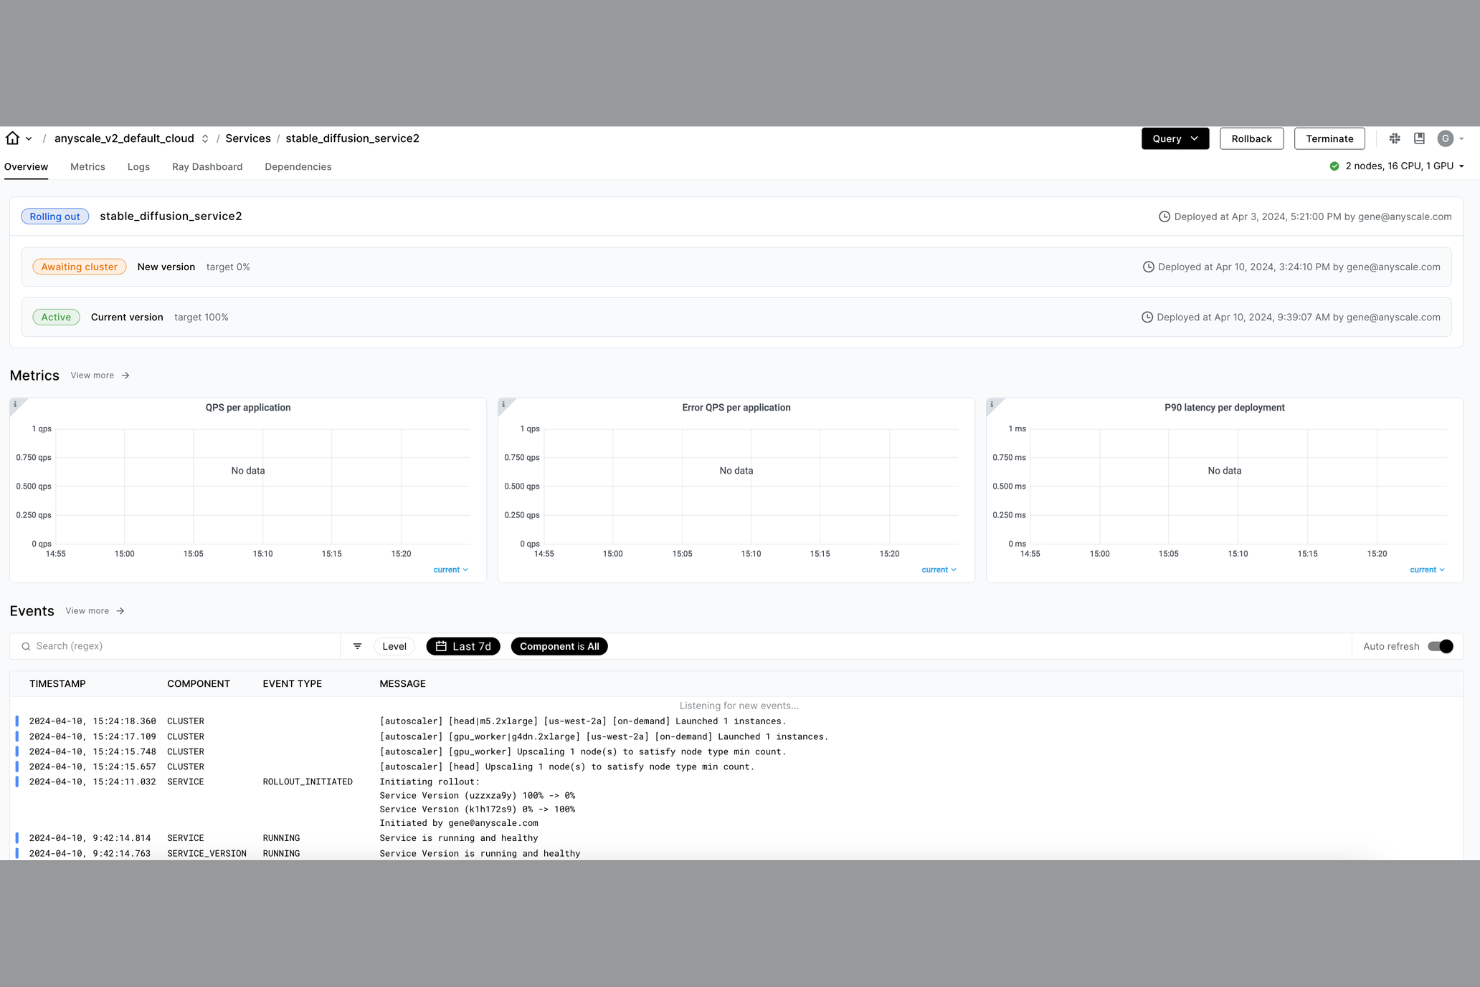
Gebouwd op het open-source Ray-framework is Anyscale een beheerd platform voor het aanbieden van ML-modellen dat gedistribueerde inferentie, automatisch schalen en implementaties met meerdere modellen op GPU- en CPU-clusters afhandelt.
Voor wie is Anyscale het meest geschikt?
Anyscale is zeer geschikt voor ML-engineers en datawetenschapsteams bij middelgrote tot grote organisaties die Python-gebaseerde workloads op schaal uitvoeren en GPU-clusterbeheer nodig hebben zonder de overhead van handmatig infrastructuurbeheer.
Waarom ik Anyscale heb gekozen
Ik heb Anyscale gekozen als een van de beste opties omdat het het enige beheerde platform is dat rechtstreeks op Ray is gebouwd. Daardoor kan mijn team standaard-Python gebruiken om logica voor gedistribueerde modelservering te definiëren, zonder een afzonderlijke orkestratie-DSL te hoeven leren. Ik ben vooral te spreken over de implementatiegrafiek-API van Ray Serve, waarmee ik meerdere modellen kan samenstellen tot één inferentiepijplijn met expliciete routering van verzoeken. Fractionele GPU-toewijzing is een andere functie die ik regelmatig gebruik om lichte modellen op gedeelde hardware te plaatsen zonder speciale instanties op te starten.
Belangrijkste functies van Anyscale
- Automatisch schalen: Schaalt het aantal replica's automatisch omhoog of omlaag op basis van de realtime verwerkingscapaciteit van verzoeken en de wachtrijdiepte.
- Verkeerssplitsing: Stuurt een configureerbaar percentage van het live verkeer naar nieuwe modelversies voor geleidelijke uitrol zonder downtime.
- Verzoeken bundelen: Groepeert binnenkomende inferentieverzoeken in batches om het GPU-gebruik bij gelijktijdige aanroepen te maximaliseren.
- Modelservering met meerdere knooppunten: Verdeelt één groot model over meerdere knooppunten wanneer het de geheugenlimieten van één GPU overschrijdt.
Integraties van Anyscale
Anyscale integreert met populaire AI/ML-bibliotheken en -frameworks, met meer dan 50 integraties voor dataplatforms, orkestratie, ML-frameworks, observatie, en frameworks voor LLM-apps. Deze omvatten MLflow, Weights & Biases, MongoDB, Snowflake, Databricks, Hugging Face, PyTorch en TensorFlow, evenals Airflow, Prefect, Dagster, Datadog, LangChain en LlamaIndex. Er is een API beschikbaar voor aangepaste integraties en het platform kan ook worden geïmplementeerd als een officiële service op Amazon EKS, Google GKE, Azure AKS en OCI Kubernetes Engine.
Pros and Cons
Pros:
- Schaalt Python-code over gedistribueerde GPU-clusters
- Frameworkonafhankelijke modelservering via Ray Serve
- Ondersteuning voor spotinstanties met automatische fouttolerantie
Cons:
- Sterk gekoppeld aan het Ray-ecosysteem
- Vereist grondige kennis van gedistribueerde systemen

Andere tools voor de implementatie van ML-modellen
Hier zijn enkele aanvullende tools voor de implementatie van ML-modellen die mijn shortlist niet hebben gehaald, maar die toch de moeite waard zijn om te bekijken:


Hoe ik tools voor de implementatie van ML-modellen beoordeel
Ik beoordeel elke tool op twee niveaus: de basisfunctionaliteit om een PyTorch-model naar een REST-eindpunt met automatische schaling en driftmonitoring te pushen, en de onderscheidende factoren die belangrijk zijn voor MLOps-teams.
Kernfunctionaliteit (basisvereisten voor deze lijst)
Bij het selecteren van tools voor mijn lijst beoordeel ik elke tool op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder vermelde kernfunctionaliteit. Vervolgens zet ik de totaalscore van de tool om naar een percentage. Elke tool moet een minimale totaalscore van 65% behalen om in aanmerking te komen voor opname.
- Modelservering & inferentie: Ik kijk of een tool modellen achter REST- of gRPC-eindpunten kan hosten voor realtimevoorspellingen en of de tool ook batchinferentie ondersteunt voor offline scoretaken.
- Ondersteuning voor meerdere frameworks: Ik controleer welke ML-frameworks standaard worden meegeleverd—zoals TensorFlow, PyTorch, XGBoost en ONNX—en of aangepaste containers een optie zijn voor minder gebruikelijke runtimes.
- Modelversiebeheer & register: Met een goed register kun je modelartefacten, metagegevens en herkomst bijhouden, zodat je een slechte implementatie binnen enkele minuten kunt terugdraaien in plaats van gehaast naar het juiste artefact te moeten zoeken.
- Schaling & resourcebeheer: Ik beoordeel hoe automatische schaling onder belasting werkt, of de toewijzing van GPU's en CPU's configureerbaar is en of de tool schaling naar nul ondersteunt om kosten tijdens inactieve perioden te verlagen.
- Monitoring & waarneembaarheid: Productiemodellen verslechteren vaak stilletjes, dus ik zoek naar detectie van datadrift, tracking van voorspellingslatentie en waarschuwingen die prestatieproblemen signaleren voordat ze eindgebruikers bereiken.
- CI/CD & implementatieautomatisering: Ik kijk of de tool geautomatiseerde pijplijnen ondersteunt met strategieën voor geleidelijke uitrol, zoals canary- of A/B-tests, plus op Git gebaseerde triggers voor het opnieuw implementeren van modellen.
Zodra ik een lijst heb met tools die aan deze criteria voldoen, kijk ik wat elk platform onderscheidt.
Onderscheidende factoren (wat leveranciers van elkaar onderscheidt)
Zo vergelijk ik verschillende leveranciers met elkaar:
Opvallende functies
Canary- en schaduwimplementaties onderscheiden tools van elkaar. Ik kijk of het mogelijk is een deel van het liveverkeer naar een nieuwe modelversie te leiden terwijl de huidige versie actief blijft—zo worden nauwkeurigheidsregressies opgespoord voordat ze alle gebruikers bereiken. GPU-optimalisatie is een andere onderscheidende factor: ondersteuning voor dynamische batching en kwantisering via versnellers zoals NVIDIA Triton of TensorRT kan de kosten per voorspelling bij grote volumes drastisch verlagen. Schaling naar nul is eveneens belangrijk, omdat inactieve eindpunten die GPU-uren verbruiken snel oplopende kosten veroorzaken bij workloads met veel inferenties.
Meer dan functies alleen
Integratie met het MLOps-ecosysteem is erg belangrijk—ik controleer of een tool verbinding kan maken met experimenttrackers zoals MLflow of Weights & Biases, orkestrators zoals Airflow en CI/CD-systemen zoals GitHub Actions. Flexibiliteit van de infrastructuur is net zo belangrijk: teams in gereguleerde sectoren hebben vaak zelfgehoste Kubernetes- of BYOC-opties nodig in plaats van uitsluitend SaaS. Ik beoordeel ook de governance- en compliancepositie, met name RBAC, auditlogging en certificeringen zoals SOC 2 of HIPAA waar beveiligingsteams van grote ondernemingen tijdens het inkoopproces naar zullen vragen.
Hoe kies je tools voor de implementatie van ML-modellen?
Het is gemakkelijk om te verzanden in lange functielijsten en complexe prijsstructuren. Om je te helpen gefocust te blijven terwijl je je unieke softwareselectieproces doorloopt, vind je hier een checklist met factoren om rekening mee te houden:
| Factor | Waar je op moet letten |
|---|---|
| Schaalbaarheid | Kan de tool plotselinge toenames in inferentieverkeer verwerken zonder handmatige tussenkomst? Controleer of zowel piekscenario's als scenario's met een laag volume worden ondersteund. |
| Integraties | Maakt het platform rechtstreeks verbinding met je experimenttrackers, CI/CD-hulpmiddelen of datawarehouses, of moet je aangepaste code bouwen en onderhouden? |
| Aanpasbaarheid | Kun je implementatieworkflows, toegangsbeheer voor modellen en resourcebeheer afstemmen op je specifieke beleidsregels en teamstructuren? |
| Gebruiksgemak | Hoe steil is de leercurve voor je team? Houd rekening met de complexiteit van de gebruikersinterface, de kwaliteit van de documentatie en de vraag of de introductie van nieuwe teamleden andere projecten zal vertragen. |
| Implementatie en introductie | Hoeveel ontwikkelingstijd is nodig om van een proefversie naar productie te gaan? Let op verborgen configuratiestappen, vereisten voor netwerken of verplichte trainingen. |
| Kosten | Zijn prijsmodellen transparant en voorspelbaar naarmate het gebruik toeneemt? Vergelijk factureringsmethoden—per voorspelling, rekenuur of eindpunt—voor je werklasten. |
| Beveiligingsmaatregelen | Welke versleutelings-, toegangsbeheer- en auditmechanismen zijn aanwezig? Beoordeel of het aanbod voldoet aan je interne beveiligingsnormen en de behoeften van je klanten. |
| Compliancevereisten | Heb je HIPAA, GDPR of SOC 2 Type II nodig? Controleer of de leverancier de vereiste attesten verstrekt en de noodzakelijke audittrailregistraties voor jouw sector ondersteunt. |
Wat zijn tools voor de implementatie van ML-modellen?
ML-modelimplementatietools zijn platforms die je helpen getrainde machine learning-modellen operationeel te maken, zodat ze beschikbaar zijn via API's of batch-eindpunten voor gebruik in de praktijk. Deze tools beheren taken zoals modelbediening, schaling, monitoring en versiebeheer, zodat je nauwkeurige voorspellingen kunt leveren en de betrouwbaarheid kunt behouden naarmate werklasten veranderen.
Functies
Let bij het selecteren van ML-modelimplementatietools op de volgende belangrijke functies:
- Ondersteuning voor meerdere frameworks: Implementeer modellen die zijn gebouwd met TensorFlow, PyTorch, scikit-learn, XGBoost en ONNX zonder modelcode of conversiestappen opnieuw te moeten bewerken.
- Automatisch schalen van inferentie: Wijst automatisch rekenresources toe op basis van verkeerspatronen en verwerkt plotselinge pieken of rustige perioden om zowel de prestaties als de kostenefficiëntie te behouden.
- Modelversiebeheer: Houdt verschillende modelversies bij, waardoor je modellen in productieprocessen eenvoudig kunt terugdraaien, vergelijken of promoveren met minimale verstoring.
- Canary- en schaduwimplementaties: Maakt geleidelijke uitrol of het spiegelen van live verkeer mogelijk, zodat je nieuwe modellen veilig kunt valideren aan de hand van gegevens uit de praktijk voordat je ze volledig implementeert.
- Batch- en realtimebediening: Ondersteunt zowel realtime-API's als asynchrone batchverwerking voor flexibiliteit binnen bedrijfsapplicaties of gegevenswetenschappelijke werkstromen.
- Resourcebeheer: Hiermee kun je CPU-, GPU- en geheugengebruik per model toewijzen en monitoren, wat helpt om kosten te optimaliseren en de servicegezondheid in productie te behouden.
- Beveiligingsmaatregelen: Omvat toegangsbeheer, versleuteling en netwerkisolatie om modelartefacten en gevoelige inferentiegegevens te beschermen.
- Integratieondersteuning: Maakt native of via API verbinding met MLOps-tools, CI/CD-pijplijnen en gegevensinfrastructuur om continue levering en monitoring te stroomlijnen.
- Logboekregistratie en monitoring: Biedt inzicht in aanvraaglogboeken, latentiemetrieken en foutpercentages voor proactieve probleemoplossing en operationele betrouwbaarheid.
- Compliance en controleerbaarheid: Levert functies zoals auditlogboeken en ondersteuning voor naleving van regelgeving, zodat je kunt voldoen aan branchevereisten in de gezondheidszorg, financiële sector of andere gereguleerde domeinen.
Veelvoorkomende AI-functies
Naast de hierboven genoemde standaardfuncties van ML-modelimplementatietools integreren veel van deze oplossingen AI met functies zoals:
- Geautomatiseerde detectie van drift: Gebruikt AI om binnenkomende gegevens en voorspellingen te monitoren op verschuivingen in de verdeling en waarschuwt teams wanneer bijtraining of onderzoek nodig is om de nauwkeurigheid van het model te behouden.
- Intelligente resourcetoewijzing: Past AI-algoritmen toe om werkbelastingpatronen te voorspellen en rekenresources dynamisch toe te wijzen, waardoor kosten worden verlaagd en latentie wordt geminimaliseerd zonder handmatige afstemming.
- Zelfherstellende implementaties: Gebruikt AI om uitgevallen of verslechterde modeleindpunten te detecteren en verkeer automatisch om te leiden of herimplementatie te activeren, waardoor uitvaltijd en handmatige interventie worden geminimaliseerd.
- Voorspellend schalen: Gebruikt AI om verkeerspieken of -dalingen te voorspellen op basis van historisch gebruik en schaalt de infrastructuur proactief om consistente prestaties en kostenbeheersing te garanderen.
- Anomaliedetectie in inferentie: Gebruikt AI om ongebruikelijke of verdachte voorspellingsaanvragen in realtime te markeren, zodat teams mogelijke problemen met de gegevenskwaliteit of beveiligingsbedreigingen kunnen identificeren.
- Geautomatiseerde analyse van de hoofdoorzaak: Gebruikt AI om logboeken en metrische gegevens te analyseren en de oorzaak van prestatiedalingen of fouten vast te stellen, zodat teams problemen sneller en met minder giswerk kunnen oplossen.
Voordelen
Het implementeren van ML-modelimplementatietools biedt verschillende voordelen voor je team en je bedrijf. Hier zijn enkele voordelen waar je naar kunt uitkijken:
- Versnelde implementatiecycli: Geautomatiseerde verpakking, versiebeheer en integratie met CI/CD-pijplijnen stellen teams in staat om modellen snel van ontwikkeling naar productie te verplaatsen.
- Consistente schaalbaarheid: Automatische schaalvergroting en dynamisch resourcebeheer zorgen ervoor dat je implementaties stabiel en responsief blijven wanneer de vraag verandert.
- Een sterkere beveiligingspositie: Ingebouwde toegangscontroles, versleuteling en auditregistratie helpen modellen en gevoelige gegevens te beschermen in overeenstemming met organisatorische en wettelijke vereisten.
- Minder operationele overhead: Gecentraliseerde monitoring, waarschuwingen en logboekregistratie beperken handmatige probleemoplossing en maken engineeringresources vrij voor werk met een hogere waarde.
- Betrouwbaar modelbeheer: Versiebeheer en implementatielogging maken het eenvoudiger om modellen te volgen, wijzigingen terug te draaien en naleving tijdens audits aan te tonen.
- Flexibele workflowintegratie: Ondersteuning voor meerdere frameworks, implementatiestrategieën en omgevingsconfiguraties stelt teams in staat de mogelijkheden van tools af te stemmen op hun bedrijfsbehoeften.
- Betere voorbereiding op naleving: Uitgebreide audittrails en functies voor naleving vereenvoudigen het voldoen aan HIPAA-, GDPR- of sectorspecifieke vereisten, waardoor het risico voor gereguleerde bedrijven afneemt.
Kosten en prijzen
Bij het selecteren van tools voor ML-modelimplementatie is inzicht nodig in de verschillende beschikbare prijsmodellen en abonnementen. De kosten variëren afhankelijk van functies, teamgrootte, add-ons en meer. De onderstaande tabel geeft een overzicht van veelvoorkomende abonnementen, hun gemiddelde prijzen en de typische functies die zijn inbegrepen in oplossingen voor ML-modelimplementatie:
Vergelijkingstabel van abonnementen
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| Gratis abonnement | $0 | Beperkte implementaties, basisbewaking, toegang voor één gebruiker en communityondersteuning. |
| Persoonlijk abonnement | $10-$30/gebruiker/maand | Individueel gebruik, standaardversiebeheer van modellen, gematigde toewijzing van resources en ondersteuning via e-mail. |
| Zakelijk abonnement | $40-$100/gebruiker/maand | Teamwork, automatische schaalvergroting, integratieondersteuning, verbeterde beveiliging en op rollen gebaseerde toegangscontroles. |
| Enterprise-abonnement | $150-$500+/gebruiker/maand | Geavanceerde naleving, premiumondersteuning, toegewezen infrastructuur, aangepaste SLA's en uitgebreide audit- en beveiligingstools. |
Veelgestelde vragen over tools voor ML-modelimplementatie
Hier volgen enkele antwoorden op veelgestelde vragen over tools voor ML-modelimplementatie:
Hoe verschillen tools voor ML-modelimplementatie van traditionele tools voor applicatie-implementatie?
Tools voor ML-modelimplementatie zijn ontworpen om om te gaan met de unieke uitdagingen van het beschikbaar stellen, bewaken en bijwerken van machinelearningmodellen, zoals het beheren van modelversies, het bijhouden van inferentielogboeken, het ondersteunen van automatische schaalvergroting voor modelverkeer en het integreren met datapijplijnen. Traditionele tools voor applicatie-implementatie kunnen doorgaans niet omgaan met dit soort vereisten.
Kan ik modellen die met verschillende frameworks zijn gebouwd implementeren met dezelfde implementatietool?
Ja, de meeste tools voor ML-modelimplementatie bieden compatibiliteit met meerdere frameworks, waardoor je modellen uit TensorFlow, PyTorch, XGBoost en meer kunt implementeren zonder handmatige conversies of herschrijvingen. Hierdoor kunnen teams eenvoudiger met verschillende technologieën werken en productieprocessen standaardiseren.
Op welke beveiligingsfuncties moet ik bij deze tools letten?
Let op functies zoals toegangscontroles, versleutelde eindpunten, audittrails en netwerkisolatie. Deze helpen ervoor te zorgen dat alleen bevoegde gebruikers modellen kunnen implementeren of bijwerken en houden je modelassets en gegevensvoorspellingen veilig.
Ondersteunen deze tools zowel realtime-inferentie als batchinferentie?
Ja, toonaangevende tools voor ML-modelimplementatie ondersteunen zowel realtime voorspellingen via API’s als modi voor batchverwerking. Hierdoor heeft je team de flexibiliteit om verschillende gebruikssituaties af te handelen, van toepassingen voor eindgebruikers tot grote offline scoretaken.
Hoe helpen deze tools bij modelbewaking en -onderhoud?
Ze bieden ingebouwde bewakingsdashboards, waarschuwingen, logboekregistratie en geautomatiseerde detectie van drift. Met deze functies kun je verslechterde prestaties, gegevensproblemen of operationele fouten vroegtijdig signaleren—vaak voordat ze gevolgen hebben voor eindgebruikers of bedrijfsresultaten.