

10 Elasticsearch-alternatieven geselecteerd voor 2026

Shortlist van Elasticsearch-alternatieven


Een sterk Elasticsearch-alternatief biedt snelle, schaalbare zoekfuncties, flexibele gegevensindexering en betrouwbare analyses, zonder dat je wordt vastgezet in één ecosysteem. Als je zoekt naar opties buiten Elasticsearch, weeg je waarschijnlijk factoren af zoals flexibiliteit dankzij opensourcesoftware, kosten, implementatiegemak of geavanceerde AI-functies.
Met zoveel beschikbare zoek- en analyseplatforms is het lastig om te weten welke oplossing aansluit bij je technische vereisten en bedrijfsdoelen. Deze lijst helpt je de beste Elasticsearch-alternatieven voor 2026 te vergelijken, zodat je vol vertrouwen de juiste oplossing voor de behoeften van je team kunt kiezen.
Wat is Elasticsearch?
Elasticsearch is een opensource zoek- en analyse-engine met hoge prestaties, gebouwd op Apache Lucene en ontworpen voor schaalbare, realtime zoekopdrachten in gestructureerde en ongestructureerde gegevens. Het slaat gegevens op als JSON-documenten en ondersteunt toepassingen voor zoeken in volledige tekst, logboekregistratie en analyses. Het wordt vaak gebruikt binnen de ELK Stack en is een krachtig alternatief voor teams die snelle, gedistribueerde zoekopdrachten en gegevensverwerking nodig hebben.
Vergelijkingstabel van Elasticsearch-alternatieven
Deze vergelijkingstabel vat de prijsgegevens van mijn beste Elasticsearch-alternatieven samen:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideaal voor geavanceerde relevantie-afstemming | Gratis abonnement + gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 2 | Ideaal voor het optimaliseren van zoekfuncties op retailwebsites | Gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 3 | Beste voor AI-aangedreven documentinzichten | Gratis proefperiode van 30 dagen beschikbaar | Vanaf $500/maand | Website | |
| 4 | Beste keuze voor opensource-uitbreidbaarheid | Gratis abonnement beschikbaar | Gratis en opensource, met optionele prijzen voor beheerde diensten van cloudproviders | Website | |
| 5 | Ideaal voor uniforme log- en metriekanalyses | Open-sourceversie beschikbaar (zelf gehost) | Prijsmodel op basis van betalen naar gebruik | Website | |
| 6 | Het beste voor razendsnelle zoekimplementaties | Opensourceversie beschikbaar | Vanaf $30/maand | Website | |
| 7 | Ideaal voor ontwikkelaarsvriendelijke API's | Opensourceversie + gratis demo beschikbaar | Prijsmodel op basis van betalen naar gebruik (op basis van resources) | Website | |
| 8 | Het beste voor schaalbaarheid op ondernemingsniveau | Not available | Gratis en opensource | Website | |
| 9 | Het beste voor realtime verwerking van bigdata | Not available | Gratis en opensource, met betaalde opties voor beheerde hosting | Website | |
| 10 | Het beste voor AI-aangedreven documentinzichten | Gratis proefperiode van 30 dagen beschikbaar | Vanaf $500/maand | Website |
Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Beoordelingen van de beste Elasticsearch-alternatieven
Hieronder vind je mijn gedetailleerde samenvattingen van de beste Elasticsearch-alternatieven die op mijn shortlist staan. In mijn beoordelingen bespreek ik de functies, beste gebruiksscenario’s en integraties van elk platform in detail, zodat je de beste optie voor jou kunt vinden.
Algolia
Ideaal voor geavanceerde relevantie-afstemming

Als je gedetailleerde controle over de relevantie van zoekresultaten nodig hebt, is Algolia voor jou gemaakt. Dit cloudgebaseerde zoekplatform spreekt productteams, e-commercebedrijven en SaaS-aanbieders aan die de rangschikking nauwkeurig willen afstemmen en zeer gepersonaliseerde resultaten willen leveren. In tegenstelling tot Elasticsearch onderscheidt Algolia zich door geavanceerde relevantie-afstemming en realtime indexeringsmogelijkheden.
Waarom Algolia een goed alternatief voor Elasticsearch is
Voor teams die geavanceerde relevantie-afstemming nodig hebben, biedt Algolia een mate van controle die verder gaat dan wat Elasticsearch standaard biedt. Ik heb Algolia gekozen omdat je hiermee de rangschikking nauwkeurig kunt afstemmen met aangepaste regels, bedrijfslogica en signalen uit gebruikersgedrag.
De dynamische rangschikkingsformule en AI-aangedreven relevantiefuncties helpen je zoekresultaten te leveren die beter aansluiten op de intentie van de gebruiker. Deze mogelijkheden maken Algolia een sterke keuze voor bedrijven waarbij zoeknauwkeurigheid en personalisatie de hoogste prioriteit hebben.
Belangrijkste functies van Algolia
Enkele andere functies van Algolia maken het een flexibele optie voor uiteenlopende zoekgestuurde toepassingen:
- Geografisch zoeken: Algolia ondersteunt locatiegebaseerd zoeken, zodat je resultaten kunt filteren en rangschikken op basis van geografische nabijheid.
- Zoeken in meerdere indexen: Je kunt meerdere indexen in één zoekopdracht doorzoeken voor complexere gegevensbehoeften.
- Facettering en filtering: Het platform biedt ingebouwde facettering en filtering om gebruikers te helpen zoekresultaten op basis van kenmerken te verfijnen.
- Analyserapportage: Algolia bevat een realtime analyserapportage om zoekprestaties en gebruikersgedrag te monitoren.
Integraties van Algolia
Standaardintegraties omvatten Android, API-toegang, Supabase, Meteor, Adobe Commerce, Bubble, WordPress, Adobe, Gatsby, Zendesk, BigCommerce, Netlify, Salesforce Commerce Cloud en meer.
Pros and Cons
Pros:
- Geavanceerde relevantie-afstemming biedt gedetailleerde controle over de rangschikking van zoekresultaten
- Realtime indexering ondersteunt directe updates van zoekresultaten
- Ingebouwde tolerantie voor typefouten en taalondersteuning voor een wereldwijd publiek
Cons:
- De prijs kan snel stijgen bij hogere gebruiksvolumes
- Beperkte ondersteuning voor complexe aggregaties in vergelijking met Elasticsearch
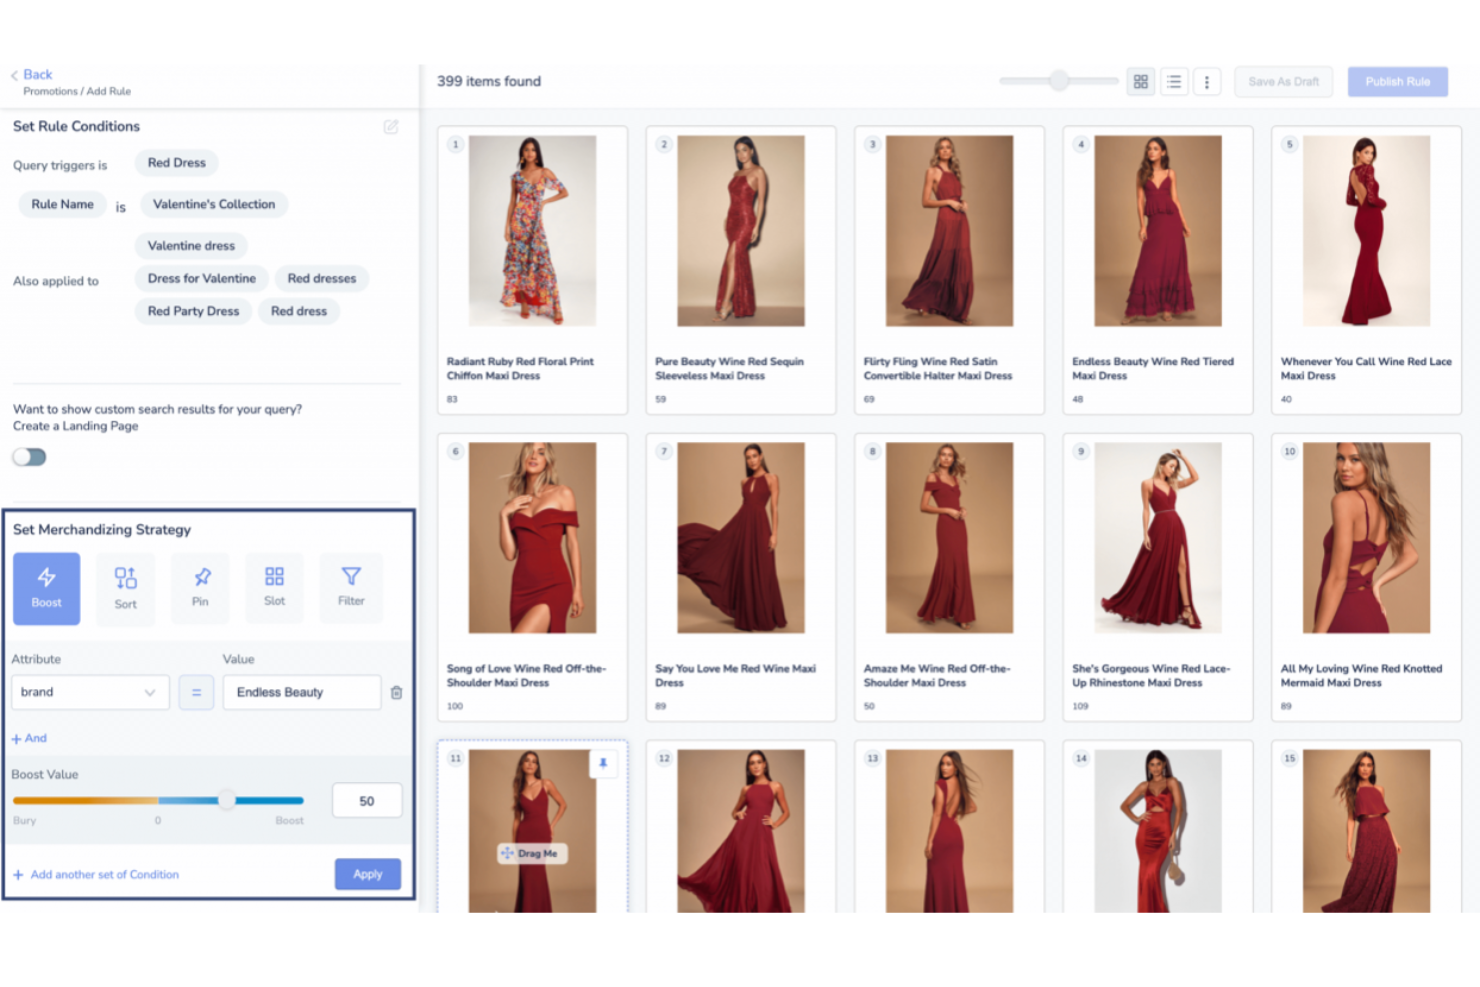
Retailers die de productontdekking en conversiepercentages willen verbeteren, kunnen Netcore Unbxd overwegen voor hun zoekfunctie op de website. Dit platform is speciaal ontworpen voor e-commerce en biedt AI-gestuurde merchandising en gepersonaliseerde zoekervaringen die verder gaan dan wat Elasticsearch doorgaans standaard biedt. Netcore Unbxd helpt retailteams bij het aanpakken van uitdagingen zoals relevantieoptimalisatie, dynamische aanbevelingen en realtime voorraadupdates.
Waarom Netcore Unbxd een goed alternatief voor Elasticsearch is
Voor retailbedrijven die zich richten op het optimaliseren van hun zoekfunctie voor e-commerce biedt Netcore Unbxd gespecialiseerde mogelijkheden die het onderscheiden van Elasticsearch. Ik heb Netcore Unbxd gekozen omdat het AI-aangedreven productaanbevelingen en merchandisingtools biedt die zijn afgestemd op online winkels.
Functies zoals dynamische gefacetteerde navigatie en realtime voorraadbewust zoeken helpen retailers relevantere resultaten te leveren en conversies te verhogen. Als je een zoekoplossing nodig hebt die specifiek voor retail is ontwikkeld, pakt dit platform uitdagingen aan die generieke zoekmachines vaak over het hoofd zien.
Belangrijkste functies van Netcore Unbxd
Andere functies die Netcore Unbxd aantrekkelijk maken voor e-commerceteams zijn onder meer:
- Visueel zoeken: Laat shoppers naar producten zoeken met afbeeldingen in plaats van trefwoorden.
- A/B-testen voor zoeken: Voer experimenten uit met zoekalgoritmen en configuraties om de impact op gebruikersgedrag te meten.
- Automatische suggesties en spellingcorrectie: Bied realtime suggesties en corrigeer typefouten terwijl gebruikers in de zoekbalk typen.
- Analysedashboard: Krijg toegang tot gedetailleerde rapporten over zoekprestaties, zoekopdrachten van gebruikers en conversiestatistieken.
Integraties van Netcore Unbxd
Netcore Unbxd vermeldt momenteel geen native integraties.
Pros and Cons
Pros:
- AI-gestuurde productaanbevelingen passen zich realtime aan het gedrag van shoppers aan
- Visueel zoeken ondersteunt productontdekking op basis van afbeeldingen voor e-commercewebsites
- Ingebouwd analysedashboard houdt zoekprestaties en conversiepercentages bij
Cons:
- Voor sommige geavanceerde functies is handmatige configuratie of ondersteuning van de leverancier nodig
- Documentatie en ondersteuningsbronnen kunnen moeilijk te navigeren zijn
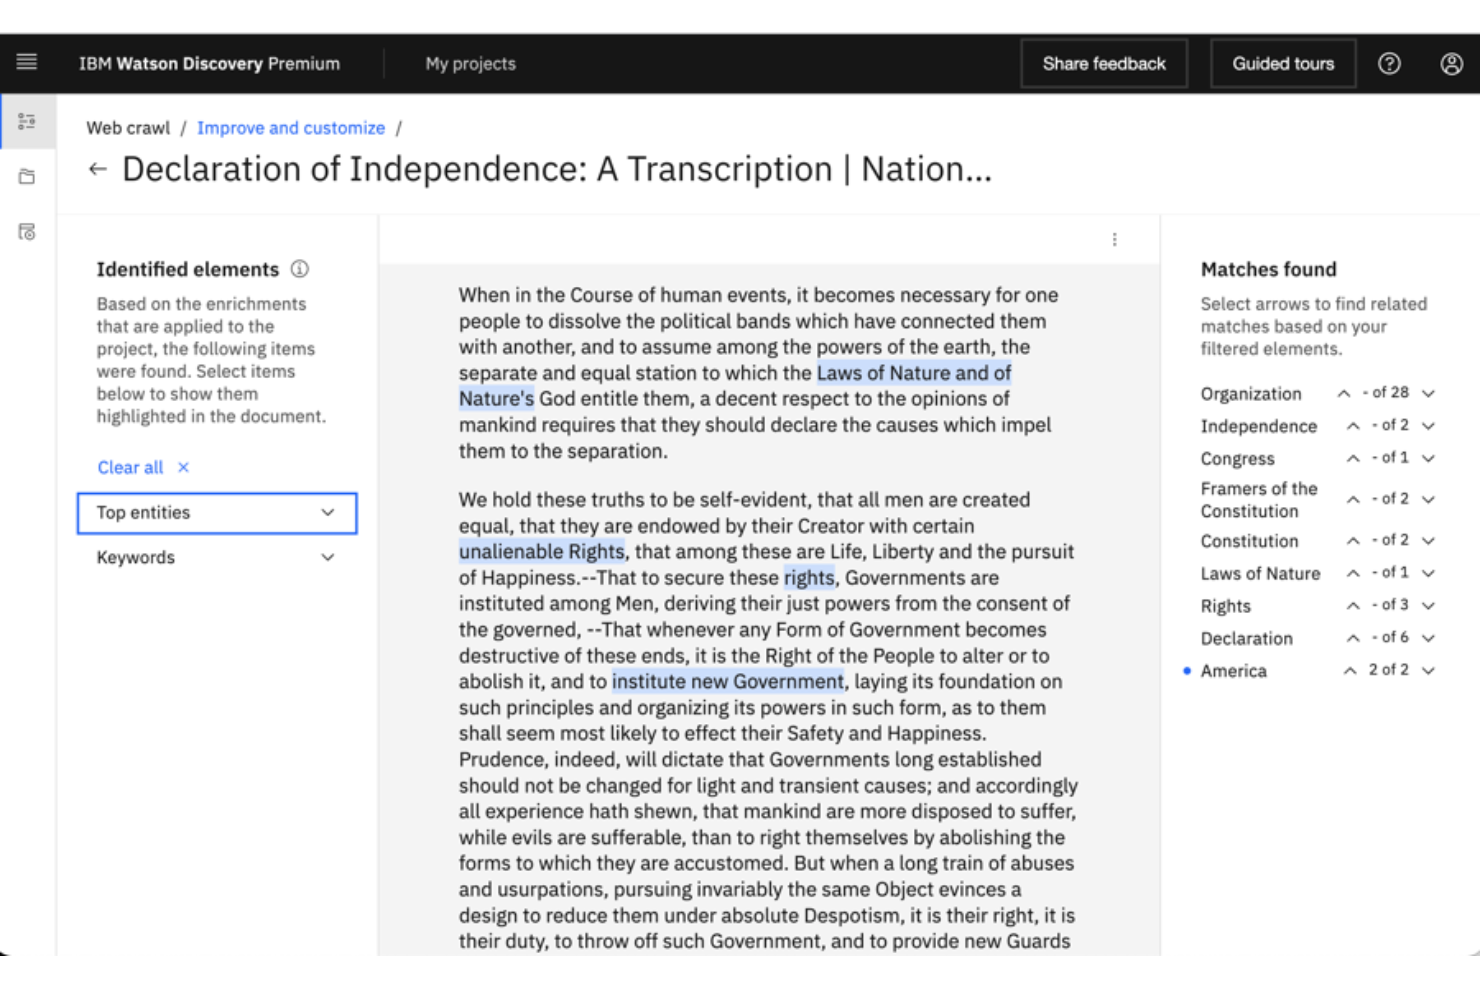
Voor teams die inzichten moeten halen uit grote hoeveelheden ongestructureerde documenten, biedt IBM Watson Discovery geavanceerde AI-aangedreven zoek- en analysemogelijkheden. Het is zeer geschikt voor ondernemingen, onderzoeksorganisaties en gereguleerde sectoren die relevante informatie uit complexe gegevensbronnen naar boven moeten halen.
In tegenstelling tot Elasticsearch gebruikt Watson Discovery natuurlijke taalverwerking en machinaal leren om context te begrijpen en nauwkeurigere antwoorden uit uw documenten te leveren.
Waarom IBM Watson Discovery een goed alternatief voor Elasticsearch is
Wat IBM Watson Discovery onderscheidt, is de focus op AI-aangedreven documentinzichten, die verder gaat dan traditioneel zoeken op trefwoorden. Ik heb deze tool gekozen omdat deze natuurlijke taalverwerking gebruikt om betekenis en context uit ongestructureerde gegevens te halen, waardoor het gemakkelijker wordt om relevante antwoorden in complexe documenten te vinden.
Functies zoals het ophalen van tekstpassages en geavanceerde entiteitsextractie helpen gebruikers precieze informatie naar boven te halen die door standaardzoekmachines mogelijk wordt gemist. Als uw team grote hoeveelheden documenten moet analyseren en begrijpen, biedt Watson Discovery mogelijkheden die moeilijk te evenaren zijn met alleen Elasticsearch.
Belangrijkste functies van IBM Watson Discovery
Enkele andere functies van IBM Watson Discovery maken het een veelzijdige keuze voor het zoeken in en analyseren van documenten:
- Aangepaste gegevensconnectoren: Maak verbinding met verschillende gegevensbronnen, waaronder cloudopslag en opslagplaatsen voor bedrijfscontent.
- Slimme documentverrijking: Voorzie documenten automatisch van labels en verrijk ze met metagegevens voor betere doorzoekbaarheid.
- Relevantieoptimalisatie: Stem zoekresultaten nauwkeurig af door het systeem te trainen op wat voor uw organisatie het belangrijkst is.
- Geïntegreerd analysedashboard: Visualiseer trends en patronen in uw gegevens met ingebouwde analysetools.
Integraties van IBM Watson Discovery
IBM Watson Discovery vermeldt momenteel geen ingebouwde integraties.
Pros and Cons
Pros:
- Geavanceerde natuurlijke taalverwerking levert contextbewuste zoekresultaten
- Voorgetrainde AI-modellen extraheren entiteiten en relaties uit documenten
- Ondersteunt het opnemen van gegevens uit meerdere gegevensbronnen, waaronder cloudopslagplaatsen
Cons:
- De initiële installatie en gegevensvoorbereiding kunnen voor grote datasets tijdrovend zijn
- Voor het aanpassen van AI-modellen kan gespecialiseerde expertise nodig zijn

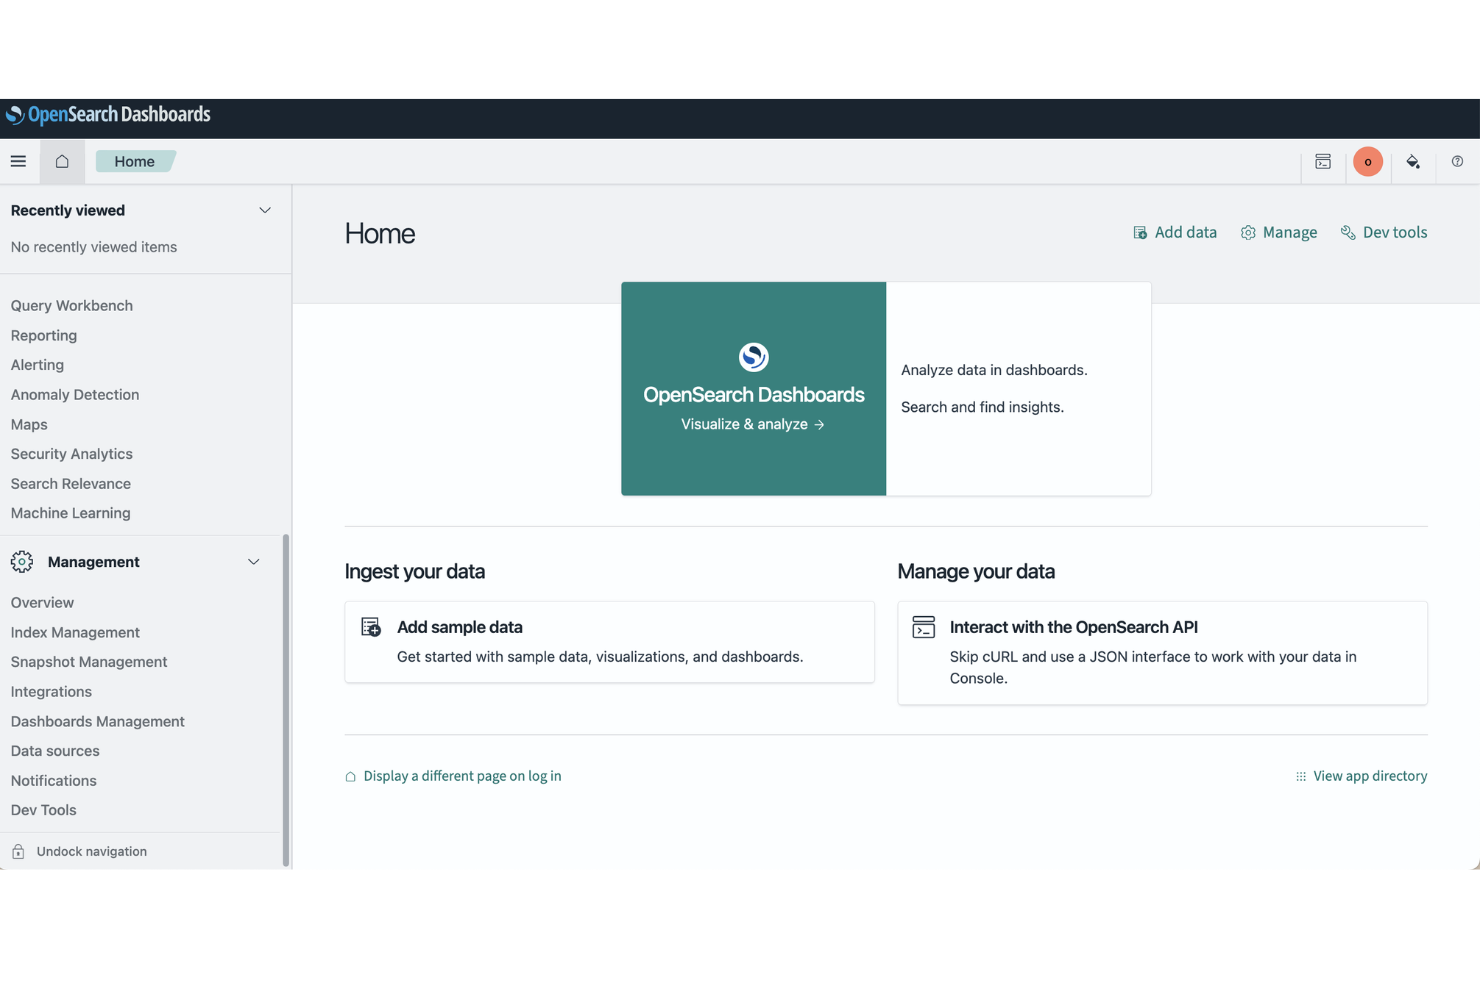
Als je op zoek bent naar een opensource-zoek- en analysesuite met uitgebreide mogelijkheden voor uitbreiding, onderscheidt OpenSearch zich van alternatieven voor Elasticsearch. Het is ontworpen voor IT-teams en ontwikkelaars die volledige controle over hun zoekstack willen, met de flexibiliteit om aangepaste plug-ins te bouwen en het platform aan unieke vereisten aan te passen.
OpenSearch spreekt organisaties aan die transparantie, door de community gestuurde ontwikkeling en de mogelijkheid om functies aan te passen zonder afhankelijkheid van één leverancier belangrijk vinden.
Waarom OpenSearch een goed alternatief voor Elasticsearch is
OpenSearch is een sterke keuze als je opensource-uitbreidbaarheid centraal wilt stellen in je zoekplatform. Ik heb OpenSearch gekozen omdat het volledig opensource is, met een transparant ontwikkelingsproces en een architectuur die geschikt is voor plug-ins, zodat je functies kunt bouwen of aanpassen aan je behoeften.
Het platform ondersteunt aangepaste plug-ins, door de community gestuurde verbeteringen en directe toegang tot de broncode voor diepgaande aanpassingen. Deze eigenschappen maken OpenSearch bijzonder aantrekkelijk voor teams die afhankelijkheid van één leverancier willen vermijden en volledige controle over hun zoekinfrastructuur willen behouden.
Belangrijkste functies van OpenSearch
Enkele andere functies van OpenSearch maken het een flexibele optie voor zoek- en analyseprojecten:
- Geïntegreerde dashboards: OpenSearch Dashboards bieden visualisatietools voor het monitoren en analyseren van zoekgegevens.
- Waarschuwingsframework: Het platform bevat ingebouwde waarschuwingen om teams op de hoogte te brengen van afwijkingen of overschrijdingen van drempelwaarden.
- Anomaliedetectie: Op machinaal leren gebaseerde anomaliedetectie helpt ongebruikelijke patronen in je gegevensstromen te identificeren.
- Gedetailleerde toegangscontrole: Je kunt gedetailleerde machtigingen en rollen instellen om gebruikerstoegang en gegevensbeveiliging te beheren.
Integraties van OpenSearch
Compatibel met de API's van Elasticsearch en ondersteunt plug-ins, dashboards en integraties via tools uit het open ecosysteem.
Pros and Cons
Pros:
- Volledig opensource-licentiemodel maakt onbeperkt gebruik en aanpassing mogelijk
- Actieve communityontwikkeling zorgt voor regelmatige updates en nieuwe functies
- Geïntegreerde dashboards bieden visualisatie en monitoring zonder extra tools
Cons:
- Minder ingebouwde integraties dan commerciële zoekplatforms
- Documentatie kan achterlopen op nieuwe releases en plug-ins uit de community

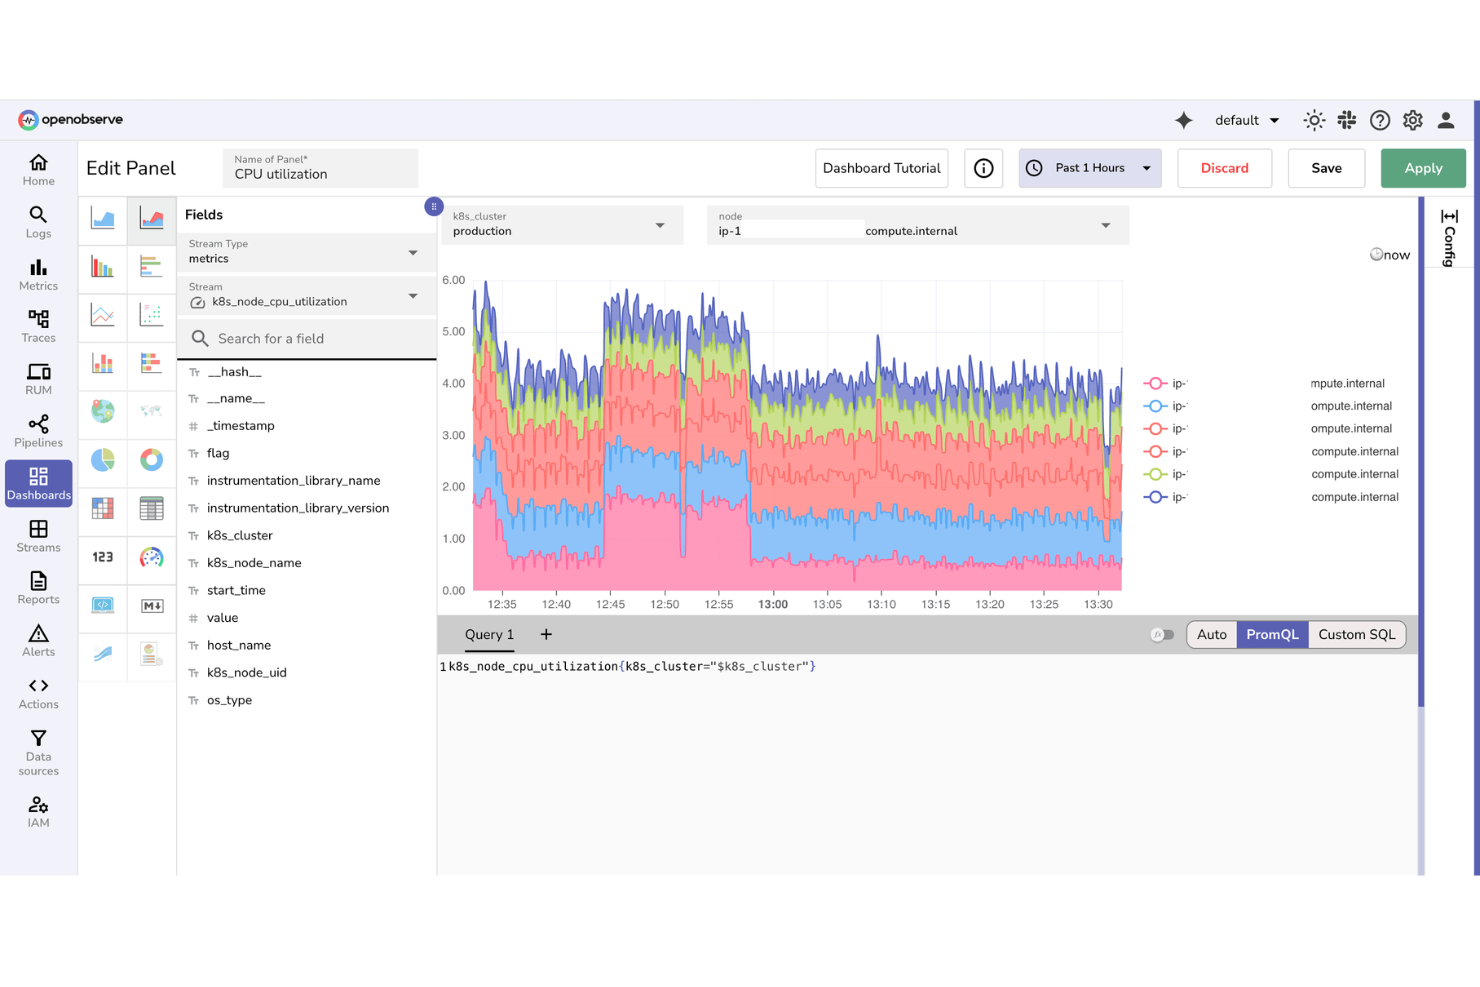
Als je op zoek bent naar één platform voor zowel logs als metrieken, biedt OpenObserve geïntegreerde analyses. Het is ontworpen voor IT-teams, DevOps-engineers en SRE's die gegevens over observeerbaarheid willen consolideren zonder afzonderlijke tools te beheren. OpenObserve onderscheidt zich van alternatieven voor Elasticsearch door ingebouwde ondersteuning te bieden voor het opnemen, opslaan en opvragen van zowel logs als metrieken in één systeem.
Waarom OpenObserve een goed alternatief voor Elasticsearch is
OpenObserve kiest voor een andere aanpak door log- en metriekanalyses te combineren in één platform. Dat vind ik bijzonder waardevol voor uniforme observeerbaarheid. In tegenstelling tot Elasticsearch, waarvoor vaak afzonderlijke tools of plug-ins voor metrieken nodig zijn, neemt OpenObserve beide gegevenstypen van nature gezamenlijk op, slaat ze gezamenlijk op en maakt het mogelijk ze gezamenlijk op te vragen.
Dit uniforme model helpt IT-teams en SRE's om gebeurtenissen en prestatiegegevens met elkaar in verband te brengen zonder tussen systemen te wisselen. Als je je stack voor observeerbaarheid wilt vereenvoudigen en de operationele overhead wilt verminderen, biedt OpenObserve een doelgericht alternatief.
Belangrijkste functies van OpenObserve
Enkele andere functies van OpenObserve maken het een flexibele keuze voor observeerbaarheid en analyses:
- SQL-achtige querytaal: Vraag je gegevens op met vertrouwde SQL-syntaxis voor zowel logs als metrieken.
- Op rollen gebaseerde toegangscontrole: Beheer gebruikersrechten en gegevenstoegang met ingebouwde RBAC.
- Beleid voor gegevensbewaring: Stel aangepaste bewaartermijnen in voor verschillende gegevensstromen om de opslag te optimaliseren.
- Ondersteuning voor S3-compatibele objectopslag: Sla gegevens op in S3 of compatibele objectopslagsystemen voor schaalbaarheid en duurzaamheid.
Integraties van OpenObserve
OpenObserve biedt querymogelijkheden op basis van API's en SQL, met integraties die zijn gericht op pijplijnen voor observeerbaarheid en objectopslagsystemen.
Pros and Cons
Pros:
- Het uniforme platform verwerkt zowel log- als metriekanalyses van nature
- De SQL-achtige querytaal vereenvoudigt het zoeken in gegevens over observeerbaarheid
- Ondersteuning voor S3-compatibele opslag maakt kosteneffectieve gegevensbewaring mogelijk
Cons:
- Minder native integraties dan bij gevestigde platforms voor observeerbaarheid
- De visualisatiemogelijkheden zijn minder uitgebreid dan in Grafana of Kibana
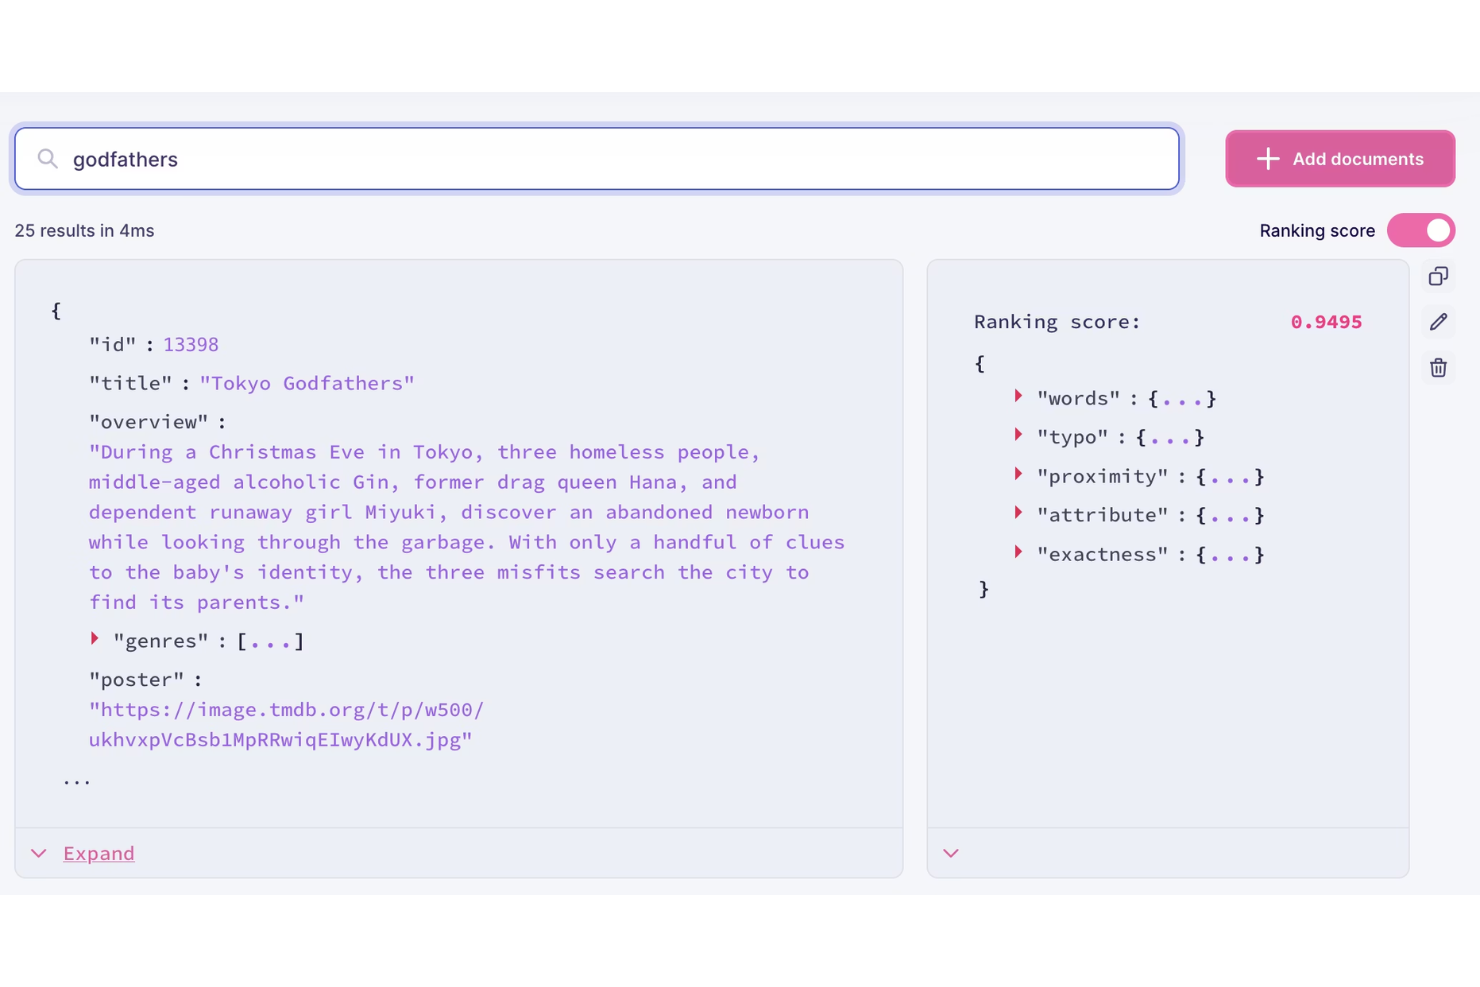
Meilisearch biedt een lichtgewicht, opensource-zoekmachine die is ontworpen voor teams die snelle, eenvoudig te implementeren zoekfunctionaliteit nodig hebben. Dankzij de eenvoudige installatie en directe zoekresultaten is het een uitstekende keuze voor ontwikkelaars die gebruikersgerichte applicaties of interne tools bouwen. Als je een oplossing wilt die snelheid en gebruiksgemak belangrijker vindt dan complexe configuratie, onderscheidt Meilisearch zich van Elasticsearch en andere alternatieven.
Waarom Meilisearch een goed alternatief voor Elasticsearch is
Wat Meilisearch onderscheidt als alternatief voor Elasticsearch, is de focus op razendsnelle zoekimplementaties. Ik heb het gekozen voor teams die directe zoekresultaten nodig hebben, dankzij de index in het geheugen en realtime-updates. Meilisearch ondersteunt standaard tolerantie voor typefouten en aanpasbare rangschikkingsregels, waardoor gebruikers snel relevante resultaten krijgen. Deze functies maken het bijzonder aantrekkelijk voor projecten waarbij snelheid en reactiesnelheid topprioriteiten zijn.
Belangrijkste functies van Meilisearch
Enkele andere functies van Meilisearch maken het een flexibele keuze voor verschillende zoekbehoeften:
- RESTful API: Meilisearch biedt een eenvoudige RESTful API voor gemakkelijke integratie met web- en mobiele applicaties.
- Zoeken met facetten: Het platform ondersteunt filteren op facetten, zodat gebruikers zoekresultaten kunnen verfijnen op basis van categorieën of kenmerken.
- Ondersteuning voor meerdere talen: Meilisearch kan meerdere talen verwerken, waardoor het geschikt is voor wereldwijde applicaties.
- Synoniembeheer: Je kunt aangepaste synoniemen definiëren om de relevantie van zoekresultaten en de gebruikerservaring te verbeteren.
Meilisearch-integraties
Native integraties omvatten SDK's voor .NET, Dart, Go, Java, JavaScript, PHP, Python, Ruby, Rust en Swift.
Pros and Cons
Pros:
- Levert extreem snelle zoekresultaten voor kleine tot middelgrote datasets
- Biedt standaard tolerantie voor typefouten en ondersteuning voor synoniemen
- Eenvoudig implementatieproces met minimale configuratie
Cons:
- Mist geavanceerde analyse- en aggregatiefuncties die wel in Elasticsearch beschikbaar zijn
- Ondersteunt geen gedistribueerde clustering voor grootschalige implementaties

Ontwikkelaars die op zoek zijn naar een eenvoudige, API-gerichte zoekmachine komen vaak uit bij Typesense. Deze opensourceoplossing is ontworpen voor teams die snel aan de slag willen, eenvoudig willen kunnen opschalen en minder operationele overhead willen hebben dan bij Elasticsearch. Typesense onderscheidt zich door zijn intuïtieve API's en realtime indexering, waardoor het zeer geschikt is voor projecten waarbij de ontwikkelaarservaring en snelle implementatie het belangrijkst zijn.
Waarom Typesense een goed alternatief voor Elasticsearch is
Als je een zoekmachine met ontwikkelaarsvriendelijke API's wilt, is Typesense zeker het overwegen waard. Ik heb Typesense gekozen omdat de RESTful en op JSON gebaseerde API's het eenvoudig maken om zoekfunctionaliteit te integreren en te beheren zonder complexe configuratie.
Het platform biedt ook directe zoekindexering en automatische tolerantie voor typefouten, waarmee teams snel relevante resultaten kunnen leveren met minimale configuratie. Deze functies maken Typesense een uitstekende keuze voor projecten waarbij ontwikkelaarsproductiviteit en een eenvoudige implementatie prioriteit hebben.
Belangrijkste functies van Typesense
Andere functies van Typesense maken het een flexibele optie voor teams die zoekgestuurde applicaties bouwen:
- Zoeken met facetten: Typesense ondersteunt zoeken met facetten, zodat gebruikers resultaten op meerdere kenmerken kunnen filteren.
- Synoniembeheer: Je kunt aangepaste synoniemen definiëren om de zoeknauwkeurigheid en gebruikerservaring te verbeteren.
- Ingebouwde hoge beschikbaarheid: Het platform biedt ingebouwde replicatie en automatische overschakeling voor betrouwbaarheid.
- Opensourcelicentie: Typesense is beschikbaar onder een opensourcelicentie, waardoor zelfhosting en aanpassingen mogelijk zijn.
Typesense-integraties
Tot de integraties behoren Laravel, Symfony, Gatsby, Firebase, Twilio, Adobe Commerce, WooCommerce, Prepr en meer.
Pros and Cons
Pros:
- Het API-ontwerp is eenvoudig en consistent voor snelle integratie
- Realtime indexering ondersteunt directe updates van zoekgegevens
- Ingebouwde tolerantie voor typefouten verbetert de zoeknauwkeurigheid voor gebruikers
Cons:
- Mist van nature geavanceerde analyse- en dashboardfuncties
- Geen ingebouwde ondersteuning voor complexe aggregaties of geneste zoekopdrachten
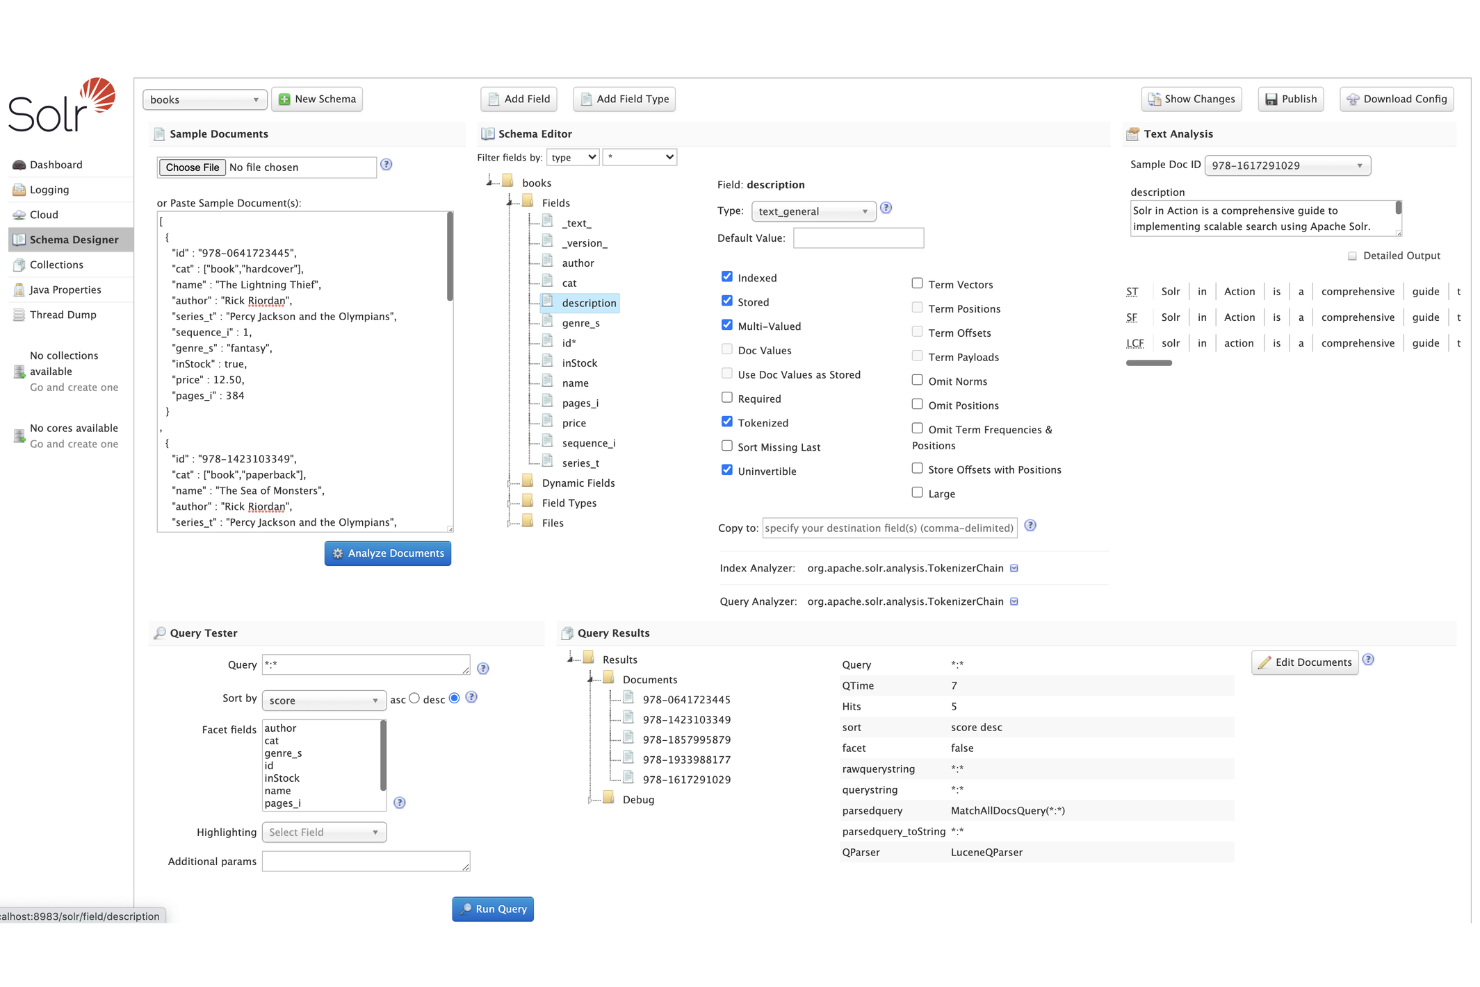
Organisaties met hoge eisen op het gebied van schaalbaarheid en betrouwbaarheid overwegen vaak Apache Solr voor hun infrastructuur voor bedrijfsmatig zoeken. Solr is gebouwd voor grootschalige implementaties en biedt gedistribueerde indexering, sharding en replicatie ter ondersteuning van hoge beschikbaarheid en enorme datavolumes.
De flexibele architectuur en het volwassen ecosysteem maken het een sterke keuze voor IT-teams die complexe, bedrijfskritische zoekomgevingen beheren die verder gaan dan wat Elasticsearch doorgaans standaard biedt.
Waarom Apache Solr een goed alternatief voor Elasticsearch is
Voor teams die prioriteit geven aan schaalbaarheid op ondernemingsniveau biedt Apache Solr een bewezen architectuur voor het verwerken van enorme zoekwerklasten. Ik heb Solr gekozen omdat de functies voor gedistribueerde indexering, sharding en replicatie zijn ontworpen ter ondersteuning van hoge beschikbaarheid en horizontale schaalbaarheid over grote clusters.
Het flexibele schemabeheer en de geavanceerde cachemogelijkheden van Solr helpen IT-teams ook om de prestaties af te stemmen op complexe omgevingen met grote hoeveelheden data. Deze mogelijkheden maken Solr zeer geschikt voor organisaties die behoefte hebben aan betrouwbare zoekfunctionaliteit op grote schaal, verdergaand dan wat Elasticsearch standaard mogelijk biedt.
Belangrijkste functies van Apache Solr
Enkele andere functies van Solr maken het tot een veelzijdige optie voor bedrijfsmatige zoekprojecten:
- Zoekmogelijkheden voor volledige tekst: Solr ondersteunt geavanceerde tekstanalyse, tokenisatie en stemming voor nauwkeurige zoekresultaten.
- Uitbreidbare plug-inarchitectuur: U kunt aangepaste plug-ins toevoegen om de kernfunctionaliteit van Solr uit te breiden voor gespecialiseerde toepassingen.
- Geospatiaal zoeken: Solr biedt ingebouwde ondersteuning voor locatiegebaseerde zoekopdrachten en het indexeren van ruimtelijke gegevens.
- Uitgebreide documentverwerking: Het platform kan een breed scala aan documentindelingen indexeren en doorzoeken, waaronder XML-, JSON- en richtextbestanden.
Apache-integraties
Integratie op basis van API's via REST-achtige API's, met plug-ins en connectors die via het ecosysteem en maatwerkontwikkeling worden gebouwd.
Pros and Cons
Pros:
- De gedistribueerde architectuur ondersteunt hoge beschikbaarheid en grootschalige implementaties
- Flexibel schemaontwerp maakt complexe en evoluerende datamodellen mogelijk
- Geavanceerde tekstanalyse en tokenisatie verbeteren de zoekprecisie
Cons:
- Documentatie kan verspreid zijn over verschillende versies en communitybronnen
- Een upgrade tussen hoofdversies kan aanzienlijke migratie-inspanningen vereisen
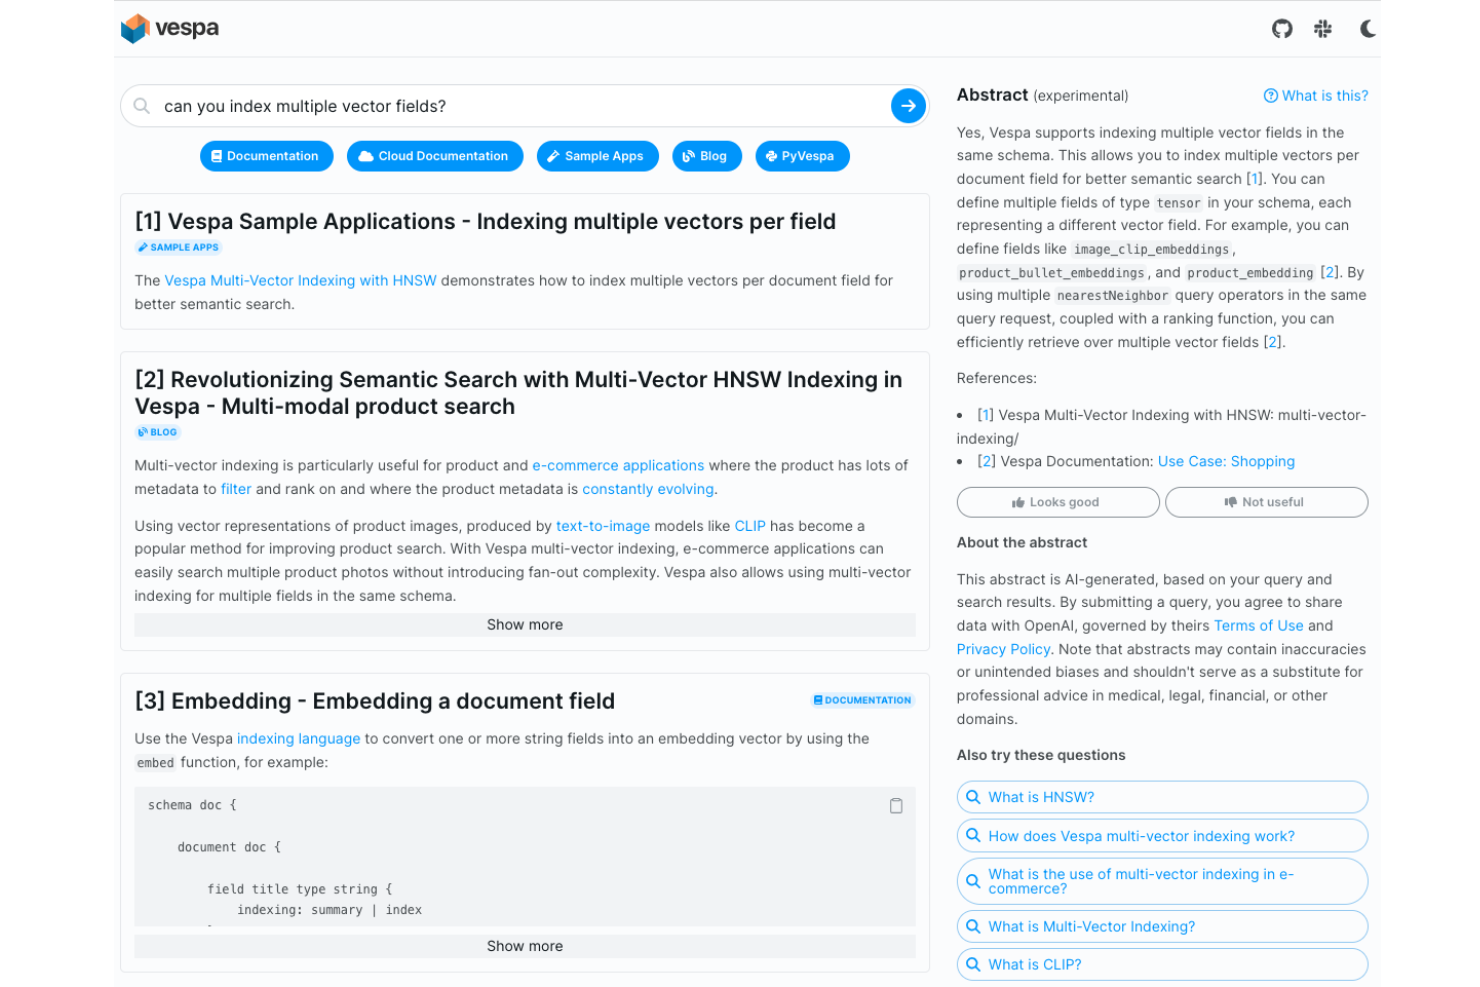
Voor teams die enorme, snel veranderende datasets verwerken, biedt Vespa een realtime-engine voor bigdataverwerking die verder gaat dan traditioneel zoeken. Het platform is ontwikkeld voor IT-specialisten en data-engineers die zoeken, aanbevelingen en analyses op livegegevens op schaal moeten combineren. Vespa onderscheidt zich van alternatieven voor Elasticsearch door verwerking met lage latentie en hoge doorvoer te ondersteunen voor complexe query's en machinelerenmodellen, rechtstreeks op streaminggegevens.
Waarom Vespa een goed alternatief voor Elasticsearch is
Vespa onderscheidt zich door realtime verwerking van bigdata, wat een belangrijke behoefte is voor organisaties die werken met datasets met een hoge snelheid en grote schaal. Ik heb Vespa gekozen omdat het complexe query's, aanbevelingen en inferentie met machineleren rechtstreeks op livegegevens kan uitvoeren terwijl deze binnenstromen.
De architectuur van het platform is ontworpen voor bewerkingen met lage latentie en hoge doorvoer, waardoor het zeer geschikt is voor gebruiksscenario's zoals personalisatie, fraudedetectie en zoeken op grote schaal. Deze mogelijkheden maken Vespa een sterk alternatief voor Elasticsearch wanneer je meer nodig hebt dan alleen zoeken — je hebt realtime analyses en besluitvorming op basis van actuele gegevens nodig.
Belangrijkste functies van Vespa
Enkele andere functies van Vespa maken het een veelzijdige keuze voor veeleisende dataomgevingen:
- Native tensorondersteuning: Vespa verwerkt en slaat tensorgegevensstructuren op voor geavanceerde rangschikking en toepassingen voor machineleren.
- Pijplijnen voor documentverwerking: Het platform bevat ingebouwde pijplijnen voor het opnemen, transformeren en indexeren van documenten.
- Flexibel schemabeheer: Je kunt dataschema's dynamisch definiëren en bijwerken zonder uitvaltijd.
- Ingebouwde toegangscontrole: Vespa biedt rolgebaseerde toegangscontrole om gebruikersrechten en gegevensbeveiliging te beheren.
Integraties van Vespa
Integraties zijn API-eerst, met ondersteuning voor aangepaste toepassingen, datapijplijnen en integraties met machineleren.
Pros and Cons
Pros:
- Realtimeverwerking ondersteunt analyses met lage latentie op streaminggegevens
- Native tensorondersteuning maakt geavanceerde inferentie met machineleren mogelijk
- Opensourcelicentie biedt volledige toegang tot de broncode
Cons:
- Voor optimale prestaties op grote schaal is aanzienlijke infrastructuur vereist
- De eerste installatie en configuratie kunnen complex zijn voor nieuwe gebruikers
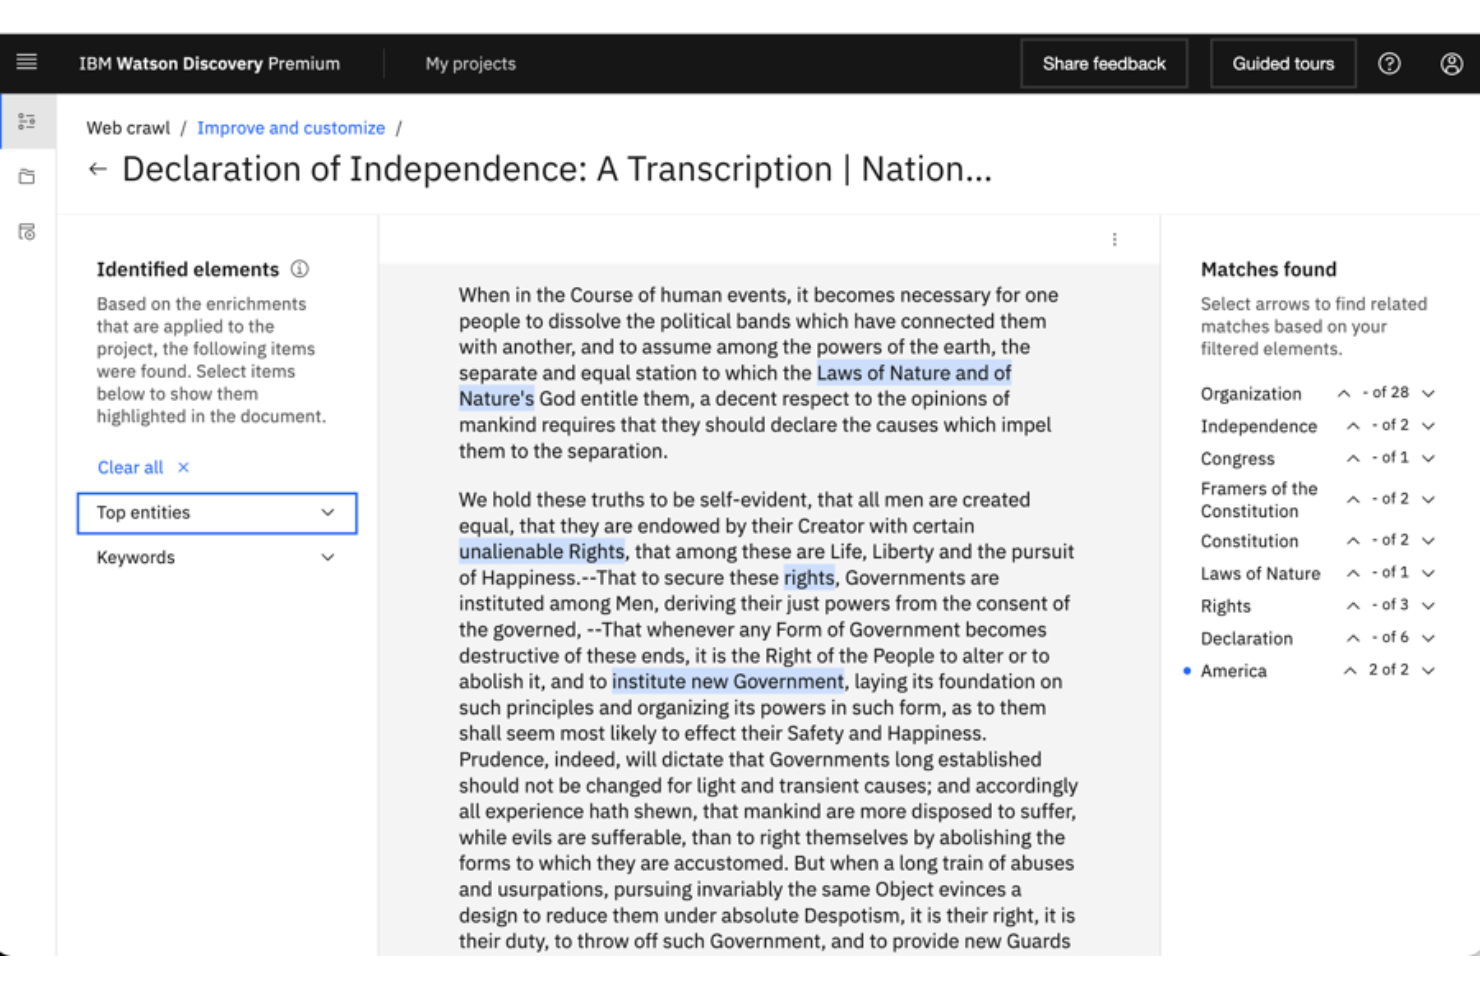
Voor teams die inzichten moeten halen uit grote hoeveelheden ongestructureerde documenten, biedt IBM Watson Discovery geavanceerde AI-aangedreven zoek- en analysemogelijkheden. Het is een sterke keuze voor ondernemingen, onderzoeksorganisaties en gereguleerde sectoren die relevante informatie uit complexe gegevensbronnen moeten halen.
In tegenstelling tot Elasticsearch gebruikt Watson Discovery natuurlijke taalverwerking en machine learning om de context te begrijpen en nauwkeurigere antwoorden uit je documenten te leveren.
Waarom IBM Watson Discovery een goed alternatief voor Elasticsearch is
Wat IBM Watson Discovery onderscheidt, is de focus op AI-aangedreven documentinzichten, die verder gaat dan traditioneel zoeken op trefwoorden. Ik heb deze tool gekozen omdat deze natuurlijke taalverwerking gebruikt om betekenis en context uit ongestructureerde gegevens te halen, waardoor het gemakkelijker wordt om relevante antwoorden in complexe documenten te vinden.
Functies zoals het ophalen van tekstpassages en geavanceerde entiteitsextractie helpen gebruikers nauwkeurige informatie te vinden die door standaardzoekmachines mogelijk wordt gemist. Als je team grote hoeveelheden documenten moet analyseren en begrijpen, biedt Watson Discovery mogelijkheden die moeilijk alleen met Elasticsearch te evenaren zijn.
Belangrijkste functies van IBM Watson Discovery
Enkele andere functies in IBM Watson Discovery maken het een veelzijdige keuze voor het zoeken en analyseren van documenten:
- Aangepaste gegevensconnectoren: Maak verbinding met verschillende gegevensbronnen, waaronder cloudopslag en opslagplaatsen voor bedrijfscontent.
- Slimme documentverrijking: Voorzie documenten automatisch van tags en verrijk ze met metagegevens voor betere doorzoekbaarheid.
- Relevantie-training: Stel zoekresultaten nauwkeuriger af door het systeem te trainen op wat voor jouw organisatie het belangrijkst is.
- Geïntegreerd analysedashboard: Visualiseer trends en patronen in je gegevens met ingebouwde analysetools.
Integraties van IBM Watson Discovery
Ingebouwde integraties worden momenteel niet vermeld door IBM Watson Discovery.
Pros and Cons
Pros:
- Geavanceerde natuurlijke taalverwerking levert contextbewuste zoekresultaten
- Voorgetrainde AI-modellen halen entiteiten en relaties uit documenten
- Ondersteunt het binnenhalen van gegevens uit meerdere gegevensbronnen, waaronder cloudopslagplaatsen
Cons:
- De initiële installatie en gegevensvoorbereiding kunnen tijdrovend zijn voor grote gegevenssets
- Voor het aanpassen van AI-modellen kan gespecialiseerde expertise nodig zijn
Andere Elasticsearch-alternatieven
Hier zijn enkele aanvullende Elasticsearch-alternatieven die mijn shortlist niet hebben gehaald, maar die toch de moeite waard zijn om te bekijken:
- FactFinder
Ideaal voor productontdekking in e-commerce
- Microsoft Azure AI Search
Het beste voor naadloze cloudintegratie
- SigNoz
Het beste met ingebouwde tools voor observeerbaarheid


Hoe ik alternatieven voor Elasticsearch beoordeel
Van het vervangen van Elastic-clusters met een SSPL-licentie tot het mogelijk maken van vectorzoekopdrachten in AI-apps: ik beoordeel tools eerst op essentiële zoekmogelijkheden en kijk daarna naar onderscheidende factoren zoals TCO en implementatieopties.
Essentiële functionaliteit (basisvereisten voor deze lijst)
Bij het selecteren van tools voor mijn lijst beoordeel ik elke tool op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder vermelde kernfunctionaliteit. Vervolgens bereken ik de totaalscore van de tool als percentage. Elke tool moet een minimale totaalscore van 65% behalen om in aanmerking te komen voor opname.
- Zoekmachine voor volledige tekst: ik beoordeel hoe elke tool omgaat met tokenisatie, stemming, analyzers en relevantiescores—zoals benaderende overeenkomsten in productcatalogi of meertalige documentzoekopdrachten.
- Gedistribueerde en schaalbare architectuur: horizontale schaling, sharding en replicatie zijn belangrijk wanneer je index groeit van miljoenen naar miljarden documenten, dus ik controleer hoe elke tool met clustering omgaat.
- RESTful API en query-DSL: een goed gedocumenteerde REST API en expressieve querytaal zijn wat je technici dagelijks gebruiken, dus ik let op flexibele queryconstructie en de beschikbaarheid van client-SDK's.
- Realtime indexering: ik controleer hoe snel nieuwe documenten na opname doorzoekbaar worden—vooral voor gebruikssituaties zoals live ordertracking of het monitoren van beveiligingsgebeurtenissen, waarbij verouderde gegevens een probleem vormen.
- Ondersteuning voor logs en analyses: tools zoals OpenSearch en Zinc verwerken beide logaggregatie, dus ik beoordeel hoe goed elk platform gestructureerde logopname, aggregaties en workflows voor observeerbaarheid ondersteunt.
- Indexering van meerdere gegevenstypen: naast tekst kijk ik naar ondersteuning voor numerieke, geospatiale en vectordatatypen—vooral voor teams die hybride zoekopdrachten of locatiebewuste applicaties bouwen.
Nadat ik een lijst heb samengesteld van tools die aan dit criterium voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (wat leveranciers onderscheidt)
Zo vergelijk ik verschillende leveranciers met elkaar:
Opvallende functies
Vector- en semantische zoekmogelijkheden worden steeds belangrijker nu teams RAG-pijplijnen en AI-aangedreven systemen voor informatieopvraging bouwen, dus ik beoordeel hoe elke tool omgaat met kNN-query's en hybride lexicale en vectorzoekopdrachten. Een beheerd cloudaanbod is ook belangrijk—teams die clusterbeheer willen overslaan, hebben baat bij platforms zoals Meilisearch Cloud of Amazon OpenSearch Serverless. Ik let ook op ondersteuning voor SQL-query's, waarmee analisten geïndexeerde gegevens kunnen opvragen zonder een propriëtaire DSL te leren.
Meer dan functies
Licenties zijn een van de eerste zaken die ik controleer. De overstap van Apache 2.0 naar SSPL is de reden waarom veel teams in de eerste plaats alternatieven zoals OpenSearch zijn gaan onderzoeken, dus ik kijk nauwkeurig naar de licentievoorwaarden en het bestuursmodel van elke tool. Compatibiliteit met het ecosysteem is ook belangrijk—ik beoordeel of bestaande Logstash-pijplijnen, Beats-agenten of OpenTelemetry-verzamelaars werken zonder ingrijpende aanpassingen. Flexibiliteit bij de implementatie vormt het sluitstuk van mijn beoordeling, vooral voor teams in gereguleerde sectoren die lokale, van netwerken geïsoleerde of hybride opties nodig hebben.
Waarom zoeken naar een Elasticsearch-alternatief?
Hoewel Elasticsearch een goede keuze is onder de Elasticsearch-alternatieven, zijn er verschillende redenen waarom sommige gebruikers op zoek gaan naar alternatieve oplossingen. Misschien zoek je een Elasticsearch-alternatief omdat…
- Het beheren en schalen van clusters aanzienlijke interne expertise vereist
- Ingebouwde relevantie-optimalisatie beperkt is voor e-commerce- of retailtoepassingen
- Geavanceerde analyse- en rapportagefuncties niet standaard zijn inbegrepen
- Native ondersteuning voor zoeken op vectoren of afbeeldingen ontbreekt
- Licentie- en ondersteuningskosten op schaal onvoorspelbaar kunnen zijn
- Integraties met specifieke e-commerce- of analyseplatforms beperkt zijn
Als een van deze punten herkenbaar klinkt, ben je hier aan het juiste adres. Mijn lijst bevat verschillende Elasticsearch-alternatieven die beter geschikt zijn voor teams die met deze uitdagingen van Elasticsearch te maken hebben en op zoek zijn naar alternatieve oplossingen.
Belangrijkste functies van Elasticsearch
Hier zijn enkele van de belangrijkste functies van Elasticsearch, zodat je kunt vergelijken wat alternatieve oplossingen te bieden hebben:
- Zoeken in volledige tekst met ondersteuning voor complexe zoekopdrachten
- Realtime indexering en ophalen van gegevens
- Gedistribueerde architectuur voor horizontale schaalbaarheid
- RESTful API voor integratie met andere systemen
- Ondersteuning voor gestructureerde en ongestructureerde gegevens
- Ingebouwde mogelijkheden voor aggregatie en analyse
- Op rollen gebaseerde toegangscontrole en beveiligingsfuncties
- Integratie met Kibana voor gegevensvisualisatie
- Ondersteuning voor meerdere talen voor wereldwijde implementaties
- Momentopnamen en herstel voor back-ups en noodherstel