Waar codeeragents helpen en waar ze falen
Pedro Alves
Technisch directeur bij Thoth AI
Pedro Alves legt uit waar AI-codeeragents softwareontwikkeling versnellen, waar ze verborgen risico's introduceren en waarom ervaren ontwikkelaars essentieel blijven.
Key Takeaways
Codeeragents: Codeeragents kunnen de implementatie versnellen, maar menselijk oordeel moet richting geven aan architectuur-, kwaliteits- en productiebeslissingen.
Verborgen bugs: Door AI gegenereerde code werkt vaak succesvol, terwijl logische fouten verborgen blijven die ervaren beoordelaars moeten opsporen.
Creatieve hiaten: Modellen voeren duidelijk omschreven vertaaltaken goed uit, maar mensen moeten onconventionele inzichten, verbanden en ker beslissingen aandragen.
Teamversterking: Organisaties halen meer voordeel uit het opschalen van ervaren professionals met AI dan uit pogingen om onervaren teams naar een hoger niveau te tillen.
Centrale controle: Een klein, op AI gericht team kan herbruikbare workflows creëren, dubbele experimenten verminderen en de toepassing binnen afdelingen verbeteren.
Pedro Alves werkt al 25 jaar intensief met AI. Momenteel is hij CTO bij Thoth AI en de bedenker van Last Week in AI.
We gingen met Pedro om tafel om codeeragenten te bespreken — en waarom het zo belangrijk is om te weten wat ze wel en niet kunnen. Dit is wat hij ons vertelde.
Voordat “AI” iets was wat mensen op dia’s zetten
Ik ben Pedro, CTO van Thoth AI. Ik werkte al met AI voordat het iets was wat mensen op dia’s zetten — in 2001 bouwde ik als student computerwetenschappen een kleine gesimuleerde wereld vol agenten en liet ik ze leren elkaar te overtreffen, een soort digitaal levensspel waarbij het er vooral om ging te zien hoe ze beter werden. Dat was 25 jaar geleden, en ik jaag nog steeds dezelfde vraag na: hoe zorg je ervoor dat een systeem zichzelf verbetert?
Toen de promotieopleiding in beeld kwam, ging iedereen ervan uit dat ik zou promoveren in machine learning. Dat deed ik niet. Het voelde te beperkt en te theoretisch. Ik wilde het vak leren aan de hand van de rijkste, meest complexe data die ik kon vinden, dus ging ik de computationele biologie in: proteomics voor mijn master en genomics voor mijn promotieonderzoek. Ik leerde machine learning, statistiek en datawetenschap door ze toe te passen — gen-gen-interactienetwerken, feature-engineering, neurale netwerken en ensemblemethoden — op problemen waarbij fouten gevolgen hadden.
Daar leerde ik de les die alles sindsdien heeft gevormd. In de geneeskunde bouwde ik modellen voor ziekteprogressie, en de standaardscorekaart — algehele nauwkeurigheid — was nutteloos. Een “goed” model volgens die maatstaf bevestigde alleen opnieuw de gevallen die artsen al kenden, terwijl de volledige waarde juist zat in de gevallen die ze zouden missen. Dus in plaats van nauwkeurigheid te optimaliseren, optimaliseerde ik de partiële AUC — in essentie de vaardigheid van het model in de gevallen die ertoe deden. De maatstaf die iemand je aanreikt, is bijna nooit het echte doel.
Van daaruit verkende ik verschillende sectoren: die medische modellen, een periode als consultant voor een profvoetbalteam, vervolgens Silicon Valley en jaren in computervisie — in een tijd waarin je nog moest innoveren op het gebied van training en zelfs de initialisatie van de gewichten van een netwerk om detectie en classificatie überhaupt werkend te krijgen. Ik werkte met data uit sociale netwerken, de detailhandel, mode en video. Ik besteedde een jaar aan het bouwen van handelsalgoritmen met genetische algoritmen en particle-swarm-optimalisatie — niet-parametrische optimalisatiemethoden waarover ik tijdens mijn promotieonderzoek artikelen had geschreven. Uiteindelijk begon ik mijn eigen bedrijf, waar ik AI-tools bouwde voor mensen die geen datawetenschappers waren.
De breedte verbindt alles. Na een dozijn vakgebieden blijf ik hetzelfde probleem in verschillende gedaanten zien — een truc die voor de hand ligt in genomics blijkt de sleutel te zijn in computervisie. Het interesseert me meer hoe een probleem wordt geformuleerd dan hoe het wordt opgelost, omdat de hefboomwerking in de formulering verborgen zit.
Dit is wat me naar Thoth brengt. Op papier zijn we een bedrijf voor data-annotatie. Maar ik denk dat het probleem dat de hele sector probeert op te lossen het verkeerde is. Niemand wil geannoteerde data — data is slechts de tussenstap. Ze willen een beter model. Daarom werk ik toe naar een toekomst waarin een systeem uitzoekt welke data jouw model nodig heeft om te verbeteren en dat deel voor je afhandelt, zodat jij je op het model kunt richten in plaats van op het labelen.
More Articles
Twee kanten van het bedrijf
Structureel gezien heeft Thoth AI twee kanten. De ene kant is de dataverwerkingsafdeling, die internationaal en op schaal opereert. Die is groter dan een typische startup, maar nog steeds veel kleiner dan de giganten in deze sector, dus ik zou het bedrijf middelgroot noemen. De andere kant, het onderdeel dat ik opbouw, is een volledig nieuw onderzoeks- en innovatieteam hier in de Bay Area — momenteel bestaande uit vijf mensen, met de komende maanden nog meer medewerkers. Daar werken we aan de rest van modelverbetering: alles wat verder gaat dan labelen.
Ons onderzoek richt zich op twee hoofdgebieden. Het eerste is robotica: belichaamde data genereren, die evalueren en actief leren gebruiken om automatisch de best mogelijke trainingsdata te genereren, zodat robots hun taken met zo weinig mogelijk data kunnen leren. Het grootste deel hiervan maakt gebruik van egocentrische data (in wezen beelden vanuit het eerstepersoonsperspectief), en we richten een groot deel van ons werk op het produceren van de hoogst mogelijke kwaliteit egocentrische data. Het tweede gebied is betrouwbaarheid en efficiëntie in taalmodellen: begrijpen waardoor hallucinaties ontstaan en hoe ze eruitzien, en wat efficiëntie betreft herkennen wanneer een kleiner model een zoekopdracht kan afhandelen en die vervolgens zo nodig herformuleren of in stukken opdelen, zodat een eenvoudiger, goedkoper model die kan beantwoorden. Dit alles is momenteel onderzoek, gericht op producten die we vanuit dit team zullen lanceren.
Wat betreft fase en omvang: de datakant is een gevestigde, middelgrote internationale operatie, terwijl het Amerikaanse onderzoeksteam bewust nog in een vroege fase verkeert. Vijf van ons werken nu op kantoor in San Mateo, en de komende maanden komen er nog een of twee medewerkers bij. Dat is onze huidige situatie.
Hoe uitgebreid testen betrouwbare resultaten oplevert
Pedro deelt
De voorbereiding verloopt nu grotendeels vanzelf. Maar dat is niet de echte winst. De grootste verbetering zit in de kwaliteit: de vergadering is scherper en meer ter zake, en de juiste zaken komen betrouwbaar bij de CEO terecht.
Veel mensen haasten zich om elke taak en functie met AI te automatiseren, maar ik ben voorzichtig. Met AI is het maken van een demo een fluitje van een cent. Iets bouwen dat betrouwbaar dagelijks gebruikt kan worden, is iets anders. Wanneer je deze tools in de praktijk gebruikt, stuit je op randgevallen en uitzonderingen waarbij de automatisering bijna werkt, maar net niet helemaal. Daarom test ik uitgebreid voordat ik iets aan een echte workflow toevertrouw.
Dit jaar heb ik AI-tools gebouwd voor onze wekelijkse beoordelingsvergadering met de CEO die aan die norm voldeden. Ze mailen verantwoordelijken om updates te verzamelen, voegen antwoorden automatisch samen, stellen rapporten, samenvattingen en de agenda op, en houden resultaten in de loop van de tijd bij.
Daarvoor gebeurde dat allemaal handmatig. Iemand moest mensen achter updates aanzitten, antwoorden handmatig samenvoegen, samenvattingen en de agenda schrijven en resultaten van week tot week bijhouden. Het werkte, maar het was traag en de agenda verschoof gemakkelijk naar wat het meest recent was in plaats van naar wat het belangrijkst was.
De voorbereiding verloopt nu grotendeels vanzelf. Maar dat is niet de echte winst. De grootste verbetering zit in de kwaliteit: de vergadering is scherper en meer ter zake, en de juiste zaken komen betrouwbaar bij de CEO terecht. Het gaat dus minder om tijdwinst en meer om het richten van de aandacht van de CEO op de beslissingen die er echt toe doen.
Waarom beoordelingsvermogen menselijk blijft terwijl AI het coderen versnelt
AI vormt nu bijna overal de drijvende kracht achter het coderen zelf. Mijn onderzoekers, de engineers die ons werk productierijp maken, en ik gebruiken allemaal AI-codeertools. Menselijk beoordelingsvermogen, niet een specifieke taakcategorie, bepaalt hoe code wordt gebouwd, en die norm verschuift afhankelijk van de inzet.
Aan de onderzoekskant is het doel meestal om iets werkend te krijgen, vaak door een GitHub-repository op te zetten om de haalbaarheid van een idee te testen. Niets gaat naar productie, dus ik ben niet streng op de schrijfkwaliteit. Als het werkt en de vraag beantwoordt, is dat voldoende.
Productie is anders. Hoe we iets bouwen is net zo belangrijk als of het werkt, dus gebruiken we AI zorgvuldiger. Ervaren engineers zijn verantwoordelijk voor de architectuur, kwaliteit en beoordelingen. AI versnelt hen, maar neemt die beslissingen niet. Die grens blijft menselijk.
De senioriteit van het team helpt. Zij gebruiken AI anders dan minder ervaren mensen. Ze weten al hoe goed werk eruitziet, waardoor het model hun bestaande beoordelingsvermogen versterkt in plaats van beoordelingsvermogen te vervangen dat ze nog aan het ontwikkelen zijn. Het maakt hen sneller zonder het essentiële onderdeel te vervangen.
Hoe je codeeragenten effectief gebruikt
Bijna elk project heeft één uniek element nodig: een niet voor de hand liggend inzicht of een beslissing die het probleem vereist… Datgene wat een project laat werken, is meestal niet doorsnee, en de AI kan er niet zelfstandig op komen. Dat onderdeel moet ik vinden. Daarna bouwt de AI alles wat erop volgt sneller en beter dan ik alleen zou kunnen.
Over het algemeen komt de effectiviteit van codeeragenten voort uit het feit dat ik mezelf disciplineer wat betreft de sterke en zwakke punten van de technologie.
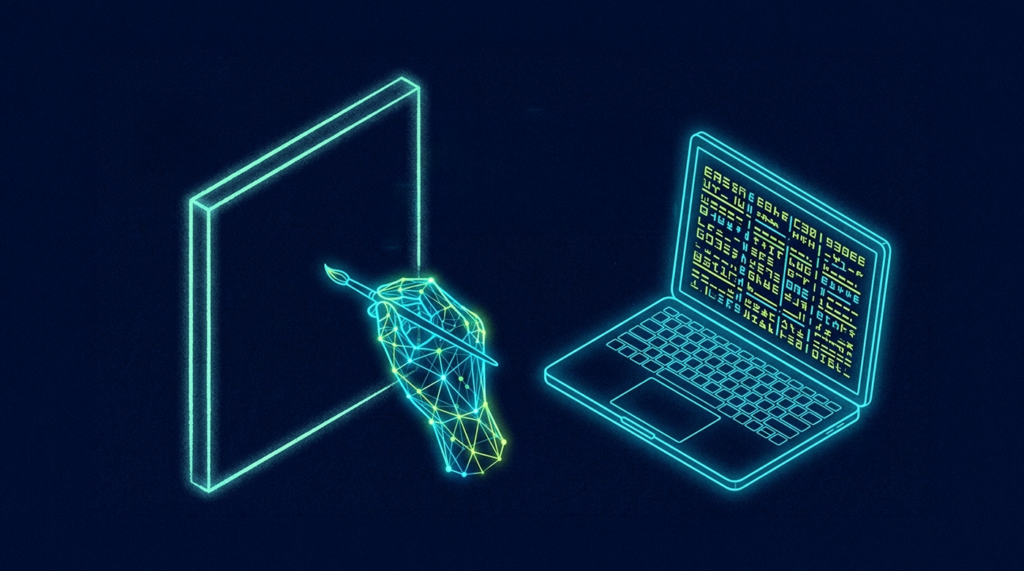
Ik zie het als het schilderen van een doek. Het doel is altijd hetzelfde: het beeld in mijn hoofd verduidelijken en vervolgens AI gebruiken om die intentie zo snel mogelijk om te zetten in werkende code. Het succes hangt af van één variabele: hoeveel creatief werk ik zelf houd versus hoeveel ik overdraag.
AI blinkt uit in de eerste laag. Ik kan het hele schilderij overzien en brede streken aanbrengen, waarna de AI de details invult. Ik weet precies wat er gebouwd moet worden, en het vertalen van intentie naar code is in wezen een formulekwestie. Hier is AI een echte krachtvermenigvuldiger, en het grootste deel van mijn dagelijkse werk valt hieronder.
De tweede laag is nuttig, maar kent meer variatie. Het is vergelijkbaar, maar ik laat bewust een paar delen van het doek open en vraag het model daar iets te schilderen. Dat vereist enige creativiteit, maar mijn aanwijzingen begrenzen het nog steeds. Ik beschouw die uitvoer als een eerste versie, niet als een antwoord.
Ik waarschuw mensen voor de derde laag. Hierbij geef je de creatieve kern aan de AI uit handen: de projectdefinitie of belangrijke ontwerpbeslissingen. Het ziet er indrukwekkend uit voor iemand die niet diep in het domein zit, maar het presteert veel vaker ondermaats dan dat het slaagt, omdat het model een leemte invult die ik had moeten invullen.
Die kloof is precies het hele punt. Bijna elk project heeft één uniek ding nodig: een niet voor de hand liggend inzicht of besluit dat het probleem vereist. Standaard levert het model de gemiddelde oplossing, het meest voorkomende patroon uit zijn training. Wat een project laat werken, is meestal niet gemiddeld, en de AI kan daar niet zelfstandig op uitkomen. Dat onderdeel moet ik vinden. Vervolgens bouwt de AI alles wat daarop volgt sneller en beter dan ik alleen zou kunnen.
Hoe programmeeragenten moeilijk te vinden fouten veroorzaken
Pedro deelt
Het duidelijkste goede resultaat van programmeeragenten is snelheid. Programmeren gaat sneller, waardoor onze implementatiefrequentie toeneemt, en het gaat niet alleen om pure snelheid. Dingen die vroeger ingewikkeld waren om in te stellen, zijn nu veel eenvoudiger. Dat deel is echt en het doet ertoe.
Het duidelijkste goede resultaat van programmeeragenten is snelheid. Programmeren gaat sneller, waardoor onze implementatiefrequentie toeneemt, en het gaat niet alleen om pure snelheid. Dingen die vroeger ingewikkeld waren om in te stellen, zijn nu veel eenvoudiger. Dat deel is echt en het doet ertoe.
Een interessanter resultaat is hoe onze fouten zijn veranderd. Het defectpercentage is niet gestegen, maar de soorten defecten zijn veranderd. AI zorgt ervoor dat code werkt. Dit wordt bijna altijd gecontroleerd voordat de code aan je wordt teruggegeven. De eenvoudigste fouten — die alleen een foutmelding geven of niet werken — komen dus veel minder vaak voor. Wat overblijft, zijn logische fouten en gevallen waar het model niet goed over heeft nagedacht. Die zijn moeilijker te ontdekken, juist omdat de code probleemloos werkt.
Daar zit het nadeel. Deze fouten verbergen zich beter. Als iemand ervaring mist of te zwaar op de tool leunt, ziet diegene dat de code werkt en neemt diegene aan dat de code correct is, terwijl dat niet zo is. Het gevaar zit niet in meer fouten, maar in onterecht vertrouwen. Je hebt iemand nodig die weet waar die op moet letten om dingen te ontdekken die de test ‘het werkt’ doorstaan, maar nog steeds fout zijn.
Waarom AI moet worden gebruikt om ervaren mensen op te schalen in plaats van minder sterke mensen beter te maken
Wat me het meest verraste, was waar de hefboomwerking vandaan komt. Intuïtief zou je kunnen denken dat AI de ervaringsdrempel verlaagt, zodat je goedkopere, meer junior teams kunt inzetten en de tools hen naar een hoger niveau tillen. Het tegenovergestelde bleek waar. Ervaring is nu belangrijker, niet minder belangrijk.
Het draait om betrouwbaarheid. AI gebruiken om één ervaren ingenieur te veranderen in vijf ervaren ingenieurs is veel betrouwbaarder dan een junior ingenieur veranderen in een ervaren ingenieur. AI vermenigvuldigt het beoordelingsvermogen dat je al hebt; het creëert geen beoordelingsvermogen dat je niet hebt.
Daarom schaal ik mijn sterkste mensen op; ik probeer mijn zwakste mensen niet naar een hoger niveau te tillen. Een paar ervaren mensen die elk meerdere keren zoveel produceren als vroeger, verslaan altijd een groter gemengd team.
Waarom mensen de creativiteit moeten aandragen — niet AI
AI heeft duidelijk niet voldaan op het gebied van de creatieve en verbindende aspecten van onderzoek. Wanneer ik technisch werk met hulp van AI, moet een mens nog steeds de verbanden leggen: uitzoeken hoe je voortbouwt op het werk van iemand anders, twee onderzoeksartikelen op een zinvolle manier met elkaar verbinden en de logische sprongen maken die je als vanzelfsprekend zou beschouwen. Dat deel vereist nog steeds een persoon.
Dat is niet verrassend als je bedenkt wat deze modellen zijn. Het zijn waarschijnlijkheidsmachines. Ze produceren de tekst waarvan het waarschijnlijkst is dat die de lezer tevredenstelt. We worden steeds beter in het trainen ervan voor andere soorten taken, maar het wordt echt moeilijk wanneer je creativiteit zelf probeert aan te leren, omdat het lastig is om het trainingssignaal op te bouwen.
Neem datasets. Een dataset voor hoe een hond eruitziet, is eenvoudig. Je verzamelt veel afbeeldingen van honden. Een dataset voor creativiteit bij het tekenen van honden levert een ander probleem op. Denk bijvoorbeeld aan iemand die een hond vleugels geeft. Het punt van dat voorbeeld zijn niet de vleugels. Het gaat om de abstracte handeling erachter: iets wat er niet thuishoort nemen en het plaatsen waar het niet wordt verwacht. Om een model dat te laten begrijpen, heb je een enorm aantal voorbeelden nodig, zodat het leert dat de vleugels er niet toe doen; het creatieve gebaar wel.
Zelfs als dat lukt, stuit je op de volgende muur. Neem nu diezelfde creativiteit en pas die toe op een wiskundige vergelijking of een stuk code uit een onderzoeksartikel, om iemands algoritme uit te breiden. Bij dat soort overdracht valt het systeem uit elkaar.
Mensen vertrouwen juist voor het onderdeel waarin machines het zwakst zijn op machines. De ironie is dat de oplossing goedkoop is. Een snufje menselijke creativiteit brengt je al ver. Leun voor dat onderdeel niet te zwaar op de machine, en je komt opmerkelijk ver.
Waarom CTO’s opnieuw moeten ontwerpen hoe AI-mogelijkheden zich door organisaties bewegen
Dit zal op dit moment geen populair advies zijn, maar ik denk dat het verstandig is en waarschijnlijk het meeste zal opleveren: wees doelbewuster dan het moment van je vraagt.
Op dit moment geven bedrijven enorme bedragen uit op basis van een eenvoudige aanname: iedereen kan een deel van zijn werk automatiseren met AI. Daarom wordt die opdracht aan iedereen gegeven. Engineers, dataspecialisten, sales, marketing, het hele bedrijf. Maak een account aan, automatiseer iets, bouw je eigen tools, ga je gang. Het resultaat is een enorme hoeveelheid verspilde inspanning: dubbel werk, projecten die nergens toe leiden en tools die niemand gebruikt. Bedrijven verbranden veel geld aan inspanningen, tijd en tokens die niets blijvends opleveren.
Breng er een echt proces omheen. Centraliseer het. Stel een klein centraal team samen dat als taak heeft elk ander team beter te laten werken met AI. Zij ontwikkelen workflows, herbruikbare context, standaarden en effectieve patronen, en rollen die vervolgens uit, zodat individuele engineers niet allemaal afzonderlijk de kosten van het uitzoeken hoeven te dragen. Dit is de structurele versie van wat ik eerder zei over het concentreren van hefboomwerking bij je sterkste mensen: een paar AI-vaardige engineers die de hele organisatie naar een hoger niveau tillen.
Dit levert tegelijkertijd twee resultaten op. De benutting neemt toe, omdat teams bewezen patronen gebruiken in plaats van te gokken. En je wint een groot deel terug van de tijd die stilletjes verloren gaat aan experimenten die nooit meer dan één keer hoefden plaats te vinden.
Dit zal op dit moment geen populair advies zijn, maar ik denk dat het verstandig is en waarschijnlijk het meeste zal opleveren: wees doelbewuster dan het moment van je vraagt… Breng er een echt proces omheen. Centraliseer het. Stel een klein centraal team samen dat als taak heeft elk ander team beter te laten werken met AI.
Volg ons
Je kunt het werk van Pedro Alves volgen op LinkedIn of je abonneren op zijn nieuwsbrief, Afgelopen week in AI. Bekijk ook Thoth AI.
Er volgen meer interviews met experts op The CTO Club!