


Utviklingen av testing i produksjon
Til tross for betydelige teknologiske fremskritt er testing i produksjon (TIP) fortsatt en av de mest utfordrende aspektene ved programvareutvikling. Det grunnleggende dilemmaet består:
Hvordan tester du i produksjonsmiljøer uten å risikere forretningskontinuiteten?
Da og nå:
- 2005 (bronsealderen): Begrensede muligheter, høy risiko, få gjennomførbare strategier
- I dag: Avanserte verktøy og metoder, men fortsatt komplekse utfordringer knyttet til implementering
Moderne skyarkitektur, mikrotjenester og containerisering har forvandlet applikasjonsutviklingen, men har ikke eliminert de grunnleggende spørsmålene rundt testing i produksjon:
- Når er riktig tidspunkt for å gjennomføre produksjonstester?
- Hvordan kan du minimere risikoen samtidig som du maksimerer innsikten?
- Hvilket rammeverk sikrer konsekvent og pålitelig testing i produksjon?
Denne artikkelen presenterer en strategisk tilnærming til TIP som balanserer viktig risikostyring med den kritiske innsikten som bare virkelige miljøer kan gi.
Paradokset ved testing i produksjon: Risiko kontra nødvendighet
Viktig innsikt: TIP skaper et grunnleggende paradoks – du må finne kritiske feil i virkelige miljøer, men det å gjøre dette utsetter disse miljøene for risiko.
Det grunnleggende dilemmaet ved testing i produksjon
Testing i produksjon utgjør en klassisk Catch-22-situasjon:
- Du trenger testing i produksjon for å finne feil som bare oppstår under virkelige forhold
- Praktisk testing i produksjon innebærer imidlertid risiko for å forstyrre kritiske forretningsoperasjoner
- Jo bedre testingen din er til å finne katastrofale feil, desto større er faren for forretningskontinuiteten
Konsekvenser i den virkelige verden: Systemer for transaksjonsbehandling har ikke råd til selv ett minutts nedetid – likevel er testing i produksjon avgjørende for å sikre at de aldri opplever slik nedetid.
Hvorfor tradisjonelle tilnærminger til testing i produksjon mislykkes
Historisk tilnærming: Korte testperioder på slutten av utviklingssyklusene
Lærdommen fra Tsjernobyl: På samme måte som atomkatastrofen ble forårsaket av en «sikkerhetstest» på en reaktor i drift, innebærer testing i produksjon betydelig risiko når den implementeres på en dårlig måte.
To kritiske problemer med testing i produksjon på slutten av utviklingen
1. Systemiske problemer oppdages for sent
Når testing i produksjon avdekker betydelige problemer:
- De er per definisjon systemiske problemer (ellers ville de ha dukket opp i testmiljøer)
- Disse problemene krever omfattende feildiagnostisering og komplekse løsninger
- Løsninger som prøves for første gang, fungerer sjelden på grunn av den innfløkte karakteren til systemiske problemer
- Leveranseplanen din blir uunngåelig forlenget med 1–2 måneder eller mer
2. Kritiske ytelsesproblemer oppstår når det er for sent
Produksjonstesting avdekker først og fremst to ødeleggende problemtyper:
Problemer med belastning og skalerbarhet
- Forretningspåvirkning: Ubrukelig i perioder med høy belastning
- Kundereaksjon: Umiddelbar misnøye
Stabilitets- og pålitelighetssvikt
- Forretningspåvirkning: Uforutsigbare driftsavbrudd
- Kundereaksjon: Tap av tillit
Kundeperspektiv: Mindre feil i funksjoner kan utbedres og tilgis, men ytelses- og stabilitetsproblemer som lammer forretningsprosesser, er utilgivelige grunner til å avslutte samarbeidet.
Hovedpoenget om tidspunktet for testing i produksjon
Praktiske TIP-strategier må balansere to motstridende realiteter:
- Testing i produksjon må begynne tidlig og fortsette gjennom hele utviklingen
- Testing i produksjon innebærer iboende risiko som må håndteres nøye
Løsningen er ikke å unngå testing i produksjon, men å implementere den strategisk fra begynnelsen av utviklingsprosessen.
Så, utelukkende fra et forretningsperspektiv – både kundens og ditt – er det å vente med TIP til slutten av lanseringssyklusen et klassisk og ødeleggende feilmønster.
Det strategiske argumentet for tidlig testing i produksjon
Hovedprinsipp: I motsetning til vanlig praksis må testing i produksjon begynne tidlig i utviklingssyklusen og fortsette gjennom hele prosessen, ikke bare til slutt.
Have an account? Log In
Frekvensdilemmaet ved testing i produksjon
Testing i produksjon gir utviklere motstridende mål:
- Hyppigere testing = Bedre diagnostikk og tidligere oppdagelse av feil
- Hyppigere testing = Økt risiko for forstyrrelser i produksjonen
- Mindre testing = Feil blir ikke oppdaget før det er for sent å rette dem effektivt
Denne utfordringen gjenspeiler hvorfor ytelsestesting ofte skyves til slutten av prosjektet, akkurat når den er mest forstyrrende og minst effektiv.
Avliving av «funksjonsfeilen» ved testing i produksjon
Hva er funksjonsfeilen?
Funksjonsfeilen er den feilaktige oppfatningen om at testing i produksjon bør vente til et produkt er «ferdig med alle funksjoner» – en forestilling som skaper unødvendig risiko.
Hvorfor denne tilnærmingen mislykkes:
- Systemkrasj skyldes sjelden én enkelt funksjon
- Problemer med ytelse og stabilitet stammer fra arkitektoniske svakheter
- Problemer med grunnleggende minnehåndtering og ressursallokering har eksistert fra begynnelsen
- Disse grunnleggende problemene kan og bør testes tidlig i produksjonsmiljøer
Moderne arkitektur: Nye verktøy, de samme problemene
Selv om utviklingen har gått fra funksjonssentrerte til tjenestesentrerte modeller, består testutfordringene:
Myten om at tjenestene må være ferdige:
- Gammel tankegang: «Vi trenger alle funksjonene ferdige før TIP.»
- Ny tankegang: «Vi trenger alle tjenestene ferdige før TIP.»
- Realiteten: Begge tilnærmingene forsinker kritisk testing på en farlig måte
Containerisering: Løfter kontra realitet ved testing i produksjon
Løftet:
- Isolerte tjenester reduserer feil som rammer hele systemet
- Raskere oppdateringer med mindre risiko
- Forenklet feilsøking
Realiteten ved testing i produksjon:
- Tjenestene er fortsatt svært avhengige av hverandre
- Feil sprer seg fortsatt gjennom avhengighetskjeder
- Samspillet mellom komponentene skaper fremvoksende atferd
- Tjenestegrenser gjør testutformingen mer kompleks
Et praktisk rammeverk for testing i produksjon
Utfordringen med gapet mellom miljøene
Avstanden mellom test- og produksjonsmiljøer skaper betydelige utfordringer:
- Produksjon er eksponentielt mer kompleks
- Datamengdene varierer med flere størrelsesordener
- Det er umulig å simulere trafikkmønstre fullstendig
- Kostnadsbegrensninger begrenser hvor trofast testmiljøet kan gjengi produksjon
Løsningen med progressiv testing
I stedet for ett enkelt testmiljø bør du innføre en progressiv tilnærming til TIP:
1. Opprett spesialiserte miljøer:
- Systemfokusert testmiljø
- Funksjonsfokusert testmiljø
- Testmiljø med egenskaper som ligner på produksjon
2. Bygg en stige, ikke møt en kløft:
- Begynn å teste kjernearkitekturen i produksjon tidlig
- Øk gradvis testkompleksiteten
- Identifiser systemiske problemer før de blir fastlåste
- Reduser overraskelser i sluttfasen og risikoen for forsinkelser
3. Innfør kontrollert eksponering:
- Bruk funksjonsflagg for å begrense bruker påvirkning
- Test med syntetiske transaksjoner i produksjon
- Overvåk reelle brukere som samhandler med nye komponenter
- Utvide gradvis testomfanget i produksjonsmiljøer
Denne tilnærmingen forvandler TIP fra en høyrisikoaktivitet på slutten av prosessen til en kontinuerlig, kontrollert prosess som gir tidligere innsikt med håndterbar risiko.
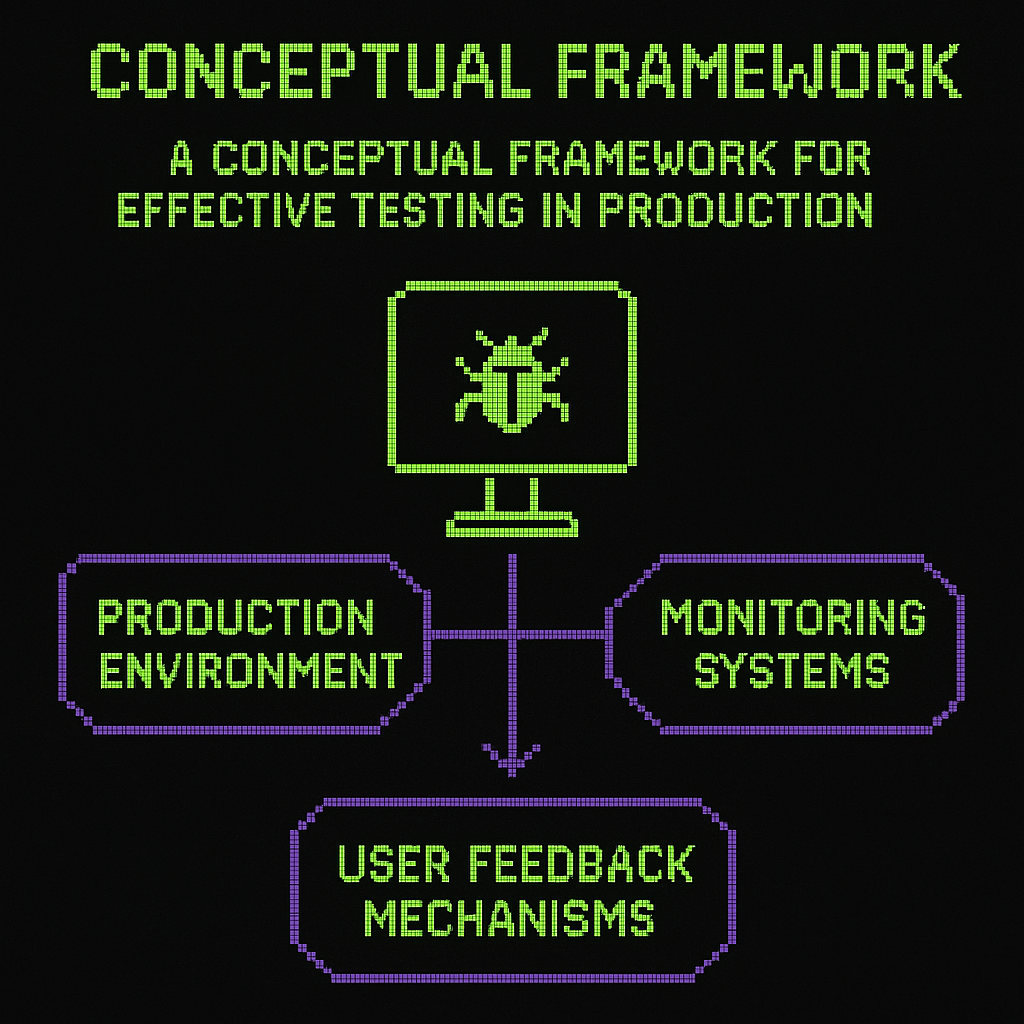
Et konseptuelt rammeverk for effektiv testing i produksjon
Utover praktisk infrastruktur krever vellykket TIP en grunnleggende endring i hvordan man tenker om å oppdage og håndtere problemer.
Å overvinne den «empiriske feilslutningen» i produksjonstesting
Hva er den empiriske feilslutningen?
Den empiriske feilslutningen i TIP er troen på at du må:
- Være vitne til at et problem oppstår i sanntid
- Se hele problemet utfolde seg med egne øyne
- Oppleve hele feilen for å kunne diagnostisere den
«Vel, jeg kan ikke se at det skjer rett foran meg, så jeg vet ikke hvordan jeg skal diagnostisere det.»
Denne tilnærmingen til TIP er:
- Irrasjonell – Vi krever ikke at kriminaletterforskere er vitne til drap for å oppklare dem
- Ueffektiv – Å vente på at problemer skal manifestere seg fullt ut, sløser med tid og ressurser
- Unødvendig – Dyktige ingeniører kan forutsi potensielle feilsteder
En arkitektur-først-tilnærming til testing i produksjon
Viktig innsikt: Systemiske problemer er nesten alltid arkitekturproblemer.
Denne erkjennelsen endrer hvordan vi tilnærmer oss TIP:
- Prioriter arkitekturtesting fra begynnelsen av prosjektet
- Start med belastnings- og ytelsestesting tidlig i utviklingen
- Identifiser potensielle flaskehalser før de blir fastlåste
- Test kjernekomponenter i produksjon før funksjonen er ferdigstilt
Utfordringer ved tradisjonelle utviklingsmetoder
Denne arkitektur-først-tilnærmingen til TIP krever at man tenker nytt om:
- Smidige metoder – Systemiske egenskaper kan ikke alltid deles inn i sprinter
- Prioritering av funksjoner – Kjernearkitekturen må ha forrang
- Testplaner – Produksjonstesting må begynne tidligere
- Ressursfordeling – Større investering på forhånd i testmiljøer
Relatert lesning: AGIL TESTINGSMETODIKK: HVORFOR DEN FUNGERER, OG HVORDAN DEN IMPLEMENTERES
Samarbeidsbasert forutsigelse: En bedre vei til testing i produksjon
Den mest effektive TIP-strategien kombinerer:
Teknisk innsikt:
- Arkitekter identifiserer potensielle svake punkter
- Utviklere fremhever risikable samspill mellom komponenter
- Systemdesignere kartlegger potensielle flaskehalser
Målrettet QA-testing:
- Bygg fokuserte testscenarioer for forutsagte problemer
- Utform stresstester for spesifikke arkitekturkomponenter
- Opprett kontrollerte eksperimenter for produksjonsmiljøer
Denne samarbeidsbaserte tilnærmingen innebærer at:
- Problemer oppstår i isolerte, diagnostiserbare kontekster
- Problemer oppdages før de påvirker kundene
- Reparasjoner kan implementeres metodisk, ikke i krisemodus
Den trinnvise veien til testing i produksjon
Testing i produksjon bør ikke være en binær, alt-eller-ingenting-hendelse som:
- Å slå på en lysbryter i et mørkt rom
- Å gå fra null til full eksponering umiddelbart
- Korte perioder med høy risiko mot slutten av prosjektet
I stedet bør testing i produksjon implementeres som:
- En gradvis tilnærming i flere faser
- Gradvis tilnærming til fullstendige produksjonsforhold
- Kontinuerlig risikoreduksjon gjennom målrettet eksponering
Funksjonsflagg: Grunnlaget for trygg testing i produksjon
Funksjonsflagg står sentralt i moderne strategier for testing i produksjon. De er en avgjørende mekanisme som endrer hvordan team validerer programvare i levende miljøer.
Hva er funksjonsflagg?
Funksjonsflagg (også kalt funksjonsbrytere) er en programvareutviklingsteknikk som gjør det mulig for team å:
- Distribuere kode uten eksponering – Frigi ny funksjonalitet til produksjon samtidig som den holdes usynlig for brukerne
- Kontrollere funksjonalitet eksternt – Aktivere eller deaktivere funksjoner uten å distribuere ny kode
- Målrette bestemte segmenter – Eksponere funksjoner for utvalgte brukergrupper for testing i produksjon
Som definert av bransjeeksperter: «Et funksjonsflagg er en programvareutviklingsprosess som brukes til å aktivere eller deaktivere funksjonalitet uten å distribuere kode. Du kan pakke inn en funksjon i et flagg for å distribuere den til produksjon uten å gjøre den synlig for alle brukere.»
Hvordan funksjonsflagg endrer testing i produksjon
Funksjonsflagg endrer i grunnleggende grad risikoprofilen til TIP ved å:
- Koble distribusjon fra lansering – Kode går inn i produksjon i en inaktiv tilstand
- Gi mulighet for umiddelbar tilbakeføring – Problemer kan utbedres uten nye distribusjoner
- Opprette kontrollerte testmiljøer – Reelle produksjonsforhold med begrenset eksponering
Disse funksjonene løser det grunnleggende dilemmaet ved TIP som ble omtalt tidligere – de gir fordelene ved testing i produksjon samtidig som de tilknyttede risikoene reduseres betydelig.
Implementering av gradvise utrullinger i produksjon
En av de mest effektive bruksområdene for funksjonsflagg i TIP er den gradvise utrullingen:
Eksempel på implementering:
- Dag 1: Aktiver den nye funksjonen for 1 % av brukerne
- Dag 3: Hvis målingene forblir stabile, øk til 5 %
- Dag 7: Hvis ytelsen er positiv, utvid til 25 %
- Dag 14: Full utrulling hvis ingen problemer er oppdaget
«Et praktisk eksempel på testing i produksjon er å bruke funksjonsflagg for en gradvis utrulling. Tenk på en netthandelsbedrift som introduserer en ny anbefalingsalgoritme på produktsidene sine. I stedet for å distribuere den til alle brukere samtidig bruker de et funksjonsflagg til å aktivere den nye algoritmen for bare 5 % av trafikken i første omgang.»
Denne tilnærmingen gjør det mulig for team å oppdage problemer som påvirker en liten del av brukerne, før de påvirker hele brukerbasen.
A/B-testing i produksjonsmiljøer
Funksjonsflagg muliggjør avanserte eksperimenter direkte i produksjon:
- Sammenligne implementeringer – Test flere versjoner av en funksjon med ulike brukersegmenter
- Ta datadrevne beslutninger – Basere valg på ytelsesmålinger fra virkeligheten
- Validere brukeropplevelsen – Fastslå hvilken versjon som gir bedre resultater
Som bransjekilder påpeker: «Verktøy for funksjonsflagg har også den ekstra fordelen at de muliggjør A/B-testing, der den nye funksjonen sammenlignes med den forrige versjonen av programvaren for å se hvilken som gir en bedre brukeropplevelse basert på produksjonsdata.»
Integrering av funksjonsflagg med overvåkingssystemer
Det fulle potensialet til funksjonsflagg for TIP realiseres gjennom integrering med overvåking:
Viktige fordeler ved integrering:
- Automatisert oppdagelse av problemer – Korreler funksjonsaktiveringer med ytelsesmålinger
- Rask håndtering av hendelser – Identifiser og deaktiver problematiske funksjoner raskt
- Kontinuerlig validering – Overvåk funksjonens påvirkning gjennom hele utrullingsprosessen
Når problemer med systemytelsen registreres i overvåkingsverktøy, kan team raskt finne og deaktivere (det vil si utløse en avstengningsbryter) funksjonen som forårsaker hendelsen, noe som gir et sikkerhetsnett som gjør TIP betydelig tryggere.
Funksjonsflagg i en arkitektur-først-teststrategi
For å maksimere verdien av funksjonsflagg ved TIP:
- Merk arkitekturkomponenter - Gjør det mulig å teste sentrale systemelementer
- Opprett funksjonshierarkier - Etabler overordnede og underordnede relasjoner mellom flagg
- Definer kretsbrytere - Angi terskler for automatisk deaktivering
- Dokumenter avhengigheter - Kartlegg samspillet mellom komponenter med flagg
- Planlegg opprydding - Etabler prosesser for fjerning av utdaterte flagg
Denne tilnærmingen støtter arkitektur-først-testmetodikken som er beskrevet tidligere, ved at team trygt kan teste grunnleggende systemkomponenter i produksjon tidlig i utviklingssyklusen.
Plattformer for funksjonsstyring: Forvandler testing i produksjon
Moderne TIP-strategier krever verktøy som kontrollerer risiko samtidig som de muliggjør validering i virkelige forhold. Plattformer for funksjonsstyring har blitt viktige komponenter i effektive testmiljøer.
Slik forbedrer funksjonsstyring testing i produksjon
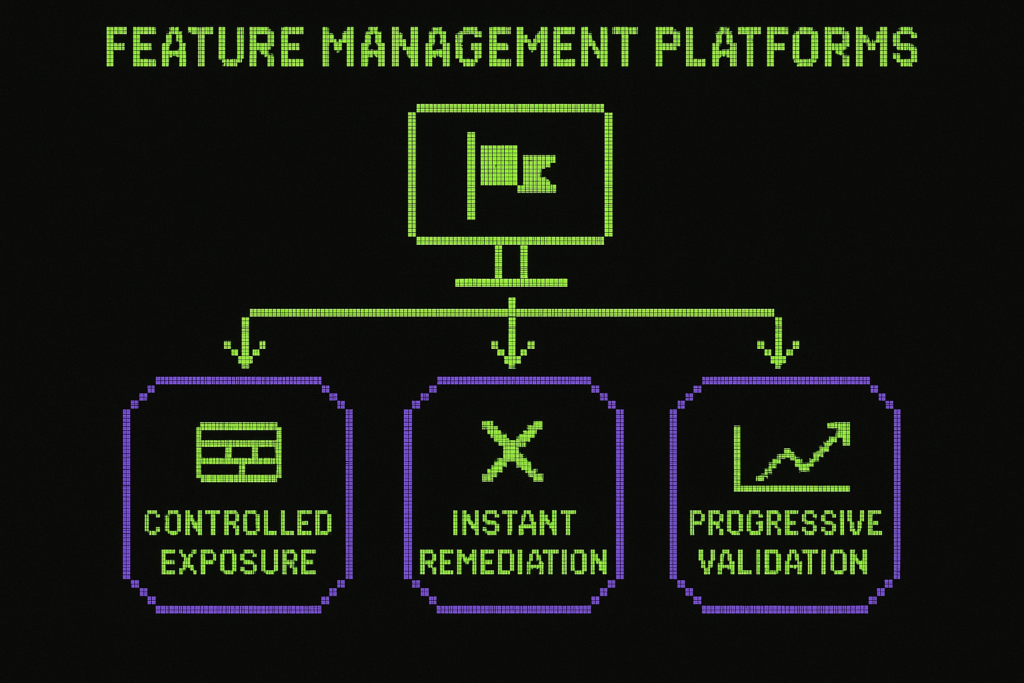
Plattformer for funksjonsstyring gir infrastrukturen som trengs for trygg og kontinuerlig TIP:
- Kontrollert eksponering - Test med bestemte brukersegmenter i stedet for utrullinger som gjelder alt eller ingenting
- Umiddelbar utbedring - Deaktiver problematiske funksjoner uten å distribuere kode
- Gradvis validering - Øk eksponeringen gradvis basert på ytelsesdata
Disse egenskapene forvandler testing i produksjon fra en høyrisikoaktivitet til en kontrollert og metodisk prosess.
Funksjonsflagg: Grunnlaget for testing i produksjon
Som nevnt, er funksjonsflagg (noen ganger kalt funksjonsbrytere) kjernen i disse plattformene. De gjør det mulig for team å:
- Distribuere kode til produksjon samtidig som den holdes usynlig for de fleste brukere
- Aktivere eller deaktivere funksjonalitet uten nye utrullinger
- Teste i produksjon med minimal risiko for virksomhetens drift
Fordel ved implementering i praksis: "LaunchDarklys plattform for funksjonsstyring gir team en sømløs måte med lav risiko til å teste programvareendringer i produksjon med høy frekvens og i stor skala," noe som muliggjør den kontinuerlige testtilnærmingen.
Kritisk integrasjon: Observerbarhet + funksjonsstyring
De mest effektive TIP-implementeringene kobler funksjonsstyring sammen med verktøy for observerbarhet:
- Korrelasjon i sanntid - Koble aktivering av funksjoner til ytelsesmålinger
- Automatiserte sikkerhetstiltak - Utløs deaktivering av funksjoner når ytelsen forringes
- Analyse av rotårsak - Identifiser raskt hvilke funksjoner som påvirker systemstabiliteten
Denne integrasjonen skaper et sikkerhetsnett som reduserer risikoene ved TIP betydelig, samtidig som fordelene maksimeres.
Suksess i den virkelige verden med plattformer for testing i produksjon
Organisasjoner på tvers av bransjer har forvandlet TIP-tilnærmingen sin ved hjelp av funksjonsstyring:
IBM, TrueCar og O'Reilly Media har implementert plattformer for funksjonsstyring for å muliggjøre kontinuerlig testing i produksjon med minimal risiko.
Som Chris Guidry, teknologidirektør hos O'Reilly Media, forklarer:
"[Ingeniørene våre] kan teste funksjoner i produksjon lenge før en markedsføringslansering. Og hvis en funksjon forårsaker problemer på lanseringsdagen, kan vi ganske enkelt slå den av med en avstengningsbryter – ingen tilbakerullinger. LaunchDarkly gjør utrullingene våre kjedelige. Det er akkurat det vi ønsker."
Implementeringsstrategi
For å utnytte plattformer for funksjonsstyring effektivt til testing i produksjon:
- Start med kjernearkitekturen – Identifiser grunnleggende komponenter først
- Opprett trinnvise utrullingsplaner – Definer eksponeringsprosenter og utløsere
- Fastsett overvåkingsterskler – Angi tydelige måleverdier for suksess og feil
- Dokumenter avhengigheter – Kartlegg forholdet mellom funksjoner med flagg
- Implementer effektbrytere – Konfigurer automatisk deaktivering ved kritiske problemer
Denne systematiske tilnærmingen muliggjør den arkitektur-først-baserte TIP-strategien som ble anbefalt tidligere, samtidig som den gir sikkerhetsmekanismene som trengs for å gjøre den praktisk.
Kombinere funksjonsstyring med trinnvise testmiljøer
For optimale TIP-resultater bør du integrere plattformer for funksjonsstyring med tilnærmingen med nivådelte testmiljøer:
- Bruk funksjonsflagg i tidlige testmiljøer for å validere kjerneideer
- Oppretthold en konsekvent flaggkonfigurasjon på tvers av miljøer
- Øk gradvis eksponeringen for reelle brukere i produksjon
- Utnytt automatisert overvåking for å ivareta sikkerheten
Denne kombinerte tilnærmingen gir fordelene ved tidlig TIP, samtidig som den opprettholder den kontrollerte og gradvise risikoreduksjonen som er avgjørende for vellykket levering.
Verktøy for testing i produksjon: Implementeringsutfordringer
Selv om funksjonsflagg og styringsplattformer danner grunnlaget for TIP, medfører det egne utfordringer å velge og implementere de riktige støtteverktøyene.
Det er avgjørende å forstå disse utfordringene for å kunne utforme en effektiv strategi for testing i produksjon.
More Articles
Verktøy for overvåking og observerbarhet
Omfattende oversikt er avgjørende ved TIP, men valg av verktøy krever en grundig vurdering:
Overvåking av applikasjonsytelse (APM):
- Fordeler: Detaljert innsikt i ytelsen på tvers av tjenestegrenser
- Utfordringer: Kan generere overveldende datamengder og krever betydelig konfigurasjon
- Vurdering ved implementering: "Et kraftig overvåkingsverktøy med omfattende innsikt, men det krever oppsett og løpende finjustering for å unngå dataoverbelastning."
Løsninger for distribuert sporing:
- Fordeler: Spor forespørsler på tvers av mikrotjenester og identifiser flaskehalser
- Utfordringer: Krever instrumentering på tvers av alle tjenester og kan påvirke ytelsen
- Vurdering ved implementering: "Effektivt for å spore ytelsesproblemer, men komplisert å sette opp for mindre team."
Plattformer for logganalyse:
- Fordeler: Gir detaljert diagnostisk informasjon og støtter rettsmedisinsk analyse
- Utfordringer: Lagringskostnadene kan øke raskt og krever en strukturert tilnærming til logging
- Vurdering ved implementering: "Verdifullt for feilsøking av komplekse problemer i produksjon, men krever en helhetlig loggestrategi for å unngå informasjonsoverbelastning."
Systemer for varslingshåndtering
Riktig varsling er avgjørende ved testing av nye funksjoner i produksjon:
Plattformer for hendelseshåndtering:
- Fordeler: Effektiviserer kommunikasjonen under hendelser og automatiserer innledende tiltak
- Utfordringer: Krever nøye konfigurasjon av terskler og integrasjon med flere systemer
- Vurdering ved implementering: "Flott for hendelseshåndtering, men kan være forstyrrende hvis det ikke konfigureres nøye for å unngå varslingsutmattelse."
Verktøy for syntetisk overvåking:
- Fordeler: Validerer kontinuerlig kritiske baner og oppdager problemer før brukerne gjør det
- Utfordringer: Begrenset til forhåndsdefinerte scenarier og kan overse problemer med den reelle brukeropplevelsen
- Vurdering ved implementering: "Gir konsekvent validering mot en grunnlinje, men må suppleres med overvåking av reelle brukere for en helhetlig TIP."
Balansering av verktøykompleksitet og teamets kapasitet
Ta hensyn til følgende ved implementering av verktøy for TIP:
- Teamets ekspertise - Har dere ferdighetene som trengs for å maksimere verktøyets verdi?
- Integrasjonskrav - Hvor godt kobler det seg til de eksisterende systemene deres?
- Driftsmessig overhead - Hvilket løpende vedlikehold krever verktøyet?
- Skalerbarhet - Vil det håndtere produksjonsvolumene og veksten deres?
- Signal-til-støy-forhold - Kan dere hente ut meningsfull innsikt uten å drukne i data?
Fallgruver ved implementering av verktøy i produksjonstesting
Teamene møter ofte disse utfordringene når de tar i bruk testverktøy i produksjon:
- Overvåkingsmangler - Kritiske komponenter som ikke er instrumentert
- Varslingstretthet - For mange varsler fører til at team ignorerer advarsler
- Manglende kontekst - Varsler uten handlingsrettet informasjon
- Datasiloer - Verktøy som ikke deler informasjon på tvers av plattformer
- Ytelsespåvirkning - Overvåkingsverktøy som forringer systemet de måler
Beste praksis for implementering av testverktøy i produksjon
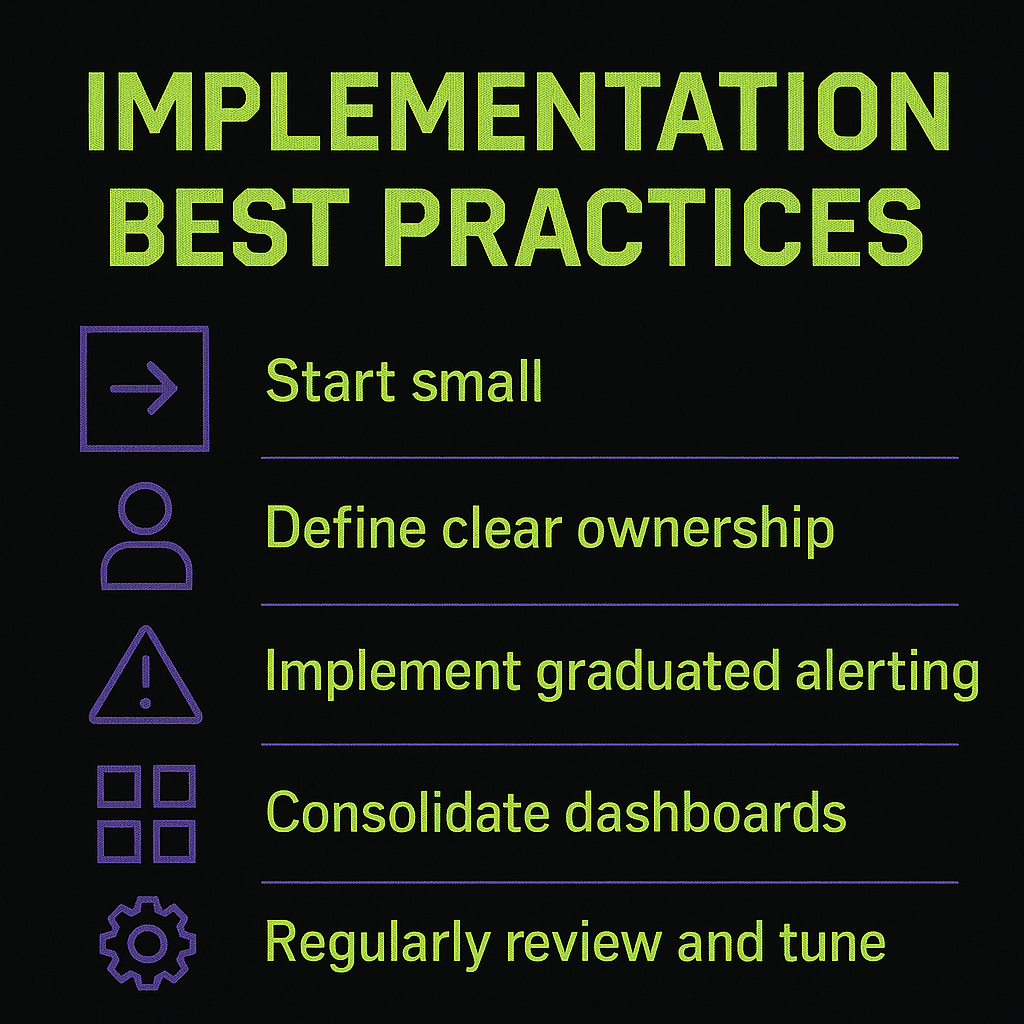
For å maksimere effektiviteten og samtidig minimere utfordringene:
- Start i det små - Begynn med sentrale brukerreiser og kritiske tjenester
- Definer tydelig eierskap - Fastslå hvem som svarer på ulike typer varsler
- Implementer trinnvis varsling - Opprett varslingsterskler før kritiske nivåer
- Konsolider dashbordene - Opprett enhetlige visninger som sammenstiller data på tvers av verktøy
- Gå regelmessig gjennom og finjuster - Juster tersklene basert på faktiske produksjonsmønstre
Den rette balansen mellom verktøy muliggjør effektiv TIP samtidig som den gir sikkerhetsnettet som trengs for å minimere risiko. Velg verktøy som samsvarer med teamets kapasitet, og integrer dem på en gjennomtenkt måte i testtilnærmingen.
Avsluttende tanker om testing i produksjon
De mest vellykkede TIP-strategiene følger disse prinsippene:
- Start tidlig - Ikke vent til slutten av utviklingen
- Test trinnvis - Bruk en rekke stadig mer komplekse miljøer
- Tenk forutseende - Ikke bare reager på problemer, men forutse dem
- Samarbeid på tvers av funksjoner - Utvikling og QA må samarbeide
- Reduser risiko systematisk - Hver testfase bør bygge tillit
TIP er viktig, men trenger ikke å være farlig. Ved å kombinere praktiske forbedringer av miljøet med konseptuelle endringer i hvordan vi tilnærmer oss testing, kan testing i produksjon gå fra å være et nødvendig onde til å bli en kontinuerlig og verdifull praksis.
Husk: Programvareutgivelser er produktleveranser, ikke måneferder. Gradvis risikoreduksjon gjennom smart testing i produksjon gir langt bedre resultater enn dramatiske sprang ut i det ukjente i de siste timene.
Synes du denne tilnærmingen til testing i produksjon er verdifull? Hvis du vil ha mer innsikt fra eksperter på QA og testing, kan du abonnere på CTO Club-nyhetsbrevet.



