

Databricks mot Cloudera: Sammenligning og vurderinger for 2026
Valget mellom Databricks og Cloudera avhenger av hvordan teamet ditt håndterer data på tvers av sky- og hybridmiljøer. Jeg sammenligner styrkene, avveiningene og de best egnede bruksområdene deres.

We review tools independently, and commissions help fund our testing. See our transparency policy, our methodology, or suggest a tool.
As data environments spread across cloud, on-premises systems, and multiple pipelines, keeping ingestion and transformation workflows consistent gets harder. The right DataOps tool should help teams manage that complexity without creating more operational overhead.
Databricks and Cloudera both support large-scale data engineering and analytics, but they solve the problem from different starting points. Databricks centers on a lakehouse model with managed pipelines, streaming, governance, and AI, while Cloudera emphasizes hybrid data operations across cloud, data center, and edge environments.
In this article, I compare Databricks and Cloudera across features, pricing, security, ease of use, and best-fit scenarios to help you decide which platform suits your data strategy and infrastructure.
Databricks
4.5/5
- Free edition available + 14-day free trial
- From $0.15/DBU
Cloudera
4.1/5
- 60-day free trial
- From $0.04/CCU/hour
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

| Databricks | Cloudera | |
|---|---|---|
| Free Trial | Free edition available + 14-day free trial | 60-day free trial |
| Pricing | From $0.15/DBU | From $0.04/CCU/hour |
Priser og skjulte kostnader for Databricks vs. Cloudera
Databricks bruker forbruksbasert prising på tvers av datateknikk, datavarehus, kunstig intelligens og andre arbeidsbelastninger, der kostnadene påvirkes av databehandlingsbruk samt skyinfrastruktur, lagring, nettverk og kundestøtte. Cloudera har en hybrid tilnærming: Skytjenestene faktureres etter forbruk gjennom Cloudera Compute Units (CCU-er), mens lokale distribusjoner bruker årsabonnementer. I begge tilfeller kan infrastruktur og nettverk øke totalkostnaden utover de grunnleggende plattformavgiftene.
Når du sammenligner de to, er det nyttig å se forbi den oppgitte prisen og kartlegge hvor arbeidsbelastningene dine skal kjøre, samt hvor ofte datapipelines, strømmende jobber og transformasjoner utføres. Med Databricks kan ineffektiv eller langvarig databehandling og dataoverføring øke kostnadene. Cloudera kan på sin side medføre kostnader gjennom infrastruktur, nettverk, Private Link, overvåking og tjenester som Data Flow eller Lakehouse Optimizer. Hvis du tar distribusjonsmodell, arbeidsbelastningsvolum, kundestøtte og skaleringsbehov med i beregningen, får du et mer realistisk bilde av de langsiktige kostnadene.
\u003cdiv class=\u0022slate-p slate-selectable\u0022 data-slate-node=\u0022element\u0022 data-block-id=\u0022PT4C8rs7CH\u0022\u003e\u003cspan data-slate-node=\u0022text\u0022\u003eBegge Databricks og Cloudera støtter storskala datateknikk, satsvise og strømmende datapipelines, analyse, maskinlæring og styrt datatilgang. De baserer seg også på åpne teknologier som Apache Spark og lakehouse-arkitekturer for å støtte ulike databelastninger.\u003c/span\u003e\u003c/div\u003e
\u003cdiv class=\u0022slate-p slate-selectable\u0022 data-slate-node=\u0022element\u0022 data-block-id=\u0022bLbhN0ysYm\u0022 data-slate-fragment=\u0022JTVCJTdCJTIyY2hpbGRyZW4lMjIlM0ElNUIlN0IlMjJ0ZXh0JTIyJTNBJTIyQm90aCUyMERhdGFicmlja3MlMjBhbmQlMjBDbG91ZGVyYSUyMHN1cHBvcnQlMjBsYXJnZS1zY2FsZSUyMGRhdGElMjBlbmdpbmVlcmluZyUyQyUyMGJhdGNoJTIwYW5kJTIwc3RyZWFtaW5nJTIwcGlwZWxpbmVzJTJDJTIwYW5hbHl0aWNzJTJDJTIwbWFjaGluZSUyMGxlYXJuaW5nJTJDJTIwYW5kJTIwZ292ZXJuZWQlMjBkYXRhJTIwYWNjZXNzLiUyMFRoZXklMjBhbHNvJTIwcmVseSUyMG9uJTIwb3BlbiUyMHRlY2hub2xvZ2llcyUyMHN1Y2glMjBhcyUyMEFwYWNoZSUyMFNwYXJrJTIwYW5kJTIwbGFrZWhvdXNlJTIwYXJjaGl0ZWN0dXJlcyUyMHRvJTIwc3VwcG9ydCUyMHZhcmllZCUyMGRhdGElMjB3b3JrbG9hZHMuJTIyJTdEJTVEJTJDJTIydHlwZSUyMiUzQSUyMnAlMjIlMkMlMjJpZCUyMiUzQSUyMlBUNEM4cnM3Q0glMjIlN0QlMkMlN0IlMjJjaGlsZHJlbiUyMiUzQSU1QiU3QiUyMnRleHQlMjIlM0ElMjJXaGVyZSUyMHRoZXklMjBkaWZmZXIlMjBpcyUyMGluJTIwaG93JTIwdGhvc2UlMjBjYXBhYmlsaXRpZXMlMjBhcmUlMjBkZWxpdmVyZWQuJTIwRGF0YWJyaWNrcyUyMGJyaW5ncyUyMGluZ2VzdGlvbiUyQyUyMHRyYW5zZm9ybWF0aW9uJTJDJTIwb3JjaGVzdHJhdGlvbiUyQyUyMGFuYWx5dGljcyUyQyUyME1MJTJDJTIwYW5kJTIwZ292ZXJuYW5jZSUyMHRvZ2V0aGVyJTIwdGhyb3VnaCUyMExha2VmbG93JTJDJTIwRGVsdGElMjBMYWtlJTJDJTIwTUxmbG93JTJDJTIwVW5pdHklMjBDYXRhbG9nJTJDJTIwYW5kJTIwaXRzJTIwRGF0YSUyMEludGVsbGlnZW5jZSUyMEVuZ2luZSUyQyUyMHdoaWxlJTIwY29sbGFib3JhdGl2ZSUyMG5vdGVib29rcyUyMGFuZCUyMG1hbmFnZWQlMjBjb21wdXRlJTIwc3VwcG9ydCUyMGRheS10by1kYXklMjBkZXZlbG9wbWVudC4lMjBCeSUyMGNvbnRyYXN0JTJDJTIwQ2xvdWRlcmElMjBlbXBoYXNpemVzJTIwaHlicmlkJTIwZGVwbG95bWVudCUyMGFjcm9zcyUyMGNsb3VkJTIwYW5kJTIwb24tcHJlbWlzZXMlMjBlbnZpcm9ubWVudHMlMkMlMjB1c2luZyUyMEFwYWNoZSUyME5pRmklMkMlMjBBaXJmbG93JTJDJTIwSWNlYmVyZyUyQyUyMFJhbmdlciUyQyUyMGFuZCUyMEF0bGFzJTIwdG8lMjBtYW5hZ2UlMjBwaXBlbGluZXMlMkMlMjBnb3Zlcm5hbmNlJTJDJTIwYW5kJTIwYW5hbHl0aWNzJTIwYWNyb3NzJTIwZGlzdHJpYnV0ZWQlMjBpbmZyYXN0cnVjdHVyZS4lMjIlN0QlNUQlMkMlMjJ0eXBlJTIyJTNBJTIycCUyMiUyQyUyMmlkJTIyJTNBJTIyYkxiaE4weXNZbSUyMiU3RCU1RA==\u0022\u003e\u003cspan data-slate-node=\u0022text\u0022\u003eForskjellen ligger i hvordan disse funksjonene leveres. Databricks samler inntak, transformasjon, orkestrering, analyse, ML og styring gjennom Lakeflow, Delta Lake, MLflow, Unity Catalog og Data Intelligence Engine, mens samarbeidende notatbøker og administrert databehandling støtter den daglige utviklingen. Cloudera legger derimot vekt på hybrid distribusjon på tvers av sky- og lokale miljøer, og bruker Apache NiFi, Airflow, Iceberg, Ranger og Atlas til å administrere pipelines, styring og analyse på tvers av distribuert infrastruktur.\u003c/span\u003e\u003c/div\u003e
| Databricks | Cloudera | |
|---|---|---|
| A/B Testing | No | No |
| Analytics | Yes | Yes |
| API | Yes | Yes |
| Conversion Tracking | No | No |
| Custom Reports | Yes | Yes |
| Dashboards | Yes | Yes |
| Data Export | Yes | Yes |
| Data Import | Yes | Yes |
| Data Mining | Yes | Yes |
| Data Visualization | Yes | Yes |
| External Integrations | Yes | Yes |
| Forecasting | Yes | Yes |
| Keyword Tracking | No | No |
| Link Tracking | No | No |
| Multi-User | Yes | Yes |
| Notifications | Yes | Yes |
| Reports | Yes | Yes |
| Scenario Planning | No | No |
| SEO | No | No |
| Visualization | Yes | Yes |
| Integrasjon | Databricks | Cloudera |
|---|---|---|
| IntegrasjonMicrosoft Azure | Databricks✅ | Cloudera✅ |
| IntegrasjonAmazon Web Services | Databricks✅ | Cloudera✅ |
| IntegrasjonGoogle Cloud Platform | Databricks✅ | Cloudera✅ |
| IntegrasjonTableau | Databricks✅ | Cloudera✅ |
| IntegrasjonInformatica | Databricks✅ | Cloudera✅ |
| IntegrasjonSalesforce | Databricks✅ | Cloudera✅ |
| IntegrasjonQlik | Databricks✅ | Cloudera✅ |
| IntegrasjonOracle Database | Databricks✅ | Cloudera✅ |
| IntegrasjonMongoDB | Databricks✅ | Cloudera✅ |
| IntegrasjonAPI | Databricks✅ | Cloudera✅ |
| IntegrasjonZapier | Databricks✅ | Cloudera❌ |
Både Databricks og Cloudera støtter brede økosystemer på tvers av skyplattformer, databaser, BI-verktøy, API-er og datatjenester. Databricks knytter disse forbindelsene til Lakeflow, Partner Connect og sine administrerte arbeidsflyter for datateknikk, mens Cloudera legger vekt på tilkobling på tvers av sky-, lokale og hybride miljøer.
| Faktor | Databricks | Cloudera |
|---|---|---|
| FaktorKryptering | DatabricksKrypterer data i hvile og under overføring, med støtte for kundeadministrerte nøkler, skybasert nøkkeladministrasjon og detaljert beskyttelse på tvers av styrte data- og KI-ressurser. | ClouderaStøtter kryptering i hvile og under overføring, nøkkeladministrasjon og sikkerhetskontroller på tvers av sky- og lokale miljøer. |
| FaktorTilgangskontroller | DatabricksUnity Catalog sentraliserer detaljerte tilgangsregler på tvers av data, modeller, applikasjoner og KI-ressurser, med SSO, identitetsintegrasjoner, rad- og kolonnebaserte kontroller samt arbeidsområdetilknytninger. | ClouderaBruker Apache Ranger, Knox og identitetsintegrasjoner til å administrere autentisering, autorisering, SSO og detaljert tilgang på tvers av hybride miljøer. |
| FaktorSamsvar med regelverk | DatabricksHar sertifiseringene SOC 1 Type II, SOC 2 Type II, ISO 27001, ISO 27017 og ISO 27018, med støtte for samsvar med HIPAA, PCI DSS, HITRUST og FedRAMP Moderate og High, avhengig av sky, region og konfigurasjon. | ClouderaOpprettholder sertifiseringer og programmer, inkludert SOC 2 Type II, ISO 27001, PCI DSS og FedRAMP Moderate for kvalifiserte Cloudera-miljøer. |
| FaktorPålitelighet | DatabricksStøtter automatisk skalering, serverløs og administrert databehandling, arbeidsbelastningsisolering og skybasert tilgjengelighet på tvers av AWS, Azure og Google Cloud, med gjenopprettingsstrategier konfigurert etter arbeidsbelastningenes krav. | ClouderaStøtter distribusjoner over flere soner, redundant infrastruktur, automatisk overtakelse og katastrofegjenoppretting på tvers av sky- og hybride distribusjoner. |
| FaktorDatastyring | DatabricksUnity Catalog tilbyr sentralisert revisjon, søk, klassifisering og automatisert dataopprinnelse fra kildedata gjennom notatbøker, jobber, modeller, tjenester og dashbord. | ClouderaSDX kombinerer Apache Ranger og Atlas for å håndheve regler, revisjon, metadatabehandling, klassifisering og dataopprinnelse på tvers av skybaserte og lokale data. |
Begge plattformene tilbyr sikkerhet og styring på bedriftsnivå, men har ulikt fokus. Databricks samler tilgangskontroll, revisjon, klassifisering og dataopprinnelse gjennom Unity Catalog på tvers av data- og KI-arbeidsbelastninger, mens Cloudera utvider sentralisert styring på tvers av hybride og lokale miljøer gjennom SDX, Ranger og Atlas.
| Faktor | Databricks | Cloudera |
|---|---|---|
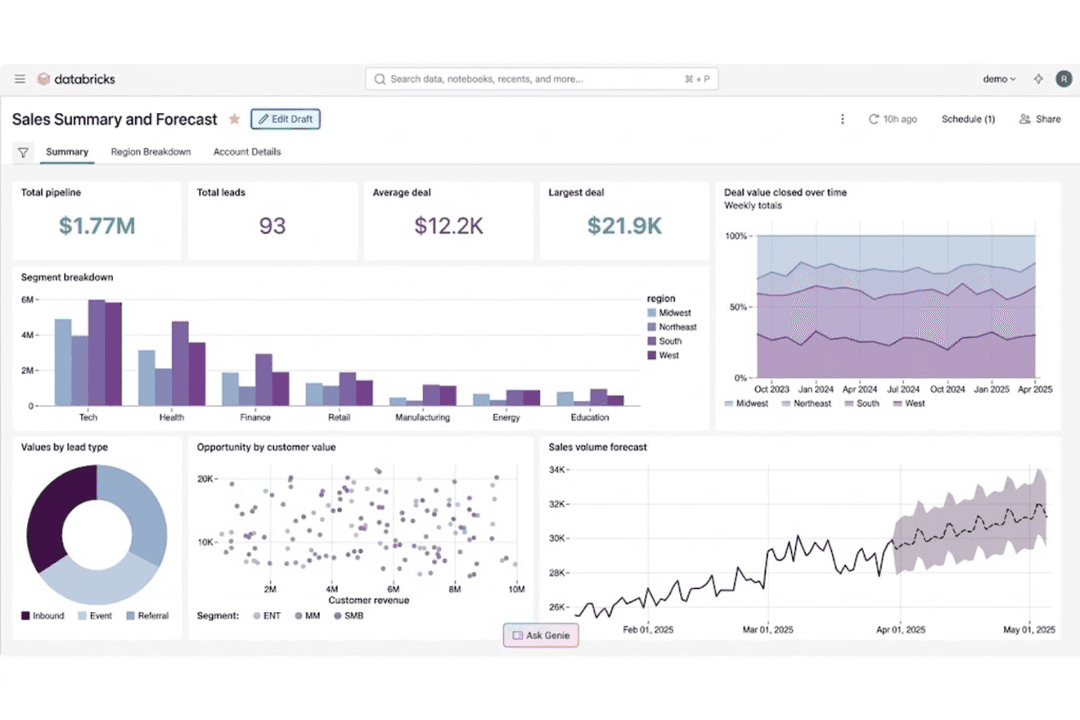
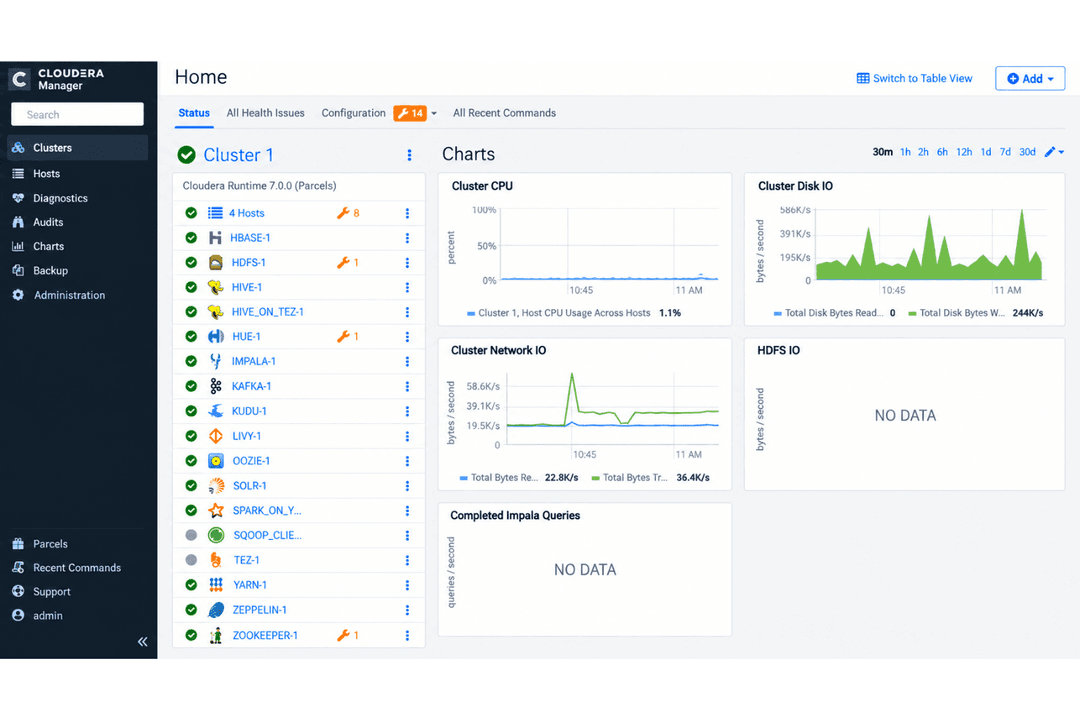
| FaktorBrukergrensesnitt | DatabricksKombinerer samarbeidsbaserte notatbøker, SQL-verktøy, dashbord og visuelle arbeidsflyter i ett arbeidsområde for teknikk-, analyse- og KI-team. | ClouderaBruker administrasjonskonsoller og tjenestespesifikke grensesnitt for administrasjon av data og hybrid infrastruktur. |
| FaktorKonfigurasjonsprosess | DatabricksSkybaserte arbeidsområder kan klargjøres raskt, mens serverløs og administrert databehandling reduserer behovet for infrastrukturkonfigurasjon ved vanlige arbeidsbelastninger. | ClouderaKonfigurasjonen avhenger av distribusjonsmodellen, med ytterligere konfigurasjon for hybride og lokale miljøer. |
| FaktorInnføring | DatabricksTilbyr veiledet oppsett, eksempelnotatbøker, opplæring og administrerte tjenester som hjelper team med å gå fra innledende eksperimentering til styrte arbeidsflyter i produksjon. | ClouderaKrever kjennskap til det bredere økosystemet, særlig når team arbeider på tvers av teknologier som NiFi, Spark, Ranger og hybrid infrastruktur. |
| FaktorDokumentasjon | DatabricksTilbyr omfattende dokumentasjon, veiledninger, implementeringsveiledning og opplæring innen datateknikk, styring, analyse og KI. | ClouderaTilbyr teknisk dokumentasjon for sky, lokale miljøer, sikkerhet og plattformadministrasjon. |
| FaktorTilgang til kundestøtte | DatabricksTilbyr offentlige ressurser og trinnvis betalt kundestøtte med tekniske kontaktpersoner, eskaleringsveier og dekning av kritiske problemer for bedriftsdistribusjoner. | ClouderaOmfatter kundestøtte på bedriftsnivå og tekniske ressurser på tvers av skybaserte og lokale tilbud. |
Sett fra et brukervennlighetsperspektiv kombinerer Databricks et teknisk utviklingsmiljø med administrerte tjenester som reduserer infrastrukturarbeidet på tvers av datapipelines, analyse og KI. Cloudera støtter skybaserte, lokale og hybride miljøer, noe som medfører flere hensyn ved distribusjon. For datateam med fokus på skyen tilbyr Databricks en helhetlig arbeidsflyt fra utvikling til produksjon, mens Cloudera passer for organisasjoner som trenger å operere på tvers av blandet infrastruktur.
Databricks
- Unifies data engineering, analytics, governance, and AI workloads, reducing the need to maintain separate platforms and duplicate data
- Built on open technologies like Delta Lake and Apache Spark, giving teams more flexibility and portability than proprietary data formats
- Unity Catalog applies governance and access policies consistently across data and workloads, which is useful for complex or multi-cloud environments
- Usage-based pricing can become difficult to predict as workloads grow, especially without careful compute and query optimization
- Requires strong technical expertise in areas like SQL, Python, Spark, and data engineering to get full value from the platform
- Can be excessive for teams with simple reporting or low-volume analytics needs, where the platform’s complexity may outweigh the benefits
Cloudera
- Handles petabyte-scale datasets with strong data governance tools
- Flexible deployment across on-premises, private, and public clouds
- Open-source architecture with full control over data location
- Interface is complex for smaller or less technical teams
- Initial setup and onboarding can be time-consuming
- Performance tuning requires deep technical expertise
Databricks
- Large EnterprisesOrganizations with multiple data teams and high-volume workloads can use Databricks to centralize data engineering, analytics, governance, and AI while reducing duplicated data and tooling.
- Financial ServicesBanks, insurers, and other financial organizations can use Databricks for governed analytics, fraud detection, risk modeling, and machine learning across sensitive datasets.
- Healthcare and Life SciencesHealthcare and life sciences teams can manage large, sensitive datasets while applying centralized governance to analytics, research, and AI workloads.
- Retail and Consumer GoodsRetailers can combine customer, transaction, inventory, and operational data for forecasting, personalization, supply chain analytics, and machine learning.
- ManufacturingManufacturers can bring together operational, IoT, and enterprise data for predictive maintenance, production analytics, forecasting, and AI-driven optimization.
- Technology and SoftwareTechnology companies with data-intensive products or services can use Databricks for large-scale pipelines, real-time analytics, ML development, and AI applications.
Cloudera
- Financial ServicesCloudera’s advanced governance, lineage, and security features make it a reliable fit for meeting banking and financial regulatory demands.
- Healthcare & Life SciencesStrict data governance, in-depth audit trails, and hybrid cloud options match healthcare’s compliance and privacy requirements.
- TelecommunicationsManaging massive data pipelines is easier with Cloudera’s Apache Spark, Kafka, and NiFi integrations.
- Large EnterprisesCloudera’s hybrid deployment support and control over complex infrastructures suit organizations with diverse, global operations.
- Data Engineering TeamsNative integration with tools like Apache Airflow, Impala, and Hive gives data engineers extensive workflow and processing flexibility.
- Government AgenciesFull data residency control, advanced security controls, and detailed auditing cater to public sector compliance standards.
Hvem bør bruke Databricks, og hvem bør bruke Cloudera?
Hvis du ser etter en DataOps-plattform som samler datateknikk, analyse, styring og KI i det samme skyfokuserte miljøet, er Databricks sannsynligvis det beste valget. Den er spesielt nyttig for team som ønsker administrerte datapipelines, samarbeidsbaserte notatbøker, støtte for strømming og sentralisert styring uten å måtte håndtere like mye infrastruktur manuelt.
Hvis du derimot trenger å kjøre dataarbeidsflyter på tvers av skybaserte, lokale og hybride miljøer, kan Cloudera passe bedre til infrastrukturen din. Det er et godt valg for virksomheter med strenge krav til samsvar eller datalokalitet, etablerte økosystemer basert på åpen kildekode og team som administrerer distribuerte dataplattformer på tvers av flere miljøer.
| Databricks | Cloudera | |
|---|---|---|
| Compute & Development | Databricks Workload-aware compute, autoscaling, and collaborative notebooks support engineering, SQL, and AI workloads without provisioning everything for peak demand. | Cloudera Provides configurable compute and data services designed to operate across cloud and on-premises infrastructure. |
| Data Intelligence | Databricks Its Data Intelligence Engine uses organizational metadata and context to improve discovery, governance, optimization, analytics, and AI workflows. | Cloudera Uses metadata, cataloging, and platform services to manage data and analytics across distributed environments. |
| Deployment Model | Databricks Runs as a cloud-native platform across AWS, Azure, and Google Cloud, with managed and serverless compute reducing infrastructure work across data and AI workloads. | Cloudera Extends across public cloud, private cloud, on-premises data centers, and edge environments. |
| Governance Model | Databricks Unity Catalog centralizes access policies, auditing, discovery, and lineage across data, models, applications, and AI assets. | Cloudera SDX combines technologies such as Apache Ranger and Atlas for policy enforcement, auditing, metadata, and lineage. |
| Lakehouse Foundation | Databricks Combines warehousing, engineering, BI, ML, and AI on a lakehouse built around open technologies such as Delta Lake and Apache Spark. | Cloudera Uses an open lakehouse approach based on technologies such as Apache Iceberg, HDFS, and the broader Apache ecosystem. |
| Analytics & Machine Learning | Both support SQL analytics, data science, machine learning, and AI workloads within their broader data platforms. |
|---|---|
| Apache Spark Support | Both use Apache Spark for distributed data processing and large-scale engineering workloads. |
| Batch & Streaming | Both process batch and real-time data for analytics, operational workflows, and downstream applications. |
| Data Integration & ETL | Both support ingestion, transformation, orchestration, and monitoring for large-scale data pipelines. |
| Integrations & APIs | Both connect with major cloud platforms, databases, BI tools, and enterprise systems and provide APIs for extending workflows. |