Le Directeur Technique Monde appelle les dirigeants à se concentrer sur l’infrastructure de données avant l’IA
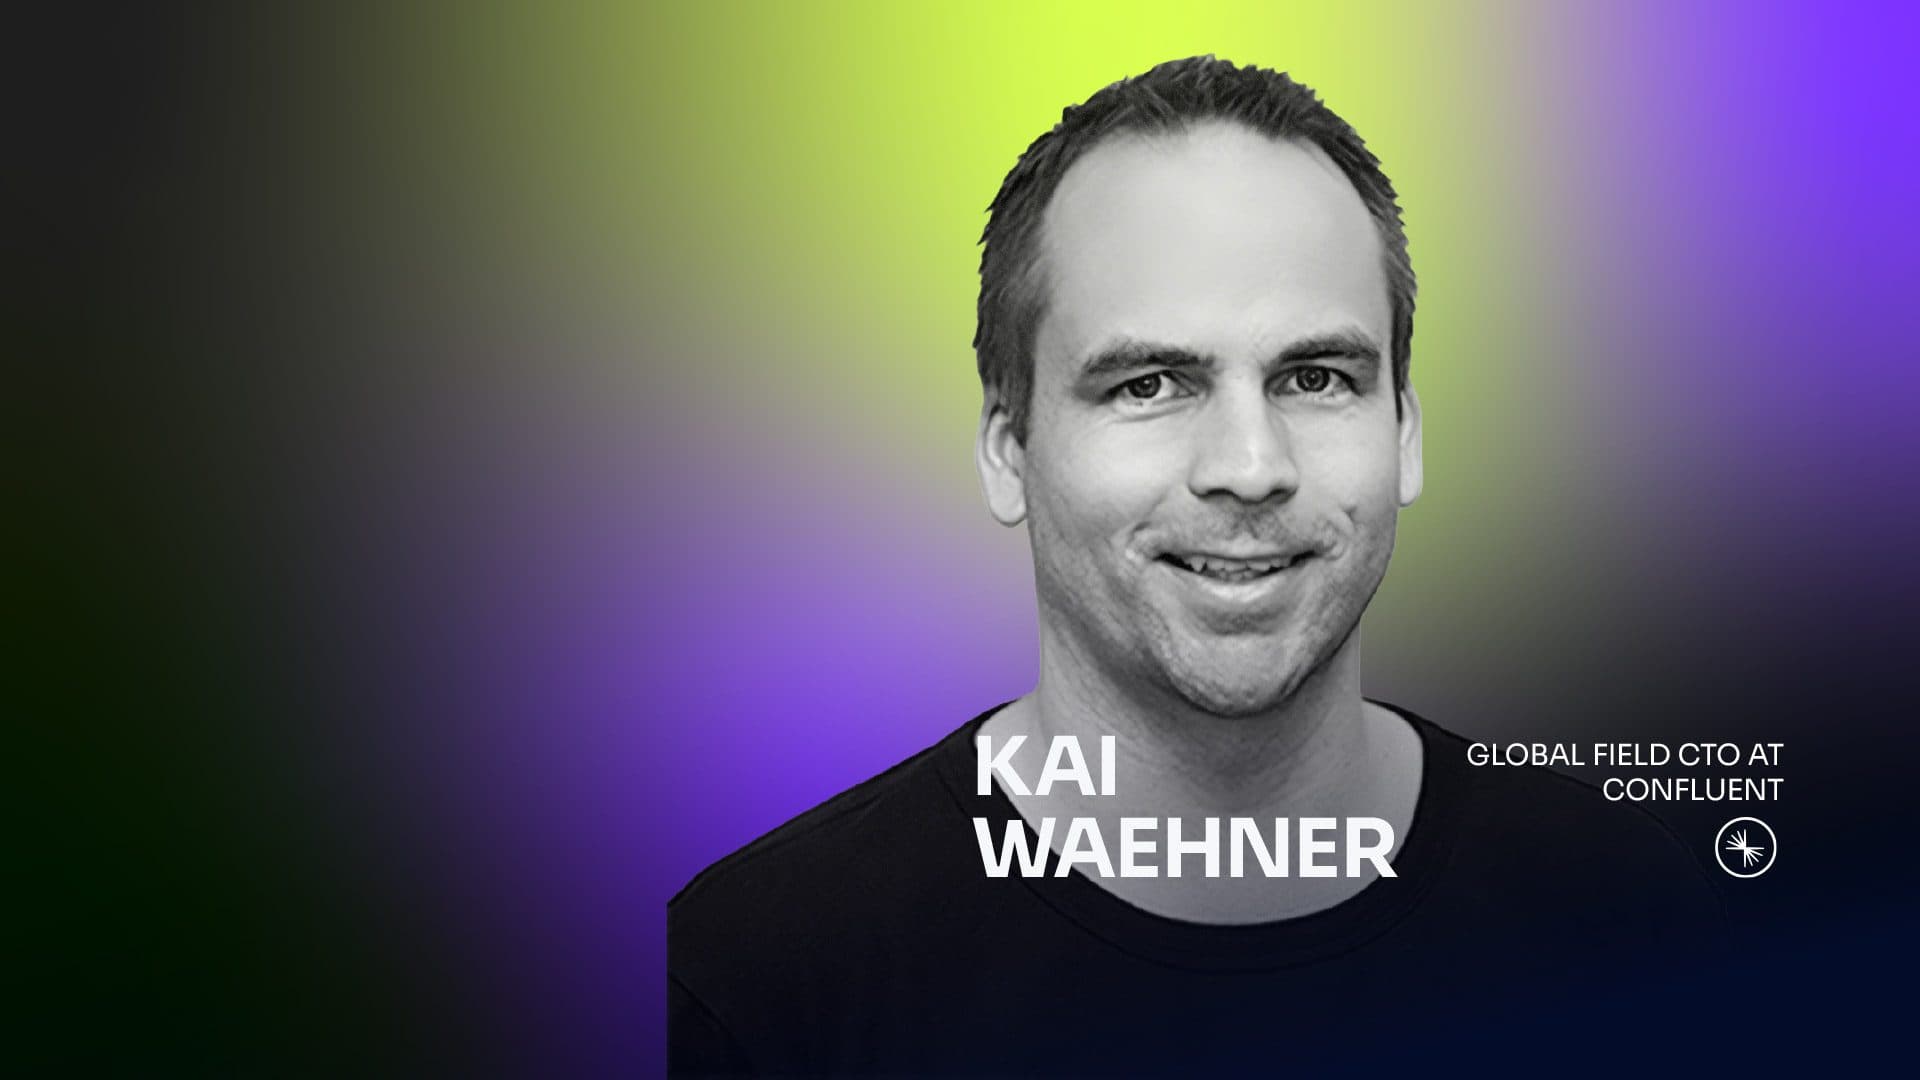
Kai Waehner
Directeur Technique Monde chez Confluent
Découvrez pourquoi les projets d’IA en entreprise échouent sans une infrastructure de données solide et comment les dirigeants peuvent bâtir des systèmes gouvernés et en temps réel favorisant une adoption fiable de l’IA.
Key Takeaways
Reconnaissance de motifs: L’expérience internationale de Kai Waehner offre un avantage unique en matière de reconnaissance de motifs dans l’IA d’entreprise.
Centrer l’infrastructure: Le succès de l’IA en entreprise repose sur la convergence des couches d’architecture : données, automatisation des processus et stratégies d’IA.
Préparation des données: La réussite ou l’échec des projets d’IA dépend souvent de l’infrastructure de données, plus que du modèle choisi.
IA intégrée: Intégrer l’IA dans les flux de travail existants améliore les performances, la gouvernance et la traçabilité.
Préoccupations relatives à la sécurité: Le code généré par l’IA peut présenter des vulnérabilités ; des examens et des tests rigoureux sont indispensables.
Kai Waehner est Directeur Technique Monde (Global Field CTO) chez Confluent et a conseillé de grandes entreprises telles que BMW et Siemens. Il se concentre sur l'infrastructure de données, la stratégie d'intégration et l'adoption de l'IA.
Nous avons rencontré Kai pour comprendre pourquoi tant d'initiatives d'IA en entreprise échouent. Voici ce qu'il avait à dire.
Un avantage dans la reconnaissance des schémas
Je m'appelle Kai Waehner. J'ai passé les neuf dernières années en tant que Global Field CTO chez Confluent, accompagnant des centaines d'entreprises en Amérique du Nord, en Europe et en Asie-Pacifique. J'ai conseillé des sociétés telles que BMW, Volkswagen, Lufthansa, Siemens, DISH Networks et Globe Telecom. Je travaille avec des dirigeants sur la stratégie technologique, l'exécution go-to-market, l'évaluation des fournisseurs, l'architecture d'entreprise et la création de contenu.
Le rôle de Field CTO diffère de la gestion d'une unique organisation d'ingénierie. J'interviens simultanément sur des dizaines d'environnements clients, en conseillant architectes et décideurs C-suite sur l'infrastructure de données, la stratégie d'intégration et l'adoption de l'IA. Cette transversalité me donne un avantage pour reconnaître les schémas, avantage difficile à acquérir depuis l'intérieur d'une seule entreprise.
Mon expérience couvre toute l'histoire de l'intégration des données en entreprise : ETL, ESB, iPaaS et gestion des API, puis neuf ans consacrés au streaming de données avec Apache Kafka et Flink en colonne vertébrale de l’architecture orientée événements et, de plus en plus, de l’orchestration des processus et de l’IA sur tout le spectre, du machine learning prédictif à l’IA générative et agentique. Je fais régulièrement des briefings avec les analystes de Gartner et Forrester, et je publie mes propres recherches, couvrant l’écosystème des fournisseurs, les modèles architecturaux et des études de cas industrielles concrètes. J’ai également publié un livre sur le streaming de données.
La discussion sur la transformation par l’IA que j’ai avec les responsables technologiques ne porte pas d’abord sur les modèles. Elle porte sur l’infrastructure sous-jacente. Les systèmes d’IA agentique qui prennent des décisions autonomes dans les workflows d’entreprise ont besoin de trois éléments fondamentaux pour fonctionner de façon fiable :
- Des données en temps réel pour agir selon la réalité actuelle
- L’intelligence des processus pour définir ce qu’ils sont autorisés à faire
- La confiance intégrée à l’architecture, et pas uniquement au modèle
Ma réflexion se concentre sur cette convergence.
More Articles
- 10 meilleurs outils d’IA pour DevOps examinés en 2026
- 13 meilleures infolettres sur l’IA pour les développeurs à suivre en 2026
- 10 meilleurs logiciels d’IA qui redéfinissent l’avenir
- Les 10 meilleures plateformes d’intelligence artificielle que j’ai testées en 2026
- 7 meilleures plateformes d’IA sans code évaluées en 2026
Pourquoi la convergence des couches architecturales est essentielle à la réussite de l’IA
Dans tous les secteurs, je constate systématiquement que les entreprises investissent massivement dans trois couches séparées : une colonne vertébrale d’intégration de données, une couche d’automatisation des processus, et de plus en plus, une initiative IA. Le problème, c’est que ces trois éléments sont presque toujours conçus pour fonctionner séparément. L’intégration de données fait circuler les données mais ne les relie pas aux décisions métier. L’automatisation des processus fait appliquer les workflows mais fonctionne sur un contexte obsolète. Les agents IA génèrent des recommandations ou prennent des mesures mais ne disposent pas d’un périmètre maîtrisé sur ce qu’ils peuvent faire. Chaque couche fonctionne isolément. L’architecture convergée fait défaut.
Les modèles de déploiement que j’observe varient considérablement. Certaines organisations opèrent une infrastructure cloud-native entièrement managée sur AWS, Azure ou GCP, et de grandes entreprises mondiales incluent souvent des déploiements en Chine continentale sur Alibaba Cloud, maintenus séparés pour des raisons légales, réglementaires et de confidentialité des données. D’autres exploitent des architectures hybrides avec des datacenters sur site reliés au cloud, soit à cause de contraintes de souveraineté des données, soit en raison de systèmes hérités impossibles à migrer rapidement. Les secteurs réglementés comme les services financiers ou la santé ont presque toujours des exigences multi-régions ou multi-cloud, non par choix mais par obligation de conformité. Chez les clients industriels, j’observe souvent des déploiements en périphérie (edge), où les données sont traitées près de l’atelier avant d’être centralisées.
Dans tous ces environnements, l’architecture événementielle est devenue une infrastructure indispensable. Apache Kafka s’est imposé comme le standard naturel du courtage d’événements pour assurer un découplage réel entre systèmes, un traitement en temps réel à toute échelle, et l’intégration hybride ou multi-cloud. PayPal traite plus de mille milliards de messages Kafka par jour. New Relic ingère des milliards de points de données par minute. Ce ne sont pas des déploiements expérimentaux, mais l’ossature opérationnelle du business.
De nombreuses entreprises disposent déjà des trois éléments nécessaires à une IA agentique de confiance. Ce qui leur manque, c’est la volonté architecturale de les faire converger.
Pourquoi la préparation des données précède celle de l’IA
Les réflexions de Kai
La préparation à l’IA commence par la préparation des données.
Voici ce que j’ai constaté : l’IA n’est pas la partie difficile. C’est l’infrastructure de données qui est en jeu.
La plupart des initiatives IA d’entreprise qui ont réussi ou échoué au cours des neuf dernières années dépendaient moins du modèle choisi que de la capacité de l’organisation à offrir une fondation fiable, gouvernée et en temps réel pour alimenter ce modèle avec des données actuelles, précises et dignes de confiance.
Un modèle bien aligné recevant des données obsolètes ou incohérentes produira des résultats peu fiables. Un système d’IA agentique sans couche de processus définissant ce qu’il peut faire finira par prendre une décision que personne ne pourra expliquer ou annuler. Ce ne sont pas des problèmes de modèle. Ce sont des problèmes d’infrastructure et d’architecture. Et ils sont totalement prévisibles avant même d’écrire une seule ligne de code IA.
L’implication concrète est que la préparation à l’IA équivaut à la préparation des données. Avant de sélectionner un modèle, avant de choisir un fournisseur d’IA, avant de lancer un projet pilote, un CTO doit pouvoir répondre honnêtement à trois questions.
- L’organisation dispose-t-elle d’un accès fiable aux données en temps réel issues de ses systèmes opérationnels ?
- Existe-t-il des processus gouvernés qui définissent ce qu’un système d’IA peut faire, et ce qu’il ne peut pas faire de façon autonome ?
- Y a-t-il un cadre de confiance mis en place au niveau de l’architecture, et pas seulement dans le modèle, qui puisse imposer ces limites en production ?
Si la réponse à l’une de ces trois questions est non, le parcours IA doit commencer là, et non par le modèle.
Pourquoi l’IA doit être intégrée aux processus métier existants
Le changement le plus significatif que j’ai impulsé a été de passer de la construction de l’IA comme initiative séparée à son intégration dans les processus métier existants. C’est un sujet extrêmement négligé et pourtant majeur. En réalité, je dirais que la plupart des CTO devraient passer de la conception de nouveaux systèmes d’IA à la conception de la place de l’IA dans les flux de travail existants, des limites imposées par la couche de processus, et de la façon de construire la gouvernance et la traçabilité — avant de déployer un seul modèle.
Avant que je n’opère cette mutation, le schéma se répétait presque toujours. Un projet IA démarrait sans lien avec les systèmes opérationnels. Le modèle fonctionnait bien en laboratoire. Mais en production, il manquait d’accès fiable aux données actuelles, de définition claire de ses marges d’action, et d’intégration dans les circuits d’approbation sur lesquels l’entreprise comptait. Démo impressionnante. Déploiement raté.
Le changement que je défends désormais systématiquement est double.
- D’abord, considérer l’architecture événementielle existante comme la base de l’adoption de l’IA plutôt que comme une cible à remplacer. Les systèmes restent. Les processus métier demeurent en place. L’IA intervient dans les flux de travail déjà en cours, consomme des événements en temps réel, et agit dans le cadre défini par la couche de processus.
- Ensuite, déplacer les garde-fous de l’IA hors du modèle pour les installer dans la couche d’orchestration des processus. Un modèle bien aligné ne suffit pas. Une IA fiable en production suppose que la couche workflow impose des étapes d’approbation, des chemins d’escalade et des pistes d’audit pour chaque action autonome réalisée par l’agent.
Alpian, la première banque privée digitale suisse entièrement agréée, en est un excellent exemple, réussi dès le départ. Alpian a construit toute sa plateforme selon un modèle événementiel, avec Apache Kafka comme système nerveux central reliant microservices, produits de données métier et agents IA. Quand ils ont introduit l’IA agentique et RAG dans les parcours d’interaction avec les clients, l’architecture était déjà opérationnelle. Les événements Kafka donnaient aux agents le contexte en temps réel. La couche de processus assurait le respect des obligations de conformité. Ils avaient dès le départ intégré le chiffrement au niveau champ et la gouvernance des schémas.
Le résultat : une institution financière réglementée exploitant des agents IA autonomes au sein de workflows gouvernés et traçables – exactement le schéma que la plupart des entreprises traditionnelles tentent actuellement d’adapter a posteriori.
Les organisations qui réussissent adoptent l’intégration de l’IA comme une discipline d’architecture, pas comme un sprint projet.
Les organisations qui réussissent adoptent l’intégration de l’IA comme une discipline d’architecture, et non comme un sprint projet… L’écart entre de bons et de mauvais résultats provient presque toujours du fait que l’infrastructure de données était ou non prête avant l’introduction de l’IA.
Pourquoi la préparation des données conditionne le succès du déploiement de l’IA
Après neuf ans chez Confluent et des centaines d’environnements entreprises, j’ai constaté que les résultats de l’IA sont extrêmement disparates. L’écart entre de bons et de mauvais résultats provient presque toujours d’un seul facteur : l’infrastructure de données était-elle prête avant l’introduction de l’IA ?
D’un point de vue positif, les chiffres issus de déploiements bien architecturés sont convaincants. BMW évite plus de 500 minutes d’arrêt de production non planifié par an sur un seul site. Alpian exploite une banque numérique entièrement réglementée, avec de l’IA agentique intégrée dans des flux clients gouvernés et auditables. Le schéma qualitatif que l’on observe dans les succès est cohérent : un délai de mise sur le marché plus court, une réduction des coûts opérationnels sur les processus répétitifs à grand volume, et une expérience client nettement améliorée lorsque l’IA accède à un contexte en temps réel plutôt qu’à des données par lots obsolètes.
Côté négatif, le schéma d’échec est tout aussi constant. Les projets d’IA sans socle de données gouverné aboutissent presque toujours au même résultat : des démonstrations impressionnantes, des déploiements en production ratés. Le modèle fonctionne en laboratoire. En production, il reçoit des données obsolètes ou incohérentes, part en erreur sur les cas limites, prend des décisions sans traçabilité, et érode la confiance métier envers l’IA au lieu de la renforcer. Selon des recherches du MIT, environ 95 % des projets pilotes IA d’entreprise n’apportent pas d’impact business mesurable. Ce chiffre recoupe mes observations sur le terrain.
Le mode d’échec le plus récent que j’observe est que la gouvernance est ajoutée trop tard. Les organisations déploient de l’IA agentique puis découvrent, généralement après un incident, qu’aucune couche de processus n’a défini ce que l’agent pouvait faire, qu’aucun circuit d’escalade n’existe pour les sorties incertaines du modèle, et qu’aucune traçabilité ne permet de reconstituer les événements. Ce n’est pas un problème d’IA, c’est un problème d’architecture. Et il est totalement évitable.
Pourquoi l’IA éclaire les décisions mais l’humain garantit la responsabilité
Je constate toujours le même schéma : l’IA informe et accélère. Elle prend des décisions autonomes dans des limites définies. Mais la responsabilité des décisions majeures reste du ressort humain.
Du côté des usages informés par l’IA, la synthèse de recherche, la création de contenu, la génération de code pour des problèmes bien délimités, les tests automatisés et l’analyse de sécurité apportent une valeur claire. Dans mon propre travail, les outils d’IA compressent plusieurs jours de synthèse sur rapports d’analystes, échanges clients et documentation technique. Le résultat doit encore être validé par un expert, mais le point de départ est considérablement avancé.
Côté décisions autonomes, les agents IA doivent décider seuls lorsque le risque est borné et le processus bien gouverné. La détection de fraude dans la finance en est l’exemple le plus clair. Sous un certain seuil de risque, un agent IA bloque automatiquement une transaction sans intervention humaine. À mesure que le montant augmente et que l’exposition réglementaire s’accroît, la couche d’orchestration oriente le dossier vers un analyste humain avant toute action. La frontière n’est pas immuable : c’est l’entreprise qui la définit, le flux de travail qui l’encode et la couche de processus qui l’applique, et non le modèle lui-même.
Côté explicitement humain, je place la limite sur les décisions impliquant des conséquences architecturales majeures, des risques stratégiques ou une forte responsabilité réglementaire. Choisir un modèle d’architecture fondamental, sélectionner un fournisseur technologique stratégique, concevoir la gouvernance d’un système d’IA agentique : cela reste des décisions humaines. Aller plus vite ne permet pas de récupérer les conséquences d’un mauvais choix.
Pourquoi l’IA ne tient pas ses promesses sur trois axes principaux
L’IA n’a pas délivré l’impact technique ou d’ingénierie attendu par les clients dans trois domaines.
Le premier est l’intégration de données d’entreprise. L’IA promettait de simplifier radicalement la connexion de systèmes hétérogènes : correspondance de schémas, qualité des données, logique de transformation, gouvernance à travers des environnements hybrides complexes. En pratique, l’IA facilite ces tâches sans les résoudre. Un modèle ne peut pas régler la dette architecturale, les systèmes anciens sans documentation, l’incohérence des sémantiques d’une entité à l’autre, l’absence de métadonnées ou la fragmentation des responsabilités. Ce travail de fond reste la charge des ingénieurs.
Le deuxième concerne l’IA agentique dans des processus métiers complexes à étapes multiples. Les démonstrations sont impressionnantes. Mais en production, les agents échouent de façon imprévisible lorsqu’ils rencontrent des cas que les données d’entraînement n’ont pas couverts, quand la fenêtre de contexte ne contient pas suffisamment d’état à jour ou lorsque la couche de processus ne gère pas bien les erreurs des agents. L’écart reste important entre ce que l’agent sait faire en environnement contrôlé et ce qu’on peut vraiment lui confier comme tâche autonome dans un flux audité et réglementé.
Le troisième concerne la prise de décision architecturale. Les outils IA accélèrent la rédaction de code, de tests, de documentation. Mais ils n’améliorent pas de façon fiable les arbitrages techniques structurants. Les modèles s’appuient sur les tendances passées, alors que l’architecture d’entreprise exige du discernement sur les contraintes à venir, les évolutions réglementaires et les paris technologiques que les modèles ne peuvent pas anticiper. Les équipes qui s’en remettent trop à l’IA pour ces choix produisent souvent des systèmes cohérents localement mais fragiles globalement.
Le dénominateur commun de ces trois limites est celui-ci : l’IA tient ses promesses si le problème est bien cadré, les données sont propres et actualisées, et qu’un expert du métier reste impliqué. Elle sous-performe partout où la résolution exige du discernement contextuel, des changements organisationnels ou une vision architecturale dépassant le simple alignement sur les tendances du passé.
Comment l'IA peine avec la sécurité et la scalabilité dans le code
La difficulté la plus constante que j'observe se situe à la frontière entre le code généré par l'IA et le jugement d'ingénierie de niveau production.
Les outils de génération de code par l'IA sont réellement utiles pour des tâches bien définies et répétitives : le code standard, les cas de test, la documentation, et les transformations simples. Les problèmes apparaissent lorsque les équipes étendent cette confiance aux décisions architecturales, au code sensible à la sécurité ou aux composants critiques pour la scalabilité sans une véritable revue humaine rigoureuse.
Du point de vue de la sécurité, le code généré par l'IA introduit souvent des vulnérabilités subtiles qui passent les analyses automatisées mais échouent dans des conditions adverses. L'injection de prompt est le meilleur exemple actuel dans les systèmes d'IA agentiques. Un agent qui génère ou exécute du code à partir des entrées utilisateurs sans validation adéquate et sans bac à sable crée des surfaces d'attaque faciles à manquer et difficiles à détecter a posteriori. J'ai vu ce schéma apparaître dans les premiers déploiements d'IA agentique où les équipes se concentraient sur les capacités et la rapidité, reléguant la revue de sécurité à plus tard.
Du côté de la scalabilité, les outils d'IA ont tendance à générer des solutions qui fonctionnent parfaitement à petite échelle mais comportent des hypothèses cachées sur le volume de données, la concurrence ou la latence qui n'apparaissent qu'en production sous forte charge. Un consommateur Kafka généré qui marche bien en test peut échouer de façon imprévisible à dix mille événements par seconde si le code produit ne prend pas en compte le rééquilibrage des partitions, la gestion des offsets, ou la maîtrise du flux. Le modèle ne connaît pas votre environnement de production. Il connaît des schémas issus de ses données d'entraînement.
La réponse pragmatique n'est pas d'arrêter d'utiliser l'IA pour la génération de code. Il faut traiter ce code comme celui d'un ingénieur junior capable, mais ignorant tout de votre système de production. Relisez-le. Testez-le dans des conditions réalistes. Et ne le laissez jamais toucher aux parcours critiques pour la sécurité ou la performance sans la validation d'un ingénieur expérimenté.
Ce que les dirigeants technologiques doivent faire ensuite
Réflexions de Kai
Investissez dans la fondation de vos données avant de nourrir vos ambitions d’IA… traitez la gouvernance de l’IA comme un problème d’architecture, pas un problème de politique… pensez dans les deux sens simultanément.
Voici trois recommandations, par ordre d'importance :
Premièrement, investissez dans la base de vos données avant de viser l’IA. Les organisations qui obtiennent des résultats mesurables avec l’IA ne sont pas celles qui sont passées le plus vite à un nouveau modèle. Elles disposaient d’une donnée propre, en temps réel, et gouvernée dans leurs systèmes avant même de lancer la discussion sur l’IA. Si vos données sont cloisonnées, obsolètes ou mal gouvernées, commencez par résoudre cela. Aucun modèle ne peut rattraper des données médiocres à grande échelle.
Deuxièmement, considérez la gouvernance de l’IA comme un problème d’architecture, pas de politique. Rédiger des consignes sur l’utilisation responsable de l’IA est nécessaire, mais pas suffisant. C’est la couche de processus qui gouverne réellement le comportement des agents en production : les barrières dans les workflows, les seuils d’approbation, les parcours d’escalade et les pistes d’audit qui renforcent les limites indépendamment des recommandations des modèles. Intégrez-les dans l’architecture dès le départ. Ajouter la gouvernance a posteriori coûte cher, est peu fiable, et n’arrive en général qu’après un souci.
Troisièmement, pensez dans les deux sens à la fois. La pression du terrain pour livrer vite des cas d’usage IA est réelle et légitime. Tout comme le besoin d’une architecture stratégique pour éviter d’empiler des solutions isolées que vous passerez des années à démêler. Les CTO que j’observe qui réussissent tiennent les deux extrémités : avancer rapidement sur les cas d’usage concrets tout en gardant un cap architectural clair qui rend ces cas réutilisables et gouvernables sur la durée.
Les organisations qui retiendront cette période comme un avantage concurrentiel ne seront pas celles qui ont adopté l’IA en premier. Ce sont celles qui ont construit l’infrastructure pour rendre l’IA fiable, puis ont accéléré à partir de cette base.
À suivre
Vous pouvez suivre le travail de Kai Waehner sur son site web, son blog et LinkedIn.
D'autres interviews d'experts à venir sur The CTO Club !