

Så du er begyndt at indføre DevOps i din virksomhed. Men hvordan kan du se, om det forbedrer dine processer? Du er nødt til at måle succesen på en eller anden måde, og det kan du gøre ved at overvåge nogle vigtige DevOps-målepunkter.
Der er mange måder at vurdere kvaliteten af et system eller en applikation på, men i denne artikel fokuserer jeg på vigtige målepunkter, der hjælper med at evaluere kvaliteten af dine processer. Ved at følge disse indikatorer kan du få dybere indsigt i dine styrker og svagheder, forbedre dine DevOps-bedste praksisser og udnytte de rette værktøjer og software til løbende forbedringer.
Hvorfor er DevOps-målepunkter vigtige?
Som beskrevet ovenfor kan fælles mål og målepunkter være en udfordring for teams, der indfører DevOps i en virksomhed. Uden DevOps-målepunkter ville der ikke være nogen test eller måling og ingen forbedringer af udviklingen. Det ville blot være gentagelser af den samme software baseret på mavefornemmelser og idéer, hvor man sender den ud i det ukendte og derefter prøver noget nyt. Uden feedback eller målepunkter for produktsucces til at forstå, hvordan noget fungerer, er der ingen retning.
Økonomiafdelinger ønsker for eksempel at holde omkostningerne så lave som muligt, mens udviklere ønsker at holde ydeevnen så høj som muligt. Disse to mål er måske ikke forenelige, medmindre risiciene er blevet vurderet, og teams forstår hinandens målsætninger.
Hvor dine udviklere måske vælger at lancere et ufærdigt produkt og håndtere det senere, medfører omkostningerne ved denne påvirkning teknisk gæld. Implementering af DevOps kan skabe overensstemmelse mellem de to teams' mål og strategier, og du kan hjælpe dine udviklere med at forstå omkostningspåvirkningen af deres tekniske beslutninger.
Dette er blot en lille del af DevOps og betydningen af fælles målepunkter.
5 vigtige DevOps-målepunkter (DORA)
Implementering af DevOps og forståelse af principbaserede rammeværk er én ting, men det er med DevOps-målepunkter, at du virkelig begynder at se fordelene ved denne samarbejdsorienterede tilgang til softwareudviklingslivscyklussen. Som med de fleste forretningsstrategier er der utallige målepunkter, du kan vælge at måle for at skabe vækst, afhængigt af din branche, målgruppe og dine mål.
Google Clouds team for forskning i og vurdering af DevOps (DORA) er det længst fungerende forskningsteam af sin slags. De fandt oprindeligt fire vigtige målepunkter til at måle præstationerne hos de ‘elite’ inden for DevOps. Siden er et femte vigtigt målepunkt blevet føjet til blandingen, og deres klyngeanalyse identificerer kun tre niveauer af DevOps-teams: højt, middel og lavt, hvor ‘elite’ hører fortiden til.
1. Implementeringsfrekvens (DF)
DF måler, hvor ofte du udgiver succesfuldt til produktion. Dette målepunkt handler om konsekvens og er en fremragende indikator for målopfyldelse.
Teams i kategorien ‘elite’ ville konsekvent implementere til produktion flere gange dagligt, mens teams med lav præstation ville være tættere på én gang hver sjette måned.
Det er så enkelt at forbedre DF som at udgive flere mindre opdateringer. Den største fordel ved dette er, at det fremhæver eventuelle procesblokeringer, flaskehalse eller komplekse projekter, der kræver opmærksomhed. Større teams foretrækker måske at implementere med regelmæssige intervaller ved at opbygge smidige udgivelsestog; det hjælper med at fjerne overvældelsen ved et ekstremt tempo og mange mennesker.
2. Gennemløbstid for ændringer (LTC)
LTC henviser til den tid, det tager for en kodeændring at komme i produktion. Dette målepunkt er en god indikator for teamets reaktionshastighed og smidighed, da det måler, hvor hurtigt de kan reagere på brugernes behov og efterspørgsel.
Den tidligere ‘elite’-standard sigtede efter en LTC på under én dag, mens teams med lavere præstationer kunne bruge mere end seks måneder. En placering i den lave ende af skalaen for LTC skyldes sandsynligvis ineffektive processer.
Du kan forbedre dette målepunkt ved at forbedre automatiseringsprocesserne, især testning. Ved at forbedre din pipeline til kontinuerlig integration og kontinuerlig levering (CI/CD) kan du få opdateringer hurtigere i produktion. En risiko, du dog skal være opmærksom på her, er bæredygtighed. Hvis dit team ikke kan opretholde dette forbedrede tempo, kan du opleve en dårlig brugeroplevelse og potentielle sikkerhedssårbarheder.
3. Fejlrate for ændringer (CFR)
CFR er procentdelen af implementeringer, der forårsager en fejl i produktionen. Fejlen kan være nedetid, tilbagerulninger eller forringet tjeneste. Denne måling viser, hvor effektivt dit team er, når det implementerer ændringer.
Benchmarks for fremragende præstationer er 0-15 %, mens høj, middel og lav præstation alle ligger under 16-30 %.
Forbedring af CFR handler om kvalitet frem for kvantitet. Virksomheder udgiver et varierende antal ændringer og har derfor også et varierende antal fejl. Ændringer af højeste kvalitet vil dog resultere i færre fejl, uanset om de implementerer ændringer to gange om året eller to gange om dagen.
4. Gennemsnitlig tid til genoprettelse (MTTR)
MTTR er den tid, dit team bruger på at genoprette tjenesten efter en fejl eller forstyrrelse. Denne måling viser ikke kun dit teams fleksibilitet, men er også en god indikator for stabiliteten af din software.
Hvis du sigter efter et ‘fremragende’ niveau, skal MTTR være under en time. Teams med lav præstation kan bruge over seks måneder.
Du kan forbedre MTTR ved at fokusere på mindre, hurtige udgivelser, som gør fejl lettere at finde og rette. Du kan også undersøge funktionsflag for at give dit team mere kontrol — især hvis de er eksperimentelle.
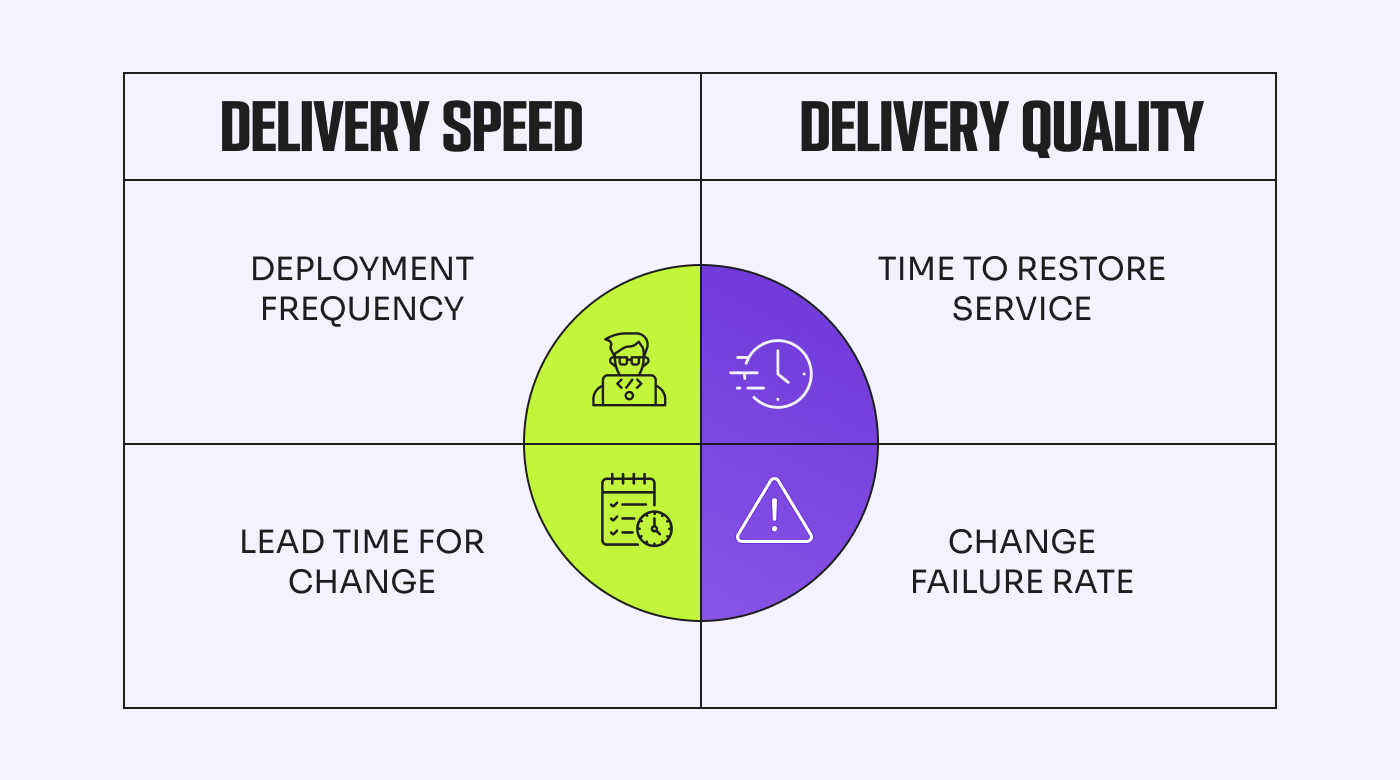
Der er endnu en måling, der skal gennemgås.
5. Pålidelighed
Den femte bonusmåling er pålidelighed. Denne måling blev senere identificeret af DORA-teamet (2021), fordi tilgængelighed tidligere blev målt som et benchmark for pålidelig software. Det blev dog besluttet, at pålidelighed bedre omfatter tilgængelighed, latenstid, ydeevne og skalerbarhed. Det indebærer grundlæggende, at den operationelle ydeevne måles sammen med udviklingen.
Andre almindelige DevOps-målinger
Have an account? Log In
Cyklustid
Cyklustid er den samlede tid fra starten af en opgave til den endelige levering. Overordnet set måler den dit teams arbejdshastighed. Du kan dog gå mere i dybden med denne måling for at finde flaskehalse som lange køtider og pullforespørgsler, der tager lang tid.
En kortere cyklustid indikerer en effektiv arbejdsgang, der reducerer flaskehalse og øger udviklingshastigheden.
Sådan måler du cyklustid
Cyklustid beregnes ved at registrere tidsstempler for commits, kodesammenfletninger og implementeringer i værktøjer som GitHub, GitLab eller Jenkins.
Cyklustid = implementeringstid - commit-tidspunkt
For at forbedre cyklustiden bør teams:
- Optimere CI/CD-pipelines for hurtigere integration og implementering.
- Automatisere byggeprocesser og tests.
- Forbedre samarbejdet mellem udviklings- og driftsteams.
- Reducere afhængigheder mellem opgaver for at minimere flaskehalse.
Gennemsnitlig tid til registrering (MTTD)
Dette er den gennemsnitlige tid, det tager for dit team at opdage en fejl. En lav MTTD indikerer effektive overvågnings- og alarmsystemer, hvilket gør det muligt at reagere på og løse hændelser hurtigt.
Sådan måler du MTTD
MTTD kan måles ved at registrere den gennemsnitlige tid mellem et problems opståen og dets registrering af overvågningsværktøjer eller gennem brugernes rapportering. En reduktion af MTTD indebærer forbedring af automatiseret overvågning, finjustering af alarmmekanismer og sikring af proaktiv problemregistrering.
Beståede automatiserede tests
Det er godt at stræbe efter god testdækning, især automatiserede tests. Her taler jeg om enhedstests, integrationstests, brugergrænsefladetests og ende-til-ende-tests. God dækning er dog ikke nok til at sikre kvaliteten af softwaren. Det afgørende er procentdelen af disse tests, der består.
Målet er naturligvis at have en procentdel af beståede tests, der ligger så tæt på 100 % som muligt. Overvågning af denne måling kan også afsløre, hvor ofte nye udviklinger ødelægger eksisterende tests.
Sådan måler du procentdelen af beståede automatiserede tests
Beregningen er en simpel procentdel: Gang antallet af beståede tests med 100, og divider derefter med det samlede antal tests. Du kan få disse oplysninger fra det pipelineværktøj, der kører byggeprocesserne (Jenkins, Azure DevOps, CircleCI osv.).
Tallet kan være en god indikator for produktets kvalitet. Det kan dog også være vanskeligt, hvis du har ustabile eller upålidelige tests.
Fejl, der slipper igennem
Fejlundvigelsesraten angiver, hvor mange fejl der overses under testning og udgives i produktion – altså hvor mange der ‘slipper igennem’. Denne metrik er ideel til overvågning, hvis du ønsker at forbedre test- og automatiseringsprocesserne.
I en utopisk verden ville alle vores apps være fejlfri. Det er dog sjældent tilfældet. Ideelt set opdages fejl under udviklings- og testfaserne i DevOps-processen og ikke i produktionen.
Denne metrik hjælper med at fastslå effektiviteten af dine testprocesser og den overordnede kvalitet af dit program. En høj fejlundvigelsesrate tyder på, at procedurerne skal forbedres, og at der er behov for mere automatisering, mens en lav rate (helst tæt på nul) indikerer en applikation af høj kvalitet.
Sådan måler du fejl, der slipper igennem
For at måle dette kan du bruge dit værktøj til fejlsporing og for hver åben fejl registrere, hvor den er blevet opdaget – om det var i test- eller produktionsmiljøet (eller et andet miljø, du måtte bruge, f.eks. UAT).
Kundehenvendelser
Kundetilfredshed er en drivende faktor for innovation, og det er der en god grund til: En fejlfri brugeroplevelse er god kundeservice og hænger typisk sammen med en stigning i salget. Derfor er kundehenvendelser, især under processen for eskalering af henvendelser, en god indikator for, hvor godt din DevOps-overgang forløber.
Kunder bør ikke fungere som kvalitetskontrol ved at rapportere fejl og mangler. Derfor er et fald i antallet af kundehenvendelser et godt tegn på, at applikationen fungerer godt.
CPU- og hukommelsesforbrug
Identificerer tendenser i ressourceudnyttelsen.
Svartid
Måler den tid, det tager for applikationen at svare på anmodninger.
Fejlrate
Registrerer antallet af mislykkede anmodninger over tid.
Gennemstrømning
Måler antallet af anmodninger, der behandles pr. sekund.
Latenstid for API-anmodninger
Måler forsinkelsen mellem afsendelse af en anmodning og modtagelse af et svar.
Ydeevne for databaseforespørgsler
Registrerer forespørgslers udførelsestider og potentielle flaskehalse.
Analyse af brugeradfærd
Overvåger tendenser i funktionsanvendelse og brugerengagement.
Gennemsnitlig tid mellem fejl (MTBF)
MTBF måler den gennemsnitlige tid mellem systemfejl, nedetid eller hændelser. Denne metrik evaluerer dine softwaresystemers pålidelighed og stabilitet og fremhæver effektiviteten af dine strategier for forebyggende vedligeholdelse og fejlbegrænsning.
Tid til afhjælpning (TTM)
Den tid, det tager at løse et problem, efter at det er blevet opdaget, er TTM. Denne metrik hjælper med at vurdere processerne for hændelsesrespons og -løsning og angiver, hvor effektive dine teams er til at håndtere og genoprette efter problemer.
Gennemløbstid for ændringer (CLT)
CLT udgør et sammenligningsgrundlag for processen med implementering af ændringer fra start til slut, herunder udvikling, testning, gennemgang og udrulning. En kortere CLT betyder hurtigere leveringscyklusser og øget agilitet.
Sådan fastsætter du KPI'er med DevOps-metrikker
Nu hvor du har en god forståelse af de metrikker, du kan bruge til at implementere og optimere DevOps i din virksomhed, vil du gerne undersøge centrale resultatindikatorer (KPI'er) for at fastsætte mål og sammenligningsgrundlag for dit team.
Metrikker kontra KPI'er
Du spekulerer måske på, hvad forskellen mellem metrikker og KPI'er er. En metrik er det, du måler. Det er en kvantificerbar måling, der leverer data om et specifikt aspekt af ydeevnen. Ikke alle metrikker er nødvendigvis knyttet til specifikke mål eller målsætninger.
KPI'er er derimod en type metrik, der er strategisk udvalgt og defineret til at afspejle de mest kritiske aspekter af ydeevnen og fremskridtene hen imod strategiske mål. KPI'er er typisk knyttet til målsætninger og har ofte tilknyttede mål, tærskler eller sammenligningsgrundlag, der skal opnås.
Fastlæggelse af KPI'er for dit DevOps-team
Det første skridt i fastlæggelsen af KPI'er for dit DevOps-team er at knytte DevOps-målinger sammen med din forretningsstrategi og dine mål. Ved at prioritere de vigtigste målinger, der skal følges, kan du begynde at fastsætte mål og referencepunkter for løbende forbedringer. Valget af de rigtige målinger kræver, at du tager højde for virksomhedens størrelse, produkt og marked. Fokuser på det, der giver de mest handlingsanvisende indsigter, og undgå den almindelige faldgrube med for mange målinger.
Overvågning af dine KPI'er er lige så vigtig som fastlæggelsen af dem. Udforsk datavisualiserings værktøjer, der giver dit team realtidsdata i intuitive dashboards. Det sikrer fuld synlighed, skaber ansvarlighed og giver alle mulighed for at arbejde sammen om fælles mål, så udviklings- og driftsteams bringes på linje, og anvendelsen og modenheden af DevOps understøttes.

Hvis vi tager udgangspunkt i DORA's kernemålinger, kan vi se referencepunkterne for hver måling baseret på teams med elite-, høj, middel og lav præstation. Denne tabel kan hjælpe dig med at fastsætte KPI'er for din egen virksomhed afhængigt af, hvad du anser som en prioritet.
Når du fastsætter dine KPI'er, er det bedst at overveje dit team og din virksomhed grundigt uden at sammenligne dem med andre virksomheder. Hvis vi ser på CFR som et eksempel, er referencepunktet det samme for høj, middel og lav præstation. Dette afhænger i høj grad af din implementeringsfrekvens, men kan også påvirke den i den modsatte retning. Hvis dit team bruger al sin tid på at løse fejl, har de mindre tid til at udvikle og udgive opdateringer. KPI'er kan også ændre sig, efterhånden som dit DevOps-team modnes. Tætte automatiserings- og testprocesser bør automatisk betyde, at du kan hæve niveauet for dine mål.
More Articles
Sådan bruger du DevOps-målinger til at skalere
Da det globale DevOps-marked forventes at nå $24.71 milliarder i 2027 (en sammensat årlig vækstrate på 22.9% baseret på en markedsstørrelse på $10.84 milliarder i 2023), bør du tage dette som dit tegn, hvis du leder efter det bedste tidspunkt til at begynde at implementere det i din virksomhed.
DevOps fremskynder ikke kun udviklingen og reducerer tiden til markedet, men forbedrer også samarbejdet ved at eliminere siloer, øger kvaliteten gennem løbende test og feedbacksløjfer og udnytter ressourcer effektivt, hvilket sparer penge. Endelig kan det nemt skaleres og understøtte virksomhedens vækst til nye grænser, idet 83 % af IT-beslutningstagerne opnåede større forretningsværdi ved at implementere DevOps i 2021.
Måling af præstationer og løbende forbedringer
Overvågning af præstationer er nøglen til at skalere en virksomhed, der anvender DevOps. Det er en dynamisk tilgang med et konstant produktionsworkflow, så måling og rapportering bør være lige så hyppige. DevOps-målinger giver dig mulighed for at følge præstationen i dine udviklings- og leveringsprocesser. Ved at kvantificere centrale aspekter som implementeringsfrekvens, gennemløbstid og ændringsfejlrate kan du identificere flaskehalse, ineffektivitet og områder, der kan forbedres. Det gør det muligt for dig at optimere arbejdsgange og processer ofte.
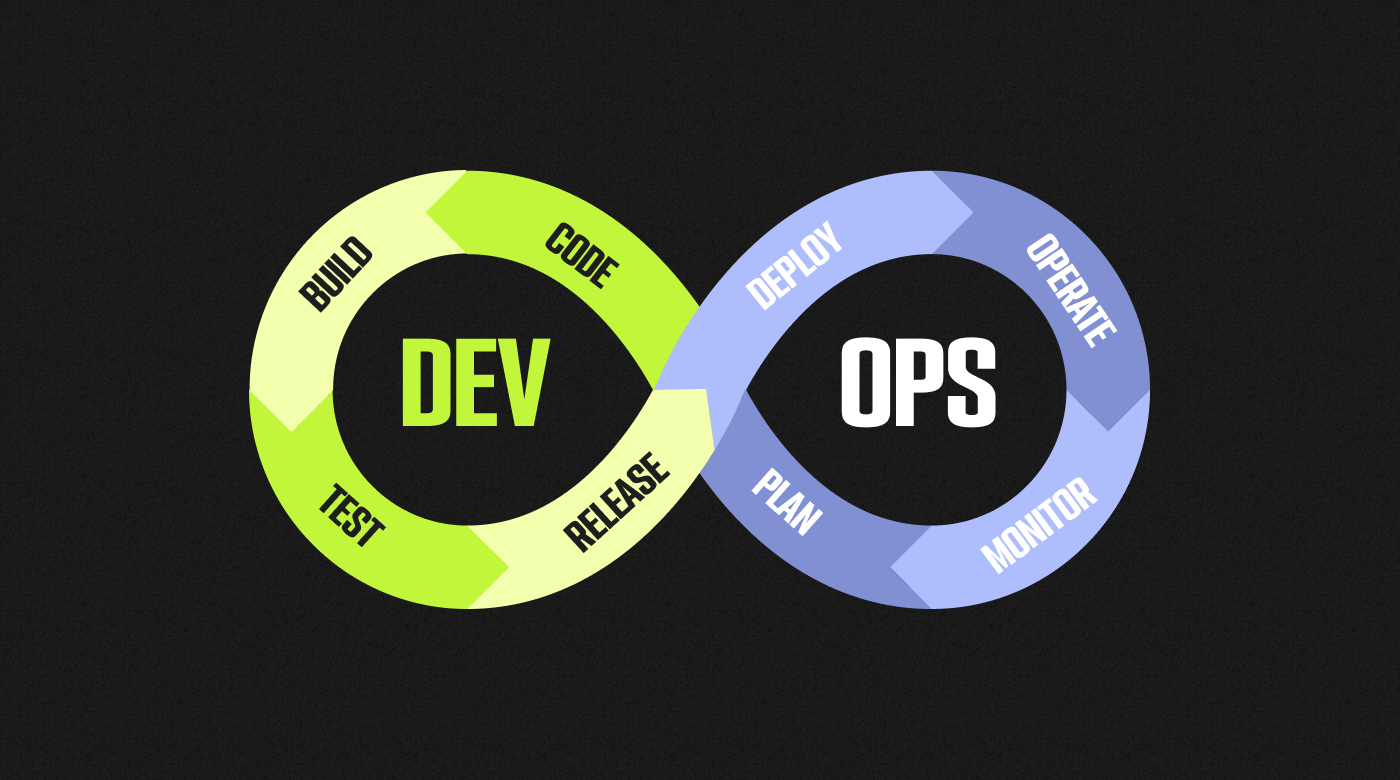
Ved at følge målinger som ændringsfejlrate og gennemsnitlig gendannelsestid kan du identificere tendenser, der gør det muligt at opdage problemer tidligt. Denne proaktive tilgang betyder, at du kan træffe korrigerende foranstaltninger og minimere påvirkningen på kunderne, hvilket giver pålidelighed – endnu en vigtig ingrediens i skalering med høj kvalitet.
Endelig vil brugen af DevOps-målinger hjælpe med at modne dit DevOps-team ved at fremme en kultur med løbende forbedringer. Feedbacksløjfer fremmer læring og vækst; der skal altid være plads til at eksperimentere med forskellige tilgange.
Hvilke DevOps-målinger understøtter virksomhedens vækst?
Når du fastsætter KPI'er, bør de fleste målinger vurderes inden for dit team og positioneres med henblik på vækst i stedet for at blive sammenlignet med andre virksomheder og grupper på forskellige modenhedsniveauer.
En lav LTC kan for eksempel vise, at dit team er effektivt, men hvis de ikke kan opretholde tempoet, er det ikke bæredygtigt og kan i sidste ende påvirke brugeroplevelsen. Denne måling bør følges over tid i stedet for at fastsætte en KPI, der matcher et højtydende eller endda elitært, modent DevOps-team. Fastlæggelse af KPI'er for at reducere LTC måned for måned, kvartal for kvartal eller år for år viser vækst i dit team og din virksomhed.
CFR er en værdifuld måleenhed, fordi ikke alle har det samme antal fejl eller problemer, men ved at angive dette som en procentdel kan du måle, hvor vellykkede dine implementeringer er. Dit team har måske meget få fejl, hvis I udgiver ændringer sjældent, men hvis hver udgivelse forårsager et problem, vil CFR være meget høj. Hvis du følger CI/CD-praksis, kan du se et højere antal fejl, men hvis din CFR er lav, har du en fordel, fordi du har hastighed og kvalitet, der understøtter vækst. MTTR bør også måles over tid for at sikre stabil vækst.
DORA fandt, at teams på alle niveauer af udviklingsresultater opnåede bedre resultater, når de fokuserede på driftsmæssige resultater. Det kan betyde, at der fastsættes KPI'er for hændelsesrapporter eller åbne supporthenvendelser, applikationens oppetid og tilgængelighed.
Et højt antal åbne supporthenvendelser kan være tegn på et problem med din kundetilfredshed, men hvis du sigter mod et fald over tid, afspejler det vækst på dette område. Du kan gå mere i dybden og måle svartider og køtider for at fremskynde forbedringen af denne måleenhed.
Den ene måleenhed, der fuldt ud kombinerer både udvikling og drift som et DevOps-team, er cyklustiden. Det åbner mulighed for at opbygge en kultur med feedback og vækst. Efterhånden som andre måleenheder forbedres, og automatiseringen modnes, bør du forvente, at cyklustiden reduceres. Hvis dit kundeserviceniveau er højt, og antallet af udviklingsfejl er lavt, har du fundet en vindende kombination til at skalere din virksomhed.
Afsluttende tanker
Som enhver anden metode er DevOps kun vellykket, hvis den implementeres korrekt. Og du kan ikke kende succesen, før du ved hvordan du bruger DevOps-målinger.
Selvfølgelig kræver implementering af DevOps-målinger sine udfordringer. Det kræver en strategisk tankegang, en samarbejdende kultur og engagement i løbende forbedringer. Resultatet er imidlertid optimerede arbejdsgange og processer, som du kan bygge et solidt fundament for at skalere din virksomhed på.
Hvis du vil holde dig opdateret med nyheder og artikler, så tilmeld dig vores nyhedsbrev!