


Kvalitetssikring kræver en kombination af proaktive tiltag og effektive reaktive protokoller. Med den rette balance kan du tilbyde brugerne fremragende service og funktionalitet på en server, der er tilgængelig året rundt. Den eneste måde at opnå denne balance på er at identificere de mest relevante målepunkter for serverovervågning.
Men hvilke kunne det være? Det afhænger af dine ønskede egenskaber, herunder dem, der er beskrevet i modellen for kvalitetsmodenhed, samt dine overvågningsmål. Der er dog nogle få målepunkter for sundhed og ydeevne, som QA-ingeniører altid bør holde øje med, uanset hvad.
Ved at vælge de ideelle målepunkter for serverovervågning fra starten kan du etablere en ydeevnebaseline, som du kan bruge som reference, når problemer med sundhed og ydeevne uundgåeligt opstår.
I denne korte vejledning ser vi på, hvorfor du bør følge disse vigtige målepunkter. Desuden får du yderligere indsigt i deres relevans, og hvordan du følger dem.
1. CPU-forbrug
En af de primære årsager til serverovervågning er at holde øje med infrastrukturens sundhed og serverens grundlæggende ydeevne. En central del af dette er proaktiv diagnosticering og afhjælpning af potentielle ydeevneproblemer. Måling af CPU- og diskforbrug er afgørende for denne indsats. Derfor er CPU-forbrug et af de mest grundlæggende og hyppigst overvågede ydeevnemålepunkter.
Dette målepunkt betragtes som “værtsbaseret,” da det registrerer en enkelt maskines evne til at fungere og forblive stabil. Når det er sagt, indebærer overvågning af CPU-forbruget en kombination af passiv og aktiv overvågning. Sidstnævnte er især nyttig til kontrolleret belastningstest, mens førstnævnte indsamler målinger på målet under reel trafik.
Sådan måler du CPU-udnyttelse
Før du går i gang, skal du:
- Vælge de specifikke drev, du vil overvåge.
- Fastslå, hvor disse drev er placeret.
- Sikre, at din dataindsamler har adgang til processerne på din computer.
Når du har konfigureret det hele, skal du bestemme den samplingsfrekvens, som du vil bruge til at følge disse målepunkter. Du kan for eksempel måle CPU-forbruget hvert 30. sekund eller hvert minut.
Der er flere forskellige måder at følge CPU-forbruget på, blandt andet ved at bruge Jobliste eller en kommando som wmic CPU get load percentage på Windows-systemer. Når du forsøger at få et overblik over din server, er det dog bedst at vise disse data på et kontrolpanel.
Husk: CPU-ydeevnen påvirkes af hardwareforhold som CPU-temperatur og blæserhastighed. Det kan være en god idé at overvåge disse faktorer sammen med udnyttelsen (angivet som en procentdel) i disse to tilstande, mens inaktivitet ignoreres.
To vigtige ting, du bør overvåge nøje, er Privilegeret tid og Brugertid, da summen af disse to giver Processortid, som hver især er defineret således:
- Privilegeret tid: Procentdel af den tid, processorer bruger på at udføre processer, der ikke er brugerprocesser (dvs. kerneprocesser)
- Brugertid: Procentdel af den tid, processorer bruger på at udføre brugerprocesser (f.eks. kommandoskal, e-mailserver, compiler)
- Processortid: Den samlede tid, hvor CPU'en var optaget
Vær opmærksom på, at en overskridelse af 100 % ikke altid betyder, at et system er overbelastet. Hvis du for eksempel har et multiprocessorsystem, betyder det blot, at summen af de to eller flere CPU'er er større end 100 % (f.eks. 50 % og 60 %). Hold øje med deres individuelle ydeevne for at bevare systemets sundhed.
Ud over CPU- og diskudnyttelse betragtes ventetider også som vigtige ved overvågning af infrastrukturens sundhed og ydeevne.
Have an account? Log In
Ventetider
Ventetider hjælper dig med at forstå, hvor effektivt opgaver udføres, og gør dig opmærksom på eventuelle flaskehalse. Men det er ikke tilstrækkeligt blot at kende ventetiderne. Du bliver nødt til at undersøge sagen yderligere for at identificere det præcise ydeevneproblem.
Høje ventetider er acceptable i korte perioder, fordi du måske har nogle intensive opgaver kørende, men alt derudover er normalt en grund til bekymring.
2. Serverens oppetid
Din server er ubrugelig, hvis den ikke er tilgængelig for dine brugere. Derfor er overvågning af serverens oppetid ufravigelig. Når serverens tilgængelighed falder til under 99.999 % (standarden, der kaldes “de fem niere,”), har du et alvorligt problem på hænderne.
Brug formlerne nedenfor til at få forståelige og handlingsanvisende indsigter fra din overvågningsindsats.
Sådan måler du serverens oppetid
Her er nogle centrale begreber, du bør kende, når du overvåger serverens oppetid:
- Driftstid: Den tid, hvor din tjeneste eller applikation er aktiv og tilgængelig for brugerne. Formel: (Samlet tid - Nedetid)/Samlet tid
- Gennemsnitlig tid mellem fejl (MTBF): Den gennemsnitlige tid mellem hændelser med nedetid. Formel: (Samlet tid - Nedetid)/Antal hændelser med nedetid
- Gennemsnitlig tid til løsning (MTTR): Den gennemsnitlige tid, der kræves for at løse et driftsudfald. Formel: Samlet nedetid/Antal hændelser med nedetid
- Gennemsnitlig tid til anerkendelse (MTTA): Den gennemsnitlige tid, der kræves for at anerkende et aktuelt driftsudfald. Formel: Samlet tid til anerkendelse/Antal hændelser med nedetid
Alle disse målepunkter hjælper med at danne et overblik, der illustrerer din infrastrukturs pålidelighed og dit teams reaktionsevne.
Så det er for eksempel godt at have en sund MTTR og MTTA. Men hvis du også har en høj MTBF, skal du undersøge de underliggende årsager til din servers nedetid nærmere. Ellers er virksomheden stadig i risiko for betydelige økonomiske tab og svækket brugertillid.
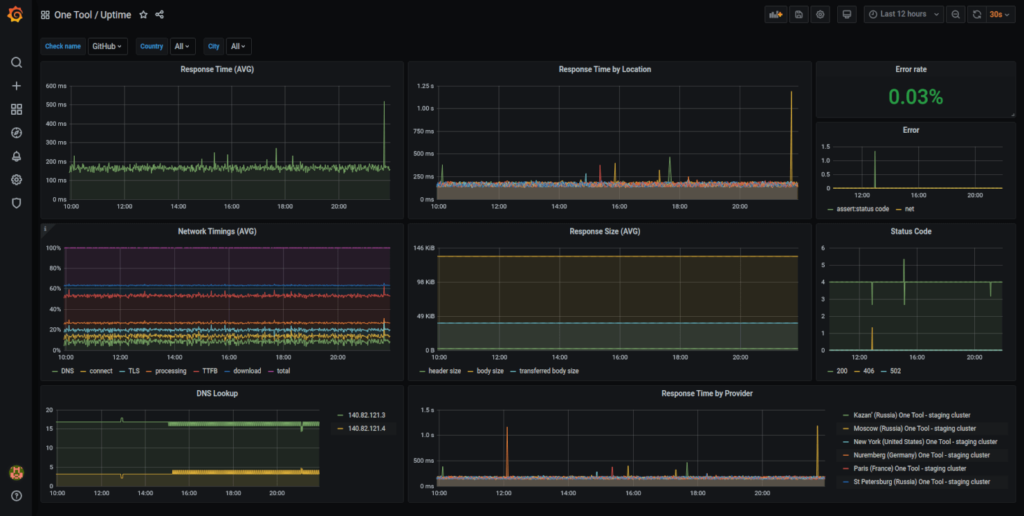
I sidste ende skal du stræbe efter “de fem niere,” hvilket betyder, at nedetiden højst må være cirka fem minutter om året. Serverovervågningssoftwaren Grafana og Prometheus anbefales begge ofte som brugervenlige og lettilgængelige værktøjer til dette aspekt af ydeevneovervågning.
3. Transaktioner (og fejlprocenter)
Du har brug for et klart billede af, hvor meget trafik din infrastruktur understøtter på et givent tidspunkt. Derfor er det vigtigt at holde øje med dine transaktioner – eller antallet af anmodninger pr. sekund – og den tilsvarende gennemsnitlige svartid. Disse oplysninger kan hjælpe dig med at bestemme, hvor mange ressourcer og hvilken kapacitet der er nødvendig for at køre serveren problemfrit.
Samtidig kan sporing af fejlprocenten, eller procentdelen af mislykkede anmodninger i forhold til det samlede antal modtagne anmodninger, give yderligere indsigt i din tjenestes belastningskapacitet. For at maksimere værdien af dette målepunkt er det bedst at etablere en baseline over tid via passiv overvågning.
Dette er afgørende for din evne til at overvåge tendenser. Hvis du kan se tilbage og fastslå den maksimale kapacitet og de ressourcer, der er nødvendige for en problemfri drift, kan du handle proaktivt ved at allokere disse nødvendigheder og identificere infrastrukturproblemer for at reducere de observerede fejlprocenter og optimere din gennemsnitlige svartid.
Sådan overvåger du transaktioner og fejlprocenter
Følgende er pålidelige værktøjer til passive teknikker til ydeevneovervågning:
- Netværkssniffere: Disse er designet til at indsamle målinger på et “mikroskopisk niveau” ved at “aflytte” trafikstrømmen på kablede og trådløse netværk. Wireshark er en af de mest udbredte standarder og indsamler data om attributter som tidsstempel, MAC- og IP-adresse, levetid og meget mere. Disse kan bruges online eller offline.
- Logningsfunktioner: Disse er normalt integreret i operativsystemerne og applikationerne. De indsamler primært oplysninger om de aktiviteter og hændelser, der genereres af applikationer, til offlinebrug.
Et af de ti bedste værktøjer til webserverovervågning, som er særligt velegnet til overvågning af transaktioner, er Monitis. Det er et alt-i-et-overvågningssystem til servere, websteder og applikationer. Det fungerer godt med både Windows- og Linux-systemer og er ideelt til at dække det grundlæggende, herunder driftstid.
Formålet med og målet for overvågningsindsatsen vil påvirke de præcise målinger og anvendelsen af disse teknikker.
More Articles
Andre målepunkter, der skal overvåges sammen med transaktioner
Svartid og det samlede antal tråde er direkte relateret til transaktioner. Disse oplysninger fortæller dig, hvor lang tid din server bruger på at svare på en anmodning, samt hvor mange tråde (som får transaktionerne til at finde sted) der bruges til at håndtere alle disse anmodninger.
Hver tråd bruger CPU-tid og RAM. For mange tråde kan føre til en ringere ydeevne. Der er en hel del at overvåge i forbindelse med disse, herunder:
- Det samlede antal tråde i en webserver eller containerpulje, herunder disse typer:
- Aktive
- Inaktive
- Fastlåste
- Standby
- Ventende brugeranmodninger og kølængde
Du kan typisk måle serverens svartid som Tid til første byte (TTFB). Dette er det antal millisekunder, det tager for en browser at modtage den første byte af et serversvar. Generelt er alt over fem sekunder kritisk.
Valg af de rigtige målinger til overvågning af serverens ydeevne
Der er en lang liste af målinger, som du kan overvåge, når du følger din servers tilstand og ydeevne, men de specifikke mål afhænger primært af formålet med din overvågning.
Mens nogle er bedst til at få indsigt i din hardwares og dit operativsystems belastningskapacitet, er andre ideelle til at observere brugeraktivitet. Under alle omstændigheder er CPU, oppetid og transaktioner grundlæggende forhold, der ikke må overses.
Efterhånden som du udvikler dig som QA-leder, og dine mål uundgåeligt ændrer sig, vil du uden tvivl tilføje flere målinger til overvågning af serveren på dit kontrolpanel. Hvis du vil have flere ekspertindsigter i, hvilke målinger det bør være, og hvordan du administrerer dem, kan du tilmelde dig nyhedsbrevet.


