
Hvor kodningsagenter hjælper, og hvor de fejler
Pedro Alves
Teknologidirektør hos Thoth AI
Pedro Alves forklarer, hvor AI-kodningsagenter kan gøre udviklingsarbejdet hurtigere, hvor de introducerer skjulte risici, og hvorfor erfarne udviklere fortsat er afgørende.
Key Takeaways
Kodningsagenter: Kodningsagenter kan fremskynde implementeringen, men menneskelig dømmekraft skal styre arkitektur, kvalitet og beslutninger i produktionen.
Skjulte fejl: AI-genereret kode kører ofte uden problemer, samtidig med at den skjuler logiske fejl, som erfarne fagfæller skal opdage.
Kreative mangler: Modeller håndterer veldefinerede oversættelsesopgaver godt, men mennesker skal bidrage med utraditionelle indsigter, forbindelser og centrale beslutninger.
Teamets løftestangseffekt: Organisationer får større udbytte ved at styrke erfarne fagfolk med AI end ved at forsøge at løfte uerfarne teams.
Central styring: Et lille AI-fokuseret team kan skabe genanvendelige arbejdsgange, reducere overlappende eksperimenter og forbedre udbredelsen på tværs af afdelinger.
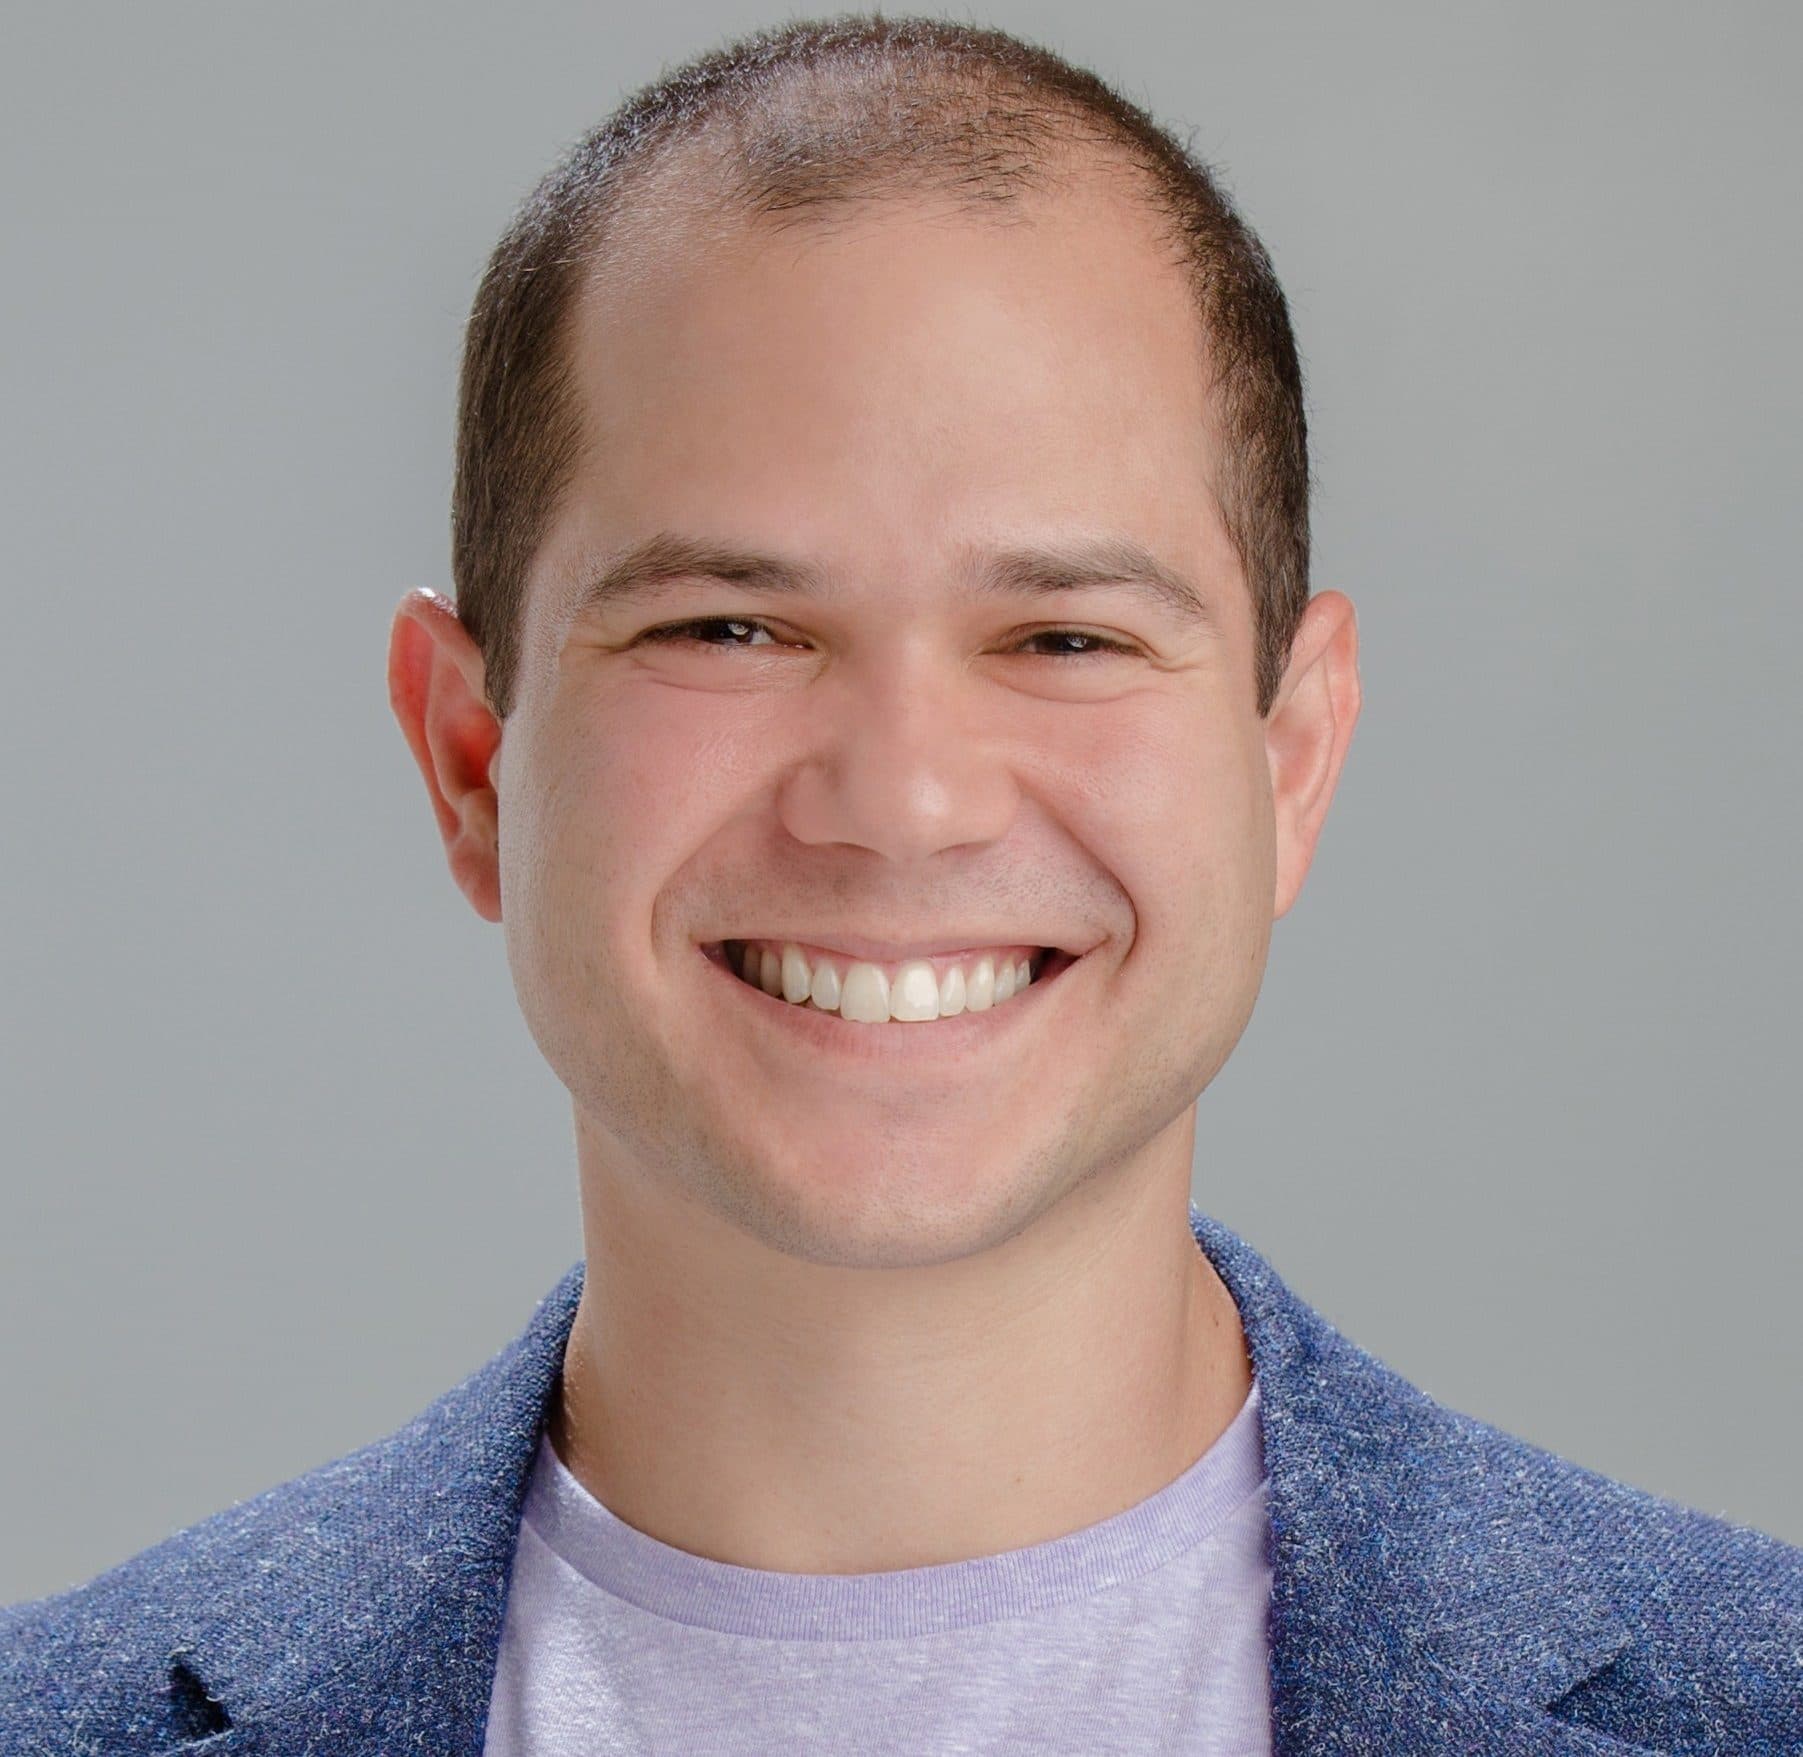
Pedro Alves har arbejdet intensivt med AI i 25 år. Han er i øjeblikket CTO hos Thoth AI og skaberen af Last Week in AI.
Vi satte os ned med Pedro for at tale om kodningsagenter — og hvorfor det er så vigtigt at vide, hvad de kan og ikke kan. Her er, hvad han fortalte os.
Før “AI” var noget, folk satte på præsentationer
Jeg hedder Pedro og er CTO hos Thoth AI. Jeg arbejdede med AI, før det var noget, folk satte på præsentationer — tilbage i 2001 byggede jeg som datalogistuderende en lille simuleret verden fuld af agenter og lod dem lære at overgå hinanden, en slags digitalt livsspil, hvor hele pointen var at se dem blive bedre. Det er 25 år siden, og jeg jagter stadig det samme spørgsmål: Hvordan får man et system til at forbedre sig?
Da tiden på universitetet nærmede sig, gik alle ud fra, at jeg ville tage en ph.d. i maskinlæring. Det gjorde jeg ikke. Det føltes for snævert og for teoretisk. Jeg ville lære håndværket gennem de mest omfattende og rodede data, jeg kunne finde, så jeg gik ind i beregningsbiologi: proteomik på min kandidatuddannelse og genomik på min ph.d. Jeg tilegnede mig maskinlæring, statistik og datavidenskab ved at anvende det — gen-gen-interaktionsnetværk, egenskabsudvikling, neurale netværk og ensemblemetoder — på problemer, hvor det havde en pris at tage fejl.
Det var dér, jeg lærte den lektie, der har præget alt siden. Inden for medicin byggede jeg modeller for sygdomsudvikling, og det almindelige nøgletal — den samlede nøjagtighed — var ubrugeligt. En “god” model efter det mål bekræftede blot igen de tilfælde, lægerne allerede kendte, selvom hele værdien lå i de tilfælde, den ville overse. Så i stedet for at optimere nøjagtigheden optimerede jeg delvis AUC — grundlæggende modellens evne i de tilfælde, der betød noget. Det mål, nogen giver dig, er næsten aldrig det egentlige mål.
Derfra kom jeg rundt i forskellige brancher: disse medicinske modeller, en periode som konsulent for et professionelt fodboldhold, derefter Silicon Valley og flere år med computervision — dengang man stadig var nødt til at innovere i måden, man trænede og endda initialiserede et netværks vægte på, for overhovedet at få detektion og klassifikation til at fungere. Jeg arbejdede med data fra sociale netværk, detailhandel, mode og video. Jeg brugte et år på at bygge handelsalgoritmer med genetiske algoritmer og partikel-sværmoptimering — ikke-parametriske optimeringsmetoder, som jeg havde skrevet artikler om på universitetet. Til sidst startede jeg min egen virksomhed, hvor jeg byggede AI-værktøjer til mennesker, der ikke var dataforskere.
Bredden forbinder det hele. Efter et dusin fagområder bliver jeg ved med at se det samme problem i forskellige forklædninger — et trick, der er indlysende inden for genomik, viser sig at være nøglen inden for computervision. Jeg går mere op i, hvordan et problem formuleres, end hvordan det løses, fordi det er i formuleringen, løftestangen ligger.
Det er det, der fører mig til Thoth. På papiret er vi en virksomhed inden for dataannotering. Men jeg mener, at det problem, hele området forsøger at løse, er det forkerte. Ingen ønsker annoterede data — data er blot det mellemliggende trin. De ønsker en bedre model. Derfor arbejder jeg hen imod en fremtid, hvor et system finder ud af, hvilke data din model har brug for for at blive bedre, og håndterer den del for dig, så du kan fokusere på modellen i stedet for mærkningen.
More Articles
Virksomhedens to sider
Strukturelt har Thoth AI to sider. Den ene side er motoren til dataoperationer, som opererer internationalt og i stor skala. Den er større end en typisk startup, men stadig meget mindre end de største virksomheder på området, så jeg vil kalde den mellemstor. Den anden side, den del jeg bygger, er et helt nyt forsknings- og innovationsteam her i Bay Area — i øjeblikket er vi fem, og flere kommer til i løbet af de næste par måneder. Her arbejder vi videre med resten af model-forbedringen: alt det, der ligger ud over mærkning.
Vores forskning har to hovedretninger. Den første er robotteknologi: at generere data fra den fysiske verden, evaluere dem og bruge aktiv læring til automatisk at generere de bedst mulige træningsdata, så robotter kan lære deres opgaver med så få data som muligt. Det meste bruger egocentriske data (grundlæggende optagelser fra et førstepersonsperspektiv), og vi fokuserer en stor del af vores arbejde på at producere egocentriske data af så høj kvalitet som muligt. Den anden retning er pålidelighed og effektivitet i sprogmodeller: at forstå, hvad der forårsager hallucinationer, og hvordan de ser ud, samt — når det gælder effektivitet — at genkende, hvornår en mindre model kan håndtere en forespørgsel, og derefter omformulere den eller dele den op i mindre dele, så en enklere og billigere model kan besvare den. Alt dette er forskning i dag med henblik på produkter, som vi vil lancere fra dette team.
Hvad angår udviklingstrin og størrelse: Datasiden er en etableret, mellemstor international organisation, mens det amerikanske forskningsteam bevidst befinder sig på et tidligt stadie. Vi er fem på vores kontor i San Mateo nu, og en eller to yderligere medarbejdere kommer til i løbet af de næste par måneder. Det er vores nuværende status.
Hvordan omfattende testning skaber pålidelige resultater
Pedro deler
Forberedelserne kører nu for det meste af sig selv. Men det er ikke den egentlige gevinst. Den større forbedring er kvaliteten: Mødet er skarpere og mere fokuseret, og de rigtige ting når pålideligt frem til den administrerende direktør.
Mange skynder sig at automatisere enhver opgave og funktion med AI, men jeg er forsigtig. AI gør det trivielt at bygge en demo. Det er noget andet at bygge noget, der er pålideligt til daglig brug. Når man bruger disse værktøjer i virkeligheden, støder man på kanttilfælde og særlige undtagelser, hvor automatiseringen næsten fungerer, men ikke helt. Derfor tester jeg grundigt, før jeg stoler på noget i en virkelig arbejdsgang.
I år byggede jeg AI-værktøjer til vores ugentlige gennemgangsmøde med den administrerende direktør, som levede op til den standard. Det sender e-mails til de ansvarlige for hvert område for at indsamle opdateringer, samler automatisk svarene, udarbejder rapporter, opsummeringer og dagsordenen samt følger resultaterne over tid.
Tidligere var alt dette manuelt. Nogen rykkede folk for opdateringer, samlede svarene manuelt, skrev opsummeringerne og dagsordenen og fulgte resultaterne fra uge til uge. Det fungerede, men det var langsomt, og dagsordenen kom nemt til at dreje sig om det seneste i stedet for det vigtigste.
Forberedelserne kører nu for det meste af sig selv. Men det er ikke den egentlige gevinst. Den større forbedring er kvaliteten: Mødet er skarpere og mere fokuseret, og de rigtige ting når pålideligt frem til den administrerende direktør. Det handler derfor mindre om den sparede tid og mere om at rette den administrerende direktørs opmærksomhed mod de beslutninger, der virkelig betyder noget.
Hvorfor dømmekraften forbliver menneskelig, mens AI fremskynder kodningen
AI driver nu selve kodningen næsten overalt. Mine forskere, ingeniørerne, der gør vores arbejde klar til produktion, og jeg bruger alle AI-kodeværktøjer. Det er menneskelig dømmekraft, ikke en bestemt opgavetype, der afgør, hvordan kode bliver bygget, og denne standard ændrer sig alt efter, hvor meget der står på spil.
På forskningssiden er målet som regel at få noget til at køre, ofte ved at oprette et GitHub-arkiv for at teste, om en idé er levedygtig. Intet går i produktion, så jeg er overbærende med, hvordan det er skrevet. Hvis det fungerer og besvarer spørgsmålet, er det tilstrækkeligt.
Produktion er anderledes. Hvordan vi bygger noget, betyder lige så meget som, om det kører, så vi bruger AI mere forsigtigt. Erfarne ingeniører har ansvaret for arkitekturen, kvaliteten og gennemgangene. AI fremskynder deres arbejde, men træffer ikke disse beslutninger. Den grænse forbliver menneskelig.
Teamets erfaring hjælper. De bruger AI anderledes end mindre erfarne personer. De ved allerede, hvordan noget godt ser ud, så modellen forstærker deres eksisterende dømmekraft i stedet for at erstatte den dømmekraft, som de stadig er ved at udvikle. Den gør dem hurtigere uden at erstatte den afgørende del.
Sådan bruger du kodeagenter effektivt
Næsten alle projekter har brug for én unik ting: en ikke-indlysende indsigt eller beslutning, som problemet kræver … Den del, der får et projekt til at fungere, er som regel ikke gennemsnitlig, og AI kan ikke nå frem til den på egen hånd. Det er min opgave at finde den. Derefter bygger AI alt det, der følger efter, hurtigere og bedre, end jeg kunne alene.
Overordnet set skyldes kodeagenters effektivitet, at jeg disciplinerer mig selv i forhold til teknologiens styrker og svagheder.
Jeg tænker på det som at male på et lærred. Målet er altid det samme: at tydeliggøre billedet i mit hoved og derefter bruge AI til at omsætte denne intention til fungerende kode så hurtigt som muligt. Dens succes afhænger af én variabel: hvor meget kreativt arbejde jeg selv beholder, og hvor meget jeg giver videre.
AI brillerer på det første niveau. Jeg kan se hele maleriet og lægge brede penselstrøg, mens AI udfylder detaljerne. Jeg ved præcis, hvad der skal bygges, og at omsætte en intention til kode er i bund og grund formelbaseret. Det er her, AI virkelig fungerer som en kraftmultiplikator, og det meste af mit daglige arbejde hører hjemme her.
Det andet niveau er nyttigt, men har større variation. Det ligner det første, men jeg lader med vilje nogle områder på lærredet stå åbne og beder modellen om at male noget dér. Det kræver en vis kreativitet, men min retning afgrænser stadig resultatet. Jeg betragter dette resultat som et udkast, ikke som et svar.
Jeg advarer folk mod det tredje niveau. Det indebærer at overlade den kreative kerne til AI: projektdefinitionen eller de vigtigste designbeslutninger. Det ser imponerende ud for en person, der ikke har dyb indsigt i området, men det klarer sig langt oftere dårligt end godt, fordi modellen udfylder et hul, som jeg selv burde have udfyldt.
Det hul er hele pointen. Næsten alle projekter har én unik ting, de har brug for: en ikke-indlysende indsigt eller beslutning, som problemet kræver. Som standard leverer modellen den gennemsnitlige løsning, det mest almindelige mønster fra dens træning. Det, der får et projekt til at fungere, er som regel ikke gennemsnitligt, og AI'en kan ikke nå frem til det på egen hånd. Det er min opgave at finde den del. Derefter bygger AI'en alt det, der følger efter hurtigere og bedre, end jeg kunne alene.
Hvordan kodningsagenter skaber fejl, der er svære at finde
Pedro deler
Det tydeligste gode resultat af kodningsagenter er hastighed. Kodningen går hurtigere, hvilket øger vores udrulningsfrekvens, og det handler ikke kun om rå hastighed. Ting, der var komplicerede at sætte op, er meget lettere nu. Den del er reel, og den betyder noget.
Det tydeligste gode resultat af kodningsagenter er hastighed. Kodningen går hurtigere, hvilket øger vores udrulningsfrekvens, og det handler ikke kun om rå hastighed. Ting, der var komplicerede at sætte op, er meget lettere nu. Den del er reel, og den betyder noget.
Et mere interessant resultat er, hvordan vores fejl har ændret sig. Fejlprocenten er ikke steget, men fejltyperne har ændret sig. AI sikrer, at koden kører. Den tjekker næsten altid dette, før den giver den tilbage til dig. Derfor opstår de enkleste fejl — dem, der bare udløser en fejl eller ikke vil køre — langt sjældnere. Det, der er tilbage, er logiske fejl, tilfælde som modellen ikke gennemtænkte, og de er sværere at opdage, netop fordi koden kører uden problemer.
Det er her, bagsiden viser sig. Disse fejl skjuler sig bedre. Hvis nogen mangler erfaring eller læner sig for meget op ad værktøjet, ser de koden køre og antager, at den er korrekt, selv om den ikke er det. Faren er ikke flere fejl; det er falsk selvtillid. Du har brug for nogen, der ved, hvad de skal kigge efter, for at opdage ting, der består testen "det kører", men stadig er forkerte.
Hvorfor AI bør bruges til at skalere erfarne medarbejdere i stedet for at forbedre svage medarbejdere
Det, der overraskede mig mest, var, hvor løftestangen kommer fra. Intuitivt kunne man tro, at AI sænker erfaringskravet, så man kan bemande billigere, mere juniorprægede teams og lade værktøjerne løfte deres niveau. Det modsatte viste sig at være tilfældet. Erfaring betyder mere nu, ikke mindre.
Det handler om pålidelighed. At bruge AI til at gøre én senioringeniør til fem senioringeniører er langt mere pålideligt end at gøre en junioringeniør til en senioringeniør. AI mangedobler den dømmekraft, du allerede har; den skaber ikke den dømmekraft, du mangler.
Så jeg skalerer mine stærkeste medarbejdere ud; jeg forsøger ikke at skalere mine svageste medarbejdere op. Nogle få erfarne medarbejdere, der hver især leverer flere gange så meget som før, slår hver gang et større blandet team.
Hvorfor mennesker skal bidrage med kreativiteten — ikke AI
AI har tydeligvis ikke leveret på de kreative og forbindende aspekter af forskning. Når jeg udfører teknisk arbejde med hjælp fra AI, skal et menneske stadig forbinde prikkerne: finde ud af, hvordan en andens arbejde kan udvides, forbinde to artikler på en måde, der giver mening, og foretage de logiske spring, man normalt tager for givet. Den del kræver stadig et menneske.
Det er ikke overraskende, når man husker, hvad disse modeller er. De er sandsynlighedsmaskiner. De producerer den tekst, der mest sandsynligt vil behage læseren. Vi bliver bedre til at træne dem i andre slags opgaver, men det bliver oprigtigt svært, når man forsøger at lære dem selve kreativiteten, fordi det er vanskeligt at opbygge træningssignalet.
Overvej datasæt. Et datasæt for, hvordan en hund ser ud, er nemt. Du samler mange billeder af hunde. Et datasæt for kreativitet i tegninger af hunde giver et andet problem. Forestil dig for eksempel en person, der tilføjer vinger til en hund. Pointen med eksemplet er ikke vingerne. Det er det abstrakte greb bag dem: at tage noget, der ikke hører til, og placere det et sted, hvor det ikke forventes. For at få en model til at forstå det har du brug for et enormt antal eksempler, så den lærer, at vingerne ikke er det vigtige; det er den kreative handling, der er det.
Selv hvis den når dertil, rammer du den næste mur. Tag nu den samme kreativitet, og anvend den på en matematisk ligning eller et stykke kode fra en artikel, så du bruger den til at udvide en andens algoritme. Det er ved den slags overførsel, det bryder sammen.
Folk læner sig op ad maskiner netop i den del, hvor de er svagest. Ironisk nok er løsningen billig. En smule menneskelig kreativitet rækker langt. Lad være med at læne dig for hårdt op ad maskinen på det punkt, så kommer du bemærkelsesværdigt langt.
Hvorfor CTO'er skal gentænke, hvordan AI-kompetencer bevæger sig gennem organisationer
Dette bliver ikke det populære råd lige nu, men jeg mener, at det er det fornuftige råd og det, der med størst sandsynlighed vil betale sig: Vær mere bevidst, end øjeblikket presser dig til at være.
Lige nu bruger virksomheder enorme summer på en simpel antagelse: Alle kan automatisere en del af deres arbejde med AI. Derfor sendes direktivet ud til alle. Ingeniører, datafolk, salg, marketing, hele virksomheden. Opret en konto, automatisér noget, byg dine egne værktøjer, kom i gang. Resultatet er en enorm mængde spildte kræfter: dobbeltarbejde, projekter, der ikke fører nogen steder hen, og værktøjer, som ingen bruger. Virksomheder brænder mange penge af på indsats, tid og tokens, der ikke skaber noget varigt.
Skab en reel proces omkring det. Centralisér det. Hav et lille centralt team, hvis opgave er at gøre alle andre teams bedre med AI. De udvikler arbejdsgange, genanvendelig kontekst, standarder og effektive mønstre og ruller dem derefter ud, så de enkelte ingeniører ikke hver især skal betale omkostningen for at finde frem til dem. Dette er den strukturelle version af det, jeg tidligere sagde om at koncentrere løftestangen hos jeres stærkeste medarbejdere: nogle få AI-kyndige ingeniører, der løfter hele organisationen.
Det giver to resultater på samme tid. Udnyttelsen stiger, fordi teams anvender gennemprøvede mønstre i stedet for at gætte sig frem. Og I får en stor mængde tid tilbage, som stille og roligt går tabt på eksperimenter, der aldrig behøvede at blive udført mere end én gang.
Dette bliver ikke det populære råd lige nu, men jeg mener, at det er det fornuftige råd og det, der med størst sandsynlighed vil betale sig: Vær mere bevidst, end øjeblikket presser dig til at være…Skab en reel proces omkring det. Centralisér det. Hav et lille centralt team, hvis opgave er at gøre alle andre teams bedre med AI.
Følg med
Du kan følge Pedro Alves' arbejde på LinkedIn eller abonnere på hans nyhedsbrev, Sidste uge i AI. Og se nærmere på Thoth AI.
Der kommer flere ekspertinterviews på The CTO Club!

