

3 serverövervakningsmått att följa för systemhälsa

Kvalitetssäkring kräver en kombination av proaktiva åtgärder och effektiva reaktiva protokoll. Med rätt balans kan du erbjuda användarna utmärkt service och funktionalitet på en server som är tillgänglig året runt. Det enda sättet att uppnå den balansen är att identifiera de mest relevanta mätvärdena för serverövervakning.
Men vilka skulle de kunna vara? Det beror på vilka egenskaper du eftersträvar, inklusive dem som beskrivs i modellen för kvalitetsmognad, samt på övervakningsmålen. Det finns ändå några hälso- och prestandamätvärden som QA-ingenjörer alltid bör hålla ett öga på, oavsett vad.
Genom att välja de idealiska mätvärdena för serverövervakning redan från början kan du skapa en prestandabaslinje att använda som referens när hälso- och prestandaproblem oundvikligen uppstår.

I den här korta guiden tittar vi på varför du bör följa dessa viktiga mätvärden. Dessutom får du ytterligare insikter i deras relevans och hur du följer dem.
1. CPU-användning
Ett av de främsta skälen till serverövervakning är att hålla koll på infrastrukturens hälsa och serverns grundläggande prestanda. En viktig del av detta är proaktiv diagnostisering och begränsning av potentiella prestandaproblem. Mätning av CPU- och diskanvändning är centralt i dessa insatser. Därför är CPU-användning ett av de mest grundläggande och vanligast övervakade prestandamätvärdena.
Detta mätvärde betraktas som “värdbaserat,” eftersom det registrerar en enskild maskins förmåga att fungera och förbli stabil. Med det sagt innebär övervakning av CPU-användning en kombination av passiv och aktiv övervakning. Den senare är särskilt användbar vid kontrollerade belastningstester, medan den förra samlar in mätningar från målet under verklig trafik.
Så mäter du CPU-utnyttjande
Innan du börjar behöver du:
- Välja de specifika enheter som du vill övervaka.
- Fastställa var dessa enheter finns.
- Se till att din datainsamlare har åtkomst till datorns processer.
När allt är konfigurerat behöver du fastställa den samplingsfrekvens med vilken du vill följa dessa mätvärden. Du kan till exempel mäta CPU-användningen var 30:e sekund eller varje minut.
Det finns flera olika sätt att följa CPU-användningen, till exempel genom att använda Aktivitetshanteraren eller ett kommando som wmic CPU get load percentage i Windows-system. När du försöker få en övergripande bild av servern är det dock bäst att visa dessa data på en instrumentpanel.
Kom ihåg: CPU-prestandan påverkas av maskinvaruförhållanden, till exempel CPU-temperatur och fläkthastighet. Du kan vilja övervaka dessa faktorer tillsammans med utnyttjandet (uttryckt som en procentsats) i dessa två lägen, med viloläge undantaget.
Två viktiga saker som du bör övervaka noggrant är Privilegierad tid och Användartid, eftersom summan av dessa två ger Processortid, som definieras enligt följande:
- Privilegierad tid: Den procentandel av tiden som processorer använder för att köra processer som inte tillhör användaren (det vill säga kärnprocesser)
- Användartid: Den procentandel av tiden som processorer använder för att köra användarprocesser (till exempel kommandoskal, e-postserver och kompilator)
- Processortid: Den totala tid som CPU:n var upptagen
Tänk på att ett värde över 100 % inte alltid innebär att ett system är överbelastat. Om du till exempel har ett system med flera processorer betyder det bara att summan av de två eller fler CPU:erna är större än 100 % (till exempel 50 % och 60 %). Observera deras individuella prestanda för att upprätthålla systemets hälsa.
Förutom CPU- och diskanvändning anses även väntetider vara viktiga vid övervakning av infrastrukturens hälsa och prestanda.
Väntetider
Väntetider hjälper dig att förstå hur effektivt uppgifter körs och varnar dig för eventuella flaskhalsar. Men det räcker inte att bara känna till väntetiderna. Du behöver göra ytterligare efterforskningar för att identifiera det exakta prestandaproblemet.
Höga väntetider är acceptabla i korta perioder eftersom du kan ha vissa intensiva uppgifter som körs, men allt utöver det är vanligtvis en anledning till oro.
2. Serverns drifttid
Din server är värdelös om den inte är tillgänglig för användarna. Därför är övervakning av serverns drifttid inte förhandlingsbar. När serverns tillgänglighet faller under 99.999 % (den standard som kallas “fem nior,”) har du ett allvarligt problem att hantera.
Använd formlerna nedan för att få begripliga och handlingsbara insikter från dina övervakningsinsatser.
Så mäter du serverns drifttid
Här är några grundläggande begrepp du bör känna till när du övervakar serverns drifttid:
- Drifttid: Den tid som din tjänst eller applikation är aktiv och tillgänglig för användare. Formel: (Total tid - Driftstopp)/Total tid
- Genomsnittlig tid mellan fel (MTBF): Den genomsnittliga tiden mellan driftstoppsincidenter. Formel: (Total tid - Driftstopp)/Antal driftstoppsincidenter
- Genomsnittlig tid till lösning (MTTR): Den genomsnittliga tid som krävs för att lösa ett avbrott. Formel: Total driftstoppstid/Antal driftstoppsincidenter
- Genomsnittlig tid till bekräftelse (MTTA): Den genomsnittliga tid som krävs för att bekräfta ett pågående avbrott. Formel: Total tid till bekräftelse/Antal driftstoppsincidenter
Alla dessa mätvärden bidrar till att skapa en helhetsbild av din infrastrukturs tillförlitlighet och ditt teams reaktionsförmåga.
Att till exempel ha bra MTTR och MTTA är positivt. Men om du även har hög MTBF behöver du undersöka grundorsakerna till serverns driftstopp ytterligare. Annars löper företaget fortfarande risk för betydande ekonomiska förluster och försämrat användarförtroende.
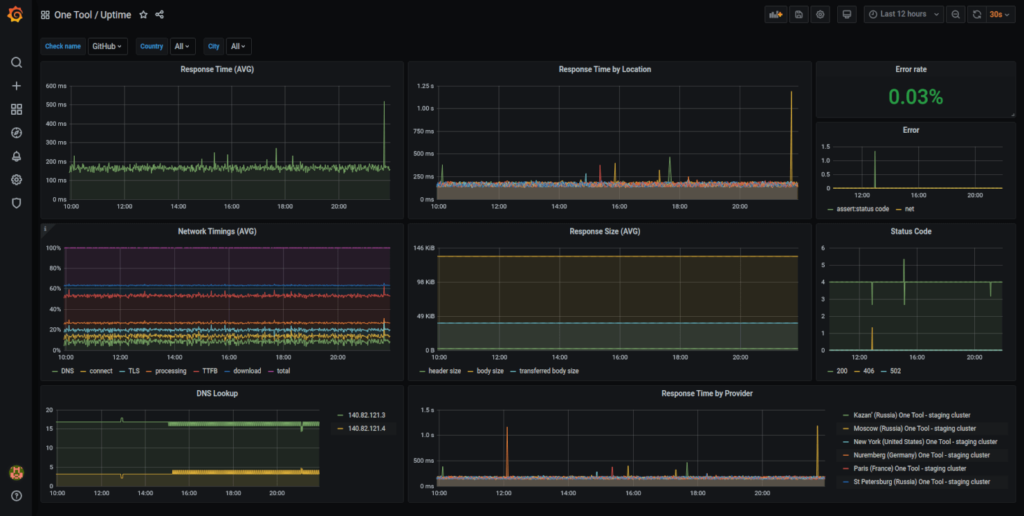
I slutändan måste du sträva efter ”fem nior”, vilket innebär att driftstoppet begränsas till högst ungefär fem minuter per år. Programvarorna Grafana och Prometheus för serverövervakning rekommenderas båda ofta som användarvänliga och lättillgängliga verktyg för denna del av prestandaövervakningen.
3. Transaktioner (och felfrekvenser)
Du behöver en tydlig bild av hur mycket trafik din infrastruktur stöder vid varje given tidpunkt. Därför är det viktigt att hålla koll på dina transaktioner – eller antalet förfrågningar per sekund – och den motsvarande genomsnittliga svarstiden. Denna information kan hjälpa dig att avgöra hur mycket resurser och kapacitet som krävs för att köra servern smidigt.
Samtidigt kan övervakning av felfrekvensen, alltså andelen misslyckade förfrågningar i förhållande till det totala antalet mottagna, ge ytterligare insikter om tjänstens belastningskapacitet. För att maximera värdet av detta mätvärde är det bäst att skapa ett basvärde över tid genom passiv övervakning.
Detta är avgörande för din förmåga att övervaka trender. Om du kan blicka tillbaka och fastställa den maximala kapaciteten och de resurser som krävs för smidig drift kan du agera proaktivt genom att tilldela dessa resurser och identifiera infrastrukturproblem för att minska de observerade felfrekvenserna och optimera den genomsnittliga svarstiden.
Så övervakar du transaktioner och felfrekvenser
Följande är tillförlitliga verktyg för passiva prestandaövervakningstekniker:
- Nätverkssniffare: Dessa är utformade för att samla in mätningar på ”mikroskopisk nivå” genom att ”avlyssna” trafikflödet i trådbundna och trådlösa nätverk. Wireshark är en av de mest allmänt accepterade standarderna och samlar in data om attribut som tidsstämpel, MAC- och IP-adress, livslängd och mer. Dessa kan användas online eller offline.
- Loggningsfunktioner: Dessa är vanligtvis integrerade i operativsystem och applikationer. De samlar främst in information om aktiviteter och händelser som genereras av applikationer för offlineanvändning.
Ett av de tio bästa verktygen för övervakning av webbservrar som är särskilt bra för att övervaka transaktioner är Monitis. Det är ett allt-i-ett-övervakningssystem för servrar, webbplatser och applikationer. Det fungerar bra för både Windows- och Linux-system och är idealiskt för att täcka grunderna, inklusive drifttid.
Övervakningsinsatsernas syfte och mål påverkar de exakta mätningarna och användningen av dessa tekniker.
Andra mätvärden att övervaka tillsammans med transaktioner
Svarstid och det totala antalet trådar är direkt relaterade till transaktioner. Dessa visar hur lång tid det tar för servern att svara på en förfrågan och hur många trådar (som gör att transaktionerna kan genomföras) som används för att hantera alla dessa förfrågningar.
Varje tråd använder processortid och RAM. För många trådar kan leda till sämre prestanda. Det finns en hel del att övervaka när det gäller dessa, bland annat:
- Det totala antalet trådar i en webbserver eller containerpool, inklusive följande typer:
- Aktiva
- Inaktiva
- Fastnade
- Vilande
- Väntande användarförfrågningar och kölängd
Du kan vanligtvis mäta serverns svarstid som tid till första byte (TTFB). Detta är antalet millisekunder det tar för en webbläsare att ta emot den första byten i ett serversvar. Generellt är allt över fem sekunder kritiskt.
Välja rätt mätvärden för övervakning av serverprestanda
Det finns en lång lista med mätvärden som du kan övervaka när du följer serverns hälsa och prestanda, men de specifika målen beror främst på syftet med din övervakning.
Vissa mätvärden är bäst för att få insikter om belastningskapaciteten hos din maskinvara och ditt operativsystem, medan andra är idealiska för att observera användaraktivitet. Oavsett vilket är CPU, drifttid och transaktioner grundläggande faktorer som inte får förbises.
När du utvecklas som QA-ledare och dina mål oundvikligen förändras kommer du utan tvekan att lägga till fler mätvärden för serverövervakning i din instrumentpanel. För fler expertinsikter om vilka dessa bör vara och hur du hanterar dem kan du prenumerera på nyhetsbrevet.

