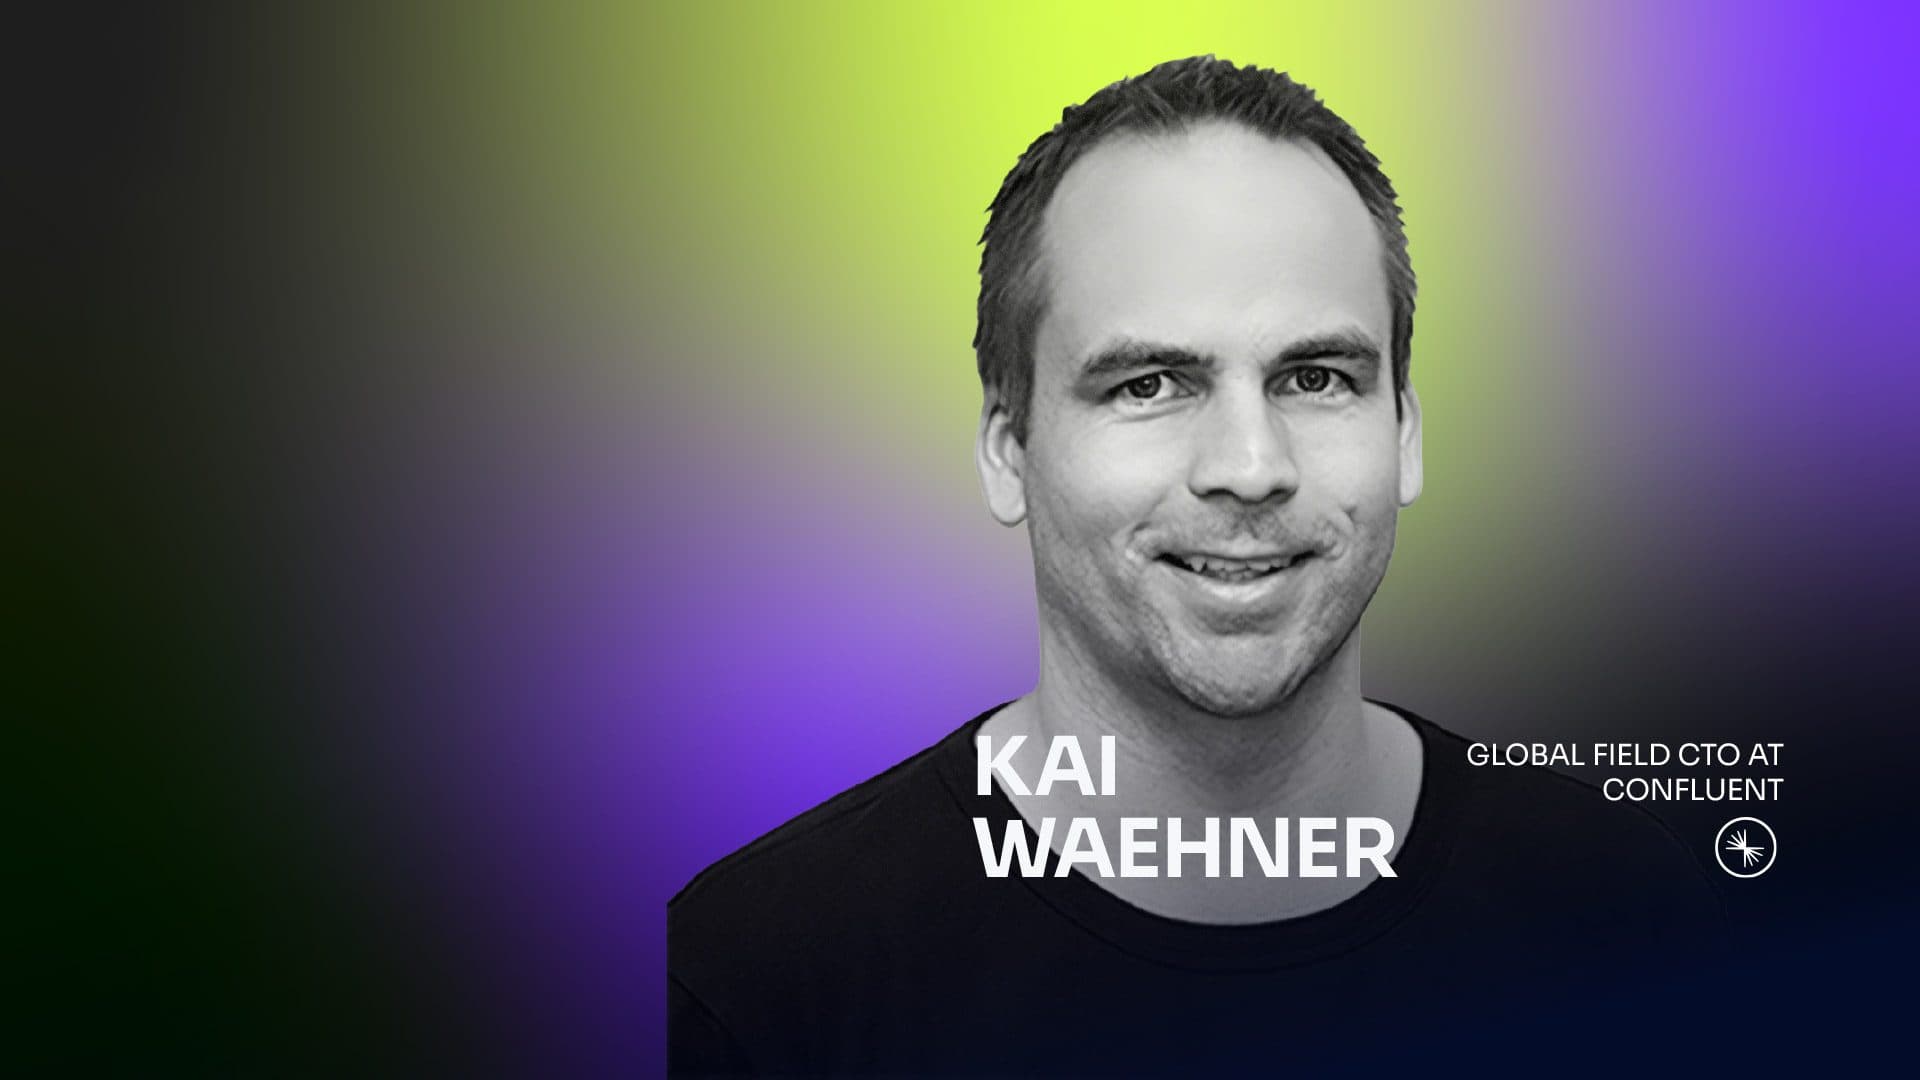
Global fältchef för teknik uppmanar ledare att fokusera på datainfrastruktur före AI
Kai Waehner
Global fältchef för teknik på Confluent
Upptäck varför AI-projekt i företag misslyckas utan en stark datainfrastruktur och hur ledare kan bygga styrda realtidssystem som stöder en tillförlitlig AI-användning.
Key Takeaways
Mönsterigenkänning: Kai Waehners erfarenhet sträcker sig över hela världen, vilket ger en unik fördel genom mönsterigenkänning inom företags-AI.
Fokus på infrastruktur: Framgång inom företags-AI bygger på sammanlänkade arkitekturlager: data, processautomatisering och AI-strategier.
Datamognad: AI-projekt lyckas eller misslyckas ofta beroende på datainfrastrukturen, inte på den valda modellen.
Integrerad AI: Att integrera AI i befintliga arbetsflöden förbättrar prestanda, styrning och granskningsbarhet.
Säkerhetsproblem: AI-genererad kod kan medföra sårbarheter; noggrann granskning och testning är avgörande.
Kai Waehner är global fält-CTO på Confluent och har gett råd till stora företag som BMW och Siemens. Hans fokus ligger på datainfrastruktur, integrationsstrategi och införande av AI.
Vi pratade med Kai för att förstå varför så många AI-initiativ inom företag misslyckas. Här är vad han hade att säga.
En fördel genom mönsterigenkänning
Jag heter Kai Waehner. Under de senaste nio åren har jag varit global fält-CTO på Confluent och arbetat med hundratals företag i Nordamerika, Europa och Asien och Stillahavsområdet. Jag har gett råd till företag som BMW, Volkswagen, Lufthansa, Siemens, DISH Networks och Globe Telecom. Jag arbetar med företagsledare kring teknikstrategi, genomförande av marknadsintroduktioner, leverantörsutvärdering, företagsarkitektur och innehållsskapande.
Rollen som fält-CTO skiljer sig från att leda en enskild teknisk organisation. Jag arbetar samtidigt i dussintals kundmiljöer och ger arkitekter och företagsledare råd om datainfrastruktur, integrationsstrategi och införande av AI. Den bredden ger mig en fördel genom mönsterigenkänning som är svår att få inifrån ett enda företag.
Min bakgrund spänner över hela historien för integration av företagsdata: ETL, ESB, iPaaS och API-hantering, följt av nio år med fokus på dataströmning där Apache Kafka och Flink utgör ryggraden i händelsestyrda arkitekturer, och i allt högre grad processorkestrering och AI över hela spektrumet, från prediktiv maskininlärning till generativ och agentbaserad AI. Jag informerar regelbundet analytiker på Gartner och Forrester och publicerar min egen forskning om leverantörslandskap, arkitekturmönster och verkliga branschfallstudier. Jag har också publicerat en bok om dataströmning.
Samtalet om AI-transformation som jag har med teknikledare handlar inte främst om modeller. Det handlar om infrastrukturen under dem. Agentbaserade AI-system som vidtar autonoma åtgärder i företagens arbetsflöden behöver tre saker för att fungera tillförlitligt:
- Data i realtid så att de agerar utifrån den aktuella verkligheten
- Processintelligens som definierar vad de får göra
- Inbyggd tillit i arkitekturen, inte bara i modellen
Det är denna konvergens som mitt tänkande fokuserar på.
More Articles
Varför arkitekturlager måste konvergera för att AI ska lyckas
Över branschgränserna ser jag konsekvent hur företag investerar stort i tre separata lager: en ryggrad för dataintegration, ett lager för processautomatisering och, i allt högre grad, ett AI-initiativ. Problemet är att dessa tre nästan aldrig utformas för att fungera tillsammans. Dataintegration flyttar data men kopplas inte till affärsbeslut. Processautomatisering upprätthåller arbetsflöden men körs med inaktuell kontext. AI-agenter genererar rekommendationer eller vidtar åtgärder, men saknar en styrd gräns för vad de får göra. Varje lager fungerar isolerat. Den konvergerade arkitekturen saknas.
De distributionsmodeller jag ser varierar avsevärt. Vissa organisationer kör helt hanterad molnbaserad infrastruktur i AWS, Azure eller GCP, och större globala företag omfattar ofta distributioner på det kinesiska fastlandet i Alibaba Cloud, som medvetet hålls åtskilda av juridiska, regulatoriska och dataskyddsmässiga skäl. Andra använder hybrida arkitekturer med lokala datacenter som är anslutna till molnet, drivet av krav på datasuveränitet eller äldre system som de inte snabbt kan flytta. Reglerade branscher som finansiella tjänster och hälso- och sjukvård har nästan alltid krav på flera regioner eller flera moln, inte av eget val utan på grund av efterlevnadskrav. Tillverkningskunder har ofta distributioner i kanten av nätverket där de bearbetar data nära fabriksgolvet innan den samlas centralt.
I alla dessa miljöer har händelsestyrd arkitektur blivit verksamhetskritisk infrastruktur. Apache Kafka har blivit den de facto-standardiserade händelseförmedlaren för verklig frikoppling mellan system, realtidsbearbetning i alla skalor samt hybrid- och multimolnintegration. PayPal bearbetar över en biljon Kafka-meddelanden dagligen. New Relic tar emot miljarder datapunkter per minut. Det här är inte experimentella distributioner. De utgör verksamhetens operativa ryggrad.
Många företag har redan de tre delar som behövs för tillförlitlig agentbaserad AI. Det som saknas är det arkitektoniska åtagandet att få dem att konvergera.
Varför datamognad kommer före AI-mognad
Kais tankar
AI-beredskap är data-beredskap.
Det här har jag kommit fram till: AI är inte den svåra delen. Det är datainfrastrukturen under den.
De flesta AI-initiativ inom företag som jag har sett lyckas eller misslyckas under de senaste nio åren har i mindre grad varit beroende av vilken modell som valts och i högre grad av huruvida organisationen hade en tillförlitlig, styrd grund i realtid för att förse modellen med aktuella, korrekta och tillförlitliga data.
En väljusterad modell som tar emot inaktuella eller inkonsekventa data kommer att producera opålitliga resultat. Ett agentiskt AI-system utan ett processlager som definierar vad det kan göra kommer förr eller senare att vidta en åtgärd som ingen kan förklara eller återkalla. Det här är inte modellproblem. Det är infrastruktur- och arkitekturproblem. Och de är helt förutsägbara innan en enda rad AI-kod skrivs.
Den praktiska innebörden är att AI-beredskap är databeredskap. Innan en modell väljs, innan en AI-leverantör utses och innan ett pilotprojekt lanseras bör en CTO ärligt kunna besvara tre frågor.
- Har organisationen tillförlitlig åtkomst till realtidsdata från sina operativa system?
- Finns det styrda processer som definierar vad ett AI-system får och inte får göra autonomt?
- Finns det ett ramverk för tillit på arkitekturnivå, inte bara inuti modellen, som kan upprätthålla dessa gränser i produktion?
Om svaret på någon av dessa tre frågor är nej bör AI-resan börja där, inte med modellen.
Varför AI måste integreras i befintliga affärsprocesser
Den mest betydande förändring jag har drivit igenom är att gå från att bygga AI som ett separat initiativ till att integrera det i befintliga affärsprocesser. Detta är kraftigt eftersatt och får stora konsekvenser. Faktum är att jag skulle säga att de flesta CTO:er bör gå från att utforma nya AI-system till att utforma hur AI deltar i befintliga arbetsflöden, vilka gränser processlagret upprätthåller och hur styrning och spårbarhet byggs in – innan en enda modell distribueras.
Innan jag genomförde denna förändring såg mönstret nästan alltid likadant ut. Ett AI-projekt startade frikopplat från de operativa systemen. Modellen presterade bra i laboratoriet. I produktion saknade den tillförlitlig åtkomst till aktuella data, en definierad gräns för sina åtgärder och integration i de godkännande arbetsflöden som verksamheten var beroende av. Imponerande demonstration. Misslyckad driftsättning.
Den förändring jag nu konsekvent förespråkar består av två delar.
- För det första: behandla den befintliga händelsedrivna arkitekturen som grunden för AI-implementering, snarare än som något som ska ersättas. Systemen finns kvar. Affärsprocesserna finns kvar. AI deltar i redan pågående arbetsflöden, konsumerar realtidshändelser och agerar inom de gränser som processlagret definierar.
- För det andra: flytta AI:s skyddsräcken från modellen till lagret för processorkestrering. En väljusterad modell räcker inte. Tillförlitlig AI i produktion innebär att arbetsflödeslagret upprätthåller godkännandegrindar, eskaleringsvägar och revisionsspår för varje autonom åtgärd som agenten vidtar.
Alpian, Schweiz första fullt licensierade digitala privatbank, är ett starkt exempel på hur detta kan göras rätt från dag ett. Alpian byggde hela sin plattform händelsedriven, med Apache Kafka som det centrala nervsystemet som kopplar samman mikrotjänster, domändataprodukter och AI-agenter. När de introducerade agentisk AI och RAG i arbetsflöden för kundinteraktion var arkitekturen redan redo. Kafka-händelser gav agenterna realtidskontext. Processlagret upprätthöll efterlevnadskontroller. De byggde in kryptering på fältnivå och schemastyrning från början.
Resultatet blev en reglerad finansiell institution som kör autonoma AI-agenter i styrda, spårbara arbetsflöden, vilket är exakt det mönster som de flesta traditionella företag nu försöker eftermontera.
Organisationer som lyckas med detta behandlar AI-implementering som en arkitektonisk disciplin, inte som en projektsprint.
Organisationer som lyckas med detta behandlar AI-implementering som en arkitektonisk disciplin, inte som en projektsprint…Skillnaden mellan bra och dåliga resultat beror nästan alltid på om datainfrastrukturen var redo innan AI introducerades.
Varför databeredskap avgör om AI-driftsättningen lyckas
Efter nio år på Confluent och arbete i hundratals företagsmiljöer har de AI-resultat jag sett varit djupt ojämna. Skillnaden mellan bra och dåliga resultat beror nästan alltid på en sak: om datainfrastrukturen var redo innan AI introducerades.
På den positiva sidan är siffrorna från väl utformade driftsättningar övertygande. BMW förhindrar över 500 minuter av oplanerade produktionsstopp per år vid en enda anläggning. Alpian driver en helt reglerad digital bank med agentbaserad AI integrerad i styrda och granskningsbara kundarbetsflöden. Det kvalitativa mönstret i framgångsrika driftsättningar är konsekvent: snabbare marknadsintroduktion, lägre driftskostnader i repetitiva arbetsflöden med stora volymer och en påtagligt bättre kundupplevelse när AI får tillgång till realtidskontext i stället för inaktuella batchdata.
På den negativa sidan är misslyckandemönstret lika konsekvent. AI-projekt utan en styrd datafundament ger nästan alltid samma resultat: imponerande demonstrationer, misslyckade produktionssättningar. Modellen fungerar i laboratoriet. I produktion får den inaktuella eller inkonsekventa data, hallucinerar i specialfall, vidtar åtgärder utan något granskningsspår och urholkar i stället för att bygga upp verksamhetens förtroende för AI. MIT-forskning uppskattar att omkring 95 % av företagens AI-pilotprojekt inte lyckas ge mätbar affärsnytta. Denna siffra stämmer överens med mina observationer i praktiken.
Det senaste misslyckandemönstret jag ser är att styrningen införs för sent. Organisationer implementerar agentbaserad AI och upptäcker sedan, vanligtvis efter en incident, att inget processlager har definierat vad agenten får göra, att det saknas en eskaleringsväg för osäkra modellresultat och att det inte finns något granskningsspår för att rekonstruera händelser. Det är inte ett AI-problem. Det är ett arkitekturproblem. Och det går helt och hållet att förebygga.
Varför AI ger beslutsunderlag, men människor står för ansvarsutkrävandet
Jag ser konsekvent ett mönster: AI ger beslutsunderlag och snabbar upp arbetet. Den fattar autonoma beslut inom definierade gränser. Men människor bär ansvaret för de beslut som har störst betydelse.
När det gäller AI som ger beslutsunderlag skapar forskningssammanställningar, innehållsskapande, kodgenerering för välavgränsade problem, automatiserade tester och säkerhetsskanning tydligt värde. I mitt eget arbete komprimerar AI-verktyg dagar av sammanställning av analytikerrapporter, kundsamtal och teknisk dokumentation. Resultatet kräver fortfarande expertbedömning för att valideras, men utgångspunkten ligger betydligt längre fram.
När det gäller autonoma beslut bör AI-agenter fatta beslut självständigt när risken är begränsad och processen är välstyrd. Bedrägeridetektering inom finansiella tjänster är det tydligaste exemplet. Under en definierad risktröskel blockerar en AI-agent automatiskt en transaktion utan någon människa i beslutsloopen. När transaktionsbeloppet ökar och den regulatoriska exponeringen växer vidarebefordrar orkestreringslagret för processer ärendet till en mänsklig analytiker innan någon åtgärd vidtas. Gränsen är inte fast. Verksamheten definierar den, arbetsflödet kodifierar den och processlagret upprätthåller den – inte modellen själv.
När det gäller sådant som uttryckligen ska hanteras av människor drar jag gränsen vid beslut med stora arkitektoniska konsekvenser, strategisk affärsrisk eller betydande regulatoriskt ansvarsutkrävande. Att välja ett grundläggande arkitekturmönster, välja en strategisk teknikleverantör och utforma styrningsmodellen för ett agentbaserat AI-system är fortfarande mänskliga beslut. Att arbeta snabbare återställer inte konsekvenserna av att fatta fel beslut.
Varför AI inte levererar tillräckligt inom tre huvudområden
AI har inte levererat den tekniska eller ingenjörsmässiga effekt som kunderna ursprungligen förväntade sig inom tre områden.
Det första är integration av företagsdata. AI lovade att dramatiskt förenkla sammankopplingen av heterogena system: schemamappning, upprätthållande av datakvalitet, transformationslogik och styrning i komplexa hybrida miljöer. I praktiken hjälper AI till med dessa uppgifter, men löser dem inte. En modell kan inte resonera sig förbi den underliggande arkitektoniska skulden, äldre system med odokumenterade datamodeller, inkonsekvent semantik mellan affärsenheter, saknade metadata och fragmenterat ägarskap. Ingenjörer måste fortfarande göra det svåra arbetet.
Det andra är agentbaserad AI i komplexa företagsarbetsflöden med flera steg. Demonstrationerna är övertygande. I produktion misslyckas agenter oförutsägbart när de stöter på specialfall som träningsdata inte täckte, när kontextfönstret saknar tillräckligt mycket aktuell status eller när processlagret inte på ett smidigt sätt fångar upp och hanterar agentfel. Skillnaden mellan vad en agent kan göra i en kontrollerad miljö och vad vi kan lita på att den gör autonomt i ett reglerat produktionsarbetsflöde är fortfarande betydande.
Det tredje är arkitektoniskt beslutsfattande. AI-verktyg har påtagligt snabbat upp rutinmässig kodning, testskrivning och dokumentation. Men de förbättrar inte på ett tillförlitligt sätt beslut om grundläggande arkitektur. Modeller återspeglar tidigare mönster. Företagsarkitektur kräver bedömningar av framtida begränsningar, regulatoriska utvecklingsvägar och tekniska satsningar som modeller inte kan göra väl. Team som förlitar sig för mycket på AI för arkitekturbeslut tenderar att skapa system som är lokalt sammanhängande men globalt sköra.
Den gemensamma nämnaren för alla tre områden är denna: AI levererar när problemet är välavgränsat, data är ren och aktuell och en människa med domänexpertis deltar i processen. AI levererar sämre överallt där problemet kräver kontextuellt omdöme, organisatorisk förändring eller arkitektoniskt tänkande som går utöver mönstermatchning mot historiska data.
Hur AI har svårt med säkerhet och skalbarhet i kod
Den mest konsekventa utmaningen jag ser uppstår i gränslandet mellan AI-genererad kod och ingenjörsmässiga bedömningar på produktionsnivå.
Verktyg för AI-kodgenerering är verkligen användbara för välavgränsade, repetitiva uppgifter: standardkod, testfall, dokumentation och enkla transformationer. Problemen uppstår när team utsträcker det förtroendet till arkitekturbeslut, säkerhetskänslig kod eller skalningskritiska komponenter utan noggrann mänsklig granskning.
På säkerhetssidan introducerar AI-genererad kod ofta subtila sårbarheter som passerar automatiserad skanning men fallerar under antagonistiska förhållanden. Promptinjektion är det tydligaste aktuella exemplet i agentbaserade AI-system. En agent som genererar eller kör kod baserat på användarindata utan korrekt indatavalidering och sandlådemiljöer skapar angreppsytor som är lätta att missa och svåra att upptäcka i efterhand. Jag har sett det här mönstret uppstå i tidiga implementeringar av agentbaserad AI, där team fokuserade på funktionalitet och snabbhet och behandlade säkerhetsgranskning som ett senare steg.
På skalningssidan tenderar AI-verktyg att generera lösningar som fungerar korrekt i liten skala men har dolda antaganden om datavolym, samtidighet eller fördröjning som först blir synliga under produktionsbelastning. En genererad Kafka-konsument som fungerar bra i tester kan fallera oförutsägbart vid tio tusen händelser per sekund om den genererade koden inte tar hänsyn till ombalansering av partitioner, hantering av offsetvärden eller hantering av mottryck. Modellen känner inte till din produktionsmiljö. Den känner till mönster från träningsdata.
Det praktiska svaret är inte att sluta använda AI för kodgenerering. Det är att behandla AI-genererad kod på samma sätt som du skulle behandla kod från en kompetent men junior ingenjör som aldrig har sett ditt produktionssystem. Granska den. Testa den under realistiska förhållanden. Och låt den aldrig komma nära säkerhetskritiska eller skalningskritiska delar utan godkännande från en senior ingenjör.
Vad teknikledare måste göra härnäst
Kais tankar
Investera i din datagrund innan dina AI-ambitioner…behandla AI-styrning som ett arkitekturproblem, inte ett policyproblem…tänk i båda riktningarna samtidigt.
Här är tre råd, i den ordning de spelar roll:
För det första: investera i din datagrund innan dina AI-ambitioner. Organisationer som uppnår mätbara AI-resultat är inte de som snabbast började använda en ny modell. De hade rena, realtidsbaserade och styrda data som flödade genom deras system innan AI-samtalet började. Om dina data är isolerade, inaktuella eller saknar styrning ska du åtgärda det först. Ingen modell kan kompensera för dåliga data i stor skala.
För det andra: behandla AI-styrning som ett arkitekturproblem, inte ett policyproblem. Det är nödvändigt men inte tillräckligt att skriva riktlinjer för ansvarsfull AI-användning. Det är processlagret som faktiskt styr agenternas beteende i produktion: arbetsflödesgrindarna, godkännandetrösklarna, eskaleringsvägarna och granskningsspåren som upprätthåller gränser oavsett vad modellen rekommenderar. Bygg in detta i arkitekturen från början. Att i efterhand införa styrning efter driftsättning är dyrt, opålitligt och sker vanligtvis efter att något har gått fel.
För det tredje: tänk i båda riktningarna samtidigt. Trycket underifrån att snabbt lansera AI-användningsfall är verkligt och legitimt. Det är även behovet uppifrån av en strategisk arkitektur som undviker att skapa fragmenterade punktlösningar som du kommer att ägna år åt att reda ut. De CTO:er jag ser navigera detta väl kan hålla båda perspektiven samtidigt: de går snabbt fram med specifika användningsfall samtidigt som de upprätthåller en tydlig arkitektonisk ledstjärna som håller dessa användningsfall komponerbara och styrbara över tid.
De organisationer som kommer att se tillbaka på den här perioden som en konkurrensfördel är inte de som började använda AI först. De byggde infrastrukturen som gör AI tillförlitlig och gick sedan snabbt fram med den grunden som bas.
Följ med
Du kan följa Kai Waehners arbete på hans webbplats, blogg och LinkedIn.
Fler expertintervjuer kommer på The CTO Club!