

Databricks jämfört med Cloudera: jämförelse och recensioner för 2026
Valet mellan Databricks och Cloudera handlar om hur ditt team hanterar data i moln- och hybridmiljöer. Jag jämför deras styrkor, avvägningar och mest lämpliga användningsområden.

We review tools independently, and commissions help fund our testing. See our transparency policy, our methodology, or suggest a tool.
As data environments spread across cloud, on-premises systems, and multiple pipelines, keeping ingestion and transformation workflows consistent gets harder. The right DataOps tool should help teams manage that complexity without creating more operational overhead.
Databricks and Cloudera both support large-scale data engineering and analytics, but they solve the problem from different starting points. Databricks centers on a lakehouse model with managed pipelines, streaming, governance, and AI, while Cloudera emphasizes hybrid data operations across cloud, data center, and edge environments.
In this article, I compare Databricks and Cloudera across features, pricing, security, ease of use, and best-fit scenarios to help you decide which platform suits your data strategy and infrastructure.
Databricks
4.5/5
- Free edition available + 14-day free trial
- From $0.15/DBU
Cloudera
4.1/5
- 60-day free trial
- From $0.04/CCU/hour
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

| Databricks | Cloudera | |
|---|---|---|
| Free Trial | Free edition available + 14-day free trial | 60-day free trial |
| Pricing | From $0.15/DBU | From $0.04/CCU/hour |
Databricks jämfört med Cloudera: priser och dolda kostnader
Databricks använder förbrukningsbaserad prissättning för datateknik, datalager, AI och andra arbetsbelastningar, där kostnaderna påverkas av användningen av beräkningsresurser samt molninfrastruktur, lagring, nätverk och support. Cloudera använder en hybridmodell: dess molntjänster faktureras efter förbrukning genom Cloudera Compute Units (CCUs), medan lokala driftsättningar använder årsabonnemang. I båda fallen kan infrastruktur och nätverk öka den totala kostnaden utöver plattformsavgifterna.
Vid en jämförelse är det bra att se bortom den angivna prissättningen och kartlägga var dina arbetsbelastningar kommer att köras och hur ofta datapipelines, strömningsjobb och transformationer körs. Med Databricks kan ineffektiv eller långvarig användning av beräkningsresurser och dataöverföring öka kostnaderna. Cloudera kan samtidigt medföra kostnader för infrastruktur, nätverk, Private Link, observerbarhet och tjänster som Data Flow eller Lakehouse Optimizer. Om du tar hänsyn till driftsättningsmodell, arbetsbelastningens volym, support och skalningsbehov får du en mer realistisk bild av den långsiktiga kostnaden.
| Databricks | Cloudera | |
|---|---|---|
| A/B Testing | No | No |
| Analytics | Yes | Yes |
| API | Yes | Yes |
| Conversion Tracking | No | No |
| Custom Reports | Yes | Yes |
| Dashboards | Yes | Yes |
| Data Export | Yes | Yes |
| Data Import | Yes | Yes |
| Data Mining | Yes | Yes |
| Data Visualization | Yes | Yes |
| External Integrations | Yes | Yes |
| Forecasting | Yes | Yes |
| Keyword Tracking | No | No |
| Link Tracking | No | No |
| Multi-User | Yes | Yes |
| Notifications | Yes | Yes |
| Reports | Yes | Yes |
| Scenario Planning | No | No |
| SEO | No | No |
| Visualization | Yes | Yes |
| Integrationer | Databricks | Cloudera |
|---|---|---|
| IntegrationerMicrosoft Azure | Databricks✅ | Cloudera✅ |
| IntegrationerAmazon Web Services | Databricks✅ | Cloudera✅ |
| IntegrationerGoogle Cloud Platform | Databricks✅ | Cloudera✅ |
| IntegrationerTableau | Databricks✅ | Cloudera✅ |
| IntegrationerInformatica | Databricks✅ | Cloudera✅ |
| IntegrationerSalesforce | Databricks✅ | Cloudera✅ |
| IntegrationerQlik | Databricks✅ | Cloudera✅ |
| IntegrationerOracle Database | Databricks✅ | Cloudera✅ |
| IntegrationerMongoDB | Databricks✅ | Cloudera✅ |
| IntegrationerAPI | Databricks✅ | Cloudera✅ |
| IntegrationerZapier | Databricks✅ | Cloudera❌ |
Både Databricks och Cloudera stöder breda ekosystem med molnplattformar, databaser, BI-verktyg, API:er och datatjänster. Databricks integrerar dessa anslutningar i Lakeflow, Partner Connect och sina hanterade arbetsflöden för datateknik, medan Cloudera betonar anslutningar mellan moln-, lokala och hybrida miljöer.
| Faktor | Databricks | Cloudera |
|---|---|---|
| FaktorKryptering | DatabricksKrypterar data i vila och under överföring, med stöd för kundhanterade nycklar, molnbaserad nyckelhantering och detaljerat skydd för styrda data- och AI-tillgångar. | ClouderaStöder kryptering i vila och under överföring, nyckelhantering och säkerhetskontroller i moln- och lokala miljöer. |
| FaktorÅtkomstkontroller | DatabricksUnity Catalog centraliserar detaljerade åtkomstprinciper för data, modeller, applikationer och AI-tillgångar, med SSO, identitetsintegrationer, rad- och kolumnkontroller samt arbetsytebindningar. | ClouderaAnvänder Apache Ranger, Knox och identitetsintegrationer för att hantera autentisering, auktorisering, SSO och detaljerad åtkomst i hybridmiljöer. |
| FaktorRegulatorisk efterlevnad | DatabricksHar certifieringarna SOC 1 Type II, SOC 2 Type II, ISO 27001, ISO 27017 och ISO 27018, med stöd för efterlevnad av HIPAA, PCI DSS, HITRUST samt FedRAMP Moderate och High beroende på moln, region och konfiguration. | ClouderaUpprätthåller certifieringar och program, inklusive SOC 2 Type II, ISO 27001, PCI DSS och FedRAMP Moderate för kvalificerade Cloudera-miljöer. |
| FaktorTillförlitlighet | DatabricksStöder automatisk skalning, serverlös och hanterad databehandling, isolering av arbetsbelastningar samt molnbaserad tillgänglighet i AWS, Azure och Google Cloud, med återställningsstrategier som konfigureras utifrån arbetsbelastningarnas krav. | ClouderaStöder distributioner över flera zoner, redundant infrastruktur, redundansväxling och katastrofåterställning i moln- och hybriddistributioner. |
| FaktorDatastyrning | DatabricksUnity Catalog tillhandahåller centraliserad granskning, upptäckt, klassificering och automatiserad datahärledning från källdata genom anteckningsböcker, jobb, modeller, tjänster och instrumentpaneler. | ClouderaSDX kombinerar Apache Ranger och Atlas för att tillämpa principer, granskning, metadatahantering, klassificering och datahärledning för data i moln- och lokala miljöer. |
Båda plattformarna erbjuder säkerhet och styrning på företagsnivå, men betoningen skiljer sig åt. Databricks samlar åtkomstkontroll, granskning, klassificering och datahärledning genom Unity Catalog för data- och AI-arbetsbelastningar, medan Cloudera utökar centraliserad styrning till hybrid- och lokala miljöer genom SDX, Ranger och Atlas.
| Faktor | Databricks | Cloudera |
|---|---|---|
| FaktorAnvändargränssnitt | DatabricksKombinerar samarbetande anteckningsböcker, SQL-verktyg, instrumentpaneler och visuella arbetsflöden i en arbetsyta för teknik-, analys- och AI-team. | ClouderaAnvänder administrationskonsoler och tjänstespecifika gränssnitt för hantering av data och hybridinfrastruktur. |
| FaktorInstallationsprocess | DatabricksMolnarbetsytor kan tillhandahållas snabbt, medan serverlös och hanterad databehandling minskar infrastrukturkonfigurationen för vanliga arbetsbelastningar. | ClouderaInstallationen beror på distributionsmodell, med ytterligare konfiguration för hybrid- och lokala miljöer. |
| FaktorIntroduktion | DatabricksErbjuder vägledd konfiguration, exempel på anteckningsböcker, utbildning och hanterade tjänster som hjälper team att gå från inledande experiment till styrda produktionsarbetsflöden. | ClouderaKräver kännedom om det bredare ekosystemet, särskilt när team arbetar med tekniker som NiFi, Spark, Ranger och hybridinfrastruktur. |
| FaktorDokumentation | DatabricksErbjuder omfattande dokumentation, handledningar, implementeringsvägledning och utbildning inom datateknik, styrning, analys och AI. | ClouderaTillhandahåller teknisk dokumentation för moln, lokala miljöer, säkerhet och plattformsadministration. |
| FaktorSupportåtkomst | DatabricksErbjuder offentliga resurser och nivåindelad betald support med tekniska kontaktpersoner, eskaleringsvägar och täckning för kritiska problem i företagsdistributioner. | ClouderaInkluderar företagssupport och tekniska resurser för moln- och lokala erbjudanden. |
Ur ett användarvänlighetsperspektiv kombinerar Databricks en teknisk utvecklingsmiljö med hanterade tjänster som minskar infrastrukturarbetet för datapipelines, analys och AI. Cloudera stöder moln-, lokala och hybridmiljöer, vilket medför ytterligare överväganden kring distributionen. För molnfokuserade datateam erbjuder Databricks ett sammanhängande arbetsflöde från utveckling till produktion, medan Cloudera passar organisationer som behöver arbeta med blandad infrastruktur.
Databricks
- Unifies data engineering, analytics, governance, and AI workloads, reducing the need to maintain separate platforms and duplicate data
- Built on open technologies like Delta Lake and Apache Spark, giving teams more flexibility and portability than proprietary data formats
- Unity Catalog applies governance and access policies consistently across data and workloads, which is useful for complex or multi-cloud environments
- Usage-based pricing can become difficult to predict as workloads grow, especially without careful compute and query optimization
- Requires strong technical expertise in areas like SQL, Python, Spark, and data engineering to get full value from the platform
- Can be excessive for teams with simple reporting or low-volume analytics needs, where the platform’s complexity may outweigh the benefits
Cloudera
- Handles petabyte-scale datasets with strong data governance tools
- Flexible deployment across on-premises, private, and public clouds
- Open-source architecture with full control over data location
- Interface is complex for smaller or less technical teams
- Initial setup and onboarding can be time-consuming
- Performance tuning requires deep technical expertise
Databricks
- Large EnterprisesOrganizations with multiple data teams and high-volume workloads can use Databricks to centralize data engineering, analytics, governance, and AI while reducing duplicated data and tooling.
- Financial ServicesBanks, insurers, and other financial organizations can use Databricks for governed analytics, fraud detection, risk modeling, and machine learning across sensitive datasets.
- Healthcare and Life SciencesHealthcare and life sciences teams can manage large, sensitive datasets while applying centralized governance to analytics, research, and AI workloads.
- Retail and Consumer GoodsRetailers can combine customer, transaction, inventory, and operational data for forecasting, personalization, supply chain analytics, and machine learning.
- ManufacturingManufacturers can bring together operational, IoT, and enterprise data for predictive maintenance, production analytics, forecasting, and AI-driven optimization.
- Technology and SoftwareTechnology companies with data-intensive products or services can use Databricks for large-scale pipelines, real-time analytics, ML development, and AI applications.
Cloudera
- Financial ServicesCloudera’s advanced governance, lineage, and security features make it a reliable fit for meeting banking and financial regulatory demands.
- Healthcare & Life SciencesStrict data governance, in-depth audit trails, and hybrid cloud options match healthcare’s compliance and privacy requirements.
- TelecommunicationsManaging massive data pipelines is easier with Cloudera’s Apache Spark, Kafka, and NiFi integrations.
- Large EnterprisesCloudera’s hybrid deployment support and control over complex infrastructures suit organizations with diverse, global operations.
- Data Engineering TeamsNative integration with tools like Apache Airflow, Impala, and Hive gives data engineers extensive workflow and processing flexibility.
- Government AgenciesFull data residency control, advanced security controls, and detailed auditing cater to public sector compliance standards.
Vem bör använda Databricks och vem bör använda Cloudera?
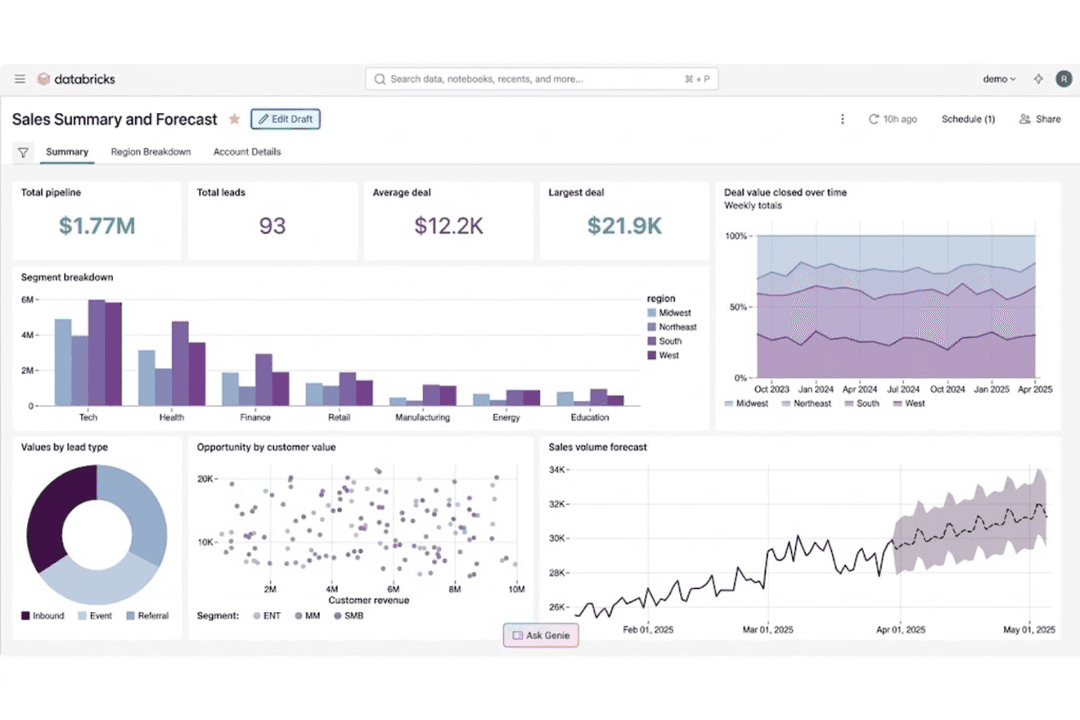
Om du letar efter en DataOps-plattform som samlar datateknik, analys, styrning och AI i samma molnfokuserade miljö är Databricks sannolikt det bättre valet. Den är särskilt användbar för team som vill ha hanterade datapipelines, samarbetande anteckningsböcker, stöd för strömmande data och centraliserad styrning utan att behöva hantera lika mycket infrastruktur manuellt.
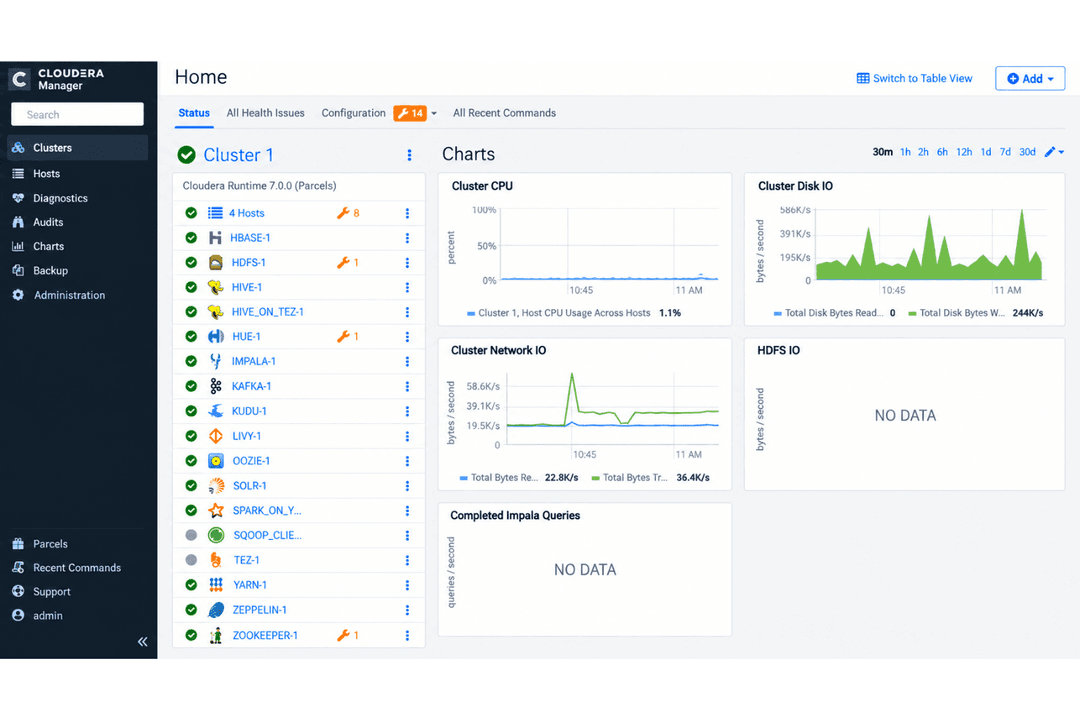
Om du i stället behöver köra dataarbetsflöden över moln-, lokala och hybrida miljöer kan Cloudera passa din infrastruktur bättre. Det är ett starkt val för företag med strikta krav på regelefterlevnad eller datalokalitet, etablerade ekosystem med öppen källkod och team som hanterar distribuerade dataplattformar över flera miljöer.
| Databricks | Cloudera | |
|---|---|---|
| Compute & Development | Databricks Workload-aware compute, autoscaling, and collaborative notebooks support engineering, SQL, and AI workloads without provisioning everything for peak demand. | Cloudera Provides configurable compute and data services designed to operate across cloud and on-premises infrastructure. |
| Data Intelligence | Databricks Its Data Intelligence Engine uses organizational metadata and context to improve discovery, governance, optimization, analytics, and AI workflows. | Cloudera Uses metadata, cataloging, and platform services to manage data and analytics across distributed environments. |
| Deployment Model | Databricks Runs as a cloud-native platform across AWS, Azure, and Google Cloud, with managed and serverless compute reducing infrastructure work across data and AI workloads. | Cloudera Extends across public cloud, private cloud, on-premises data centers, and edge environments. |
| Governance Model | Databricks Unity Catalog centralizes access policies, auditing, discovery, and lineage across data, models, applications, and AI assets. | Cloudera SDX combines technologies such as Apache Ranger and Atlas for policy enforcement, auditing, metadata, and lineage. |
| Lakehouse Foundation | Databricks Combines warehousing, engineering, BI, ML, and AI on a lakehouse built around open technologies such as Delta Lake and Apache Spark. | Cloudera Uses an open lakehouse approach based on technologies such as Apache Iceberg, HDFS, and the broader Apache ecosystem. |
| Analytics & Machine Learning | Both support SQL analytics, data science, machine learning, and AI workloads within their broader data platforms. |
|---|---|
| Apache Spark Support | Both use Apache Spark for distributed data processing and large-scale engineering workloads. |
| Batch & Streaming | Both process batch and real-time data for analytics, operational workflows, and downstream applications. |
| Data Integration & ETL | Both support ingestion, transformation, orchestration, and monitoring for large-scale data pipelines. |
| Integrations & APIs | Both connect with major cloud platforms, databases, BI tools, and enterprise systems and provide APIs for extending workflows. |