
Były założyciel technologiczny Meta dzieli się trzema rzeczami, które każdy CTO musi zrobić przed sięgnięciem po sztuczną inteligencję
James Everingham
Dyrektor generalny i współzałożyciel Guild.ai
James Everingham wyjaśnia, dlaczego CTO powinni traktować sztuczną inteligencję jak infrastrukturę, wcześnie ustanowić zasady zarządzania oraz pozwolić użytecznym narzędziom zdobyć akceptację zamiast narzucać ich stosowanie.
Key Takeaways
Zdobywaj akceptację: CTO powinni udowadniać wartość sztucznej inteligencji poprzez rozwiązywanie istotnych problemów, zamiast narzucać narzędzia, którym inżynierowie mogą się sprzeciwiać.
Zbuduj zasady zarządzania: Zasady zarządzania sztuczną inteligencją muszą poprzedzać jej wdrożenie, a budżety, mechanizmy kontroli dostępu i audytowanie należy uwzględnić w infrastrukturze od pierwszego dnia.
Przemyśl architekturę na nowo: Wyspecjalizowani agenci wymagają infrastruktury wspierającej koordynację, własność, odpowiedzialność i zarządzanie w stylu organizacji pracą zespołów w całych zespołach technicznych.
Weryfikuj wyniki: Inżynierowie mogą przyspieszyć pracę dzięki sztucznej inteligencji, ale przed wydaniem oprogramowania ocena człowieka musi zweryfikować kod, zagrożenia i gotowość do działania na produkcji.
Centralizuj ponowne wykorzystanie: Wspólna platforma agentów pozwala zespołom wyszukiwać, rozwijać na bazie istniejących rozwiązań, zarządzać nimi i je optymalizować, zamiast tworzyć wszystko od podstaw.
James Everingham kierował zespołami inżynieryjnymi w niektórych z najbardziej zaawansowanych firm na świecie, w tym w Mecie. Obecnie jest dyrektorem generalnym i współzałożycielem Guild.ai — płaszczyzny sterowania agentami AI, która zapewnia organizacjom jedno miejsce do wdrażania, zarządzania, monitorowania i optymalizowania każdego agenta działającego na produkcji.
Spotkaliśmy się z Jamesem, aby dowiedzieć się, jak AI zmienia przepływy pracy zespołów inżynieryjnych — oraz co te zespoły muszą zmienić, zanim AI będzie można skutecznie zintegrować. Oto, co nam powiedział.
Od Mety do startupu AI
Jestem dyrektorem generalnym i współzałożycielem Guild.ai — płaszczyzny sterowania agentami AI, która zapewnia organizacjom jedno miejsce do wdrażania, zarządzania, monitorowania i optymalizowania każdego agenta działającego na produkcji. Zebraliśmy 44 mln dolarów — w ramach rundy Series A prowadzonej przez Google Ventures, z udziałem NFX, Acrew, Scribble Ventures, Khosla Ventures i Webb Investment Network. Nasz zespół liczy około 35 osób i ma siedzibę w San Francisco.
Wcześniej byłem wiceprezesem ds. inżynierii w Meta DevInfra, gdzie tworzyłem i rozwijałem podstawowe narzędzia, usługi oraz platformy deweloperskie napędzające produkty Mety. Mój zespół stworzył pierwszego wewnętrznego agenta AI Mety, co natychmiast wpłynęło na sposób, w jaki inżynierowie Mety korzystali z narzędzi AI. Podczas pracy w Mecie współtworzyłem również Diem i pełniłem funkcję dyrektora ds. inżynierii Instagrama.
W ciągu 40-letniej kariery jako menedżer, przedsiębiorca i twórca technologii kierowałem wieloma światowej klasy zespołami inżynieryjnymi. W Yahoo byłem wiceprezesem ds. inżynierii odpowiedzialnym za serwisy medialne Yahoo po przejęciu przez firmę Luminate — założonej przeze mnie firmy zajmującej się interaktywną technologią obrazów. Wcześniej kierowałem zespołami w Oracle, Netscape Communications, Tellme (przejętej przez Microsoft) oraz w kilku własnych firmach.
More Articles
Jak AI pomogła usunąć coroczne zamrożenie kodu w Mecie
Kiedy pracowałem w Mecie, wykorzystaliśmy model ryzyka AI, aby zlikwidować coroczne zamrożenie kodu.
Wcześniej Meta co roku zamrażała bazę kodu od połowy grudnia do stycznia, ponieważ jest to okres największego ruchu w jej produktach. Przez lata, aby uniknąć incydentów na produkcji w najbardziej ryzykownych tygodniach, nikt nie wdrażał zmian. Było to bezpieczne, ale jednocześnie zatrzymywało produktywność całej firmy na ponad miesiąc.
Nie narzucajcie inżynierom odgórnego wymogu korzystania z AI — zapewnijcie im infrastrukturę: scentralizowaną platformę, sygnał ryzyka i płaszczyznę sterowania — a następnie pozwólcie im samodzielnie znaleźć sposoby na zwiększenie skuteczności.
Mój zespół stworzył i udostępnił jako oprogramowanie o otwartym kodzie źródłowym system Diff Risk Score oparty na modelu LLM, który ocenia prawdopodobieństwo, że różnica w kodzie spowoduje awarię produkcji. Zamiast traktować każdą zmianę jako równie niebezpieczną w okresie zamrożenia, model przeprowadzał ocenę ryzyka. Przypisywał każdej różnicy ciągłą ocenę ryzyka, dostrojoną pod kątem wysokiej czułości — na przykład oznaczając 10% różnic, a jednocześnie wykrywając 60% zmian, które faktycznie powodowały incydenty. Model umożliwiał wdrażanie różnic niskiego ryzyka nawet w okresie zamrożenia, ale wstrzymywał te, które oznaczył jako ryzykowne.
W rezultacie zamrożenie nie ma już charakteru „wszystko albo nic”. Diff Risk Score umożliwia Mecie rozpoczęcie całkowitego usuwania zamrożenia kodu — inżynierowie odzyskują tygodnie w kalendarzu, które wcześniej były bezproduktywnym czasem, bez rezygnowania z zabezpieczenia zapewnianego przez zamrożenie.
To dobry przykład mojej szerszej filozofii: nie narzucajcie inżynierom odgórnego wymogu korzystania z AI, zapewnijcie im infrastrukturę — scentralizowaną platformę, sygnał ryzyka i płaszczyznę sterowania — a następnie pozwólcie im samodzielnie znaleźć sposoby na zwiększenie skuteczności.
Dlaczego ludzie muszą umieć wyjaśnić kod, zanim trafi on na produkcję
Jeśli nie potrafisz tego wyjaśnić, nie możesz tego wdrożyć.
Intensywnie korzystam z narzędzi AI, aby przyspieszać pracę, ale doradzam inżynierom, aby zawsze wymagali walidacji, zanim cokolwiek trafi na produkcję. AI nie zastępuje inżynierskiego osądu — daje inżynierom większe możliwości stosowania tego osądu na dużą skalę.
AI dostarcza obecnie informacji zarówno w zakresie oceny ryzyka, jak i odkrywania narzędzi i przepływów pracy.
W czym ludzie są najlepsi:
- Zarządzanie i zabezpieczenia dotyczące samych agentów: Gdy zespoły głęboko osadzają modele rozumujące i agentów w infrastrukturze, szybko dostrzegają problemy z zarządzaniem — liczba agentów rośnie szybciej, niż ktokolwiek się spodziewał, a budżety znikają z dnia na dzień. Potrzebujesz takiej samej warstwy zarządzania wokół niedeterministycznych agentów, jaką wprowadziłbyś wokół ludzi korzystających z tej infrastruktury — co oznacza, że ludzie nadal ustalają limity budżetowe, zakresy dostępu i wymagania dotyczące audytu.
- Strategia wdrażania: Nie nakazuje się korzystania z narzędzi AI — korzystanie wynikające z przekonania jest skuteczniejsze niż korzystanie wymuszone, ponieważ nakazy prowadzą do powierzchownego wdrożenia. Decyzja o tym, jak zintegrować AI z przepływem pracy zespołu, jest jednoznacznie kwestią ludzkiego przywództwa i kultury — narzędzie może udowodnić swoją wartość, ale decyzji o wdrożeniu nie można zautomatyzować.
Dlaczego zespoły inżynieryjne muszą przemyśleć swoją architekturę
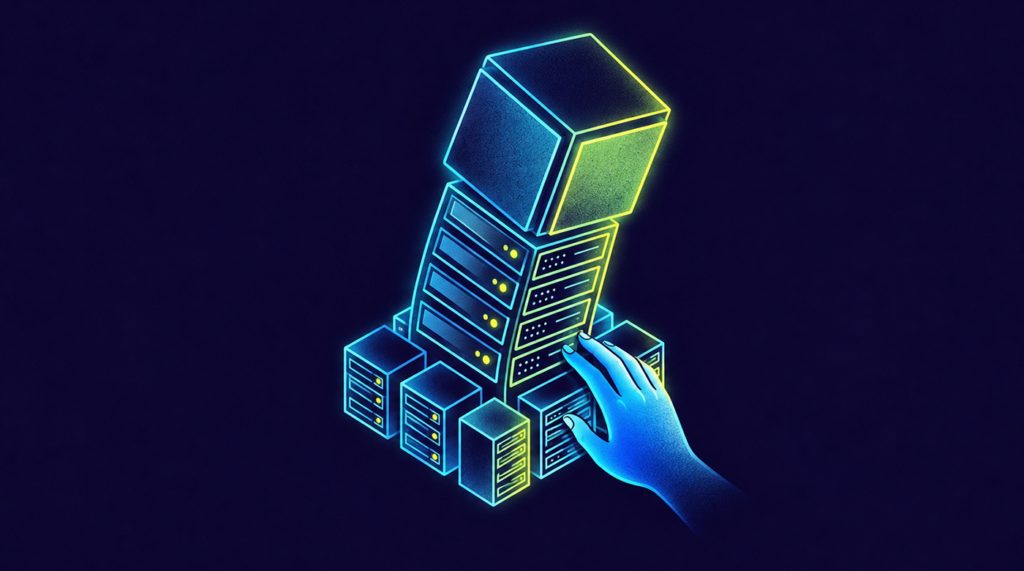
Wczesne komputery zaczynały od jednego komputera mainframe współdzielonego przez wszystkich, a następnie przeszły do szaf serwerowych z wyspecjalizowanymi usługami. Agenci podążają tą samą drogą.
Stare założenie polegało na tworzeniu garstki agentów ogólnego przeznaczenia i centralizowaniu wokół nich wykorzystania, podobnie jak centralizuje się moc obliczeniową. Firmy zdają sobie jednak sprawę, że ich rzeczywistość nie obejmuje garstki współdzielonych narzędzi — jest raczej zbliżona do ekosystemu wyspecjalizowanych agentów tworzonych do konkretnych celów. Wymusza to ponowne przemyślenie tego, co właściwie oznacza „architektura” w przypadku bazy kodu: mniej monolitu z wtyczkami, bardziej świata mikrousług, z tą różnicą, że usługami są agenci, a nie punkty końcowe.
W większości organizacji naturalnym odruchem jest traktowanie agenta jak każdego innego elementu oprogramowania — napisanie specyfikacji, wdrożenie go i oczekiwanie spójnych wyników. Porzuciłem to podejście i zastąpiłem je modelem myślowym opartym na sile roboczej. Zmienia to pytania dotyczące projektowania organizacji — kto zatwierdza poszczególne działania, kto odpowiada za budżet i kto ponosi odpowiedzialność, gdy coś się zepsuje — w pytania dotyczące zarządzania, a nie wdrażania. To inny sposób kształtowania relacji zespołu z jego narzędziami.
Dlaczego zarządzanie musi zostać wdrożone, zanim rozpowszechni się AI
W moich wcześniejszych rolach chciałbym, żebyśmy zbudowali warstwę zarządzania, zanim wdrożenie nabrało tempa, a nie dopiero później.
Kiedy pracowałem w Meta, inżynierowie zaczęli samodzielnie tworzyć i publikować agentów na wewnętrznej platformie; liczba agentów szybko rosła, a zespół infrastruktury nagle musiał gorączkowo nadążać za popytem — dosłownie próbując znaleźć dziesiątki tysięcy wolnych serwerów.
Z perspektywy czasu można było tego uniknąć. Jeśli zakładasz, że wdrożenie może wewnętrznie rozprzestrzenić się wirusowo, od pierwszego dnia budujesz mechanizmy kontroli kosztów i granice dostępu jako część platformy, zamiast traktować je jako awaryjne działania naprawcze.
Dyrektorzy ds. technologii muszą na nowo zaprojektować granicę między „gdzie znajduje się AI” a „czego AI może dotykać” — przenosząc ją z edytora do infrastruktury, ponieważ to właśnie na tym poziomie powstaje ryzyko i musi znajdować się nadzór.
James dzieli się
Dyrektorzy ds. technologii muszą na nowo zaprojektować granicę między “gdzie znajduje się AI” a “czego AI może dotykać” — przenosząc ją z edytora do infrastruktury, ponieważ to właśnie na tym poziomie powstaje ryzyko i musi znajdować się nadzór.


