

Jedno z moich ulubionych powiedzeń brzmi: „pracuj mądrzej, a nie ciężej”. Oczywiście dotyczy to również testowania oprogramowania. Oznacza to, że chcę wykonywać jak najmniej pracy i jednocześnie zapewniać jak największą wartość.
Porozmawiajmy więc o technikach testowania czarnoskrzynkowego i o tym, jak można je stosować do tworzenia przypadków testowych oraz znajdowania najważniejszych błędów w testowanej aplikacji.
Czym jest testowanie czarnoskrzynkowe?
Zacznijmy od zrozumienia, czym jest testowanie czarnoskrzynkowe — w przeciwieństwie do testowania białoskrzynkowego. Jest to rodzaj testowania oprogramowania, w którym tester nie ma dostępu do wewnętrznej struktury testowanej aplikacji. Może natomiast uzyskać dostęp wyłącznie do danych wejściowych i wyjściowych systemu oraz testować funkcjonalność oprogramowania na podstawie specyfikacji wymagań.
Należy pamiętać, że testowanie czarnoskrzynkowe obejmuje wyłącznie zewnętrzną funkcjonalność oprogramowania i nie weryfikuje wewnętrznego działania kodu źródłowego. Dlatego czasami nazywa się je „testowaniem behawioralnym”. Powinno więc być stosowane razem z testowaniem białoskrzynkowym, które koncentruje się na testowaniu kodu wewnętrznego. Dzięki temu można mieć większą pewność, że oprogramowanie zostało w pełni przetestowane i jest w możliwie dużym stopniu wolne od defektów.
Have an account? Log In
5 rodzajów technik testowania czarnoskrzynkowego
Stosujemy te techniki testowania czarnoskrzynkowego, aby zwiększyć pokrycie testami, a jednocześnie zmniejszyć liczbę przypadków testowych. Identyfikując właściwe dane testowe, możemy utworzyć minimalną liczbę testów zapewniających największe pokrycie.
Omawiane przeze mnie techniki można stosować na wszystkich poziomach testowania — w tym podczas testów jednostkowych, integracyjnych i systemowych, a także testów funkcjonalnych i niefunkcjonalnych.
1. Podział na klasy równoważności
Podział na klasy równoważności to technika stosowana w testowaniu oprogramowania do dzielenia możliwych danych wejściowych na zestaw klas równoważności lub partycji, w celu znalezienia i przetestowania reprezentatywnego zestawu danych wejściowych z każdej klasy. Oczekuje się, że wszystkie elementy należące do danej klasy równoważności dadzą taki sam wynik, dlatego przetestowanie pojedynczej wartości z zestawu powinno wystarczyć.
Pozwala to zmniejszyć liczbę przypadków testowych, które trzeba utworzyć i wykonać, zapewniając jednocześnie dobre pokrycie. Klasy definiuje się na podstawie wymagań funkcjonalnych lub niefunkcjonalnych, uwzględniając takie czynniki jak typy danych, zakresy i zależności między wartościami wejściowymi.
Definiując klasy równoważności, należy zawsze pamiętać o uwzględnieniu również nieprawidłowych klas, aby objąć testami także negatywne scenariusze testowe. Z mojego doświadczenia wynika, że większość defektów wykrywa się podczas korzystania z nieprawidłowych danych wejściowych, a nie z prawidłowych.
Przyjrzyjmy się przykładowi:
Masz opcjonalne pole, które pozwala wprowadzać wyłącznie wartości całkowite od 1 do 10. Otrzymasz następujące klasy równoważności:
- brak wartości (prawidłowa partycja)
- wartości od 1 do 10 (prawidłowa partycja)
- wartości mniejsze niż 1 (nieprawidłowa partycja)
- wartości większe niż 10 (nieprawidłowa partycja)
Potrzebujesz więc tylko 4 przypadków testowych — po 1 dla każdej partycji. Ponowne testowanie tej samej partycji z użyciem wielu wartości nie przyniesie dodatkowej wartości — jeśli przetestujesz wartość 5, uzyskasz takie same wyniki dla wartości 4, 8 itd.
2. Analiza wartości brzegowych
Analiza wartości brzegowych to technika stosowana w testowaniu oprogramowania do identyfikowania i testowania wartości wejściowych znajdujących się na granicy domeny danych wejściowych programu lub w jej pobliżu. Założenie jest takie, że te wartości z większym prawdopodobieństwem spowodują błędy lub nieoczekiwane działanie, ponieważ często obejmują przypadki specjalne lub brzegowe, których program mógł nie być zaprojektowany do prawidłowej obsługi.
Na przykład podczas testowania programu, który akceptuje liczby całkowite z zakresu od 1 do 100, wartościami brzegowymi będą 1, 100 oraz wszystkie wartości znajdujące się tuż poza zakresem, takie jak 0 i 101.
Dwa rodzaje testowania wartości brzegowych to:
- Testowanie wewnętrznych wartości brzegowych: koncentruje się na wartościach wejściowych znajdujących się tuż wewnątrz granicy domeny danych wejściowych, takich jak dozwolone wartości minimalne i maksymalne.
- Testowanie zewnętrznych wartości brzegowych: koncentruje się na wartościach wejściowych znajdujących się tuż poza granicą domeny danych wejściowych, takich jak wartości nieco większe lub mniejsze od dozwolonych wartości minimalnych i maksymalnych.
Analiza wartości brzegowych jest ważną techniką wykrywania błędów i zapewniania, że program działa poprawnie dla wszystkich danych wejściowych, a nie tylko dla tych znajdujących się w środkowej części dziedziny danych wejściowych. Może to pomóc w identyfikowaniu i naprawianiu błędów, które w przeciwnym razie mogłyby pozostać niezauważone.
3. Testowanie tabel decyzyjnych
W testowaniu tabel decyzyjnych sprawdzamy logikę i zachowanie oprogramowania, gdy dostępnych jest wiele warunków. Jest to sposób przedstawiania zależności między danymi wejściowymi a wynikami w formie tabeli. Tabela zazwyczaj zawiera kolumny dla warunków oraz wiersze dla różnych kombinacji. Dla każdego wiersza należy utworzyć konkretny przypadek testowy. Oczekiwany wynik przypadku testowego również powinien zostać uwzględniony w tabeli.
Wyobraźmy sobie przykład wymagania dotyczącego oprogramowania, w którym można zastosować tę technikę: aplikację obliczającą koszt zakupu na podstawie produktu, ilości i metody wysyłki:
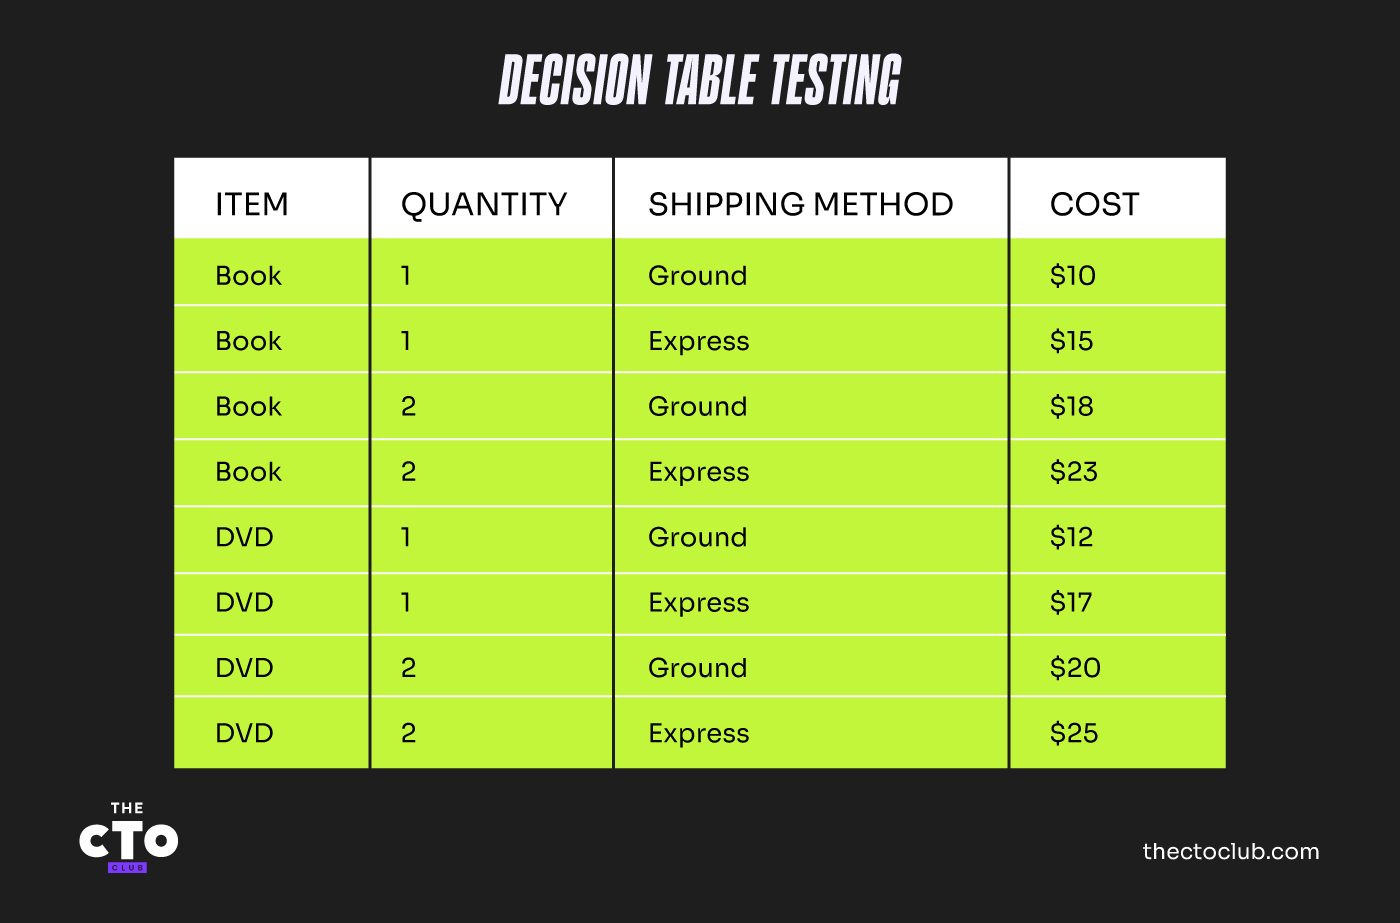
W tym przykładzie Produkt, Ilość i Metoda wysyłki są danymi wejściowymi, a Koszt jest wynikiem. Tabela przedstawia wszystkie możliwe kombinacje danych wejściowych oraz odpowiadający im wynik w każdym przypadku. Korzystając z tej tabeli, można szybko zidentyfikować przypadki testowe i ich oczekiwane rezultaty, co ułatwia testowanie i weryfikowanie dostępnych kombinacji.
Testowanie tabel decyzyjnych jest przydatne, gdy program ma wiele danych wejściowych i warunków, które oddziałują na siebie w złożony sposób. Rozbicie danych wejściowych i warunków na tabelę ułatwia identyfikowanie i testowanie wszystkich możliwych kombinacji oraz wariantów.
4. Testowanie przejść między stanami
Testowanie przejść między stanami to technika testowania czarnoskrzynkowego, w której sprawdzamy zachowanie programu podczas przechodzenia między różnymi stanami lub trybami. Stan to warunek lub zestaw warunków, w których program może się znajdować, a przejście to zmiana z jednego stanu do innego. Ideą testowania przejść między stanami jest zidentyfikowanie wszystkich możliwych stanów i przejść, przez które może przechodzić program, a następnie utworzenie przypadków testowych w celu sprawdzenia, czy program zachowuje się poprawnie w każdym stanie i wykonuje prawidłowe przejścia między stanami.
Przykładem testowania przejść między stanami może być witryna handlu elektronicznego, w której klienci mogą dodawać produkty do koszyka, przejść do kasy, wprowadzić informacje dotyczące płatności i dane wysyłki, a następnie złożyć zamówienie. Stanami w tym przykładzie byłyby:
- Przeglądanie produktów
- Dodawanie produktów do koszyka
- Przechodzenie do kasy
- Wprowadzanie danych płatności i wysyłki
- Potwierdzenie zamówienia
Przejścia między tymi stanami wyglądałyby następująco:
- Przeglądanie produktów -> Dodawanie produktów do koszyka
- Dodawanie produktów do koszyka -> Przechodzenie do kasy
- Przechodzenie do kasy -> Wprowadzanie danych płatności i wysyłki
- Wprowadzanie danych płatności i wysyłki -> Potwierdzenie zamówienia
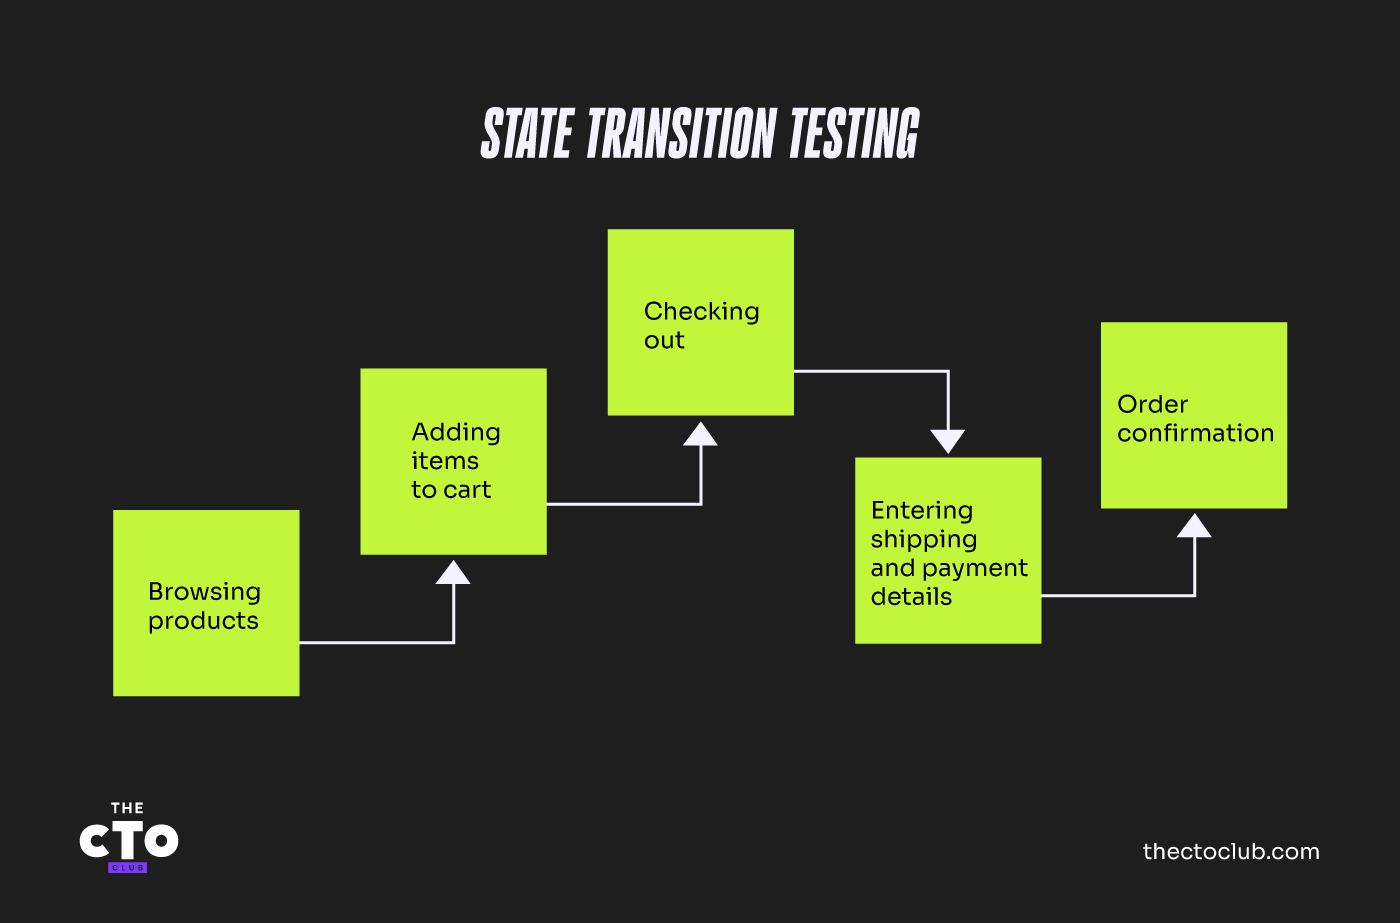
Ta technika pomaga identyfikować i testować wszystkie możliwe ścieżki, które użytkownik może przejść w systemie, oraz może pomóc w znajdowaniu i naprawianiu błędów związanych z określonymi przepływami. Testowanie przejść między stanami jest szczególnie przydatne podczas testowania systemów o złożonych interakcjach, takich jak systemy finansowe, systemy handlu elektronicznego lub systemy sterujące urządzeniami fizycznymi.
More Articles
5. Testowanie parami
Testowanie parami to technika testowania czarnoskrzynkowego stosowana do tworzenia przypadków testowych obejmujących wszystkie możliwe pary kombinacji wartości wejściowych dla danego zestawu parametrów. Stosuje się ją, gdy liczba dostępnych danych wejściowych jest duża, przez co przetestowanie wszystkich możliwych kombinacji między nimi byłoby niezwykle trudne.
Załóżmy, że mamy aplikację z 3 polami: A, B i C. Każde pole może przyjmować 3 możliwe wartości: 1, 2 lub 3.
W przypadku tradycyjnych metod testowania musielibyśmy przetestować indywidualnie 27 (3^3) możliwych kombinacji danych wejściowych, aby zweryfikować wszystkie możliwe kombinacje. Byłoby to niezwykle czasochłonne i nieefektywne.
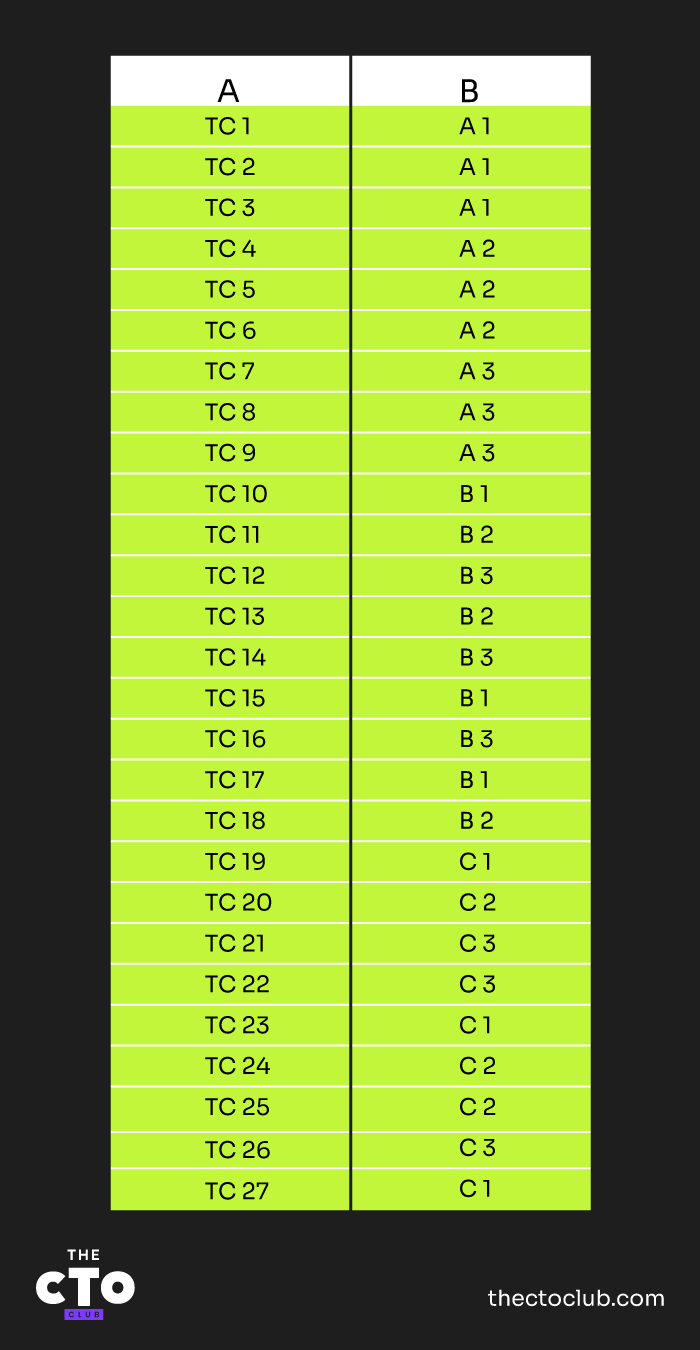
Dzięki testowaniu parami można zidentyfikować przypadki użycia obejmujące wszystkie możliwe unikalne kombinacje danych wejściowych. Wyglądałoby to mniej więcej tak:
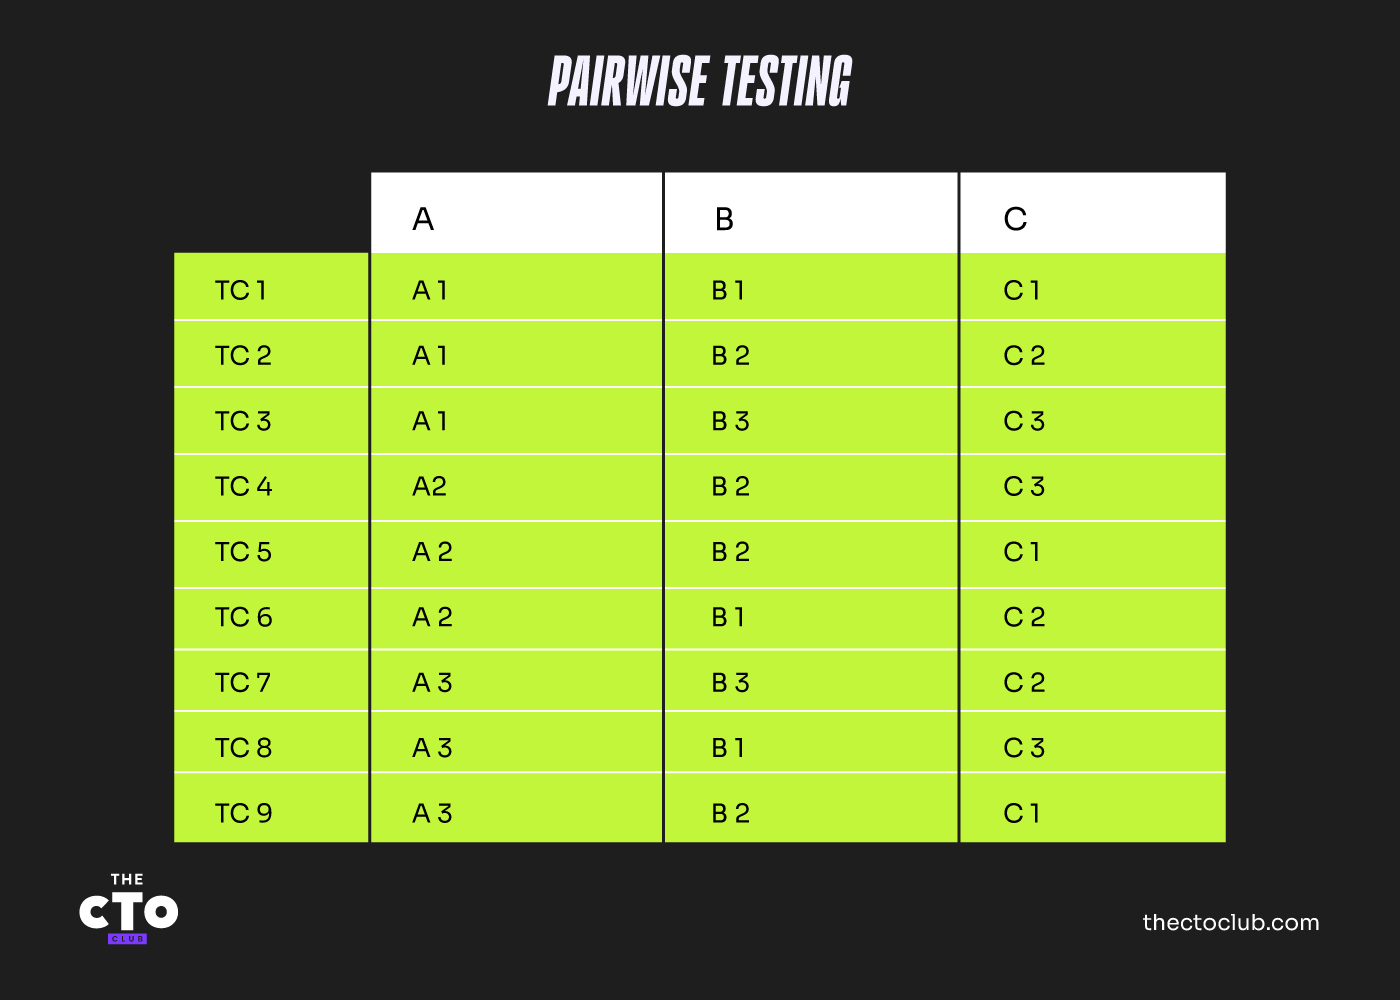
Jak widać, liczba testów została drastycznie zmniejszona — z 27 do 9. Pokrycie testami się nie zmieniło; nadal zapewniamy uwzględnienie wszystkich możliwych kombinacji wartości.
Dostępnych jest kilka narzędzi do testowania parami. Poniżej wymienię kilka przykładów:
- AllPairs: Narzędzie do tworzenia przypadków testowych dla par parametrów na podstawie określonych przez użytkownika list parametrów i ograniczeń. Jest dostępne zarówno w wersji o otwartym kodzie źródłowym, jak i komercyjnej.
- PICT (niezależne parami testowanie kombinatoryczne): Narzędzie wykorzystujące algorytm genetyczny do generowania przypadków testowych dla par parametrów. Jest dostępne jako narzędzie o otwartym kodzie źródłowym.
- SmartBear TestComplete: Komercyjne narzędzie do automatyzacji testów, które oferuje wbudowaną obsługę testowania parami.
- Pairwise Test Case Generator: Narzędzie o otwartym kodzie źródłowym dostępne w serwisie GitHub, które można wykorzystać do generowania przypadków testowych dla par parametrów.
- Testy parami można również generować za pomocą programu Excel lub OpenOffice Calc, wykorzystując makra albo wtyczki do generowania przypadków testowych.
To tylko kilka przykładów; dostępne mogą być również inne narzędzia. Zalecam zapoznanie się z dostępnymi opcjami i ich ocenę, aby sprawdzić, które narzędzie najlepiej odpowiada konkretnym potrzebom i wymaganiom.
Przemyślenia końcowe
Stosowanie tych technik to świetny sposób na osiągnięcie dobrego pokrycia na dowolnym etapie cyklu życia oprogramowania. Jeszcze lepsze rezultaty można uzyskać, dodając do procesu testowania inne rodzaje testów, takie jak testowanie eksploracyjne, zgadywanie błędów, testowanie zgodności, testowanie użyteczności i inne.
Ponadto, jeśli wynikowe przypadki testowe trafią do zestawu testów regresji, warto rozważyć ich automatyzację — w przypadku testów interfejsu użytkownika można użyć narzędzi takich jak Selenium, Cypress i Appium, natomiast w przypadku testowania interfejsów API można wykorzystać testy integracyjne napisane przez zespół programistyczny lub narzędzia takie jak Postman.
Jeśli ten artykuł okazał się przydatny, zachęcam do subskrypcji biuletynu QA Lead, w którym znajdziesz informacje o wszystkich nowych treściach i samouczkach dotyczących zapewniania jakości oraz testowania.

