
Proste produkty są łatwe do testowania, a dziś prawie nikt już nie tworzy prostych produktów. Platformy B2B SaaS, z którymi pracujemy w QA.tech, mają wspólny profil: wiele ról użytkowników z różnymi uprawnieniami, ekrany, których cała struktura zależy od danych znajdujących się za nimi, przepływy pracy obejmujące kilkanaście kroków i kilka zależności, a coraz częściej także funkcjonalności rozciągające się na strony internetowe, interfejs API i aplikacje mobilne w ramach jednej ścieżki użytkownika.
To właśnie obszar, w którym skryptowana automatyzacja testów kosztuje najwięcej i obejmuje najmniej. Każda rola zwielokrotnia liczbę ścieżek. Każdy stan danych zwielokrotnia ją ponownie. Pakiet testów, który uczciwie obejmowałby wszystkie kombinacje, byłby większy niż sam produkt — dlatego zespoły w praktyce skryptują kluczowe ścieżki, pozostałe sprawdzają wyrywkowo ręcznie i akceptują tę lukę.
W tym artykule wyjaśniamy, jak agenci QA.tech w odmienny sposób radzą sobie z każdym z tych wymiarów złożoności. Opis opiera się na wdrożeniach w zespołach z obszarów fintech, technologii HR, infrastruktury handlu elektronicznego i ochrony zdrowia — czyli w produktach, w przypadku których „po prostu nagraj przepływ” nigdy nie mogło zadziałać.
Właściwy model mentalny: wdrażasz nowego współpracownika
Sposób ujęcia, który pozwala zrozumieć wszystko, co opisujemy poniżej, pochodzi od jednego z klientów. Lider zespołu QA, obserwując, jak agent po raz pierwszy eksplorował ich platformę, zapytał: „Czyli działa jak nowa osoba w firmie?”. Dokładnie tak. Agent dołącza do zespołu tak, jak zrobiłby to bystry, nowo zatrudniony specjalista QA — eksploruje produkt, buduje jego model mentalny, zadaje pytania, gdy napotyka coś niejednoznacznego, i w pierwszych tygodniach od czasu do czasu otrzymuje korekty. Różnica polega na tym, co dzieje się później: budowana przez niego wiedza staje się trwałym grafem wiedzy, agent nigdy nie zapomina korekty i stosuje każdy element kontekstu do wszystkich przyszłych testów.
Ten model mentalny ma znaczenie, ponieważ złożone produkty to dokładnie te obszary, w których okres „wdrażania nowej osoby” przynosi korzyści. Skrypt zna jedną ścieżkę w Twoim produkcie. Wytrenowany agent zna Twój produkt.
Role i uprawnienia: pokaż mu całą mapę, a następnie daj dowolny klucz
Systemy uprawnień to obszar, w którym pakiety skryptowanych testów po cichu się poddają. Jeśli Twoja platforma ma role administratora, menedżera i członka — albo pięćdziesiąt konfiguracji ról dostosowanych do poszczególnych klientów — podejście oparte na skryptach wymaga osobno przygotowanego zakresu testów dla każdej roli, a zakres ten dezaktualizuje się natychmiast po zmianie uprawnień.
Podejście agentowe odwraca ten schemat. Najpierw agent eksploruje Twój produkt przy użyciu konta administratora, dzięki czemu jego graf wiedzy obejmuje całą powierzchnię: każdy ekran, każdą czynność i każdy istniejący przepływ. Następnie przekazujesz mu konta z ograniczeniami. Logując się jako członek, agent widzi mniej opcji — a ponieważ zna całą mapę, rozumie czego brakuje i dlaczego, zamiast być zdezorientowanym przez mniejszy interfejs.
Od tego momentu testowanie uprawnień staje się rozmową. Powiedz agentowi: „jako użytkownik z tej kategorii powinieneś widzieć tylko X, Y i Z”, a on zweryfikuje granicę. I oto szczegół, który zespoły uwielbiają: gdy użytkownik z ograniczeniami rzeczywiście nie może otworzyć ekranu, agent rejestruje wynik pozytywny — dowód, że system uprawnień działa prawidłowo. Potwierdzasz to oczekiwanie raz, agent je zapisuje, a cała klasa weryfikacji związanych z bezpieczeństwem jest stale wykonywana bez konieczności tworzenia skryptów.
Przepływy oparte na danych: ten sam cel, różne dane, zero ponownego tworzenia
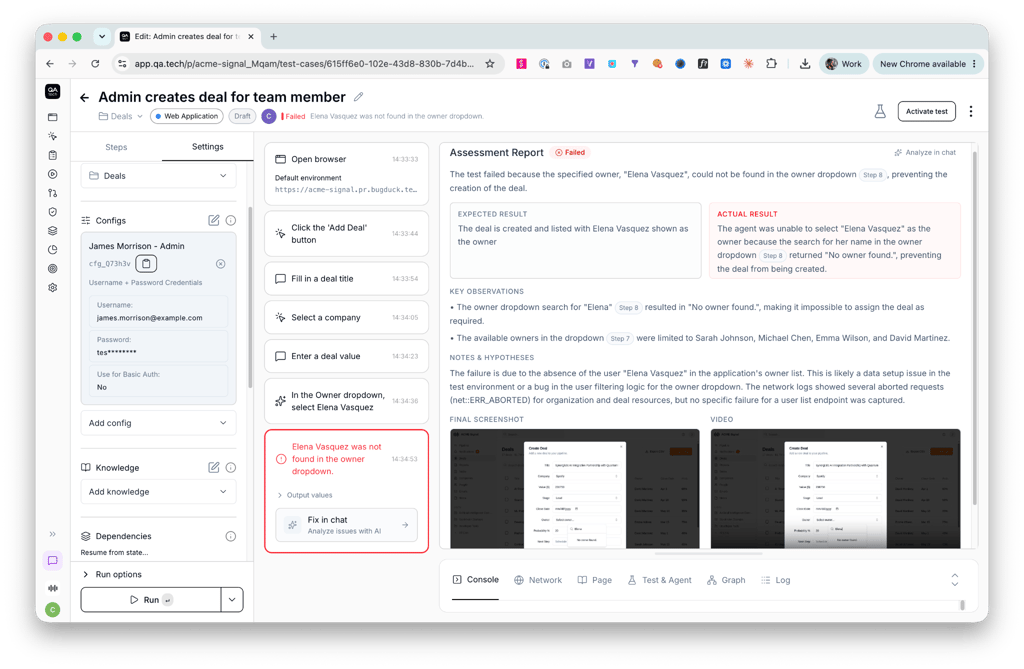
W systemach SaaS opartych na dużej ilości danych sam przepływ rzadko jest trudną częścią — trudne są warianty. Utworzenie rekordu to jeden test; utworzenie go przy użyciu pięćdziesięciu różnych profili danych, z których część powinna zakończyć się powodzeniem, a część odrzuceniem, to obszar, w którym testowanie ręczne tonie, a skrypty zamieniają się w niemożliwe do utrzymania macierze parametrów.
Ponieważ agent działa na podstawie celów, a nie nagranych kroków, zmiana danych wymaga tylko jednego polecenia: „Uruchom ten przypadek testowy ponownie z tymi danymi”. Wiedza o przepływie pozostaje bez zmian — zmieniają się tylko dane wejściowe. Przypadki negatywne działają tak samo: opisz, co powinno zostać odrzucone, a agent sprawdzi, czy produkt odmawia, gdy powinien. W przypadku pól tekstowych, których pełno w każdym złożonym produkcie, agent korzysta z przekazanego mu kontekstu produktu, aby wprowadzać sensowne wartości, a gdy się pomyli, poprawiasz jego rozumienie raz, zamiast modyfikować skrypt.
Długie przepływy pracy: agent już zna warunki wstępne
Przepływy pracy w systemach SaaS dla przedsiębiorstw mają łańcuchy zależności — nie można edytować transakcji, dopóki transakcja nie istnieje, nie można zatwierdzić zgłoszenia, dopóki ktoś go nie prześle, a także testować dziesiątego kroku bez pierwszych dziewięciu. W pakietach skryptowanych testów staje się to kodem konfiguracji: zestawami danych testowych, danymi początkowymi i skryptami pomocniczymi, które same w sobie stanowią obciążenie związane z utrzymaniem.
Agent obsługuje łańcuchy tak jak człowiek: zapamiętując. Gdy ukończy przepływ, wszystko, co następuje później, opiera się na tej wiedzy. Poproś go o przetestowanie podziałów alokacji w transakcji, a będzie wiedział, że najpierw trzeba utworzyć transakcję – ponieważ już to zrobił, a ścieżka znajduje się w jego grafie wiedzy. Wymagane przepływy, takie jak logowanie, konfiguruje się raz i wykorzystuje ponownie wszędzie. Im bardziej złożone są Twoje przepływy pracy, tym większe znaczenie ma to narastanie wiedzy, ponieważ każdy krok, który agent już zna, to krok, którego nikt nie musi ponownie opisywać w skrypcie.
Przepływy między różnymi powierzchniami: internet, API i urządzenia mobilne w jednym teście
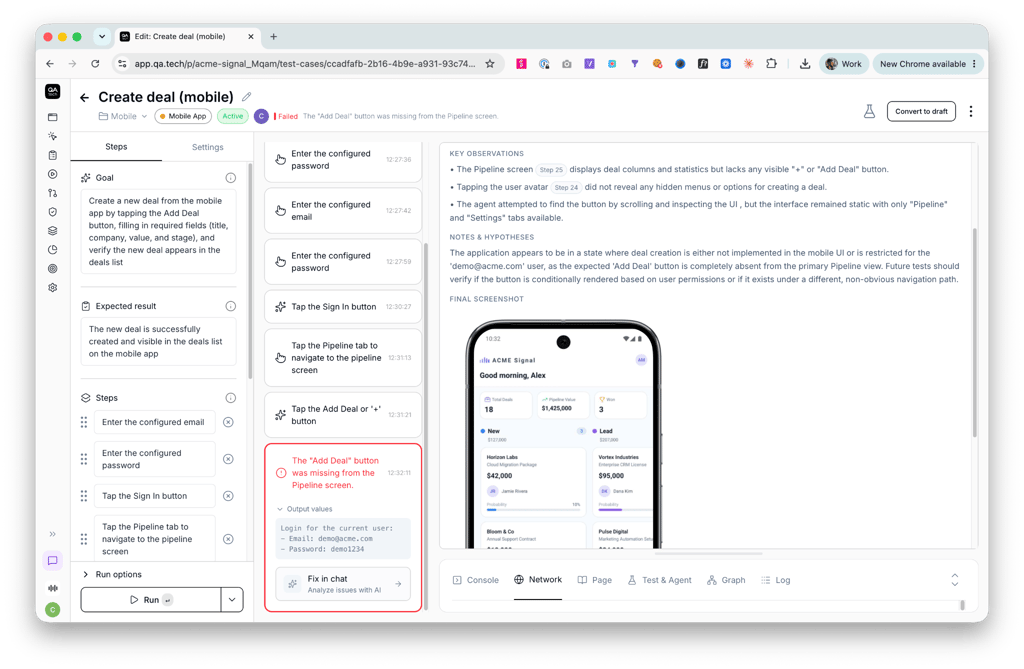
Rzeczywiste ścieżki użytkowników we współczesnych usługach SaaS nie respektują granic narzędzi testowych. Użytkownik konfiguruje coś w interfejsie internetowym, uruchamiany jest webhook, rekord jest aktualizowany za pośrednictwem API, a powiadomienie trafia do aplikacji mobilnej. Większość zespołów testuje każdą powierzchnię w osobnym narzędziu, korzystając z oddzielnych skryptów i licząc na to, że punkty styku zadziałają.
QA.tech uruchamia je jako pojedyncze testy kompleksowe: przepływ może rozpocząć się w produkcie internetowym, zawierać pośrodku kroki testowe API i zakończyć się w natywnej aplikacji na iOS lub Androida, weryfikując ścieżkę w sposób odpowiadający rzeczywistym doświadczeniom klienta. W przypadku platform, w których punkty styku między powierzchniami są dokładnie tym miejscem, gdzie ukrywają się błędy – płatności, powiadomienia, synchronizacja – rozwiązanie to zamyka lukę, której narzędzia działające osobno dla każdej powierzchni z założenia nie potrafią zamknąć.
Do czego to prowadzi
Wzorzec obserwowany w zespołach pracujących nad złożonymi produktami jest spójny. Pierwsze tygodnie mają charakter współpracy – agent eksploruje, pyta i otrzymuje korekty, a Twój zespół uczy się, jak przekazywać mu instrukcje. Następnie liczba pytań maleje, a wysiłek związany z testowaniem przestaje zależeć od złożoności produktu: nowe role, nowe stany danych i nowe kroki przepływów są wchłaniane przez graf wiedzy zamiast generować nową pracę nad skryptami.
Rezultat widać w liczbie godzin. Pricer, firma z branży technologii handlu detalicznego, której platforma jest właśnie tego rodzaju złożonym produktem opartym na dużej ilości danych, odnotowała oszczędność 390 godzin pracy zespołu QA na kwartał po przeniesieniu weryfikacji do agentów QA – czas, który można było przeznaczyć na dostarczanie nowych funkcji zamiast na utrzymywanie infrastruktury testowej.
Jest też mniej oczywista korzyść, o której wspominają liderzy zespołów inżynieryjnych: eksploracja agenta ujawnia kombinacje, których nikt nie pomyślał, aby przetestować. Gdy zakres testów wynika z systemu, który odwzorował cały produkt, a nie z listy zgłoszeń testowych, pytanie „czy pomyśleliście o tym?” zaczyna zadawać Wam platforma.
Najczęściej zadawane pytania
Czy agenci QA.tech mogą testować kontrolę dostępu opartą na rolach w rozwiązaniach B2B SaaS?
Tak. Agent odwzorowuje całą aplikację z poziomu konta administratora, a następnie testuje ją jako dowolny użytkownik z ograniczeniami, sprawdzając, czy każda rola widzi dokładnie to, co powinna. Oczekiwane blokady uprawnień są rejestrowane jako wyniki pozytywne.
Jak agenci QA.tech obsługują scenariusze testowe oparte na danych?
Ten sam przypadek testowy jest uruchamiany z innymi danymi na podstawie instrukcji – “uruchom to ponownie z tymi danymi” – bez ponownego tworzenia opisu testu. Zarówno przypadki pozytywne, jak i negatywne wynikają z opisanego przez Ciebie celu.
Czy QA.tech obsługuje testowanie internetu, API i urządzeń mobilnych w jednym przepływie?
Tak. Pojedynczy test QA.tech może łączyć kroki internetowe, kroki testowe API oraz natywne kroki na iOS lub Androidzie, weryfikując kompleksowe ścieżki między różnymi powierzchniami.
Ile czasu QA.tech potrzebuje, aby nauczyć się złożonego produktu SaaS?
Wstępne skanowanie trwa kilka minut; dobre zrozumienie ról, danych i przepływów pracy zazwyczaj wymaga kilku tygodni normalnego użytkowania, a liczba pytań agenta stopniowo maleje wraz z uzupełnianiem jego grafu wiedzy.
Masz produkt, który wykracza poza możliwości narzędzi testowych? Skieruj agentów QA.tech do swojego środowiska testowego – zostały stworzone właśnie do obsługi złożonych produktów.


