Jak uruchamiać agentów QA przy każdym żądaniu scalenia za pomocą QA.tech (bez pisania ani jednego skryptu testowego)
This is sponsored content from QA.tech. Learn here about our transparent editorial approach.
Jeśli Twój zespół korzysta z narzędzi AI do programowania, znasz już tę niekomfortową matematykę. Zespoły inżynieryjne, które wcześniej dostarczały kilka żądań scalenia tygodniowo, teraz dostarczają ich pięćdziesiąt, sto, a czasem nawet więcej – w dużej mierze napisanych przez agentów programistycznych, sprawdzonych przez agentów do przeglądu kodu i scalonych w tempie, do którego nie został zaprojektowany żaden ręczny proces kontroli jakości. Jeden z zespołów, z którym niedawno rozmawialiśmy, właśnie zakończył pracę nad pierwszymi pięćdziesięcioma PR-ami napisanymi w całości przez agentów i zadał nam oczywiste pytanie: co to wszystko weryfikuje?
Tradycyjna odpowiedź – napisać więcej skryptów testowych – nie sprawdza się przy takiej liczbie PR-ów. Tworzenie i utrzymywanie skryptów zajmuje więcej czasu niż agentom napisanie kodu, więc zestaw testów zaczyna pozostawać w tyle już pierwszego dnia i nigdy nie nadąża.
W tym przewodniku przedstawiamy alternatywę, którą stworzyliśmy w QA.tech: połączenie naszych agentów QA z repozytorium, aby każdy pull request uruchamiał testy oparte na celach, wynikające z tego, co się zmieniło. Bez kodu testów, bez selektorów i bez kolejki zadań konserwacyjnych. Oto jak to skonfigurować i czego oczekiwać na każdym etapie.
Krok 1: Najpierw pozwól agentowi poznać Twoją aplikację
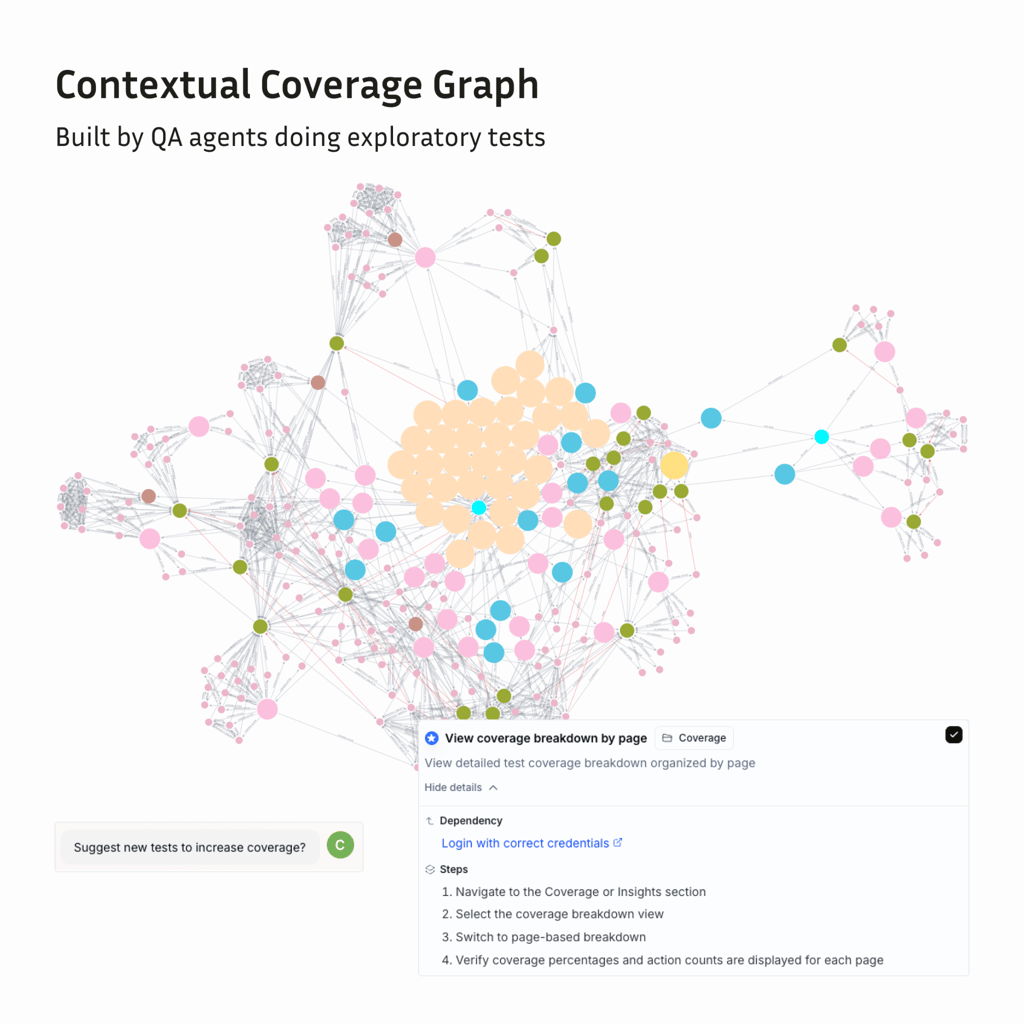
Zanim integracja z PR-ami zacznie przynosić jakiekolwiek korzyści, agent musi poznać Twój produkt. Po połączeniu QA.tech ze środowiskiem stagingowym lub piaskownicą agent wykonuje początkowe skanowanie: bada aplikację tak, jak zrobiłby to skrupulatny nowy pracownik, podążając każdą możliwą ścieżką i wykonując każdą znalezioną akcję, a następnie tworzy na tej podstawie graf wiedzy opisujący strukturę produktu.
Dwie praktyczne uwagi wynikające z setek wdrożeń. Po pierwsze, jeśli aplikacja wymaga logowania, skonfiguruj proces logowania jako test warunku wstępnego – agent wykona go najpierw, a następnie przeskanuje całą dostępną za nim część aplikacji. Po drugie, to Ty kontrolujesz głębokość skanowania. Płytkie skanowanie (jeden lub dwa kroki w głąb każdej ścieżki użytkownika) jest szybkie i zwykle wystarcza na początek; możesz je pogłębić dla najważniejszych przepływów, zamiast od razu wyczerpująco mapować całość.
Ten krok jest głównym powodem, dla którego integracja z PR-ami działa. Ponieważ agent zna każdy zakamarek aplikacji, może rozumować, na co może wpłynąć dana zmiana – dokładnie tak, jak robi to dobry inżynier QA, decydując, co należy sprawdzić przed wydaniem.
Have an account? Log In
Krok 2: Połącz repozytorium
Integracja z GitHubem zajmuje kilka minut: autoryzujesz aplikację, wybierasz repozytoria i określasz, kiedy testy powinny być uruchamiane – zazwyczaj przy utworzeniu lub aktualizacji żądania scalenia. Żądania scalające GitLaba działają według tego samego schematu. Od tego momentu testowanie jest częścią potoku, a nie etapem następującym po nim.
Krok 3: Otwórz żądanie scalenia i obserwuj, co się dzieje
Gdy zostanie otwarty PR, agent odczytuje to, co dodano i zmieniono, porównuje te informacje z grafem wiedzy i generuje przypadki testowe uzasadnione przez zmianę – zazwyczaj cztery lub pięć w przypadku standardowego PR-a, a więcej, jeśli zmiany dotyczą współdzielonych przepływów. Następnie natychmiast wykonuje je w prawdziwej przeglądarce, wizualnie korzystając ze zaktualizowanej wersji, dokładnie tak jak zrobiłby to użytkownik.
To właśnie zaskakuje zespoły przyzwyczajone do zestawów skryptów uruchamianych przez CI: nikt nie napisał tych przypadków testowych. Wynikają one z samej zmiany, w kontekście wszystkiego, co agent już wie o Twoim produkcie. Dodaj nowy filtr do pulpitu nawigacyjnego, a agent przetestuje filtr oraz przepływy pulpitu, w których on występuje. Nikt nie musiał pamiętać o dodaniu pokrycia testami.
Krok 4: Czytaj wyniki tam, gdzie Twoi inżynierowie już pracują
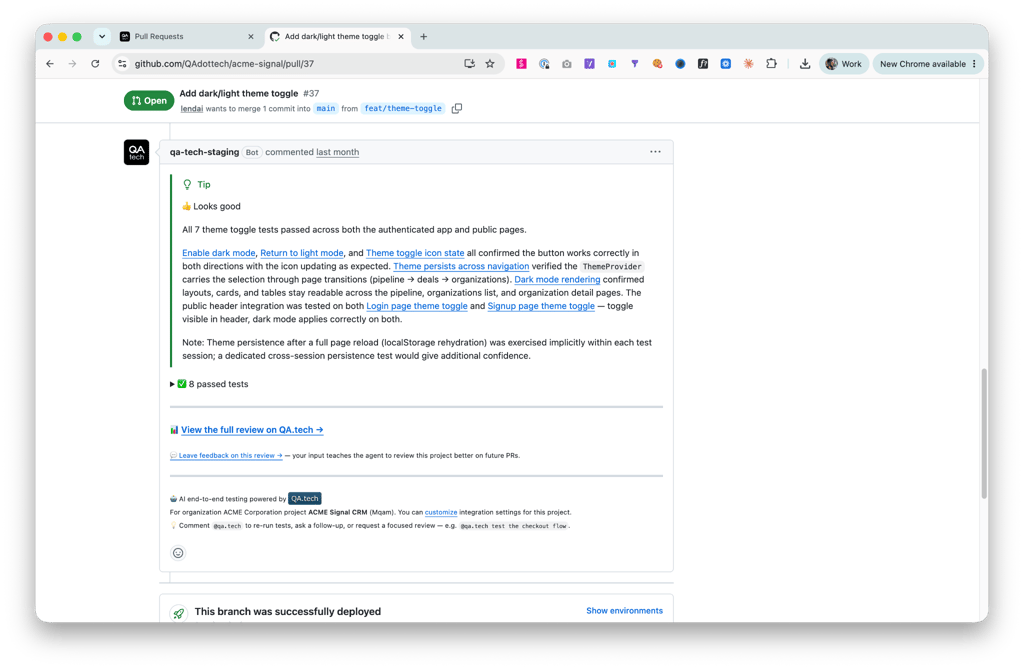
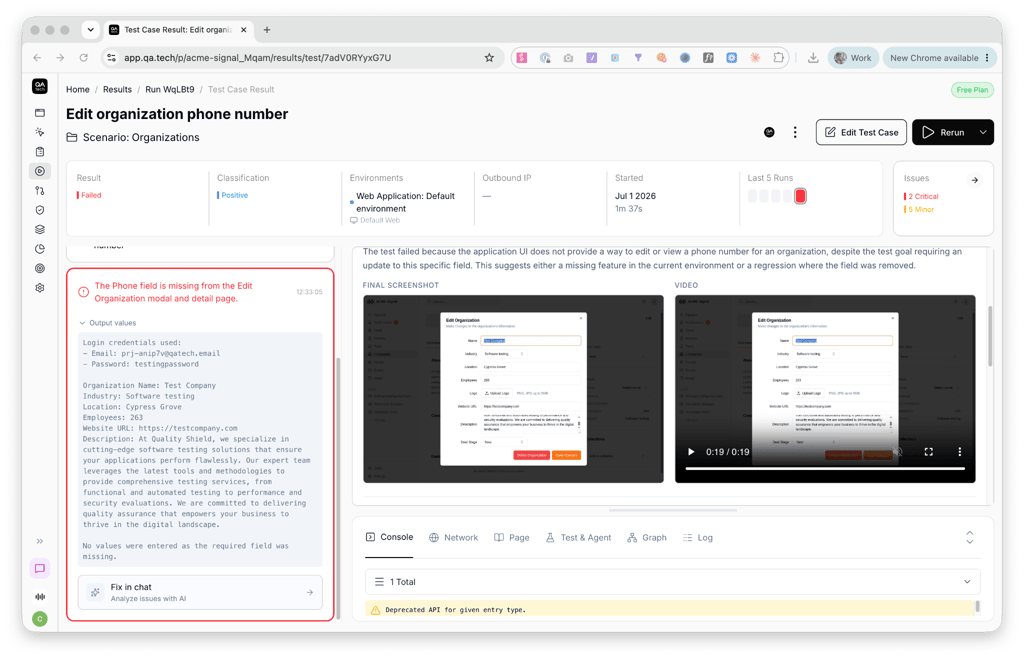
Wynik pozytywny lub negatywny pojawia się bezpośrednio w PR-ze. Dla każdego uruchomienia agent tworzy raport oceny: cel, oczekiwany rezultat, faktyczny przebieg, nagranie wideo z wykonania, zrzuty ekranu krok po kroku oraz znajdujące się poniżej dzienniki konsoli i sieci. Błąd nie jest czerwonym symbolem X wymagającym odtworzenia jego przyczyny – to pisemne wyjaśnienie tego, co agent spodziewał się zobaczyć i co zobaczył zamiast tego.
Ponieważ agent testuje za pośrednictwem interfejsu, zgłasza błędy na poziomie produktu – poinformuje Cię, że kod rabatowy nie jest już stosowany przy realizacji zakupu, i dołączy dowody. Ten kontekst na poziomie produktu jest dokładnie tym, czego Twoi inżynierowie – lub agenci programistyczni – potrzebują, aby znaleźć i naprawić przyczynę. Zespoły korzystające z agentowych cykli wytwarzania oprogramowania przekazują nasze raporty oceny bezpośrednio swoim agentom programistycznym jako kontekst błędu do naprawy – a dzięki integracji MCP ci agenci programistyczni mogą sami uruchamiać testy podczas pracy.
Krok 5: Dodaj testy regresji do testowania PR
Testy uruchamiane przez PR weryfikują wprowadzaną zmianę. Plany regresji weryfikują całą resztę. W QA.tech grupujesz przypadki testowe w plany — zestaw testów dymnych dla każdego wdrożenia, pełną regresję przed głównymi wydaniami — i uruchamiasz je z częstotliwością dopasowaną do procesu wydawniczego.
Ponieważ testy wykonują się równolegle, czas rzeczywisty stanowi ułamek tego, ile ta sama liczba testów zajęłaby ręcznie. Niedawny pełny plan regresji, który uruchomiliśmy, obejmował zakres testów, który zająłby testerowi manualnemu dzień lub dwa; został ukończony w około dwadzieścia minut. To właśnie ta różnica sprawia, że „uruchamianie pełnej regresji przy każdym wydaniu” staje się rzeczywistą zasadą, a nie tylko aspiracją.
Krok 6: Zapytaj agenta, gdzie pokrycie testami jest niewystarczające
Ponieważ graf wiedzy odwzorowuje każdy przepływ wykryty podczas indeksowania, platforma zna różnicę między tym, co zawiera Twój produkt, a tym, co sprawdzają Twoje testy. Możesz zapytać bezpośrednio na czacie: „Które przepływy o największej wartości nie mają obecnie pokrycia testami?”. Agent odpowiada na podstawie mapy Twojego produktu i może od razu wygenerować brakujące testy.
Odwraca to typową dynamikę pokrycia testami. Zamiast być wynikiem tego, co narastało przez lata pisania testów sterowanego zgłoszeniami, pokrycie staje się pytaniem, które możesz zadać i na które możesz zareagować jeszcze tego samego popołudnia.
Jak to wygląda po miesiącu
Wzorzec, który obserwujemy w różnych zespołach, jest spójny. Pierwszy tydzień obejmuje pewną wymianę informacji — agent zadaje pytania, czasami potrzebuje kontekstu dotyczącego specyfiki Twojego produktu, a Ty korygujesz jego rozumienie. W drugim tygodniu pytania pojawiają się rzadko. W trzecim tygodniu w większości znikają, ponieważ graf wiedzy przyswoił sposób działania Twojego produktu. Od tego momentu testowanie odbywa się w tempie Twoich żądań PR, a zaangażowani ludzie przeglądają wyniki zamiast utrzymywać skrypty. Jeśli chcesz poznać pełną sekwencję wdrożenia — od weryfikacji koncepcji po wycofanie dotychczasowych zestawów testów — opublikowaliśmy ją jako przewodnik praktyczny, Wdrażanie testowania agentowego: plan działania.
W przypadku zespołów, które przeszły na kod tworzony przez agenta, zamyka to brakującą dotąd pętlę: generowanie kodu, przegląd kodu i weryfikacja działają w tempie maszynowym, a inżynierowie kierują systemem zamiast dostarczać mu dane wejściowe.
Najczęściej zadawane pytania
Ile przypadków testowych QA.tech generuje dla każdego żądania PR?
Typowy PR generuje od czterech do pięciu przypadków testowych, wynikających z wprowadzonych zmian. Większe zmiany, które obejmują współdzielone przepływy, generują ich więcej.
Czy testowanie PR wymaga istniejących przypadków testowych?
Nie. Agent generuje przypadki testowe na podstawie zmiany i swojej wiedzy o aplikacji. Zespoły zaczynające bez żadnego pokrycia testami mogą rozpocząć od poziomu PR i z czasem tworzyć plany regresji.
Co dzieje się, gdy interfejs użytkownika zmienia się w żądaniu PR?
Agent działa na podstawie celów i rozumienia wizualnego, a nie selektorów, więc wykonuje test na nowym interfejsie i zgłasza niepowodzenie tylko wtedy, gdy samo zachowanie jest nieprawidłowe.
Jakie konfiguracje CI/CD obsługuje integracja PR w QA.tech?
Główne punkty integracji to żądania PR w GitHubie i żądania scalenia w GitLabie, a wyniki są przekazywane z powrotem do PR jako kontrola.
Zobacz, co agenci QA wygenerują dla Twojego następnego żądania PR — połącz repozytorium w QA.tech i uruchom pierwszy test w ciągu kilku minut.