Tidligere teknologigründer i Meta deler tre ting alle teknologidirektører må gjøre før de tar i bruk KI
James Everingham
Administrerende direktør og medgründer av Guild.ai
James Everingham forklarer hvorfor teknologidirektører bør behandle KI som infrastruktur, etablere styring tidlig og la nyttige verktøy opparbeide seg aksept i stedet for å tvinge dem på teamet.
Key Takeaways
Oppnå aksept: Teknologidirektører bør bevise verdien av KI gjennom meningsfulle utfordringer i stedet for å pålegge verktøy som ingeniører kan motsette seg.
Etabler styring: KI-styring må komme før innføringen, med budsjetter, tilgangskontroller og revisjon som bygges inn i infrastrukturen fra første dag.
Tenk nytt om arkitekturen: Spesialiserte agenter krever infrastruktur som støtter koordinering, eierskap, ansvarlighet og ledelse etter arbeidslivets prinsipper på tvers av tekniske team.
Valider resultater: Ingeniører kan øke tempoet med KI, men menneskelig dømmekraft må kontrollere kode, risikoer og produksjonsklarhet før lansering.
Sentraliser gjenbruk: En delt agentplattform lar team oppdage, forgrene, styre og optimalisere eksisterende løsninger i stedet for å bygge alt fra grunnen av.
James Everingham har ledet utviklingsarbeidet hos noen av verdens mest avanserte selskaper, blant annet Meta. Han er for tiden administrerende direktør og medgründer av Guild.ai, en kontrollplan for AI-agenter som gir organisasjoner ett sted for å distribuere, styre, overvåke og optimalisere alle agenter i produksjon.
Vi satte oss ned med James for å lære hvordan AI endrer utviklingsarbeidsflyter – og hva utviklingsteam må endre før AI kan integreres effektivt. Her er det han fortalte oss.
Fra Meta til AI-oppstartsselskap
Jeg er administrerende direktør og medgründer av Guild.ai, kontrollplanen for AI-agenter som gir organisasjoner ett sted for å distribuere, styre, overvåke og optimalisere alle agenter i produksjon. Vi har hentet inn 44 millioner dollar – en serie A-runde ledet av Google Ventures, med deltakelse fra NFX, Acrew, Scribble Ventures, Khosla Ventures og Webb Investment Network. Vi er et team på rundt 35 personer, basert i San Francisco.
Før dette var jeg visepresident for utvikling hos Meta DevInfra, der jeg bygget og drev de sentrale utviklerverktøyene, tjenestene og plattformene som driver Metas produkter. Teamet mitt bygget Metas første interne AI-agent, noe som umiddelbart påvirket hvordan Metas utviklere brukte AI-verktøy. I løpet av tiden min hos Meta var jeg også med på å skape Diem og var utviklingssjef for Instagram.
Med en 40 år lang karriere som leder, entreprenør og teknologiutvikler har jeg ledet en rekke utviklingsteam i verdensklasse. Hos Yahoo var jeg visepresident for utvikling for Yahoos medieegenskaper etter at de kjøpte opp Luminate, et selskap innen interaktiv bildeteknologi som jeg grunnla. Før det ledet jeg team hos Oracle, Netscape Communications, Tellme (kjøpt opp av Microsoft) og flere av mine egne selskaper.
More Articles
Hvordan AI bidro til å fjerne Metas årlige kodefrys
Da jeg var hos Meta, brukte vi en AI-risikomodell til å avskaffe den årlige kodefrysen.
Tidligere frøs Meta kodebasen hvert år fra midten av desember til og med januar, fordi dette er perioden med høyest trafikk for produktene deres. I årevis var det ingen som lanserte endringer for å unngå produksjonsforstyrrelser i de mest risikable ukene. Dette var trygt, men det satte også produktiviteten i hele selskapet på pause i over en måned.
\u003cstrong\u003eIkke gi utviklerne et ovenfra-og-ned-pålegg om AI, men gi dem infrastruktur – en sentralisert plattform, et risikosignal, en kontrollplan – og la dem selv finne ut hvordan de kan utnytte den.\u003c/strong\u003e
Teamet mitt bygget og gjorde Diff Risk Score tilgjengelig som åpen kildekode, et LLM-drevet system som beregner sannsynligheten for at en kodeendring vil føre til et produksjonskrasj. I stedet for å behandle alle endringer som like farlige under fryseperioden utførte modellen en risikoklassifisering. Den tildelte en kontinuerlig risikoscore til hver kodeendring, justert for høy tilbakekalling – for eksempel ved å flagge 10 % av kodeendringene, samtidig som den fanget opp 60 % av endringene som faktisk forårsaket hendelser. Modellen gjorde det mulig for kodeendringer med lav risiko å bli tatt i bruk selv under fryseperioden, mens den holdt tilbake dem den flagget som risikable.
Resultatet er at frysen ikke lenger er alt eller ingenting. Diff Risk Score gjør det mulig for Meta å begynne å fjerne kodefrysen helt – utviklerne får tilbake uker i kalenderen som tidligere var bortkastet tid, uten å ofre sikkerhetsnettet frysen ga.
Det er et godt eksempel på min bredere filosofi: Ikke gi utviklerne et ovenfra-og-ned-pålegg om AI, men gi dem infrastruktur – en sentralisert plattform, et risikosignal, en kontrollplan – og la dem selv finne ut hvordan de kan utnytte den.
Hvorfor mennesker må kunne forklare kode før den settes i produksjon
Hvis du ikke kan forklare det, kan du ikke sette det i produksjon.
Jeg bruker AI-verktøy aktivt for å få arbeidet unna raskere, men jeg råder utviklere til å alltid kreve validering før noe når produksjon. AI erstatter ikke utviklernes faglige vurderinger; den gir utviklerne større muligheter til å bruke disse vurderingene i stor skala.
AI gir nå informasjon til arbeidet med risikovurdering, i tillegg til utforsking av verktøy og arbeidsflyter.
Der mennesker er best:
- Styring og sikkerhetsnett rundt agentene selv: Når team bygger inn resonneringsmodeller og agenter dypt i infrastrukturen, oppdager de raskt styringssvikt — agentene formerer seg raskere enn noen forventet, og budsjettene forsvinner over natten. Du trenger det samme styringslaget rundt ikke-deterministiske agenter som du ville hatt rundt mennesker som bruker denne infrastrukturen — det vil si at mennesker fortsatt setter budsjettgrenser, tilgangsbegrensninger og krav til revisjon.
- Adopsjonsstrategi: Du kan ikke pålegge bruk av AI-verktøy — bruk som er opparbeidet slår pålagt bruk, siden pålegg fører til overflatisk adopsjon. Å avgjøre hvordan AI skal integreres i et teams arbeidsflyt, er utvilsomt en beslutning om menneskelig ledelse og kultur — verktøyet kan bevise sin verdi, men adopsjonsbeslutningen kan ikke automatiseres.
Hvorfor ingeniørteam må tenke nytt om arkitekturen sin
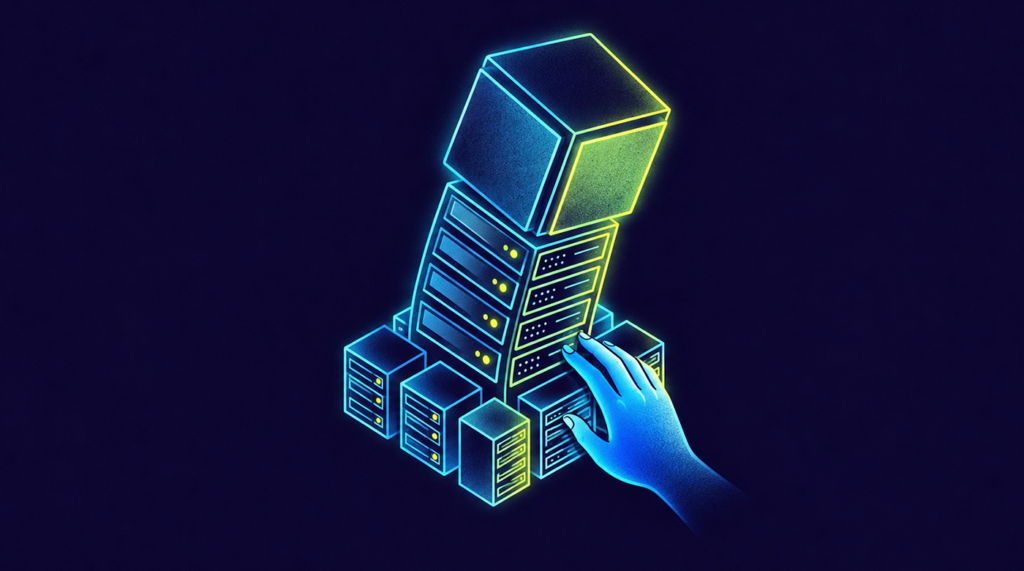
Databehandling begynte med én stormaskin som alle delte, før den gikk over til serverrack som kjørte spesialiserte tjenester. Agentene følger den samme utviklingen.
Den gamle antakelsen var å bygge en håndfull agenter for generell bruk og sentralisere bruken rundt dem, omtrent som man sentraliserte datakraft. Men selskaper innser at virkeligheten deres ikke består av en håndfull delte verktøy — den ligner mer på et økosystem av spesialiserte, formålsbygde agenter. Dette tvinger frem en ny vurdering av hva «arkitektur» egentlig betyr for en kodebase: mindre monolitt med programtillegg, mer en mikrotjenesteverden, bortsett fra at tjenestene er agenter i stedet for endepunkter.
Instinktet i de fleste organisasjoner er å behandle en agent som enhver annen programvaredel — skrive spesifikasjonen, levere den og forvente konsistente resultater. Jeg forkastet dette og erstattet det med en mental modell basert på en arbeidsstyrke. Dette omformulerer spørsmål om organisasjonsdesign — hvem som godkjenner hva, hvem som eier budsjettet, og hvem som er ansvarlig når noe går galt — til ledelsesspørsmål, ikke leveransespørsmål. Det er en annen måte å strukturere et teams forhold til verktøyene sine på.
Hvorfor styring må være på plass før AI-adopsjonen tar av
I de tidligere rollene mine skulle jeg ønske at vi hadde bygget styringslaget før adopsjonen tok av, ikke etterpå.
Da jeg var i Meta, begynte ingeniører å bygge og publisere sine egne agenter på den interne plattformen. Agentene formerte seg raskt, og infrastrukturteamet måtte plutselig kjempe for å holde tritt med etterspørselen — bokstavelig talt ved å prøve å finne titusenvis av ledige servere.
Dette kunne vi i ettertid ha unngått. Hvis du antar at adopsjonen kan spre seg viralt internt, bygger du kostnadskontrollene og tilgangsbegrensningene inn i plattformen fra første dag, ikke som krisehåndtering.
CTO-er må redesigne grensen mellom «hvor AI befinner seg» og «hva AI kan berøre» — flytte den ut av redigeringsverktøyet og inn i infrastrukturen, fordi det er laget der risikoen oppstår og styringen må ligge.
James deler
CTO-er må redesigne grensen mellom “hvor AI befinner seg” og “hva AI kan berøre” — flytte den ut av redigeringsverktøyet og inn i infrastrukturen, fordi det er laget der risikoen oppstår og styringen må ligge.
Hvorfor organisasjoner må ha et sentralisert sted der agenter kan forgrenes
Som ingeniør var jeg en bedre tyv enn programmerer. Jeg fant noe som delvis dekket behovene mine, tilpasset det til det spesifikke formålet mitt og lærte underveis.
Det første trinnet i arbeidsflyten er ikke «gi en modell en ledetekst», men å bla gjennom et sentralisert sted for å se hvilke agenter som allerede finnes for denne oppgaven, og forgrene en av dem i stedet for å begynne helt fra grunnen. Organisasjoner må opprette prosesser som gjør det enkelt å stjele agenter.
Tre råd til CTO-er som integrerer AI i tekniske organisasjoner
Her er rådene mine:
- Ikke pålegg det – gjør det fortjent. Pålagt bruk av kunstig intelligens for å øke produktiviteten frustrerer meg fordi det fører til overflatisk bruk – de beste utviklerverktøyene blir tatt i bruk fordi de fortjener det, og utviklere er smarte nok til å motsette seg å bli fortalt hvilke verktøy de skal like. CTO-er bør presentere forretningsutfordringer av en helt annen størrelsesorden for organisasjonen – problemer som er så store at kunstig intelligens er den eneste realistiske løsningen. La deretter ingeniørene som løser dem, bli naturlige forkjempere.
- Slutt å behandle kunstig intelligens som et verktøy for å skrive kode, og begynn å behandle det som infrastruktur. 2025 var året da kodeverktøy som Cursor og Copilot ble allemannseie. Nå slutter resonneringsmodeller og agenter som utfører flere trinn, å være programtillegg i kodeeditoren og blir i stedet en del av infrastrukturen i selskaper – de sender inn kode, kjører tester, lærer opp nye ingeniører og håndterer produksjonsatferd. Hvis KI-strategien din fortsatt er «hvilket programtillegg til utviklingsmiljøet bør vi kjøpe», løser du et gammelt problem.
- Styr agenter som du ville styrt en arbeidsstyrke, ikke som du ville styrt programvare. Agenter drevet av resonneringsmodeller er ikke-deterministiske – gi den samme agenten den samme inndataen to ganger, og du kan få ulike resultater. Dette er ikke en feil som skal rettes, men teknologiens grunnleggende natur. CTO-er håndterer allerede ikke-deterministiske systemer hver dag gjennom de ansatte. Du må bruke noen av de samme sikkerhetsreglene på agenter som du bruker på arbeidsstyrken din. Ikke gi en agent ubegrenset tilgang til produksjonsmiljøet, root-påloggingsopplysninger eller et ubegrenset skybudsjett den første dagen, på samme måte som du heller ikke ville gitt dette til en helt nyansatt.
Her er rådet mitt: Ikke pålegg det – gjør det fortjent. Slutt å behandle kunstig intelligens som et verktøy for å skrive kode, og begynn å behandle det som infrastruktur. Styr agenter som du ville styrt en arbeidsstyrke, ikke som du ville styrt programvare.
Følg med
Du kan følge arbeidet til James Everingham på X og LinkedIn.
Flere ekspertintervjuer kommer på The CTO Club!