Laadunvarmistus edellyttää ennakoivien toimenpiteiden ja tehokkaiden reaktiivisten protokollien yhdistelmää. Oikean tasapainon avulla voit tarjota käyttäjille erinomaista palvelua ja toimivuutta palvelimella, joka on käytettävissä ympäri vuoden. Ainoa tapa saavuttaa tämä tasapaino on tunnistaa olennaisimmat palvelimen valvontamittarit.
Mutta mitä ne voisivat olla? Se riippuu haluamistasi ominaisuuksista, mukaan lukien laadun kypsyysmallissa kuvatut ominaisuudet, sekä valvonnan tavoitteista. On kuitenkin olemassa muutamia kuntoon ja suorituskykyyn liittyviä mittareita, joita laadunvarmistusinsinöörien tulisi aina seurata tilanteesta riippumatta.
Valitsemalla ihanteelliset palvelimen valvontamittarit heti alusta alkaen voit kehittää suorituskyvyn perustason, jota voit käyttää vertailukohtana, kun kuntoon ja suorituskykyyn liittyviä ongelmia väistämättä ilmenee.
Tässä lyhyessä oppaassa tarkastelemme, miksi näitä keskeisiä mittareita kannattaa seurata. Lisäksi saat lisätietoa niiden merkityksestä ja siitä, miten niitä seurataan.
1. Suorittimen käyttöaste
Yksi tärkeimmistä syistä palvelimen valvontaan on infrastruktuurin kunnon ja palvelimen perussuorituskyvyn seuraaminen. Keskeinen osa tätä on mahdollisten suorituskykyongelmien ennakoiva diagnosointi ja lieventäminen. Suorittimen ja levyn käytön mittaaminen on näiden toimien keskiössä. Siksi suorittimen käyttöaste on yksi tärkeimmistä ja yleisimmin seuratuista suorituskykymittareista.
Tätä mittaria pidetään ”isäntäpohjaisena”, koska se tallentaa yksittäisen koneen kyvyn suoriutua tehtävistä ja pysyä vakaana. Suorittimen käyttöasteen seuraaminen edellyttää kuitenkin passiivisen ja aktiivisen valvonnan yhdistelmää. Jälkimmäinen on erityisen hyödyllinen hallituissa kuormitustesteissä, kun taas edellinen kerää kohteesta mittaustietoja todellisen liikenteen aikana.
Suorittimen käyttöasteen mittaaminen
Ennen aloittamista sinun on:
- Valittava tietyt asemat, joita haluat seurata.
- Määritettävä, missä kyseiset asemat sijaitsevat.
- Varmistettava, että tietojenkerääjälläsi on pääsy tietokoneesi prosesseihin.
Kun kaikki tämä on määritetty, sinun on määritettävä näytteenottotaajuus, jolla haluat seurata näitä mittareita. Voit esimerkiksi mitata suorittimen käyttöastetta 30 sekunnin tai yhden minuutin välein.
Suorittimen käyttöastetta voi seurata muutamalla eri tavalla, esimerkiksi käyttämällä tehtävienhallintaa tai Windows-järjestelmissä komentoa wmic CPU get load percentage. Kun kuitenkin yrität muodostaa palvelimestasi kokonaiskuvan, nämä tiedot kannattaa esittää koontinäytössä.
Muista: Suorittimen suorituskykyyn vaikuttavat laitteiston olosuhteet, kuten suorittimen lämpötila ja tuulettimen nopeus. Näitä tekijöitä kannattaa ehkä seurata käyttöasteen (prosenttiosuutena ilmoitettuna) rinnalla näissä kahdessa tilassa, joutokäyntiä lukuun ottamatta.
Kaksi keskeistä asiaa, joita kannattaa seurata tarkasti, ovat etuoikeutettu aika ja käyttäjäaika, sillä näiden kahden summa antaa suorittimen käyttöajan. Ne määritellään seuraavasti:
- Etuoikeutettu aika: Prosenttiosuus ajasta, jonka suorittimet käyttävät muiden kuin käyttäjien prosessien (eli ydintason prosessien) suorittamiseen.
- Käyttäjäaika: Prosenttiosuus ajasta, jonka suorittimet käyttävät käyttäjäprosessien (kuten komentotulkin, sähköpostipalvelimen tai kääntäjän) suorittamiseen.
- Suorittimen käyttöaika: Kokonaisaika, jonka suoritin oli varattu.
Muista, että yli 100 prosentin käyttöaste ei aina tarkoita järjestelmän olevan ylikuormitettu. Jos sinulla on esimerkiksi moniprosessorijärjestelmä, se tarkoittaa vain, että kahden tai useamman suorittimen summa on yli 100 prosenttia (esimerkiksi 50 % ja 60 %). Seuraa niiden yksittäistä suorituskykyä järjestelmän kunnon ylläpitämiseksi.
Suorittimen ja levyn käyttöasteen ohella odotuksia pidetään myös olennaisina infrastruktuurin kunnon ja suorituskyvyn valvonnassa.
Have an account? Log In
Odotukset
Odotukset auttavat arvioimaan, kuinka tehokkaasti tehtävät suoritetaan, ja ilmoittavat mahdollisista pullonkauloista. Pelkkä odotusten tunteminen ei kuitenkaan hyödytä sinua. Sinun on tehtävä lisätutkimuksia tarkan suorituskykyongelman tunnistamiseksi.
Suuret odotusajat ovat hetkellisesti hyväksyttäviä, koska käynnissä saattaa olla joitakin paljon resursseja vaativia tehtäviä, mutta kaiken tämän ylittävä määrä on yleensä huolestuttavaa.
2. Palvelimen käytettävyys
Palvelimestasi ei ole hyötyä, jos se ei ole käyttäjien saatavilla. Siksi palvelimen käytettävyyden seuraaminen on välttämätöntä. Aina kun palvelimesi käytettävyys laskee alle 99,999 prosentin (standardin, joka tunnetaan nimellä ”viisi ysiä”), kyseessä on vakava ongelma.
Käytä alla olevia kaavoja saadaksesi valvontatoimistasi ymmärrettäviä ja hyödynnettäviä tietoja.
Palvelimen käytettävyyden mittaaminen
Seuraavassa on muutamia keskeisiä käsitteitä, jotka on hyvä tuntea palvelimen käytettävyyttä seurattaessa:
- Käytettävyysaika: Aika, jonka palvelusi tai sovelluksesi on aktiivinen ja käyttäjien käytettävissä. Kaava: (Kokonaisaika - käyttökatko)/kokonaisaika
- Vikojen välinen keskimääräinen aika (MTBF): Käyttökatkojen tapahtumat toisistaan erottava keskimääräinen aika. Kaava: (Kokonaisaika - käyttökatko)/käyttökatkotapahtumien määrä
- Ratkaisuun kuluva keskimääräinen aika (MTTR): Katkoksen ratkaisemiseen tarvittava keskimääräinen aika. Kaava: Käyttökatkon kokonaiskesto/käyttökatkotapahtumien määrä
- Kuittaukseen kuluva keskimääräinen aika (MTTA): Nykyisen käyttökatkon kuittaamiseen tarvittava keskimääräinen aika. Kaava: Kokonaisaika kuittaukseen/käyttökatkotapahtumien määrä
Kaikki nämä mittarit auttavat muodostamaan kokonaiskuvan, joka havainnollistaa infrastruktuurisi luotettavuutta ja tiimisi reagointikykyä.
Esimerkiksi terve MTTR- ja MTTA-arvo ovat hyvä asia. Mutta jos myös MTBF-arvosi on korkea, sinun on tutkittava palvelimesi käyttökatkojen perimmäisiä syitä tarkemmin. Muuten yritys on edelleen alttiina merkittäville taloudellisille menetyksille ja käyttäjien luottamuksen heikkenemiselle.
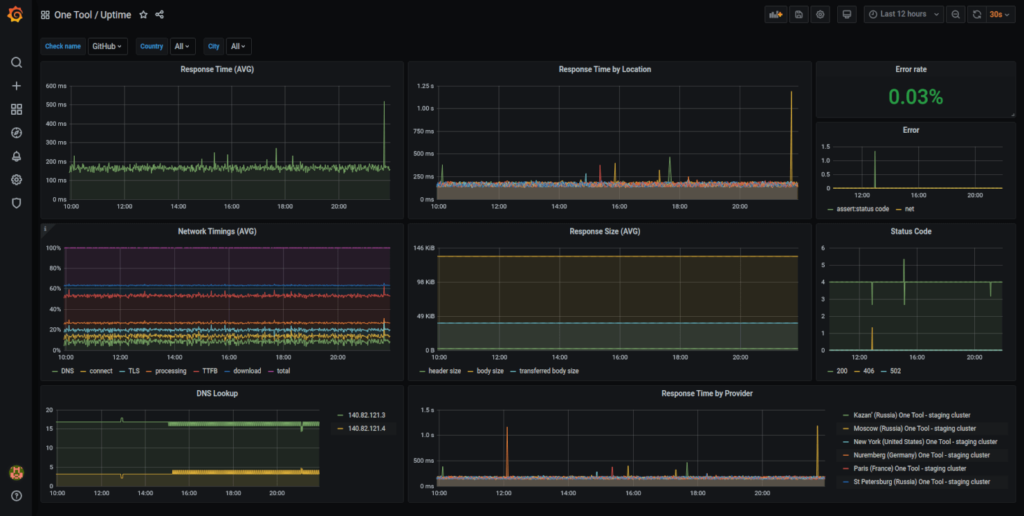
Viime kädessä sinun on pyrittävä ”viiteen ysiin” pitämällä käyttökatkot enintään noin viidessä minuutissa vuodessa. Grafanaa ja Prometheusta suositellaan usein käyttäjäystävällisinä ja helposti saatavilla olevina työkaluina tähän suorituskyvyn valvonnan osa-alueeseen.
3. Tapahtumat (ja virheasteet)
Tarvitset selkeän kuvan siitä, kuinka paljon liikennettä infrastruktuurisi tukee kulloinkin. Siksi on tärkeää seurata tapahtumia eli pyyntöjen määrää sekunnissa sekä vastaavaa keskimääräistä vasteaikaa. Näiden tietojen avulla voit määrittää palvelimen sujuvaan toimintaan tarvittavien resurssien ja kapasiteetin määrän.
Samalla virheasteen eli epäonnistuneiden pyyntöjen osuuden kaikista vastaanotetuista pyynnöistä seuraaminen voi antaa lisätietoa palvelusi kuormankantokyvystä. Jotta saat tästä mittarista mahdollisimman paljon hyötyä, on parasta muodostaa vertailutaso ajan mittaan passiivisen valvonnan avulla.
Tämä on ratkaisevan tärkeää trendien seuraamisen kannalta. Jos pystyt tarkastelemaan aiempia tietoja ja määrittämään sujuvaan toimintaan tarvittavan enimmäiskapasiteetin ja resurssit, voit toimia ennakoivasti kohdentaaksesi nämä tarpeet ja paikantaaksesi infrastruktuuriongelmat havaittujen virheasteiden pienentämiseksi ja keskimääräisen vasteajan optimoimiseksi.
Tapahtumien ja virheasteiden valvonta
Seuraavat ovat luotettavia työkaluja passiiviseen suorituskyvyn valvontaan:
- Verkkoliikenteen nuuskijat: Ne on suunniteltu keräämään mittauksia ”mikroskooppisella tasolla” ”kuuntelemalla” langallisten ja langattomien verkkojen liikennevirtaa. Wireshark on yksi laajimmin hyväksytyistä standardeista. Se kerää tietoja esimerkiksi aikaleimasta, MAC- ja IP-osoitteesta, elinajasta ja muista ominaisuuksista. Näitä voidaan käyttää verkossa tai offline-tilassa.
- Lokitustoiminnot: Ne on yleensä integroitu käyttöjärjestelmiin ja sovelluksiin. Ne keräävät ensisijaisesti tietoja sovellusten tuottamista toiminnoista ja tapahtumista offline-käyttöä varten.
Yksi kymmenestä parhaasta verkkopalvelinten valvontatyökalusta, joka soveltuu erityisen hyvin tapahtumien valvontaan, on Monitis. Se on palvelinten, verkkosivustojen ja sovellusten monipuolinen valvontajärjestelmä. Se sopii sekä Windows- että Linux-järjestelmille ja on ihanteellinen perusteiden, kuten käytettävyysajan, kattamiseen.
Valvontatoimien tavoite ja kohde vaikuttavat näiden tekniikoiden täsmällisiin mittauksiin ja käyttöön.
More Articles
Muita tapahtumien yhteydessä seurattavia mittareita
Vasteaika ja säikeiden kokonaismäärä liittyvät suoraan tapahtumiin. Ne kertovat, kuinka kauan palvelimelta kestää vastata pyyntöön ja kuinka monta säiettä (jotka mahdollistavat tapahtumat) käytetään kaikkien näiden pyyntöjen käsittelyyn.
Jokainen säie käyttää suorittimen aikaa ja RAM-muistia. Liian suuri määrä voi johtaa heikkoon suorituskykyyn. Näiden osalta on valvottava melko monia asioita, kuten:
- Säikeiden kokonaismäärä verkkopalvelimessa tai säilövarannossa, mukaan lukien seuraavat tyypit:
- Aktiiviset
- Joutilaana olevat
- Jumiutuneet
- Valmiustilassa olevat
- Odottavat käyttäjäpyynnöt ja jonon pituus
Palvelimen vastausaikaa voidaan yleensä mitata ensimmäisen tavun vastaanottoon kuluvana aikana (TTFB). Se on millisekuntien määrä, joka selaimelta kuluu palvelimen vastauksen ensimmäisen tavun vastaanottamiseen. Yleisesti ottaen kaikki yli viiden sekunnin ajat ovat kriittisiä.
Oikeiden mittareiden valitseminen palvelimen suorituskyvyn seurantaan
On olemassa pitkä luettelo mittareita, joita voit seurata palvelimesi kunnon ja suorituskyvyn arvioimiseksi, mutta tietyt tavoitteet riippuvat ensisijaisesti seurantatoimiesi tarkoituksesta.
Jotkin mittarit soveltuvat parhaiten laitteistosi ja käyttöjärjestelmäsi kuormankeston arvioimiseen, kun taas toiset ovat ihanteellisia käyttäjien toiminnan tarkkailuun. Joka tapauksessa suorittimen käyttö, käytettävyysaika ja tapahtumat ovat perusasioita, joita ei voi jättää huomiotta.
Kun etenet QA-vastaavana ja tavoitteesi väistämättä muuttuvat, lisäät epäilemättä hallintapaneeliisi uusia palvelimen seurantamittareita. Jos haluat lisää asiantuntijanäkemyksiä siitä, mitä niiden tulisi olla ja miten niitä hallitaan, tilaa uutiskirje.