


Udviklingen inden for test i produktion
Trods betydelige teknologiske fremskridt er test i produktion (TIP) fortsat en af de mest udfordrende aspekter af softwareudvikling. Det grundlæggende dilemma består:
Hvordan tester man i live-miljøer uden at risikere virksomhedens kontinuitet?
Dengang vs. i dag:
- 2005 (bronzealderen): Begrænsede muligheder, høj risiko, få brugbare strategier
- I dag: Avancerede værktøjer og metoder, men stadig komplekse implementeringsudfordringer
Moderne cloudarkitektur, mikrotjenester og containerisering har forandret applikationsudviklingen, men har ikke fjernet de grundlæggende spørgsmål om test i produktion:
- Hvornår er det rette tidspunkt at udføre produktionstests?
- Hvordan kan man minimere risici og samtidig maksimere indsigter?
- Hvilken ramme sikrer konsekvent og pålidelig test i produktion?
Denne artikel præsenterer en strategisk tilgang til TIP, der afvejer vigtig risikostyring mod de kritiske indsigter, som kun virkelige miljøer kan give.
Paradokset ved test i produktion: Risiko kontra nødvendighed
Vigtig indsigt: TIP skaber et grundlæggende paradoks – man er nødt til at finde kritiske fejl i virkelige miljøer, men det indebærer en risiko for de samme miljøer.
Det grundlæggende dilemma ved test i produktion
Test i produktion udgør en klassisk Catch-22:
- Man har brug for produktionstest for at finde fejl, der kun opstår under virkelige forhold
- Praktisk produktionstest indebærer dog en risiko for at forstyrre kritiske forretningsaktiviteter
- Jo bedre ens test er til at finde katastrofale fejl, desto større er faren for virksomhedens kontinuitet
Indvirkning i den virkelige verden: Transaktionsbehandlingssystemer kan ikke tåle selv ét minuts nedetid – alligevel er test i produktion afgørende for at sikre, at de aldrig oplever denne nedetid.
Hvorfor traditionelle tilgange til test i produktion fejler
Historisk tilgang: Korte testperioder i slutningen af udviklingscyklusser
Læren fra Tjernobyl: Ligesom atomkatastrofen, der blev forårsaget af en "sikkerhedstest" på en reaktor i drift, indebærer test i produktion betydelige risici, når den implementeres dårligt.
To kritiske problemer ved test i produktion i slutningen af processen
1. Systemiske problemer opdages for sent
Når test i produktion afslører betydelige problemer:
- Er de pr. definition systemiske problemer (ellers ville de være dukket op i testmiljøer)
- Kræver disse problemer omfattende diagnosticering og komplekse løsninger
- Virker løsninger ved første forsøg sjældent på grund af den indviklede karakter af systemiske problemer
- Forlænges leveringsplanen uundgåeligt med 1-2 måneder eller mere
2. Kritiske ydelsesproblemer viser sig, når det er for sent
Produktionstest afslører primært to ødelæggende problemtyper:
Problemer med belastning og skalerbarhed
- Forretningspåvirkning: Ubrugeligt i spidsbelastningsperioder
- Kundereaktion: Øjeblikkelig utilfredshed
Fejl i stabilitet og pålidelighed
- Forretningspåvirkning: Uforudsigelige driftsafbrydelser
- Kundereaktion: Tab af tillid
Kundeperspektiv: Mindre fejl i funktioner kan rettes og tilgives, men fejl i ydeevne og stabilitet, der lammer forretningsprocesser, er utilgivelige og afgørende grunde til at fravælge løsningen.
Konklusionen om tidspunktet for test i produktion
Praktiske TIP-strategier skal afveje to modstridende realiteter:
- Test i produktion skal foregå tidligt og fortsætte gennem hele udviklingen
- Test i produktion indebærer iboende risici, som skal håndteres omhyggeligt
Løsningen er ikke at undgå test i produktion, men at implementere den strategisk fra begyndelsen af udviklingsprocessen.
Så rent forretningsmæssigt — både set fra kundens og din side — er det en klassisk og ødelæggende fejl at gemme TIP til slutningen af releasecyklussen.
Den strategiske begrundelse for tidlig test i produktion
Grundprincip: I modsætning til almindelig praksis skal test i produktion begynde tidligt i udviklingscyklussen og fortsætte hele vejen igennem — ikke kun til sidst.
Have an account? Log In
Frekvensdilemmaet ved test i produktion
Test i produktion stiller udviklere over for modstridende mål:
- Hyppigere test = Bedre diagnosticering og tidligere fejlfinding
- Hyppigere test = Øget risiko for driftsforstyrrelser i produktionen
- Mindre test = Fejl opdages først, når det er for sent at rette dem effektivt
Denne udfordring minder om, hvorfor ydelsestest ofte skubbes til slutningen af projektet — præcis når den er mest forstyrrende og mindst effektiv.
Afkræftelse af »feature-fejlslutningen« ved test i produktion
Hvad er feature-fejlslutningen?
Feature-fejlslutningen er den fejlagtige opfattelse, at test i produktion bør vente, indtil et produkt er »featurekomplet« — en forestilling, der skaber unødvendig risiko.
Hvorfor denne tilgang mislykkes:
- Systemnedbrud skyldes sjældent én enkelt funktion
- Problemer med ydeevne og stabilitet udspringer af arkitektoniske fejl
- Problemer med den grundlæggende hukommelsesstyring og ressourceallokering har eksisteret fra begyndelsen
- Disse grundlæggende problemer kan og bør testes tidligt i produktionsmiljøer
Moderne arkitektur: Nye værktøjer, samme problemer
Selvom udviklingen har bevæget sig fra funktionscentrerede til servicecentrerede modeller, består testudfordringerne:
Myten om servicekomplethed:
- Gammel tankegang: »Vi skal have alle funktioner færdige, før vi laver TIP.«
- Ny tankegang: »Vi skal have alle services færdige, før vi laver TIP.«
- Virkelighed: Begge tilgange forsinker på farlig vis kritisk test
Containerisering: Løfte kontra virkelighed ved test i produktion
Løftet:
- Isolerede services reducerer fejl, der rammer hele systemet
- Hurtigere opdateringer med mindre risiko
- Forenklet fejlfinding
Virkeligheden ved test i produktion:
- Services er stadig meget indbyrdes afhængige
- Fejl spreder sig stadig gennem afhængighedskæder
- Samspillet mellem komponenter skaber nye, uforudsete adfærdsmønstre
- Servicegrænser gør testdesign mere komplekst
En praktisk ramme for test i produktion
Udfordringen med forskellen mellem miljøer
Afstanden mellem test- og produktionsmiljøer skaber betydelige udfordringer:
- Produktionen er eksponentielt mere kompleks
- Datamængderne varierer med flere størrelsesordener
- Det er umuligt at simulere trafikmønstre fuldstændigt
- Omkostningsbegrænsninger begrænser testmiljøets lighed med produktionen
Løsningen med progressiv test
I stedet for ét enkelt testmiljø bør du implementere en progressiv tilgang til TIP:
1. Opret specialiserede miljøer:
- Systemfokuseret testmiljø
- Funktionsfokuseret testmiljø
- Testmiljø med egenskaber, der minder om produktionen
2. Byg en stige i stedet for at stå foran en kløft:
- Begynd tidligt at teste kernearkitekturen i produktionen
- Øg gradvist testens kompleksitet
- Identificer systemiske problemer, før de bliver indgroede
- Reducer overraskelser og planlægningsrisici i slutfasen
3. Implementer kontrolleret eksponering:
- Brug funktionsflag til at begrænse brugernes påvirkning
- Test med syntetiske transaktioner i produktion
- Overvåg rigtige brugere, der interagerer med nye komponenter
- Udvid gradvist testomfanget i live-miljøer
Denne tilgang forvandler TIP fra en højrisikoaktivitet i slutfasen til en kontinuerlig, kontrolleret proces, der leverer tidligere indsigt med en håndterbar risiko.
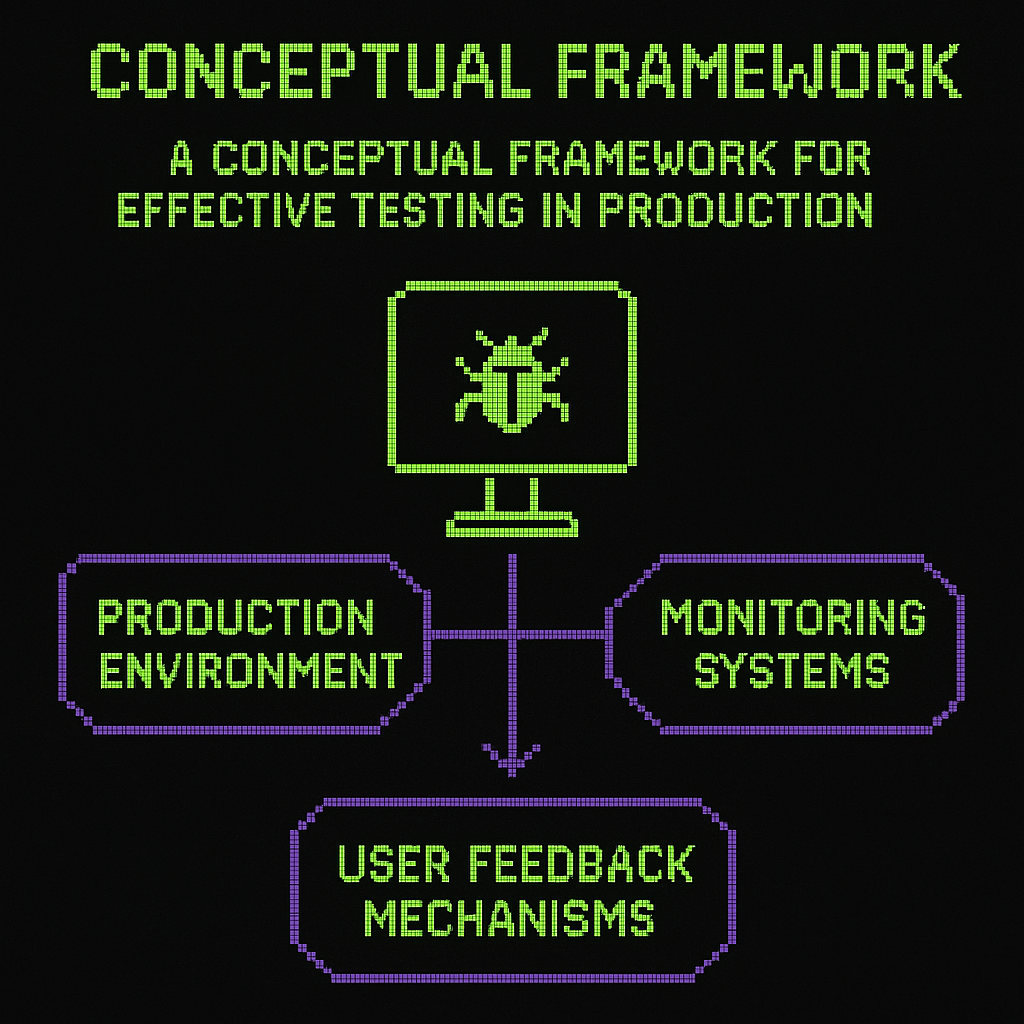
En konceptuel ramme for effektiv testning i produktion
Ud over den praktiske infrastruktur kræver vellykket TIP en grundlæggende ændring i måden, vi tænker på, når problemer skal opdages og håndteres.
Overvindelse af den "empiriske fejlslutning" ved testning i produktion
Hvad er den empiriske fejlslutning?
Den empiriske fejlslutning ved TIP er overbevisningen om, at du skal:
- Være vidne til, at et problem opstår i realtid
- Se hele problemet udfolde sig med dine egne øjne
- Opleve det fuldstændige svigt for at kunne diagnosticere det
"Jeg kan jo ikke se det ske lige foran mig, så jeg ved ikke, hvordan jeg skal diagnosticere det."
Denne tilgang til TIP er:
- Ulogisk - Vi kræver ikke, at kriminalefterforskere overværer mord for at opklare dem
- Ineffektiv - Det spilder tid og ressourcer at vente på, at problemer manifesterer sig fuldt ud
- Unødvendig - Dygtige ingeniører kan forudsige potentielle fejludløsende punkter
En arkitektur-først-tilgang til testning i produktion
Vigtig indsigt: Systemiske problemer er næsten altid arkitekturproblemer.
Denne erkendelse ændrer vores tilgang til TIP:
- Prioritér testning af arkitekturen fra projektets begyndelse
- Påbegynd belastnings- og ydelsestest tidligt i udviklingen
- Identificér potentielle flaskehalse før de bliver indlejret
- Test kernekomponenter i produktion før funktionaliteten er færdig
Udfordringer ved traditionelle udviklingsmetoder
Denne arkitektur-først-tilgang til TIP kræver, at man gentænker:
- Agile-metoder - Systemiske egenskaber kan ikke altid opdeles i sprint
- Prioritering af funktionalitet - Kernearkitekturen skal have forrang
- Testplaner - Testning i produktion skal begynde tidligere
- Ressourcefordeling - Større forudgående investering i testmiljøer
Relateret læsning: AGILE TESTMETODOLOGI: HVORFOR DEN VIRKER, OG HVORDAN DEN IMPLEMENTERES
Samarbejdsbaseret forudsigelse: En bedre vej til testning i produktion
Den mest effektive TIP-strategi kombinerer:
Ingeniørmæssig indsigt:
- Arkitekter identificerer potentielle svage punkter
- Udviklere fremhæver risikable interaktioner mellem komponenter
- Systemdesignere kortlægger potentielle flaskehalse
Målrettet QA-testning:
- Opbyg fokuserede testscenarier for forudsagte problemer
- Design belastningstests for specifikke arkitekturkomponenter
- Skab kontrollerede eksperimenter til produktionsmiljøer
Denne samarbejdsbaserede tilgang betyder:
- Problemer opstår i isolerede, diagnostiske sammenhænge
- Problemer opdages, før de påvirker kunderne
- Rettelser kan implementeres metodisk, ikke i krisetilstand
Den trinvise vej til testning i produktion
Testning i produktion bør ikke være en binær alt-eller-intet-begivenhed som:
- At tænde på en lyskontakt i et mørkt rum
- At gå fra nul til fuld eksponering øjeblikkeligt
- Korte perioder med høj risiko ved projektets afslutning
Implementer i stedet test i produktion som:
- En gradvis tilgang i faser
- Progressiv tilnærmelse til fulde produktionsforhold
- Kontinuerlig risikoreduktion gennem målrettet eksponering
Funktionsflag: Grundlaget for sikker test i produktion
Funktionsflag er kernen i moderne strategier for test i produktion. De er en afgørende mekanisme, der ændrer den måde, teams validerer software i aktive produktionsmiljøer på.
Hvad er funktionsflag?
Funktionsflag (også kaldet funktionstilkoblinger) er en softwareudviklingsteknik, der gør det muligt for teams at:
- Implementere kode uden eksponering - Udrulle ny funktionalitet til produktion, samtidig med at den holdes usynlig for brugerne
- Kontrollere funktionalitet eksternt - Aktivere eller deaktivere funktioner uden at udrulle ny kode
- Målrette specifikke segmenter - Eksponere funktioner for udvalgte brugergrupper med henblik på test i produktion
Som brancheeksperter definerer det: "Et funktionsflag er en softwareudviklingsproces, der bruges til at aktivere eller deaktivere funktionalitet uden at udrulle kode. Du kan indlejre en funktion i et flag for at udrulle den til produktion uden at gøre den synlig for alle brugere."
Sådan forandrer funktionsflag test i produktion
Funktionsflag ændrer grundlæggende risikoprofilen ved TIP ved at:
- Adskille implementering fra udgivelse - Kode kommer ind i produktionen i en inaktiv tilstand
- Muliggøre øjeblikkelig tilbagerulning - Problemer kan afhjælpes uden nye implementeringer
- Skabe kontrollerede testmiljøer - Reelle produktionsforhold med begrænset eksponering
Disse funktioner imødegår det centrale dilemma ved TIP, som blev omtalt tidligere – de giver fordelene ved test i produktion, samtidig med at de tilknyttede risici reduceres betydeligt.
Implementering af gradvise udrulninger i produktionen
En af de mest effektive anvendelser af funktionsflag til TIP er den gradvise udrulning:
Eksempel på implementering:
- Dag 1: Aktivér den nye funktion for 1 % af brugerne
- Dag 3: Hvis målingerne forbliver stabile, øges andelen til 5 %
- Dag 7: Hvis ydeevnen er positiv, øges andelen til 25 %
- Dag 14: Fuld udrulning, hvis der ikke er registreret problemer
"Et praktisk eksempel på test i produktion er at bruge funktionsflag til en gradvis udrulning. Forestil dig en e-handelsvirksomhed, der introducerer en ny anbefalingsalgoritme på sine produktsider. I stedet for at udrulle den til alle brugere på én gang bruger virksomheden et funktionsflag til indledningsvis kun at aktivere den nye algoritme for 5 % af trafikken."
Denne tilgang gør det muligt for teams at opdage problemer, der påvirker en lille del af brugerne, før de påvirker hele brugerbasen.
A/B-test i produktionsmiljøer
Funktionsflag muliggør avancerede eksperimenter direkte i produktionen:
- Sammenlign implementeringer - Test flere versioner af en funktion med forskellige brugersegmenter
- Træf datadrevne beslutninger - Basér valgene på målinger af ydeevnen i den virkelige verden
- Validér brugeroplevelsen - Afgør, hvilken version der giver bedre resultater
Som branchekilder bemærker: "Værktøjer til funktionsflag har også den ekstra fordel, at de muliggør A/B-test, hvor den nye funktion sammenlignes med den tidligere version af softwaren for at se, hvilken der giver en bedre brugeroplevelse baseret på produktionsdata."
Integration af funktionsflag med overvågningssystemer
Funktionsflags fulde potentiale til TIP realiseres gennem integration med overvågning:
Vigtige integrationsfordele:
- Automatisk registrering af problemer - Korreler aktiveringer af funktioner med målinger af ydeevnen
- Hurtig hændelsesrespons - Identificer og deaktiver problematiske funktioner hurtigt
- Kontinuerlig validering - Overvåg funktionens indvirkning gennem hele udrulningsprocessen
Når problemer med systemets ydeevne registreres i overvågningsværktøjer, kan teams "hurtigt finde og deaktivere (dvs. trykke på en nødafbryder) den funktion, der forårsager hændelsen", hvilket giver et sikkerhedsnet, der gør TIP betydeligt sikrere.
Funktionsflag i en arkitektur-først-teststrategi
For at maksimere værdien af funktionsflag ved TIP:
- Markér arkitekturkomponenter - Muliggør test af centrale systemelementer
- Opret funktionshierarkier - Etabler overordnede-underordnede relationer mellem flag
- Definér kredsløbsafbrydere - Angiv automatiske tærskler for deaktivering
- Dokumentér afhængigheder - Kortlæg interaktioner mellem markerede komponenter
- Planlæg oprydning - Etabler processer til fjernelse af forældede flag
Denne tilgang understøtter den tidligere beskrevne arkitektur-først-testmetode ved at gøre det muligt for teams at teste grundlæggende systemkomponenter sikkert i produktion tidligt i udviklingscyklussen.
Platforme til funktionsstyring: Forandring af test i produktion
Moderne TIP-strategier kræver værktøjer, der styrer risikoen og samtidig muliggør validering i den virkelige verden. Platforme til funktionsstyring er blevet væsentlige komponenter i effektive testmiljøer.
Sådan forbedrer funktionsstyring test i produktion
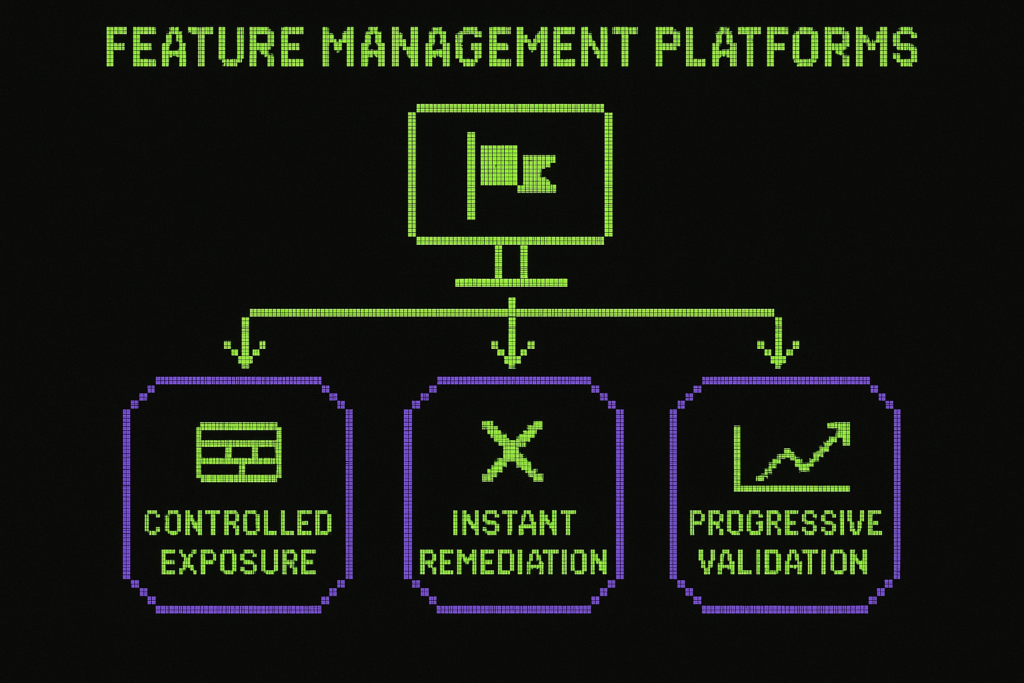
Platforme til funktionsstyring leverer den infrastruktur, der er nødvendig for sikker og kontinuerlig TIP:
- Kontrolleret eksponering - Test med specifikke brugersegmenter i stedet for udrulninger, der gælder alle eller ingen
- Øjeblikkelig afhjælpning - Deaktivér problematiske funktioner uden at udrulle kode
- Progressiv validering - Øg eksponeringen gradvist baseret på ydelsesdata
Disse funktioner forvandler test i produktion fra en højrisikoaktivitet til en kontrolleret og metodisk proces.
Funktionsflag: Grundlaget for test i produktion
Som nævnt er funktionsflag (undertiden kaldet funktionsomskiftere) kernen i disse platforme, og de gør det muligt for teams at:
- Udrulle kode til produktion, mens den holdes skjult for de fleste brugere
- Aktivere eller deaktivere funktionalitet uden nye udrulninger
- Teste i produktion med minimal risiko for forretningsdriften
Fordel ved implementering i praksis: "LaunchDarklys platform til funktionsstyring giver teams en problemfri måde med lav risiko til at teste softwareændringer i produktion med høj frekvens og i stor skala", hvilket muliggør den kontinuerlige testtilgang.
Kritisk integration: Observerbarhed + funktionsstyring
De mest effektive TIP-implementeringer forbinder funktionsstyring med værktøjer til observerbarhed:
- Korrelation i realtid - Forbind aktivering af funktioner med ydelsesmetrikker
- Automatiserede sikkerhedsforanstaltninger - Udløs deaktivering af funktioner, når ydeevnen forringes
- Analyse af den grundlæggende årsag - Identificér hurtigt, hvilke funktioner der påvirker systemets stabilitet
Denne integration skaber et sikkerhedsnet, der reducerer risiciene ved TIP betydeligt, samtidig med at fordelene maksimeres.
Succes i den virkelige verden med platforme til test i produktion
Organisationer på tværs af brancher har forandret deres TIP-tilgang ved hjælp af funktionsstyring:
IBM, TrueCar og O'Reilly Media har implementeret platforme til funktionsstyring for at muliggøre kontinuerlig test i produktion med minimal risiko.
Som Chris Guidry, teknisk chef hos O'Reilly Media, forklarer:
"[Vores ingeniører] kan teste funktioner i produktion længe før en markedsføringslancering. Og hvis en funktion forårsager problemer på lanceringsdagen, kan vi bare slå den fra med en nødafbryder – ingen tilbagerulninger. LaunchDarkly gør vores udgivelser kedelige. Det er præcis det, vi ønsker."
Implementeringsstrategi
For effektivt at udnytte platforme til funktionsstyring ved test i produktion:
- Start med kernearkitekturen - Markér fundamentale komponenter først
- Opret gradvise udrulningsplaner - Definér eksponeringsprocenter og udløsere
- Fastlæg overvågningstærskler - Angiv tydelige målepunkter for succes og fiasko
- Dokumentér afhængigheder - Kortlæg relationer mellem markerede funktioner
- Implementér kredsløbsafbrydere - Konfigurér automatisk deaktivering ved kritiske problemer
Denne systematiske tilgang muliggør den arkitektur-først-TIP-strategi, der blev anbefalet tidligere, samtidig med at den leverer de sikkerhedsmekanismer, der er nødvendige for at gøre den praktisk anvendelig.
Kombination af funktionsstyring med gradvise testmiljøer
For at opnå optimale TIP-resultater skal du integrere platforme til funktionsstyring med den trinvise tilgang til testmiljøer:
- Brug funktionsflag i tidlige testmiljøer til at validere kernekoncepter
- Oprethold en ensartet flagkonfiguration på tværs af miljøer
- Øg gradvist eksponeringen for rigtige brugere i produktionen
- Udnyt automatiseret overvågning for at sikre sikkerheden
Denne kombinerede tilgang leverer fordelene ved tidlig TIP, samtidig med at den opretholder den kontrollerede, gradvise risikoreduktion, der er afgørende for en vellykket levering.
Værktøjer til test i produktion: Udfordringer ved implementering
Selvom funktionsflag og administrationsplatforme udgør grundlaget for TIP, medfører behovet for at vælge og implementere de rette understøttende værktøjer yderligere overvejelser.
Det er afgørende at forstå disse udfordringer for at skabe en effektiv strategi for test i produktion.
More Articles
Værktøjer til overvågning og observerbarhed
Omfattende synlighed er afgørende ved TIP, men valg af værktøjer kræver en grundig evaluering:
Overvågning af applikationsydelse (APM):
- Fordele: Detaljeret indsigt i ydeevnen på tværs af servicegrænser
- Udfordringer: Kan generere overvældende datamængder; kræver betydelig konfiguration
- Overvejelse ved implementering: "Effektivt overvågningsværktøj med omfattende indsigt, men det kræver opsætning og løbende finjustering for at undgå dataoverbelastning."
Løsninger til distribueret sporing:
- Fordele: Spor anmodninger på tværs af mikrotjenester; identificér flaskehalse
- Udfordringer: Kræver instrumentering på tværs af alle tjenester; kan påvirke ydeevnen
- Overvejelse ved implementering: "Effektivt til sporing af ydeevneproblemer, men komplekst at opsætte for mindre teams."
Platforme til loganalyse:
- Fordele: Leverer detaljerede diagnostiske oplysninger; understøtter retsmedicinsk analyse
- Udfordringer: Lageromkostningerne kan hurtigt eskalere; kræver en struktureret tilgang til logning
- Overvejelse ved implementering: "Værdifuldt til fejlfinding af komplekse problemer i produktionen, men kræver en sammenhængende logningsstrategi for at forhindre informationsoverbelastning."
Systemer til alarmhåndtering
Korrekt alarmhåndtering er afgørende ved test af nye funktioner i produktionen:
Platforme til hændelseshåndtering:
- Fordele: Effektiviserer kommunikationen under hændelser; automatiserer de første svar
- Udfordringer: Kræver omhyggelig konfiguration af tærskler; integration med flere systemer
- Overvejelse ved implementering: "Fremragende til hændelseshåndtering, men kan være forstyrrende, hvis det ikke konfigureres omhyggeligt for at undgå alarmtræthed."
Værktøjer til syntetisk overvågning:
- Fordele: Validerer løbende kritiske stier; registrerer problemer før brugerne
- Udfordringer: Begrænset til foruddefinerede scenarier; kan overse problemer med den reelle brugeroplevelse
- Overvejelse ved implementering: "Leverer ensartet grundvalidering, men skal suppleres med overvågning af rigtige brugere for at opnå omfattende TIP."
Afvejning af værktøjskompleksitet i forhold til teamets kompetencer
Ved implementering af værktøjer til TIP bør du overveje:
- Teamets ekspertise - Har I de nødvendige færdigheder til at maksimere værktøjets værdi?
- Integrationskrav - Hvor godt forbindes det med jeres eksisterende systemer?
- Driftsmæssige omkostninger - Hvilken løbende vedligeholdelse kræver værktøjet?
- Skalerbarhed - Kan det håndtere jeres produktionsmængder og vækst?
- Signal-støj-forhold - Kan I udlede meningsfuld indsigt uden at drukne i data?
Faldgruber ved implementering af værktøjer til test i produktion
Teams støder ofte på disse udfordringer, når de implementerer testværktøjer i produktionen:
- Overvågningshuller - Kritiske komponenter, der ikke er instrumenteret
- Alarmtræthed - For mange notifikationer får teams til at ignorere advarsler
- Utilstrækkelig kontekst - Advarsler uden handlingsanvisende information
- Datasiloer - Værktøjer, der ikke deler information på tværs af platforme
- Ydeevnepåvirkning - Overvågningsværktøjer, der forringer det system, de måler
Bedste praksis for implementering af værktøjer til test i produktion
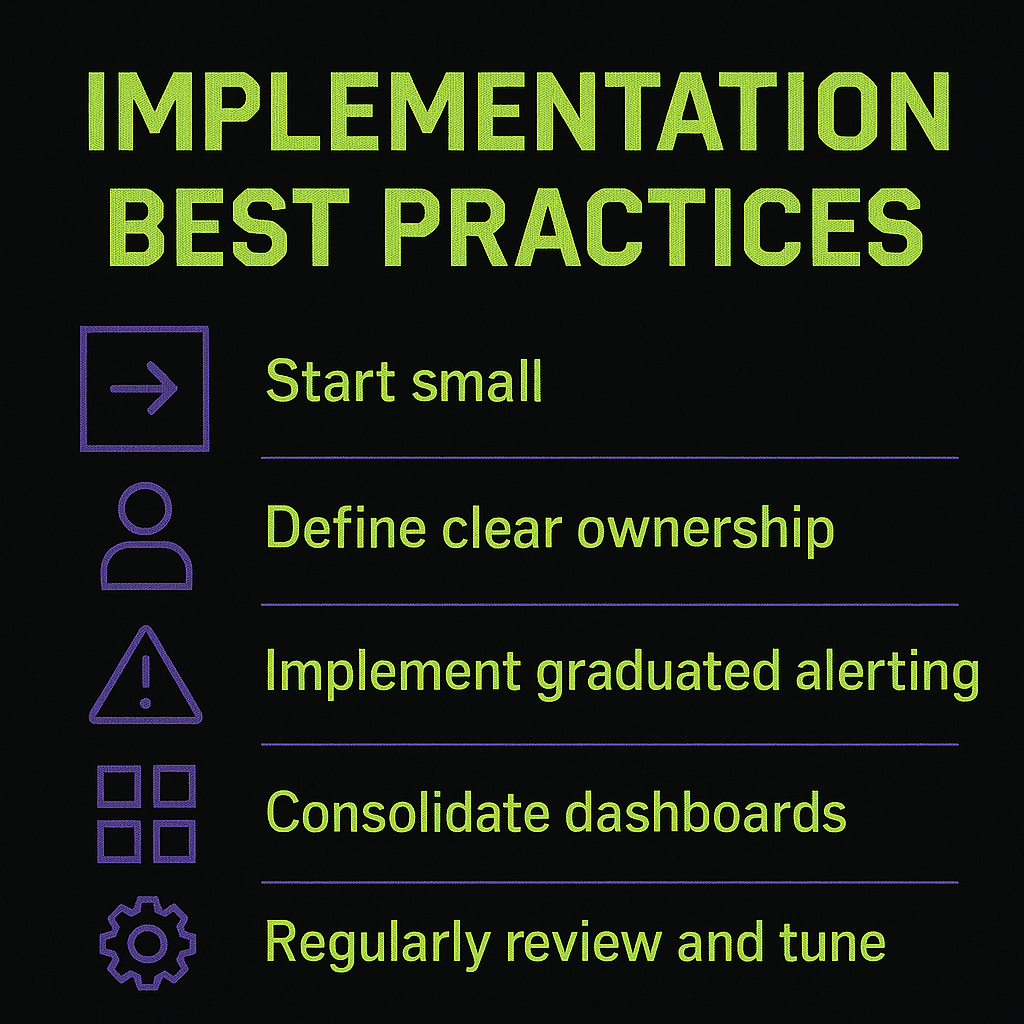
For at maksimere effektiviteten og samtidig minimere udfordringerne:
- Start i det små - Begynd med centrale brugerrejser og kritiske tjenester
- Definer et tydeligt ejerskab - Fastlæg, hvem der reagerer på de forskellige alarmtyper
- Implementer gradueret alarmering - Opret advarselstærskler før kritiske niveauer
- Konsolider dashboards - Opret samlede visninger, der sammenholder data på tværs af værktøjer
- Gennemgå og finjuster regelmæssigt - Juster tærskler baseret på faktiske produktionsmønstre
Den rette balance mellem værktøjer muliggør effektiv TIP og giver samtidig det sikkerhedsnet, der er nødvendigt for at minimere risikoen. Vælg værktøjer, der passer til jeres teams kompetencer, og integrer dem gennemtænkt i jeres testtilgang.
Afsluttende tanker om test i produktion
De mest succesfulde TIP-strategier følger disse principper:
- Start tidligt - Vent ikke til slutningen af udviklingen
- Test trinvist - Brug en række miljøer med stigende kompleksitet
- Tænk forudsigende - Reager ikke bare på problemer, men foregrib dem
- Samarbejd på tværs af funktioner - Udvikling og QA skal arbejde sammen
- Reducer risikoen systematisk - Hver testfase bør øge tilliden
TIP er afgørende, men behøver ikke at være farligt. Ved at kombinere praktiske forbedringer af miljøet med konceptuelle ændringer i vores tilgang til test kan vi forvandle test i produktion fra et nødvendigt onde til en kontinuerlig og værdifuld praksis.
Husk: Softwareudgivelser er produktleverancer, ikke månelandinger. En gradvis reduktion af risikoen gennem intelligent test i produktion skaber langt bedre resultater end dramatiske spring ud i det ukendte i de sidste timer.
Finder du denne tilgang til test i produktion værdifuld? Hvis du vil have mere indsigt fra eksperter inden for QA og test, kan du tilmelde dig CTO Clubs nyhedsbrev.



