
10 Kortlista över de bästa verktygen för kaosteknik


Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av de bästa verktygen för kaosteknik
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av verktyg för kaosteknik och hjälper dig att hitta det bästa alternativet för din budget och dina affärsbehov.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för dynamisk riskanalys över system | 30 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Pris på begäran | Website | |
| 2 | Bäst för anpassningsbara felscenarier i Linux | Gratis för alltid (öppen källkod) | Gratis att använda | Website | |
| 3 | Bäst för automatiserade resiliensarbetsflöden | Gratis för alltid (öppen källkod) | Gratis att använda | Website | |
| 4 | Bäst för automatiserade avslut av instanser | Gratis för alltid (öppen källkod) | Gratis att använda | Website | |
| 5 | Bäst för riskvalidering med miljöskanning | 30 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Pris på begäran | Website | |
| 6 | Bäst för precis felinjektering i stor skala | 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Pris på begäran | Website | |
| 7 | Bäst för integrerad resilienstestning | Gratis provperiod + kostnadsfri demo tillgänglig | Prisuppgift på begäran | Website | |
| 8 | Bäst för inbyggd störning av AWS-molnet | Gratisplan tillgänglig | Från $0.10/åtgärdsminut | Website | |
| 9 | Bäst för kaosexperiment för Azure-användare | 30 dagars kostnadsfri provperiod tillgänglig | Från $0.10 per åtgärdsminut | Website | |
| 10 | Bäst för Kubernetes-infödd kaosorkestrering | Gratis för alltid (öppen källkod) | Gratis att använda | Website |
Recensioner av de bästa verktygen för kaosteknik
Nedan finns mina detaljerade sammanfattningar av de bästa verktygen för kaosteknik som kom med på min kortlista. Mina recensioner ger en detaljerad överblick över funktionerna, användningsområdena och integrationerna för varje verktyg, så att du kan hitta det bästa alternativet för dig.

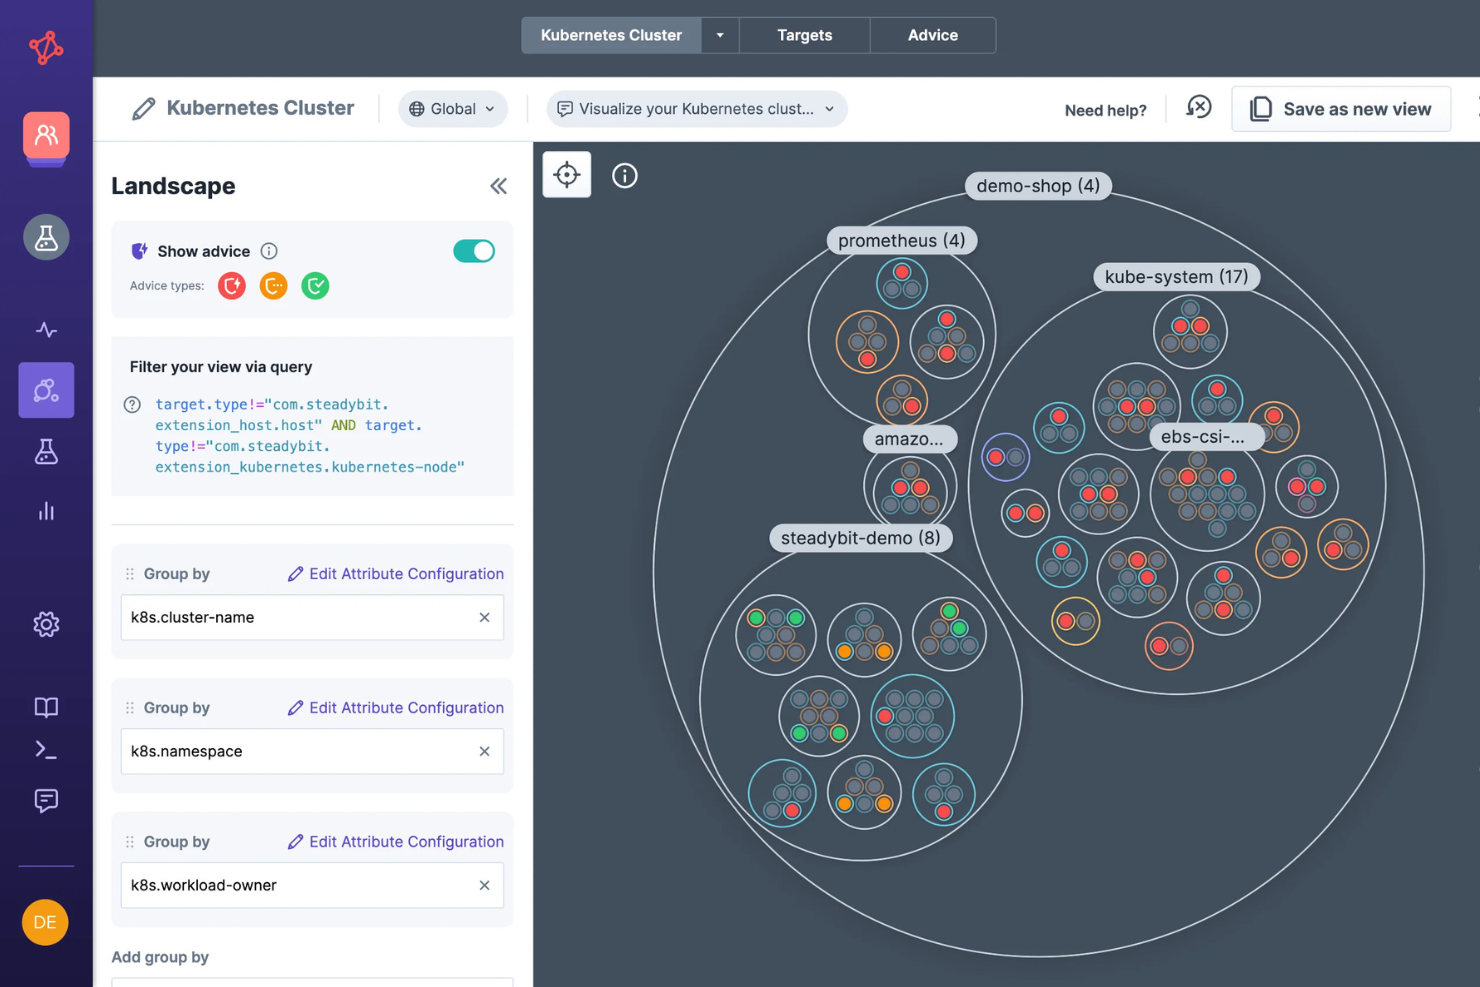
Steadybit är en plattform för kaosteknik som kombinerar automatiserad upptäckt av sårbarheter, kodfri experimentdesign och tillförlitlighetskontroller för Kubernetes för att kontinuerligt upptäcka och validera systemsvagheter innan de orsakar incidenter.
För vem passar Steadybit bäst?
Steadybit passar särskilt bra för plattformsteknik- och SRE-team som driver molnbaserade Kubernetes-miljöer och behöver kontinuerlig validering av tillförlitligheten i distribuerade system.
Därför valde jag Steadybit
Jag valde Steadybit som ett av de bästa alternativen eftersom funktionen Tillförlitlighetsrådgivning inte liknar något jag har sett i andra verktyg. Den kontrollerar kontinuerligt dina aktiva mål mot 13 bästa praxis för Kubernetes och visar samt prioriterar automatiskt bristerna. Jag uppskattar att jag kan lägga till anpassade rådgivningsregler för att matcha interna standarder, så att riskanalysen speglar min faktiska miljö och inte bara generiska riktmärken. Med vyn Utforskaren kan jag sedan gruppera och filtrera dessa mål efter tillgänglighetszon och region för att se exakt var riskerna koncentreras i distribuerade system.
Viktiga funktioner i Steadybit
- Kodfri experimentredigerare: Utforma och kör kaosexperiment med ett dra-och-släpp-gränssnitt utan att skriva några skript.
- Förbyggda experimentmallar: Välj bland färdiga mallar som täcker vanliga felscenarier för att snabbare konfigurera experiment.
- Kontroll av påverkansområde: Definiera experimentets gränser för att begränsa omfattningen av felinjekteringen och skydda kritiska systemkomponenter.
- Automatisering via API och CLI: Utlös och schemalägg experimentkörningar automatiskt med hjälp av Steadybits API eller kommandoradsgränssnitt.
Steadybit-integrationer
Steadybit erbjuder över 20 integrationer med öppen källkod, inklusive AWS, Azure, GCP, Kubernetes, Datadog, Dynatrace, New Relic, Prometheus, Grafana och Slack. Du kan även bygga anpassade tillägg med Steadybits ExtensionKits med öppen källkod och ansluta dem till CI/CD-arbetsflöden via Jenkins och GitHub.
Pros and Cons
Pros:
- Automatiserad riskupptäckt innan experiment körs
- Tilläggspaket med öppen källkod för anpassning
- Alternativ för SaaS- och lokal distribution
Cons:
- Främst Kubernetes-fokuserad målupptäckt
- Mindre community än alternativ med öppen källkod

Chaos Toolkit är ett ramverk med öppen källkod för kaosteknik som kör deklarativa experiment definierade i JSON eller YAML för att testa systemresiliens i moln-, container- och applikationsmiljöer.
Vem passar Chaos Toolkit bäst för?
Chaos Toolkit passar naturligt för DevOps-ingenjörer och SRE:er som vill definiera och versionshantera resiliensexperiment som kod i befintliga CI/CD-pipelines.
Varför jag valde Chaos Toolkit
Jag har inkluderat Chaos Toolkit bland mina främsta val eftersom dess modell med experiment som kod verkligen är utformad för automatiserade resiliensarbetsflöden. Varje experiment är en enda JSON- eller YAML-fil med en definierad hypotes för önskat tillstånd, ett metodblock med sonder och åtgärder samt återställningssteg, så att jag kan versionshantera det i Git och utlösa det direkt från en GitHub Actions- eller GitLab CI-pipeline. Jag uppskattar också att hypotesen för önskat tillstånd körs både före och efter felinjektionen, vilket ger mig en tydlig och strukturerad signal för godkänt/underkänt utan någon manuell jämförelse.
Viktiga funktioner i Chaos Toolkit
- Bibliotek med tilläggsdrivrutiner: Riktar sig mot AWS, Azure, Google Cloud Platform, Kubernetes, Kafka, Istio och ToxiProxy genom specialbyggda tilläggspaket, så att du kan avgränsa felinjektionen exakt till din miljö.
- Kontroller: Lägger till operativa kopplingar runt experimentkörningen så att du kan utlösa externa åtgärder, som loggning eller aviseringar, före eller efter valfri aktivitet utan att ändra kärnfilen för experimentet.
- Kommandot ”Chaos discover”: Inspekterar ett installerat tillägg och genererar en lista över tillgängliga aktiviteter, så att du kan utforska vilka felåtgärder och sonder som stöds innan du skriver ett experiment.
- Schemaläggning av experiment: Kör experiment enligt ett definierat schema via CLI, vilket möjliggör upprepade, obemannade resilienstester utan ett externt orkestreringslager.
Integrationer i Chaos Toolkit
Chaos Toolkit erbjuder ungefär 20 tillägg, inklusive AWS, Azure, Google Cloud Platform, Kubernetes, Istio, Kafka, Prometheus, Datadog, Dynatrace och Slack. Det stöder också distribution i CI/CD-arbetsflöden genom GitHub Actions och GitLab, och dess Python-, HTTP- och processleverantörer låter dig bygga anpassade integrationer.
Pros and Cons
Pros:
- Deklarativa YAML-experiment som lagras i versionshantering
- Inbyggd återställningsmekanism för återgång till önskat tillstånd
- Upptäcker automatiskt tjänster och föreslår experiment
Cons:
- Attacker mot flera mål kräver en anpassad drivrutinskonfiguration
- Ramverksfokuserad utformning kräver manuell sammansättning

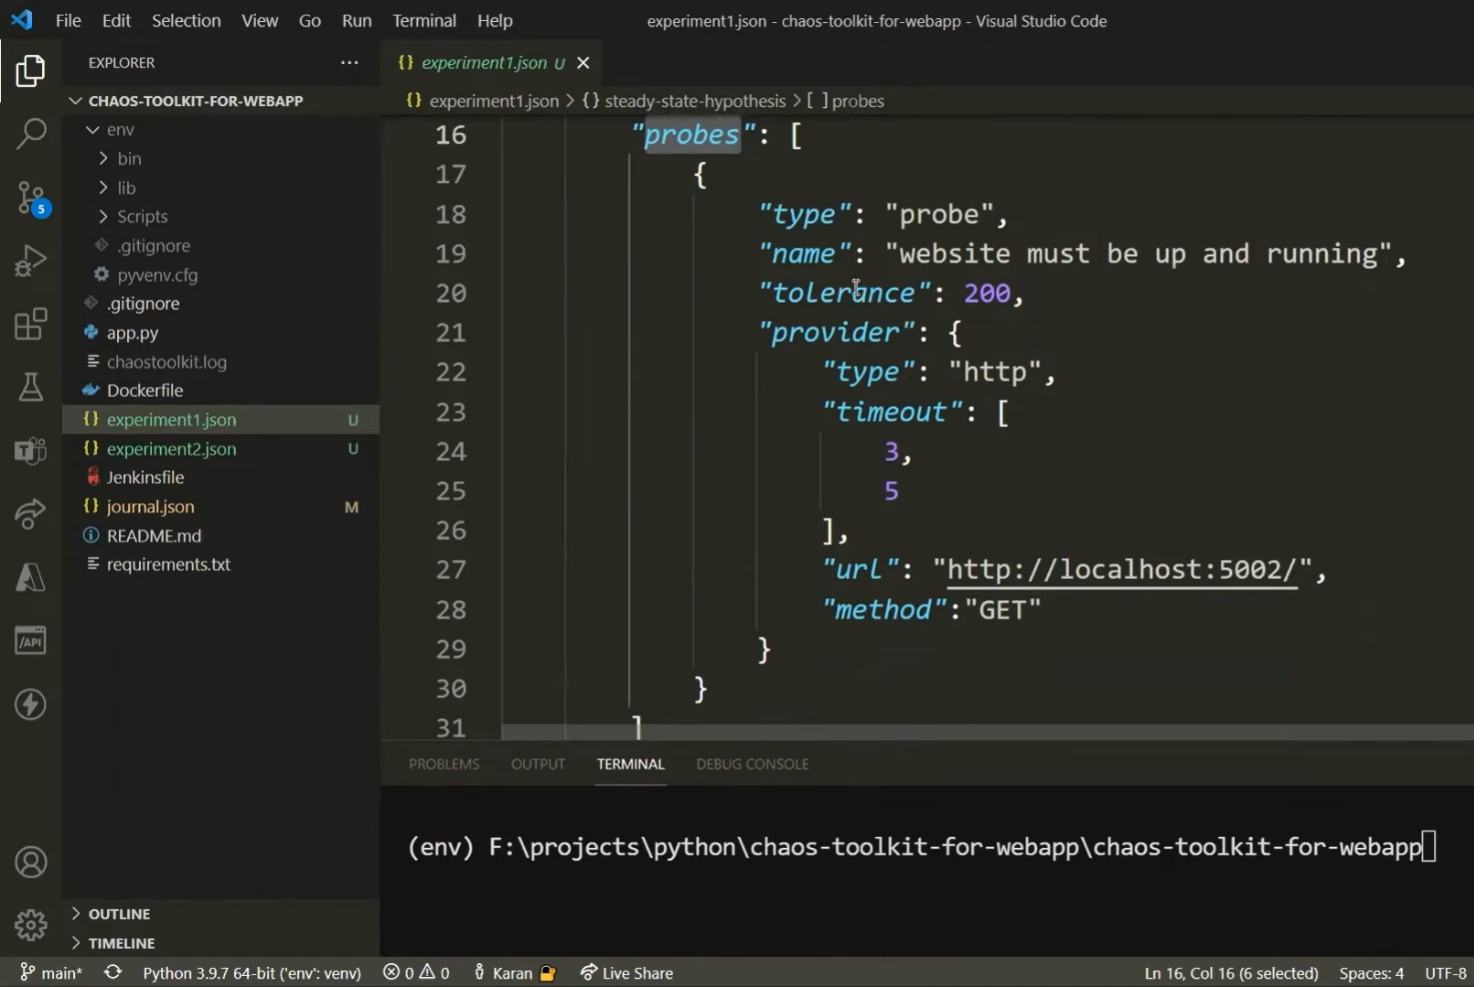
Chaos Toolkit är ett ramverk med öppen källkod för kaosteknik som kör deklarativa experiment definierade i JSON eller YAML för att testa systemresiliens i moln-, container- och applikationsmiljöer.
Vem passar Chaos Toolkit bäst för?
Chaos Toolkit passar naturligt för DevOps-ingenjörer och SRE:er som vill definiera och versionshantera resiliensexperiment som kod i befintliga CI/CD-pipelines.
Varför jag valde Chaos Toolkit
Jag har tagit med Chaos Toolkit bland mina toppval eftersom dess modell med experiment som kod verkligen är byggd för automatiserade resiliensarbetsflöden. Varje experiment är en enda JSON- eller YAML-fil med en definierad hypotes om stabilt tillstånd, ett metodblock med sonder och åtgärder samt återställningssteg, så att jag kan versionshantera det i Git och utlösa det direkt från en GitHub Actions- eller GitLab CI-pipeline. Jag uppskattar också att hypotesen om stabilt tillstånd körs både före och efter felinjekteringen, vilket ger mig en tydlig och strukturerad signal för godkänt/underkänt utan någon manuell jämförelse.
Viktiga funktioner i Chaos Toolkit
- Bibliotek med tilläggsdrivrutiner: Riktar sig mot AWS, Azure, Google Cloud Platform, Kubernetes, Kafka, Istio och ToxiProxy genom specialbyggda tilläggspaket, så att du kan avgränsa felinjekteringen exakt till din miljö.
- Kontrollmekanismer: Lägger till operativa kopplingar runt experimentkörningen så att du kan utlösa externa åtgärder, som loggning eller aviseringar, före eller efter valfri aktivitet utan att ändra den centrala experimentfilen.
- Kommandot ”Chaos discover”: Inspekterar ett installerat tillägg och genererar en lista över tillgängliga aktiviteter, så att du kan utforska vilka felåtgärder och sonder som stöds innan du skapar ett experiment.
- Schemaläggning av experiment: Kör experiment enligt ett definierat schema via CLI, vilket möjliggör upprepade, obemannade resilienstester utan ett externt orkestreringslager.
Integrationer i Chaos Toolkit
Chaos Toolkit erbjuder ungefär 20 tillägg, inklusive AWS, Azure, Google Cloud Platform, Kubernetes, Istio, Kafka, Prometheus, Datadog, Dynatrace och Slack. Det stöder även distribution i CI/CD-arbetsflöden genom GitHub Actions och GitLab, och dess Python-, HTTP- och processleverantörer låter dig bygga anpassade integrationer.
Pros and Cons
Pros:
- Deklarativa YAML-experiment lagrade i versionshantering
- Inbyggd återställningsmekanism för återgång till stabilt tillstånd
- Upptäcker automatiskt tjänster och föreslår experiment
Cons:
- Attacker mot flera mål kräver en anpassad drivrutinskonfiguration
- Ramverksfokuserad design kräver manuell sammansättning

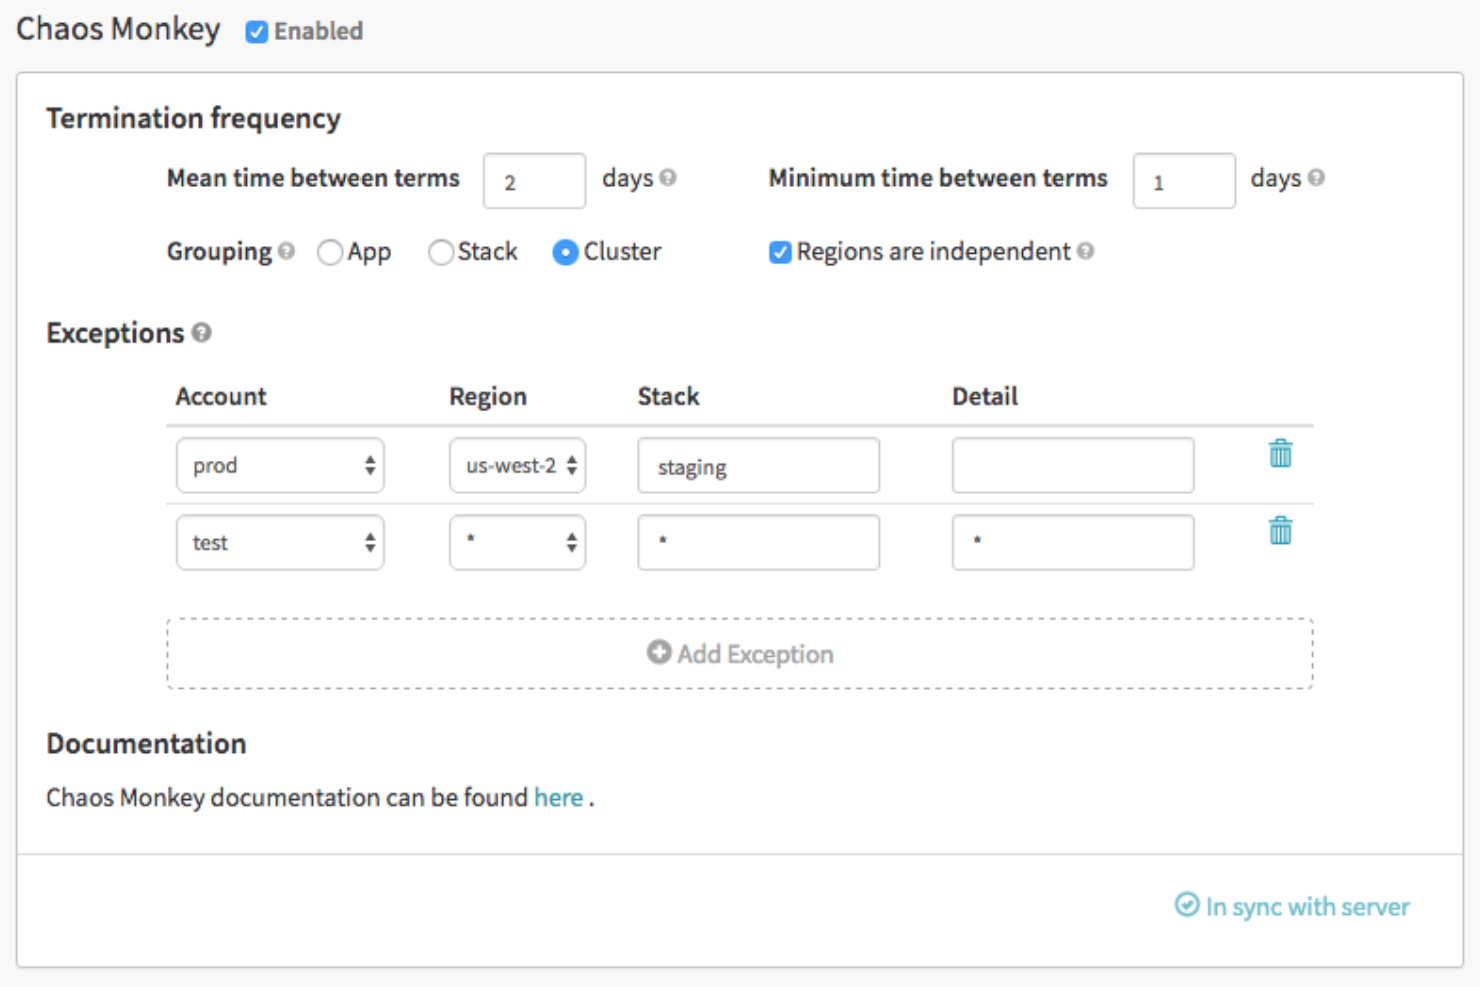
Chaos Monkey är ett verktyg för kaosteknik med öppen källkod, utvecklat av Netflix, som slumpmässigt avslutar virtuella maskininstanser och containrar som körs i din produktionsmiljö.
Vem passar Chaos Monkey bäst för?
Chaos Monkey passar tillförlitlighetsingenjörer på teknikföretag i stor skala som behöver schemalagda, automatiserade feltester i molninfrastrukturen.
Varför jag valde Chaos Monkey
Jag har tagit med Chaos Monkey bland mina toppval eftersom det är ett av få verktyg för kaosteknik som är särskilt byggda kring automatiserade avslut av instanser i aktiva produktionsmiljöer. Jag gillar hur schemaläggningen med viktat myntkast utlöser slumpmässiga avslut mellan kl. 09.00 och 15.00 på vardagar, vilket håller testerna realistiska utan manuell konfigurering. Du kan även konfigurera gruppering på app-, stack- eller klusternivå och ange undantagsregler för att skydda specifika konton eller regioner från avslut.
Viktiga funktioner i Chaos Monkey
- Spinnaker-integrering: Chaos Monkey ansluter till Spinnaker för att upptäcka instansgrupper och hantera avslut i hela din distributionspipeline.
- Konfigurerbart avslutsfönster: Begränsa avslut till arbetstid så att ditt jourteam är tillgängligt när instanser slutar fungera.
- Vitlistning för undantag: Markera specifika appar eller kluster som undantagna så att Chaos Monkey hoppar över dem helt under en avslutscykel.
- Spårning av avslut: Varje avslutad instans loggas i en MySQL-databas, vilket ger dig en fullständig granskningshistorik över kaoshändelser över tid.
Integreringar med Chaos Monkey
Chaos Monkey har ett litet antal inbyggda integreringar och kräver Spinnaker som huvudsakligt beroende för appupptäckt och hantering av avslut samt MySQL som backenddatabas. Det stöder även dynamisk konfiguration via etcd eller Consul.
Pros and Cons
Pros:
- Helt öppen källkod utan licenskostnader
- Beprövat i Netflix produktionsmiljöer i stor skala
- Konfigurerbara scheman och frekvens för avslut
Cons:
- Infogar endast fel genom avslut av instanser
- Kräver Spinnaker för distributionshantering

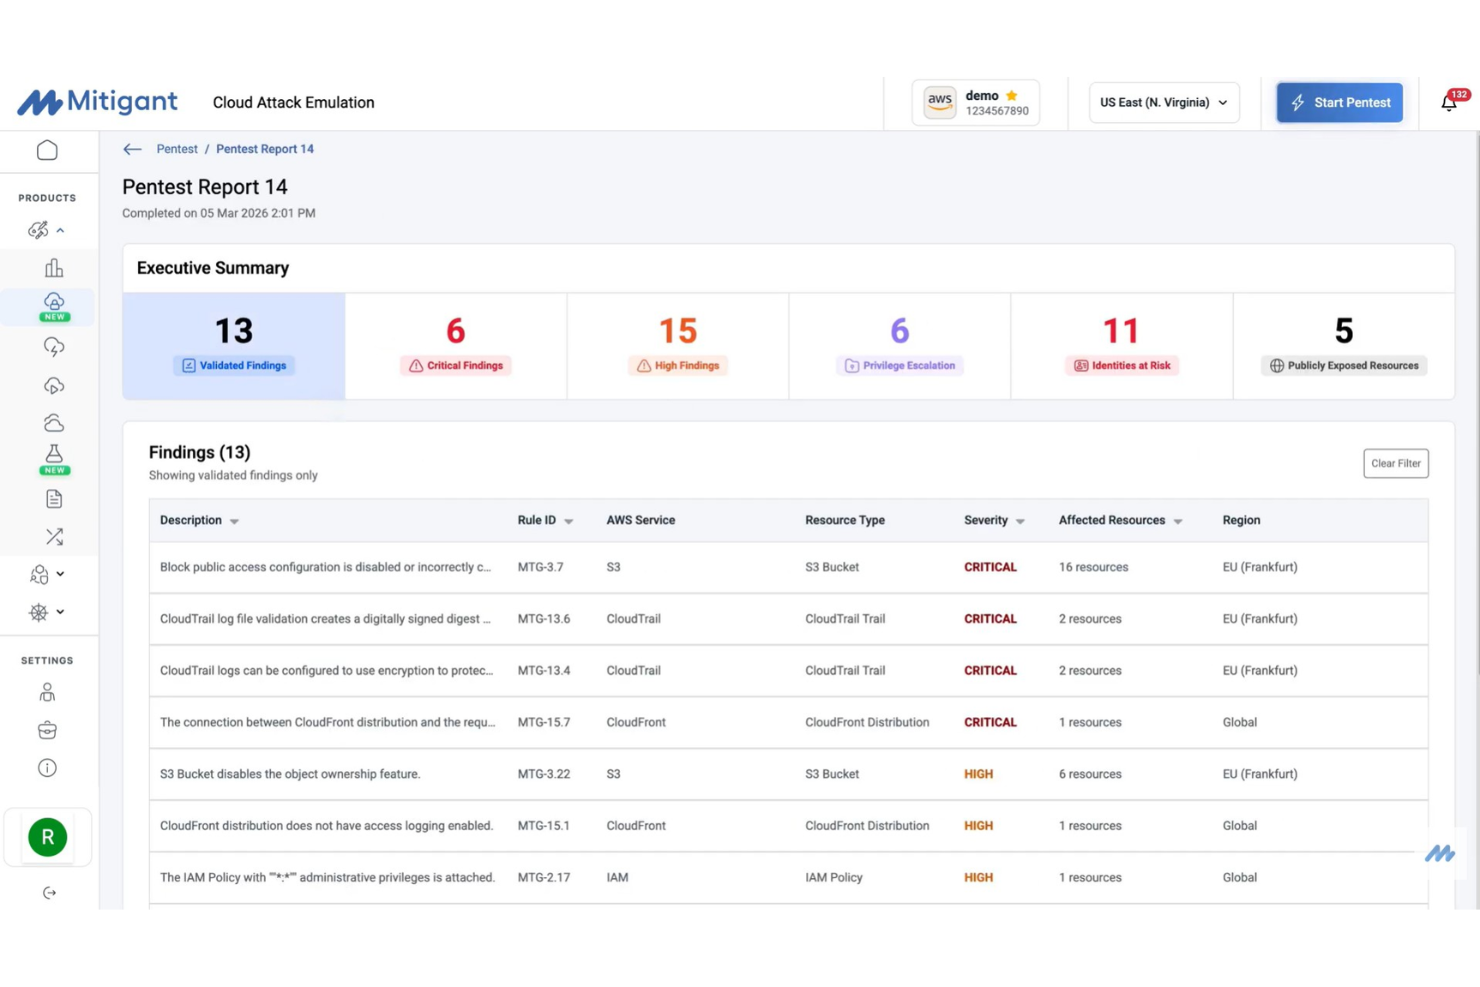
Mitigant är en plattform för kaosteknik inom molnsäkerhet som kombinerar validering av motståndares exponering, attackemulering i AWS, Azure och GCP, miljöskanning efter felkonfigurationer samt kontinuerlig efterlevnadsövervakning i Kubernetes- och multicloudmiljöer.
Vem passar Mitigant bäst för?
Mitigant passar bra för molnsäkerhets- och SRE-team i medelstora till stora organisationer som behöver validera säkerhetsstatus och motståndskraft i multicloudmiljöer samtidigt.
Varför jag valde Mitigant
Jag valde Mitigant som ett av de bästa alternativen eftersom miljöskanningen går längre än passiv identifiering. Plattformen kör aktivt över 500 förbyggda angreppsscenarier som är kopplade till MITRE ATT&CK i AWS, Azure och GCP för att visa vad som faktiskt kan utnyttjas, inte bara vad som är felkonfigurerat. Jag uppskattar också att analysen av säkerhetsstatus med hjälp av AI översätter attackresultat till prioriterade åtgärdssteg, inklusive de specifika Sigma-detekteringsregler som ditt SIEM behöver för att upptäcka varje teknik framöver.
Viktiga funktioner i Mitigant
- Attackbyggare: Skapa och kör anpassade angreppsscenarier med Mitigants Cloud Attack Language för att gå längre än förbyggda experiment och testa hotvägar som är specifika för miljön.
- Validering av detektering: Kör kontrollerade attacker för att bekräfta om ditt SIEM, CDR och molnets detekteringsmekanismer faktiskt upptäcker varje teknik innan en verklig angripare gör det.
- Kontinuerlig efterlevnadsövervakning: Skanna moln- och Kubernetesmiljöer mot CIS Benchmarks, NIS2, DORA, PCI-DSS, SOC 2 och andra ramverk med kontinuerlig spårning av avvikelser.
- AI-baserat red teaming: Testa AI-arbetsbelastningar som körs i molnmiljöer mot sofistikerade motståndartaktiker som är kopplade till MITRE ATLAS.
Integrationer med Mitigant
Mitigant integreras med AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, Wiz, Prowler, Slack, Microsoft Teams, Jira och DefectDojo för att skicka resultat till befintliga arbetsflöden. Ytterligare stöd för miljöer omfattar Alibaba Cloud, OpenShift, Docker, Hetzner, Exoscale, Open Telekom Cloud, SysEleven, Quay och Minikube. Ett API är tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- MITRE ATT&CK-kopplade attacker i multicloudmiljöer
- Säkra produktionsexperiment med automatisk återställning
- Inbyggd efterlevnadsövervakning för flera ramverk
Cons:
- Fokus enbart på moln utesluter lokal infrastruktur
- Mindre community jämfört med alternativ med öppen källkod

Gremlin
Bäst för precis felinjektering i stor skala
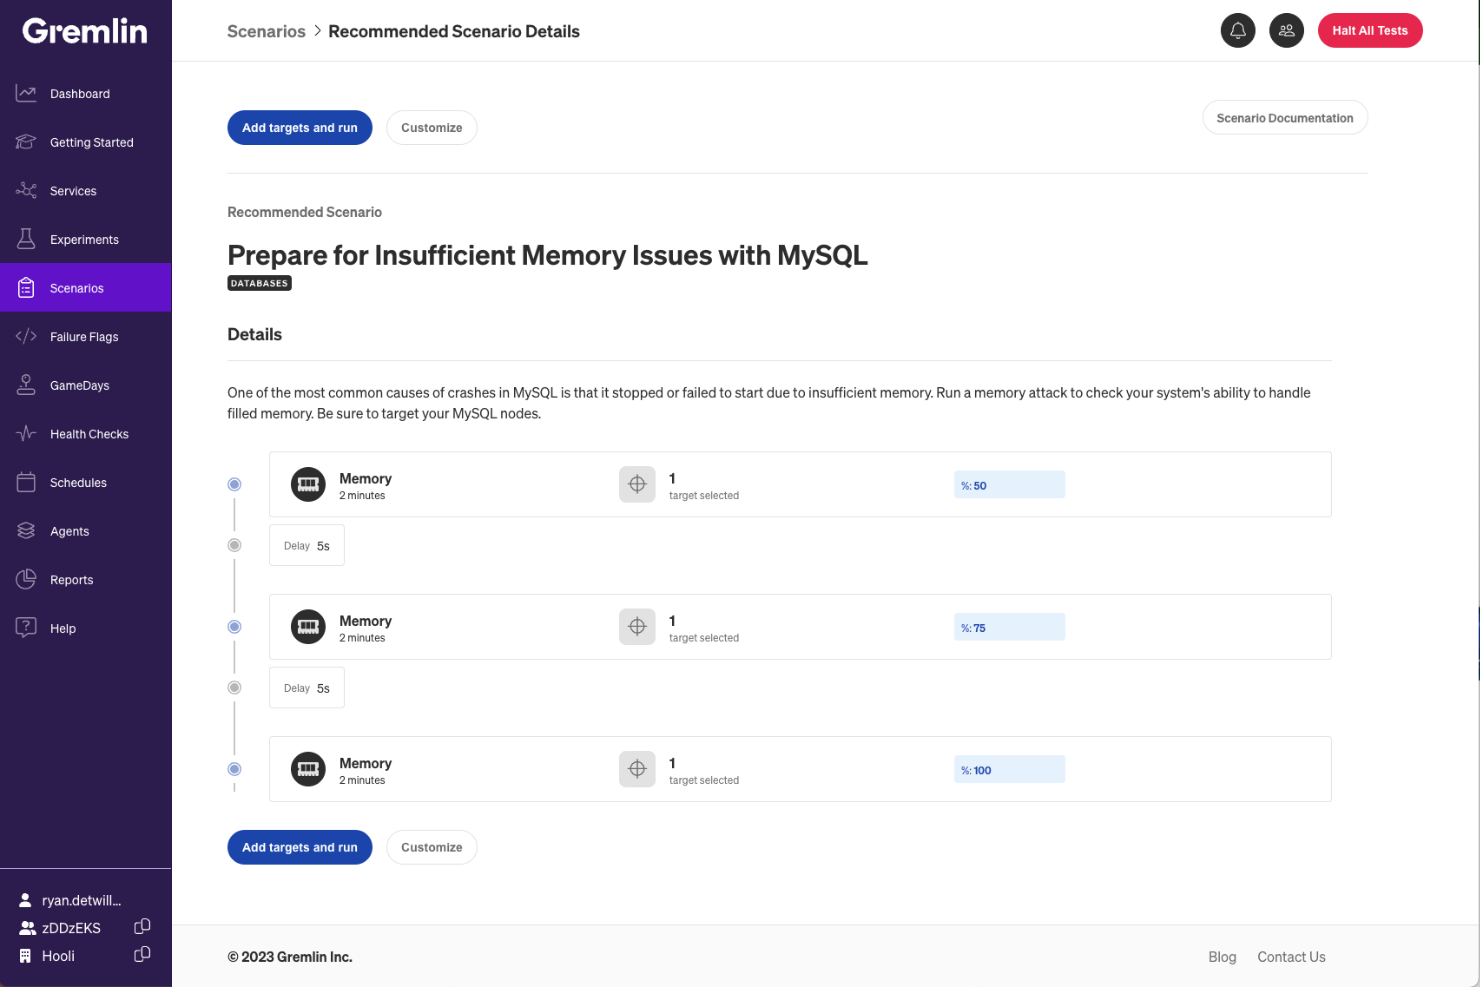
Gremlin är en plattform för företags tillförlitlighet som kombinerar felinjektering, kaosteknik, identifiering av beroenden och testning av katastrofåterställning för att ge ditt team en framåtblickande bild av systemets motståndskraft.
Vem passar Gremlin bäst för?
Gremlin passar bra för tekniska företags- och SRE-team som hanterar storskaliga, distribuerade system där oplanerade driftstopp medför betydande operativa risker.
Varför jag valde Gremlin
Jag har tagit med Gremlin bland mina toppval eftersom dess funktioner för felinjektering går långt utöver grundläggande kaostestning. Jag gillar hur hanteringen av påverkansområdet och stoppvillkoren gör att jag kan köra riktade experiment i levande produktionsmiljöer utan att riskera ett verkligt driftstopp. Funktionen för identifiering av beroenden kartlägger automatiskt dolda tjänsteberoenden, så att jag kan testa felvägar som jag inte ens visste fanns. Lagret för tillförlitlighetspoäng knyter sedan ihop allt genom att omvandla resultaten från enskilda felinjekteringar till mätbara och spårbara data för varje tjänst i en stor miljö.
Gremlins viktigaste funktioner
- Felindikatorer: Testa motståndskraften hos programkod och serverlösa funktioner genom att injicera fel direkt på funktionsnivå.
- Hantering av övningsdagar: Planera och genomför samordnade tillförlitlighetsevenemang för team med gemensam rapportering och strukturerade arbetsflöden för experiment.
- Identifierade risker: Övervaka kontinuerligt tjänster efter kända tillförlitlighetsrisker och uppmärksamma dem innan de utlöser en incident.
- Förbyggda tillförlitlighetstester: Kör standardiserade, färdiga testscenarier för att identifiera vanliga tillgänglighetsbrister utan att behöva bygga experiment från grunden.
Gremlins integrationer
Gremlin erbjuder inbyggda integrationer med Kubernetes, AWS, Azure och Google Cloud, Datadog, New Relic, Prometheus och Grafana, PagerDuty och Slack, ansluter till Jenkins för CI/CD-pipelines och har stöd för Jira och Grafana Cloud K6 för belastningstestning. Ett API och anpassade webhooks finns tillgängliga för ytterligare integrationer.
Pros and Cons
Pros:
- Ett stort urval av typer av felinjektionsattacker
- Kontrollerat påverkansområde isolerar specifika mål
- Minimal installation med omfattande dokumentation
Cons:
- Begränsat stöd för lokal felinjektering
- Ingen version med öppen källkod tillgänglig

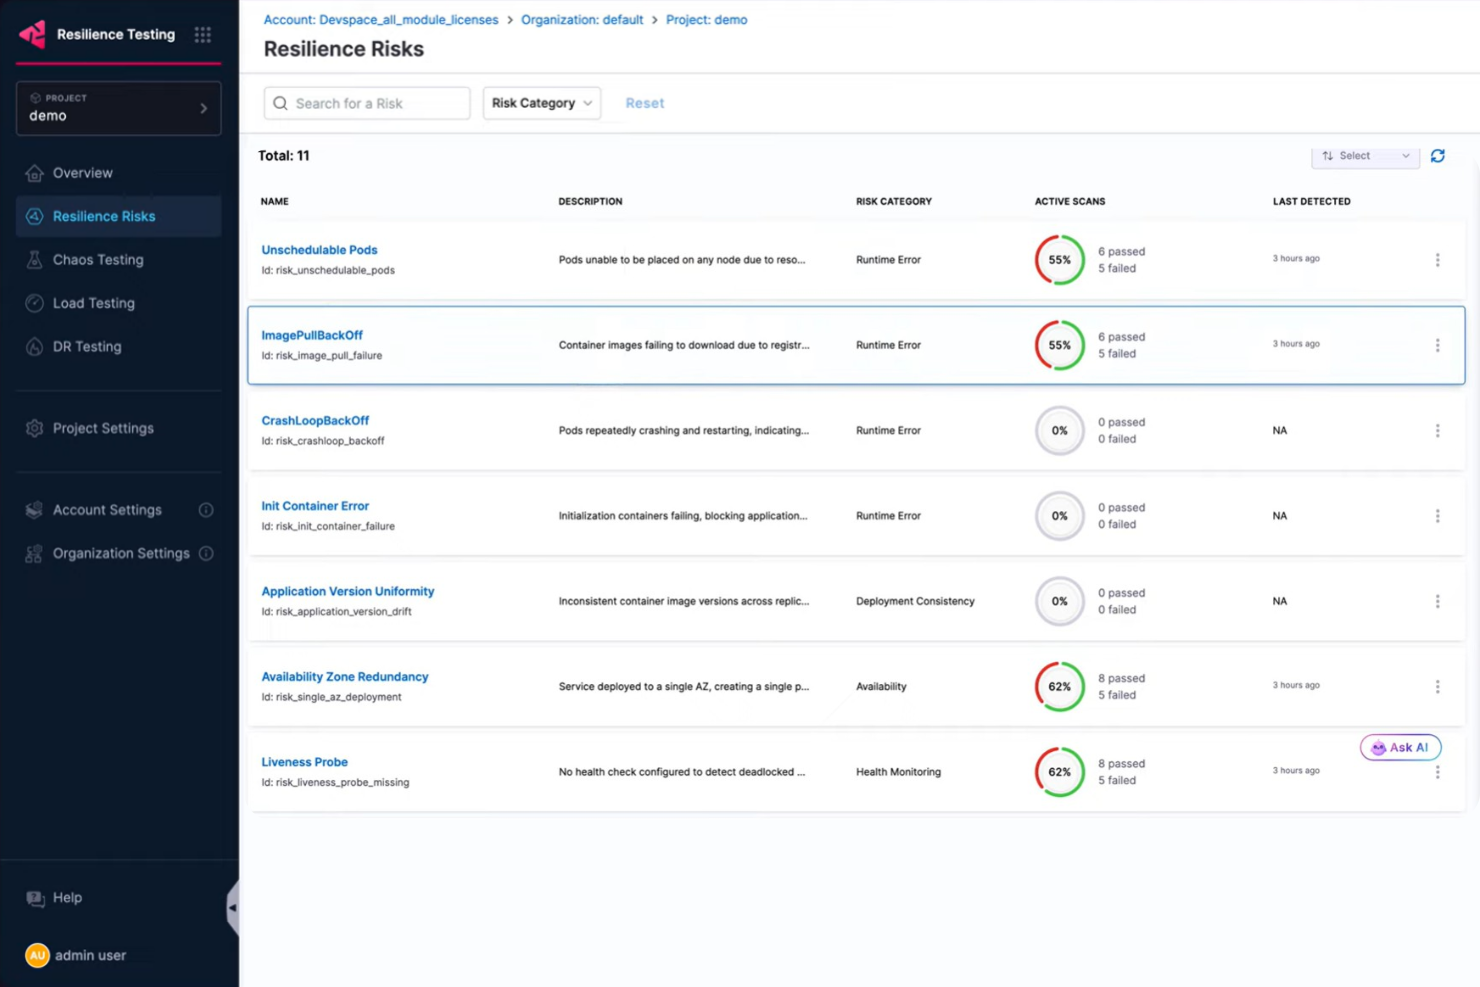
Harness plattform för resiliens testning kombinerar kaos-, belastnings- och katastrofåterställningstestning i en och samma svit, med automatiserad felinjektering, kartläggning av applikationsberoenden och integration med CI/CD-pipelines.
Vem passar Harness.io bäst för?
Harness plattform för resiliens testning passar bra för QA-ingenjörer, prestandaingenjörer och SRE:er på medelstora till stora företag som behöver hantera kaos-, belastnings- och katastrofåterställningstestning inom en enda plattform, tillsammans med sina befintliga CI/CD-arbetsflöden.
Varför jag valde Harness.io
Jag har inkluderat Harness.io bland mina toppval eftersom verktyget samlar kaos-, belastnings- och DR-testning under samma tak på ett sätt som jag inte har sett andra verktyg matcha. Det jag uppskattar mest är den automatiserade pipeline-integrationen: kaostester utlöses före och efter varje driftsättning, vilket validerar beredskapen för återställning utan någon manuell konfigurering. Jag förlitar mig också på kartläggningen av applikationsberoenden, som automatiskt synliggör mikrotjänster, API:er och luckor i infrastrukturen, så att jag vet exakt var täckningen för resiliens är bristfällig innan jag kör ett enda experiment.
Viktiga funktioner i Harness.io
- ChaosGuard: Ett lager för policytillämpning som definierar skyddsräcken för att blockera obehöriga eller högriskartade felinjekteringar innan experiment körs.
- Spårning av resilienspoäng: Beräknar automatiskt en kvantitativ resilienspoäng för varje tjänst baserat på experimentresultat över tid.
- Kaosnav: Ett bibliotek med färdigbyggda felscenarier organiserade efter infrastrukturtyp för snabbare skapande av experiment.
- Schemaläggning av speldagar: Gör det möjligt att planera, schemalägga och genomföra strukturerade resiliensövningar mellan team med definierad omfattning och arbetsflöden för godkännande.
Integrationer med Harness.io
Harness plattform för resiliens testning integreras med Prometheus, Grafana, Dynatrace och Keptn och stöder automatisering av CI/CD-pipelines via Jenkins, GitHub Actions, GitLab och Harness CI/CD. Plattformen erbjuder även ett API för anpassade integrationer.
Pros and Cons
Pros:
- Kombinerar kaos-, belastnings- och katastrofåterställningstestning
- Bygger på projektet LitmusChaos med öppen källkod
- Stöder felinjekteringsmål i flera moln
Cons:
- Plattformen är komplex för fristående kaosbehov
- Otydlig prissättning kräver konsultation med leverantören

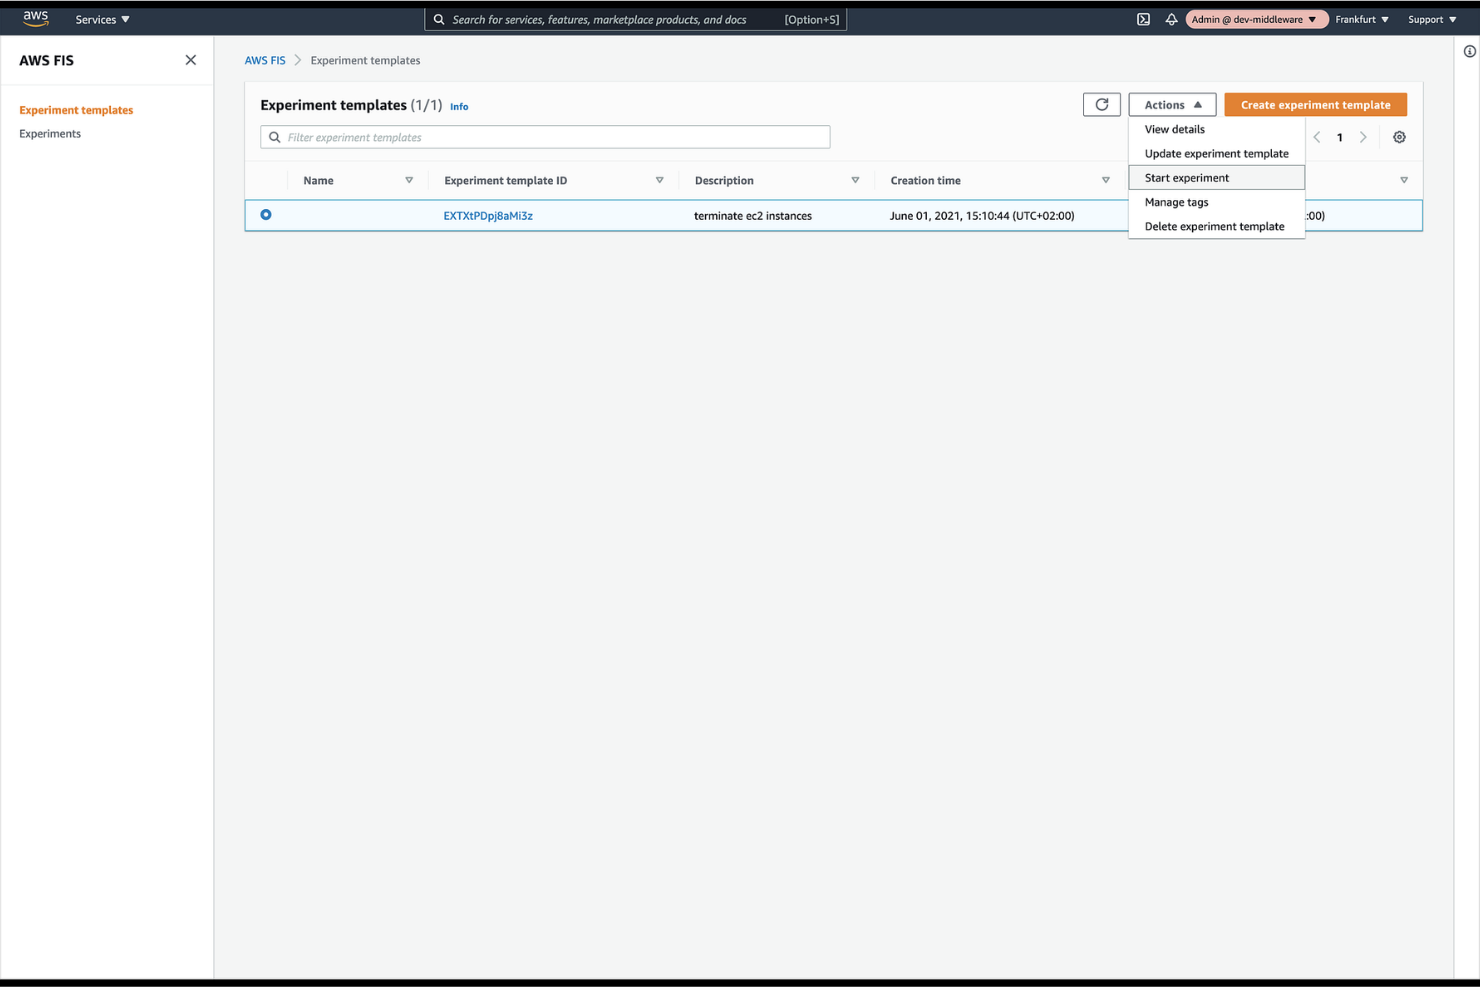
AWS-tjänsten för felinjektering (FIS) är en hanterad tjänst för kaosteknik som kör kontrollerade felinjekteringsexperiment direkt mot AWS-infrastruktur, tjänster och arbetsbelastningar.
Vem passar AWS-tjänsten för felinjektering bäst för?
AWS FIS passar SRE:er och plattformsingenjörer i organisationer som kör produktionsarbetsbelastningar på AWS och behöver integrerade kaosexperiment.
Viktiga funktioner
- Mål i flera konton och regioner
- Experimentloggning till CloudWatch Logs eller Amazon S3
- Mål baserade på resurstaggar
- Parallell och sekventiell körning av åtgärder
Integrationer
AWS FIS har inbyggda felinjekteringsåtgärder för bland annat Amazon EC2, ECS, EKS, RDS, S3, DynamoDB och AWS Lambda. AWS CLI, SDK:er och ett HTTPS-API stöder automatisering.
Pros and Cons
Pros:
- Agentfri konfiguration av AWS-resurser
- Förbyggt scenariobibliotek för fel i tillgänglighetszoner
- Finjusterade IAM-åtkomstkontroller för experiment
Cons:
- Begränsad till infrastrukturmål som endast finns i AWS
- Ingen inbyggd felinjektering på applikationsnivå

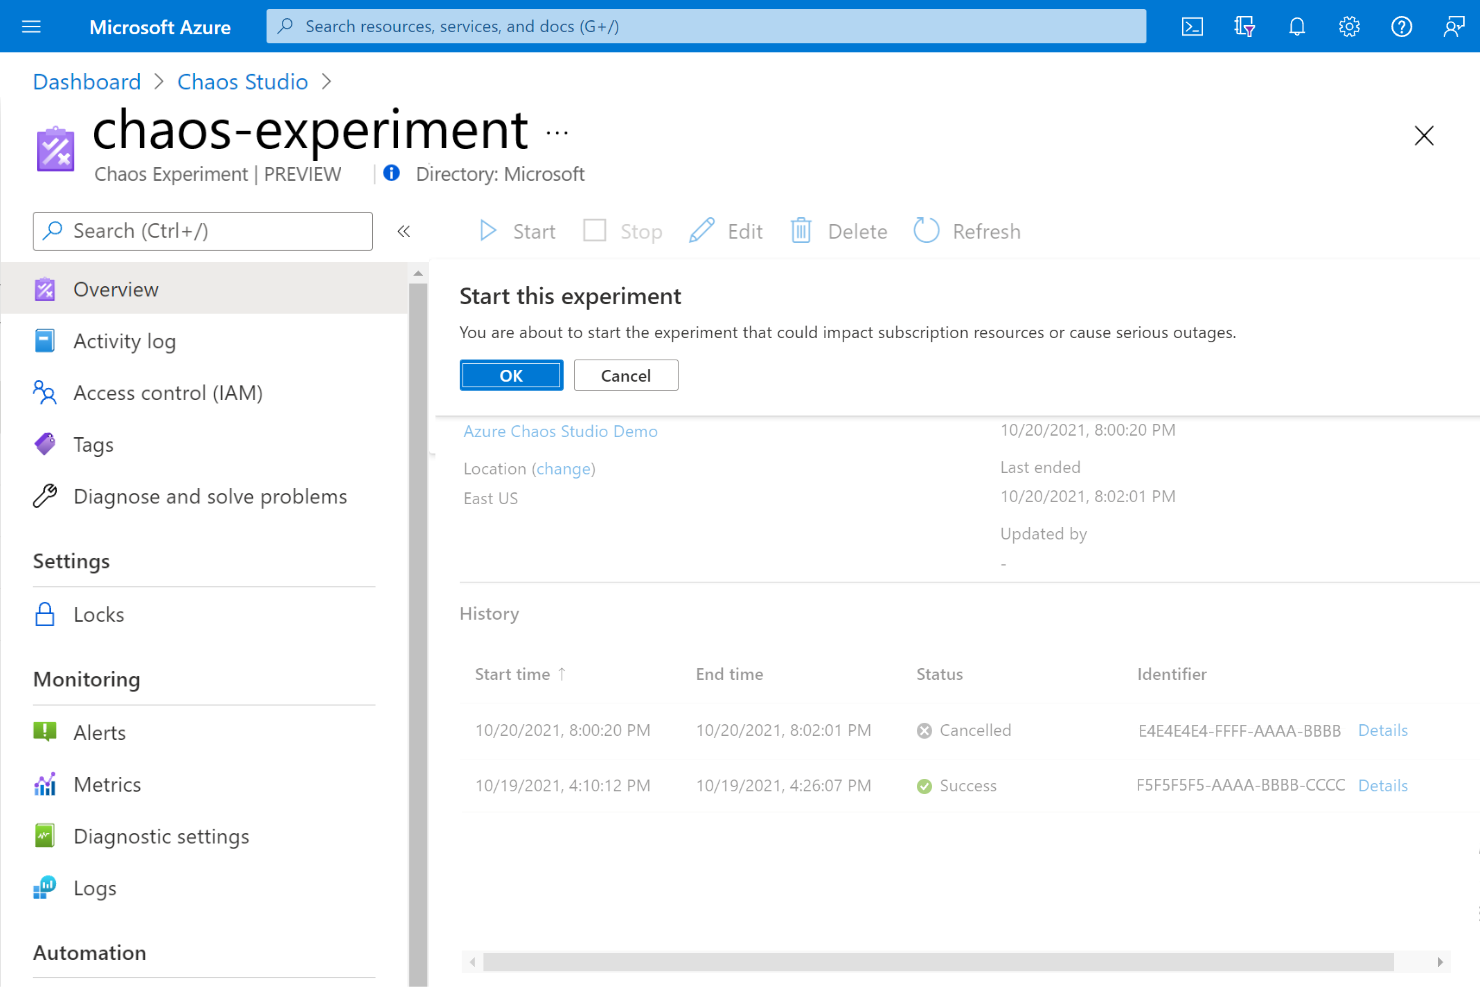
Azure Chaos Studio är Microsofts hanterade tjänst för kaosteknik som låter dig utforma, köra och analysera felinjekteringsexperiment mot Azure-resurser, tjänster och applikationer.
Vem passar Azure Chaos Studio bäst för?
Azure Chaos Studio passar naturligt för plattformsingenjörer och SRE:er i organisationer som kör produktionsarbetsbelastningar på Azure och behöver inbyggd felinjektering utan att hantera externa verktyg.
Varför jag valde Azure Chaos Studio
Jag valde Azure Chaos Studio eftersom tjänsten kör direkta fel mot Azure-resurser utan att kräva en agent på varje mål, vilket innebär att jag kan injicera fel i Azure Cosmos DB, Azure Kubernetes Service eller Azure App Service direkt via Azure Resource Manager. Jag uppskattar också experimentdesignern, där jag visuellt kan skapa förgrenade felsekvenser i flera steg och koppla Azure Monitor-stopplägen för att automatiskt avbryta experiment. Tillsammans gör dessa två saker kontrollerade och repeterbara kaosexperiment mycket enklare att hantera i en befintlig Azure-miljö.
Viktiga funktioner i Azure Chaos Studio
- Felinjektionsbibliotek: Få åtkomst till en förbyggd samling agentbaserade och tjänstedirekta fel som omfattar nätverk, CPU, minne, disk och tjänstespecifika feltyper.
- Modell för kaosmål och funktioner: Registrera specifika Azure-resurser som kaosmål och aktivera endast de felfunktioner du vill använda, vilket begränsar experimentets omfattning på resursnivå.
- Stöd för ARM-mallar: Definiera och distribuera experiment som Azure Resource Manager-mallar för versionshanterad och repeterbar experimentkonfiguration.
- Integration med Azure DevOps-pipelines: Utlös kaosexperiment direkt i CI/CD-pipelines för att testa applikationers motståndskraft som en del av automatiserade lanseringsarbetsflöden.
Integrationer med Azure Chaos Studio
Azure Chaos Studio fungerar integrerat i Azure-ekosystemet, med inbyggt stöd för felinjektering i Azure Virtual Machines, Virtual Machine Scale Sets, Azure Kubernetes Service (AKS), Azure Cosmos DB, Azure App Service, Azure Key Vault och mycket mer. Ett Azure REST API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Förbyggt scenariobibliotek för vanliga avbrott
- Betalning per användning baserad på åtgärdsminut
- AI-insticksprogram för konversationsbaserad experimentkonfiguration
Cons:
- Riktar sig endast mot Azure-värdbaserade resurser
- Ingen dedikerad Java-SDK finns tillgänglig

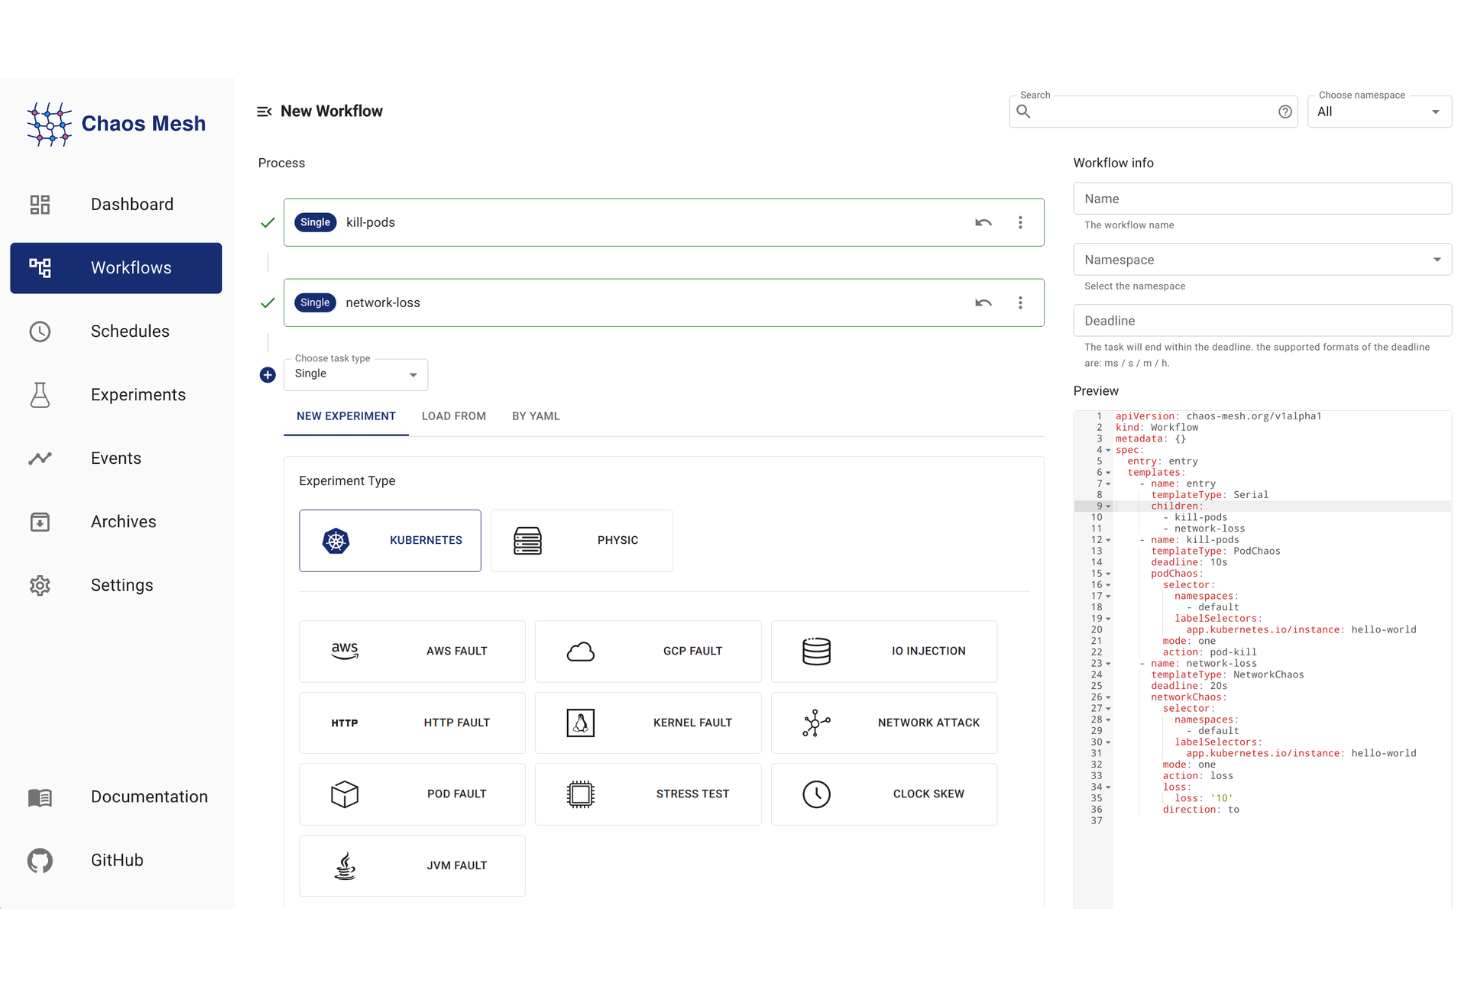
Chaos Mesh är en Kubernetes-infödd plattform för kaosteknik med öppen källkod som använder CustomResourceDefinitions (CRD:er) för att direkt injicera poddfel, nätverksfördröjningar, belastningstillstånd och filsystemfel i Kubernetes-kluster.
Vem passar Chaos Mesh bäst för?
Chaos Mesh passar bra för plattformsingenjörer och SRE:er som kör Kubernetes-arbetsbelastningar och vill ha CRD-styrd felinjektering utan kommersiella licenskostnader.
Varför jag valde Chaos Mesh
Chaos Mesh finns med på min kortlista eftersom allt definieras som en inbyggd Kubernetes-resurs med hjälp av CRD:er, så jag kan skriva ett NetworkChaos- eller PodChaos-manifest på samma sätt som jag skulle skriva vilket annat Kubernetes-objekt som helst. Jag uppskattar att målval baserat på väljare låter mig begränsa experiment till specifika namnrymder, etiketter eller anteckningar, vilket håller felens spridningsområde förutsägbart. Den inbyggda arbetsflödesmotorn låter mig dessutom kedja samman seriella och parallella felsteg, så att jag kan modellera realistiska scenarier med flera fel i stället för enstaka isolerade fel.
Viktiga funktioner i Chaos Mesh
- Chaos Dashboard: Ett webbaserat gränssnitt för att utforma, köra och övervaka kaosexperiment utan att behöva skriva YAML direkt.
- HTTPChaos: Injicerar fel i flöden för HTTP-förfrågningar och -svar, inklusive fördröjningar, avbrott samt ändringar av rubriker och innehåll.
- JVMChaos: Riktar sig mot JVM-baserade applikationer för att simulera undantag, latens och manipulering av returvärden på metodnivå.
- RBAC-baserad behörighetsmodell: Styr vem som kan skapa eller utlösa experiment inom specifika namnrymder med hjälp av Kubernetes-infödda rollbindningar.
Integrationer i Chaos Mesh
Chaos Mesh integreras med pipelinesystem som Argo, Jenkins, GitHub Action och Spanner. Det har även ett särskilt datakällsplugin för Grafana och fungerar inbyggt med Prometheus för insamling av experimentmätvärden. Ett REST-API finns tillgängligt för anpassade integrationer och automatisering av CI/CD-pipelines.
Pros and Cons
Pros:
- Inkluderar TimeChaos för injicering av klockskevning
- CRD-experiment passar versionshantering med GitOps
- CNCF-projekt i inkubation med aktiv styrning
Cons:
- Saknar stöd för hantering av flera kluster
- Felininjektering på fysisk hårdvara är begränsad
Andra verktyg för kaosteknik
Här är några ytterligare verktyg för kaosteknik som inte kom med på min kortlista, men som ändå är värda att undersöka:
- LitmusChaos
Bäst för molnbaserade experiment med öppen källkod
- Tricentis
Bäst för automatisering av kvalitetsarbete
- Chaoskube
Bäst för slumpmässiga avslut av Kubernetes-poddar


How I Evaluate Chaos Engineering Tools
I evaluate chaos engineering tools across two layers: baseline criteria like fault injection coverage and blast radius control, and differentiators like GameDay orchestration and SLO-aware safeguards.
Core Functionality (Table Stakes for This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. Then, I calculate the tool's total score as a percentage. Each tool needs to achieve a minimum total score of 65% to be considered for inclusion.
- Fault injection library: I look for a broad set of pre-built failure scenarios covering compute, network, and application layers. A tool that only offers pod kills but can't simulate DNS failures or memory pressure leaves too many blind spots untested.
- Blast radius control: Scoping matters. I evaluate whether a tool lets you target experiments by service, region, tag, or traffic percentage so you can safely test a single availability zone without risking an entire cluster.
- Experiment orchestration: The ability to chain faults into multi-step workflows with steady-state hypotheses and rollback conditions is what separates a real experiment from just breaking things. I check for scheduling and CI/CD pipeline support too.
- Cloud and Kubernetes targeting: I consider how well each tool covers major cloud providers and container orchestrators. Tools like Gremlin and Litmus approach this differently, but both should let you target resources across multi-cloud and Kubernetes environments.
- Automated safeguards: Health-check-driven abort conditions are what I look for here. If a chaos experiment degrades response times past a defined threshold, the tool should automatically halt and roll back without waiting for a human to intervene.
- Observability integration: Correlating experiment timelines with live metrics is how you validate hypotheses. I check for connections to monitoring platforms so you can see exactly how system behavior shifts during each fault injection.
Once I have a list of tools that meet this criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
GameDay orchestration is a big differentiator. Tools that let you chain faults into multi-step scenarios—like simulating a region failover during peak traffic—reveal resilience gaps that single-fault tests miss. I also evaluate multi-cloud and hybrid support, since most teams run workloads across providers and need one control plane to target all of them. Automated safety guardrails tied to SLOs round this out by giving teams confidence to run experiments in production.
Beyond Features
Deployment model matters more than people expect. Agent-based tools add overhead to production workloads, while agentless options trade off depth of fault injection. I evaluate which approach fits the team's risk tolerance. Security and governance are equally important—RBAC, SSO, and audit logging determine whether you can actually run experiments in regulated environments without a lengthy change advisory board review. Team maturity also shapes the right pick. Smaller SRE teams often get more value from open-source projects with strong community support, while larger orgs need managed SaaS with dedicated onboarding and GameDay facilitation.
Så väljer du verktyg för kaosteknik
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för programvaruval kommer här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| Skalbarhet | Kan verktyget hantera tillväxt när dina system och experimentvolymer utökas över flera moln? |
| Integrationer | Ansluter verktyget direkt till din övervakning, CI/CD och plattform för incidenthantering? |
| Anpassningsmöjligheter | Kan du anpassa kaosexperiment efter din unika arkitektur, inklusive anpassade feltyper? |
| Användarvänlighet | Kan dina SRE- eller DevOps-team snabbt komma igång, eller finns det en brant inlärningskurva och lång installationstid? |
| Implementering och introduktion | Vilka interna kompetenser och resurser krävs för att distribuera och underhålla plattformen? |
| Kostnad | Är prismodellerna transparenta och ligger investeringen i linje med dina förväntade användningsscenarier? |
| Säkerhetsåtgärder | Erbjuder verktyget RBAC, SSO och revisionsspår för att uppfylla organisationens säkerhetsstandarder? |
| Supporttillgänglighet | Finns det tillgänglig, kunnig leverantörssupport vid behov av felsökning eller spelövningar? |
Vad är verktyg för kaosteknik?
Verktyg för kaosteknik är specialiserade plattformar eller verktyg som låter dig simulera fel i produktions- eller testmiljöer för att upptäcka svagheter i systemen. Dessa verktyg hjälper team att proaktivt införa fel, övervaka påverkan och validera strategier för motståndskraft – särskilt i komplexa, distribuerade molnbaserade arkitekturer. Genom att köra kontrollerade experiment kan teknik- och driftteam identifiera brister i redundans, redundansväxling och incidenthantering innan verkliga avbrott inträffar.
Funktioner
När du väljer verktyg för kaosteknik bör du hålla utkik efter följande viktiga funktioner:
- Bibliotek för felinjektering: Erbjuder en rad förbyggda scenarier för simulering av fel som CPU-toppar, nätverksfördröjning eller processavslut för att testa systemets motståndskraft.
- Kontroll av påverkansområde: Gör det möjligt att begränsa experimentens omfattning efter värd, tjänst, region eller procentandel av trafiken för att minska risken under tester i drift.
- Experimentorkestrering: Möjliggör schemaläggning och automatisering av flerstegs kaosexperiment med definierade hypoteser, kontroller av stabilt tillstånd och logik för återställning.
- Mål för moln och Kubernetes: Tillhandahåller integrationsalternativ för att köra felinjekteringar i publika moln, containerorkestrerare och hybrida miljöer.
- Automatiserade skyddsåtgärder: Övervakar hälsa och systemmätvärden under experiment och återställer eller avbryter tester om tröskelvärden överskrids eller påverkan blir alltför omfattande.
- Integrationer för observerbarhet: Ansluter till verktyg för övervakning och APM så att du kan korrelera experimenthändelser med prestandadata och systemhälsa.
- Skapande av anpassade experiment: Gör det möjligt att utforma och skripta unika felinjekteringar som går utöver standardiserade felscenarier för att passa din specifika arbetsbelastning eller arkitektur.
- Rollbaserad åtkomstkontroll: Erbjuder detaljerade behörigheter och granskningsspår för att hantera vem som kan köra, ändra eller visa kaosexperiment i produktion.
- Experimentmallar: Tillhandahåller färdiga upplägg för vanliga testscenarier så att team snabbt kan starta nya experiment utan att börja från grunden.
Lösningar med verktyg för kaosteknik inkluderar vanligtvis inte AI som en del av sitt funktionserbjudande.
Fördelar
Att implementera verktyg för kaosteknik ger flera fördelar för ditt team och din verksamhet. Här är några som du kan se fram emot:
- Validering av motståndskraft: Simulera verkliga fel och bekräfta att dina system kan absorbera störningar utan större driftavbrott.
- Snabbare incidenthantering: Öva på och mät arbetsflöden för hantering, vilket minskar den genomsnittliga återställningstiden (MTTR) genom kontrollerade experiment och övningsdagsscenarier.
- Proaktiv upptäckt av risker: Upptäck okända svagheter innan de påverkar produktionen genom att injicera fel på ett säkert och repeterbart sätt.
- Kontinuerlig förbättring: Integrera med CI/CD-processer för löpande tester av motståndskraft och upptäckt av regressioner under varje distributionscykel.
- Säkra förändringar i produktion: Använd automatiserade skyddsåtgärder och kontroll av påverkansområdet för att experimentera säkert och bygga förtroende för förändringar i infrastrukturen.
- Insyn för intressenter: Korrelera fel med övervakningsdata, vilket gör det enklare att dela lärdomar och kommunicera tillförlitlighetsläget med tekniska team och verksamhetsteam.
- Beredskap för efterlevnad: Uppfyll krav på tester av motståndskraft och granskning med plattformsfunktioner som RBAC, granskningsloggning och policybaserade godkännanden av experiment.
Kostnader och priser
Vid valet av verktyg för kaosteknik krävs en förståelse för de olika prismodeller och planer som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga planer, deras genomsnittliga priser och typiska funktioner som ingår i lösningar för kaosteknik:
Jämförelsetabell för planer för verktyg för kaosteknik
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisplan | $0 | Grundläggande felinjektering, begränsat antal experimentmallar, åtkomst för en användare och communitysupport. |
| Personlig plan | $10-$50/användare/månad | Utökat felförråd, grundläggande integrationer, schemaläggningsfunktioner och e-postsupport. |
| Företagsplan | $50-$150/användare/månad | Hantering av flera användare, avancerad orkestrering, granskningsloggar, integrationer för observerbarhet och RBAC. |
| Stor företagsplan | $150+/användare/månad | Anpassade SLA:er, lokal distribution, SSO/SAML, detaljerade behörigheter, funktioner för efterlevnad och prioriterad support. |
Vanliga frågor om verktyg för kaosteknik
Här är några svar på vanliga frågor om verktyg för kaosteknik:
Fungerar verktyg för kaosteknik i produktionsmiljöer?
Ja, de flesta verktyg för kaosteknik är utformade för säker användning i produktion. De erbjuder kontroller som avgränsning av påverkansområde, stoppvillkor och automatiska återställningar för att minimera risken vid aktiv felinjektering.
Hur vet jag om mitt team är redo att använda verktyg för kaosteknik?
Om ditt team redan övervakar systemets hälsa, har tydliga processer för incidenthantering och känner sig bekvämt med att automatisera tester eller experiment är ni sannolikt redo att börja använda verktyg för kaosteknik. Team som är nya inom tillförlitlighetsarbete kan vilja börja i en testmiljö innan de går över till produktion.
Kräver dessa verktyg kodändringar i mina applikationer?
Nej, de flesta verktyg injicerar fel på infrastruktur- eller plattformsnivå utan att du behöver ändra applikationskoden. Anpassad experimentkörning eller detaljerad målgruppsanpassning av arbetsbelastningar kan dock kräva minimal konfiguration.
Vad är skillnaden mellan agentbaserad och agentlös distribution?
Agentbaserade verktyg installerar lätta agenter på dina arbetsbelastningar för att möjliggöra ett bredare utbud av felinjekteringar. Agentlösa metoder minskar den operativa belastningen, men kan ha begränsad täckning av fel eller kräva ytterligare behörigheter.
Kan verktyg för kaosteknik hjälpa till med efterlevnadskrav?
Ja, avancerade verktyg för kaosteknik omfattar ofta granskningsloggar, rollbaserade åtkomstkontroller och funktioner för policyhantering som stöd för efterlevnad och styrning i reglerade miljöer.
Hur svårt är det att integrera verktyg för kaosteknik i CI/CD-pipelines?
De flesta moderna verktyg för kaosteknik erbjuder färdiga insticksprogram eller API:er för integrering med Jenkins, GitHub Actions och andra CI/CD-plattformar, vilket gör automatiserade motståndskraftskontroller till en del av ert distributionsarbetsflöde.