

10 bästa verktygen för generering av syntetiska data 2026

Bästa verktygen för generering av syntetiska data – kortlista


Verktyg för generering av syntetiska data skapar realistiska, artificiella datamängder för testning, analys och utveckling av AI-modeller när det inte är möjligt eller säkert att använda verkliga data. Om du söker efter sådana verktyg hanterar du förmodligen känslig information, integritetsbestämmelser eller begränsad datatillgång. Rätt plattform för syntetiska data hjälper ditt team att hantera dessa utmaningar utan att utsätta era system, användare eller efterlevnad för risker. I den här guiden hittar du de bästa tillgängliga lösningarna för generering av syntetiska data samt viktig information som hjälper dig att välja rätt alternativ för dina projekt.
Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Sammanfattning av de bästa verktygen för generering av syntetiska data
Den här jämförelsetabellen sammanfattar prisuppgifter för mina främsta val av verktyg för generering av syntetiska data, så att du kan hitta det bästa alternativet för din budget och verksamhetens behov.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för automatisering av testdata på begäran | Gratis demo tillgänglig | Pris lämnas på begäran | Website | |
| 2 | Bäst för datakvalitet i träningsdata för AI-modeller | Gratisabonnemang + gratis demo tillgänglig | Från $1/kredit (betala efter användning) | Website | |
| 3 | Bäst för säker datatillhandahållning inom finanssektorn | Gratis demonstration tillgänglig | Prisuppgift på begäran | Website | |
| 4 | Bäst för att snabbt generera exempeldata | Gratisplan tillgänglig | Från $60 (faktureras årsvis) | Website | |
| 5 | Bäst för syntetisering av hälso- och sjukvårdsdata och insikter | Gratis demonstration tillgänglig | Pris på begäran | Website | |
| 6 | Bäst för att generera realistiska hälsojournaler | Inte tillgängligt | Gratis, öppen källkod | Website | |
| 7 | Bäst för API-drivna arbetsflöden för dataskapande | Gratis provperiod tillgänglig | Pris på begäran | Website | |
| 8 | Bäst för att generera varierande visuella träningsdata | Not available | Website | ||
| 9 | Bäst för kompatibla dataarbetsflöden med lite kod | Website | |||
| 10 | Bäst för dataanonymisering i forskningsmiljöer | Not available | Website |


Recensioner av de bästa verktygen för generering av syntetiska data
Nedan finns mina detaljerade sammanfattningar av de bästa verktygen för generering av syntetiska data som kom med på min kortlista. I mina recensioner får du en detaljerad genomgång av funktionerna, de bästa användningsområdena och funktionerna hos varje plattform, så att du kan hitta det bästa alternativet för dig.

Bäst för automatisering av testdata på begäran
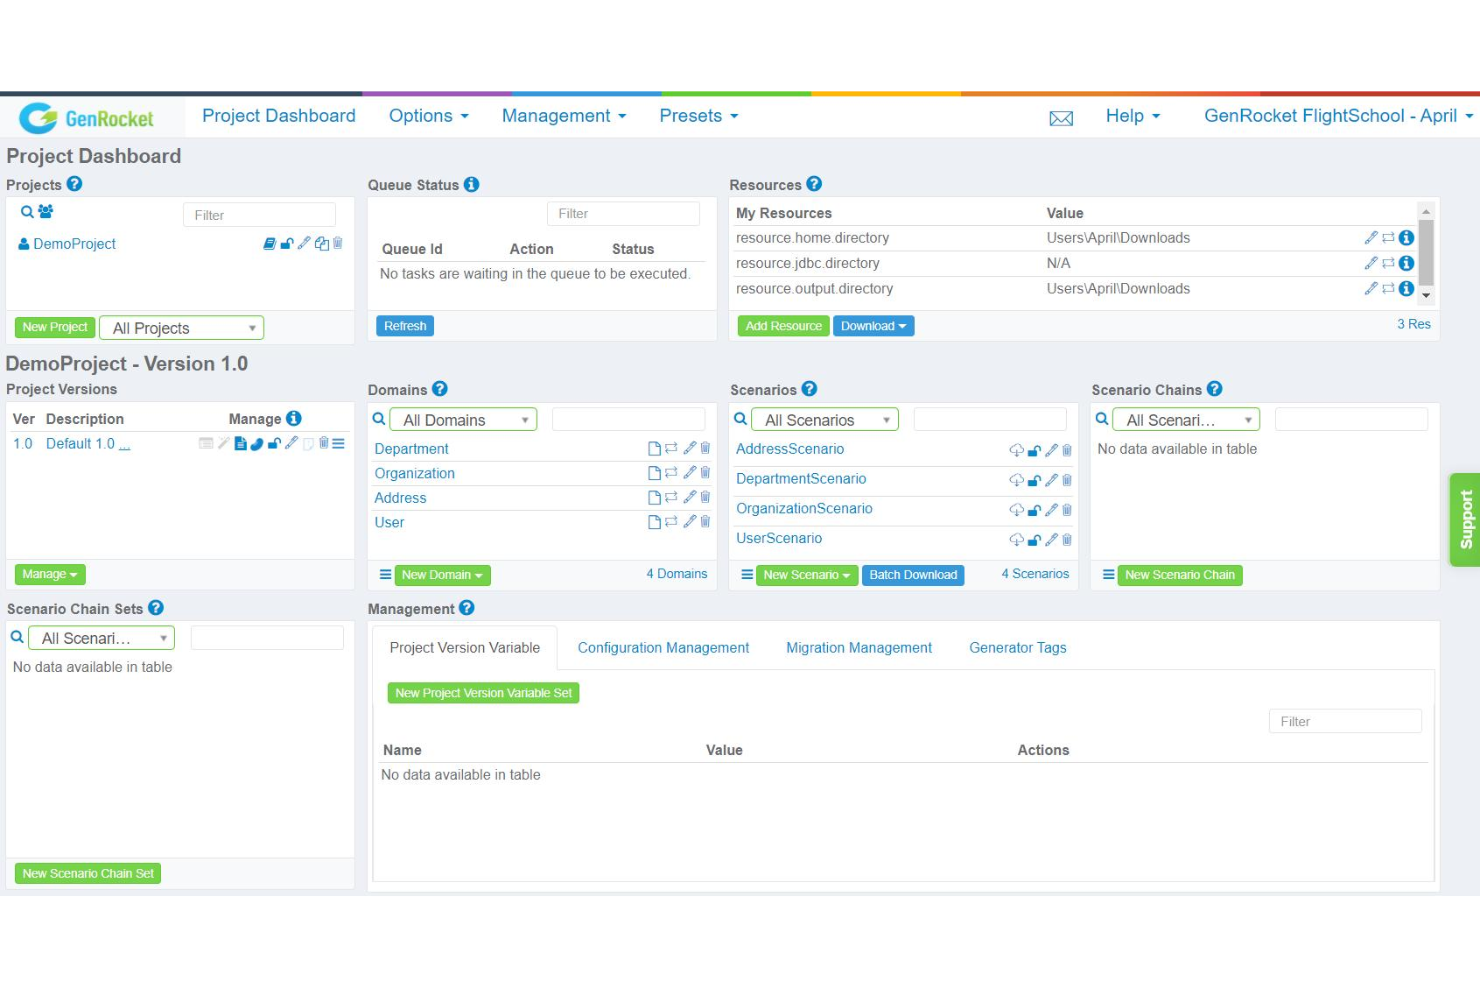
GenRocket är en designstyrd plattform för syntetiska data som genererar testdata på begäran utan att röra produktionssystem, med hjälp av över 750 datageneratorer i över 125 format för att stödja testautomatisering, datamaskering, dataurval och integrering med CI/CD-pipelines.
Vem passar GenRocket bäst för?
GenRocket passar bra för QA-ingenjörer och team för testautomatisering på medelstora till stora företag som behöver högvolymig, regelbaserad syntetisk testdata som genereras på begäran i komplexa programvarumiljöer.
Varför jag valde GenRocket
GenRocket finns med på min kortlista tack vare hur väl plattformen hanterar automatisering av testdata i stor skala. Jag uppskattar särskilt självbetjäningslagret G-Portal, som gör det möjligt för utvecklings- och testteam att begära och generera testdata utan att behöva vara GenRocket-experter. Tillsammans med den deterministiska modellen för datagenerering kan mitt team skapa referensintegritetsbevarade, scenariospecifika datauppsättningar på begäran under varje testkörning, i stället för att vänta på manuell etablering. Det är det som gör plattformen verkligt användbar i snabbföränderliga CI/CD-miljöer.
GenRockets viktigaste funktioner
- Dataurval: Välj ut data från sex populära SQL-databaser, däribland Oracle, DB2, MS SQL, MySQL, PostgreSQL och Sybase, med upp till 2,5 miljoner rader per minut.
- Maskering av data på plats: Ersätt känsliga PII-fält syntetiskt under dataurvalet, så att produktionsdata aldrig nås eller lagras.
- Dataorkestrering: Leverera urval och syntetiska datauppsättningar till en eller flera testmiljöer parallellt och på begäran.
- Pipelineintegrering: Anslut GenRocket direkt till CI/CD-pipelines och ramverk för testautomatisering för att automatisera etableringen av data i varje releasefas.
GenRocket-integreringar
GenRocket integreras med verktyg för CI/CD och testautomatisering, däribland Jenkins, Selenium, Cucumber, Tosca, TestComplete, UFT, JMeter och LoadRunner, och stöder COTS-plattformar som Salesforce, SAP, Workday, Guidewire och Oracle ERP. Plattformen fungerar även med Azure DevOps Test Runner och stöder containerdistribution baserad på Docker. Både REST- och Java-API:er finns tillgängliga för anpassade integreringar.
Pros and Cons
Pros:
- Genererar data i över 110 utdataformat
- Patenterad referensintegritet i alla datauppsättningar
- Innehåller acceleratorpaket för EDI inom hälso- och sjukvård
Cons:
- Den initiala konfigurationen kan förvirra användare
- Webbgränssnittet behöver vidareutvecklas


YData Fabric är en plattform för syntetiska data som kombinerar dataprofilering, utökning av datamängder och generering av syntetiska data, med kärnfunktionalitet inriktad på att producera och validera träningsklara datamängder för AI- och maskininlärningspipelines.
Vem passar YData bäst för?
YData Fabric passar bra för datavetare och ML-ingenjörer som behöver granska, korrigera och generera träningsdata innan de matar in dem i AI-modeller.
Varför jag valde YData
Jag har tagit med YData Fabric bland mina främsta val eftersom dess datapipeline för datakvalitet går längre än generering. Den kör först automatisk dataprofilering som identifierar obalanser, saknade värden och statistiska avvikelser i en datamängd innan någon syntes genomförs. Det är viktigt eftersom träning av en AI-modell på bristfälliga data leder till bristfälliga modeller. Jag uppskattar också att Fabrics pipelines låter dig versionshantera och iterera arbetsflöden för databeredning, så att du kan spåra exakt vilken konfiguration av datamängden som ledde till vilket modellresultat.
YDatas viktigaste funktioner
- Fabric SDK: Låter utvecklare generera och integrera syntetiska data i befintliga arbetsflöden med ett Python-baserat SDK.
- Laborationer på begäran: Startar konfigurerbara utvecklingsmiljöer med GPU-stöd, förladdade med populära datavetenskapliga bibliotek.
- Kodfri generering av syntetiska data: Genererar syntetiska datamängder via ett användargränssnitt utan att någon kod behöver skrivas, med ett arbetsflöde i fem klick.
- Driftsättning i flera moln: Driftsätter Fabric på AWS, Google Cloud Platform eller Microsoft Azure för att passa din befintliga infrastruktur.
YData-integrationer
YData Fabric erbjuder inbyggda anslutningar för AWS S3, Azure Blob Storage, Azure Data Lake, Google Cloud Storage, BigQuery, MySQL, Azure SQL Server, PostgreSQL, Snowflake och Oracle DB, samt anslutningar för Databricks Unity Catalog och Delta Lake. Det finns även ett API för anpassade integrationer.
Pros and Cons
Pros:
- Mäter automatiskt integritet, användbarhet och överensstämmelse
- Stöder villkorsstyrd och regelbaserad generering
- Erbjuder flera arkitekturer för generativa modeller
Cons:
- Begränsad anpassning för avancerade konfigurationer
- Fokuserar främst på tabulära datatyper


SAS Data Maker är en plattform för syntetisk datagenerering som kombinerar integritetsskyddande datasyntes, stöd för tidsserier och scenariosimulering för att skapa statistiskt representativa datamängder för AI-utveckling och testning.
Vem passar SAS Data Maker bäst för?
SAS Data Maker passar bra för data- och analysteam på banker, försäkringsbolag och finansiella institutioner som behöver dela eller testa med känsliga kunddata utan efterlevnadsrisk.
Varför jag valde SAS Data Maker
Jag valde SAS Data Maker som ett av de bästa alternativen eftersom dess arkitektur för differentiell integritet är särskilt utvecklad för reglerade branscher som bank och försäkring. Det jag tycker är övertygande är att plattformen inte bara genererar syntetiska data: den innehåller även spårning av dataursprung, granskningsloggar och väl underbyggda integritetsåtgärder, vilket är de specifika kontroller som finansteam behöver vid granskningar av efterlevnad.
Viktiga funktioner i SAS Data Maker
- Datagenerering med låg kod/utan kod: Skapa och generera syntetiska datamängder via ett klickbaserat användargränssnitt utan krav på skriptning.
- Visuella statistiska utvärderingsmått: Granska automatiserade kvalitets- och integritetspoäng för varje genererad datamängd via inbyggda instrumentpaneler.
- Utökning av obalanserade data: Generera ytterligare exempel för underrepresenterade klasser för att korrigera snedfördelningar före modellträning.
- Simulering av sällsynta händelser: Skapa realistiska syntetiska scenarier för händelser med låg frekvens, till exempel utrustningsfel eller bedrägerifall, där verkliga data är knapphändiga.
Integreringar med SAS Data Maker
SAS Data Maker är tillgängligt på Microsoft Azure via Microsoft Marketplace. Inbyggda integreringar listas för närvarande inte.
Pros and Cons
Pros:
- Utvecklat för AI-driven syntes av tabelldata med integritetsskydd
- Kan distribueras lokalt eller i ett privat moln
- Stöder sekventiella syntetiska data och syntetiska tidsseriedata
Cons:
- Längre bearbetningstider för stora datamängder
- Företagsfokuserat med begränsad tillgänglighet för små och medelstora företag

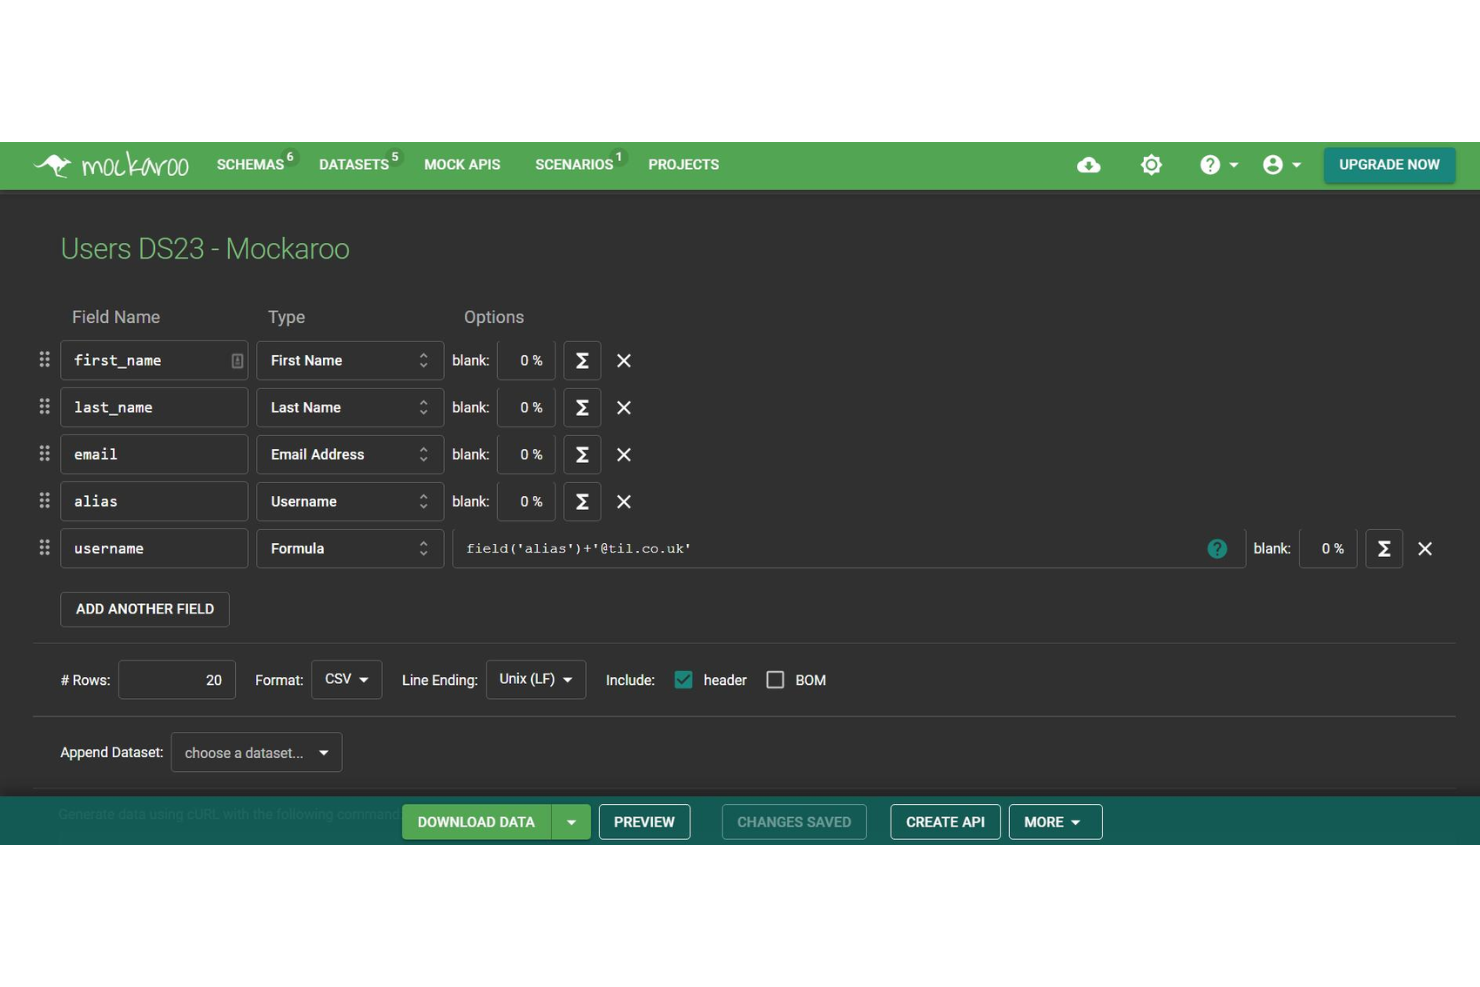
Mockaroo är en webbläsarbaserad syntetisk datagenerator som låter dig utforma anpassade scheman och exportera realistiska testdatauppsättningar i format som CSV, JSON, SQL och Excel.
För vem passar Mockaroo bäst?
Mockaroo passar naturligt för utvecklare, QA-ingenjörer och dataanalytiker som snabbt behöver realistiska testdatauppsättningar utan komplexa verktyg eller konfiguration.
Varför jag valde Mockaroo
Jag valde Mockaroo som ett av de bästa alternativen eftersom det verkligen är det snabbaste sättet jag har hittat för att gå från noll till en användbar datauppsättning. Du väljer bland över 180 realistiska datatyper, definierar ditt schema och laddar direkt ner upp till 1 000 rader utan någon konfigurationsbörda. Jag gillar också scenariofunktionen, som låter dig generera viktade och villkorsstyrda datauppsättningar som återspeglar verkliga fördelningar i stället för helt slumpmässiga värden.
Mockaroos viktigaste funktioner
- Designer för simulerade API:er: Bygg och konfigurera simulerade REST-API:er med anpassade URL:er, svarsdatainnehåll och felförhållanden direkt i Mockaroo.
- Härledning av schema: Ladda upp en befintlig CSV-, JSON- eller XML-fil så identifierar Mockaroo automatiskt strukturen och skapar ett matchande schema utifrån den.
- AI-genererade datatyper: Använd AI för att skapa anpassade datatyper inom valfritt ämnesområde när Mockaroos inbyggda typer inte täcker dina specifika fältkrav.
- REST-API-åtkomst: Spara scheman och hämta genererade data programmatiskt via en REST-URL, vilket möjliggör automatiserad datagenerering i skalskript eller pipelines.
Mockaroo-integrationer
Mockaroo har en anslutningsapp från en oberoende utgivare för Microsoft Power Automate, vilket låter dig hämta genererade data till arbetsflöden i Power Platform. Ett REST-API finns tillgängligt för anpassade integrationer, och Mockaroo finns även som en Docker-avbildning som du kan distribuera i ditt eget privata moln.
Pros and Cons
Pros:
- Stöder över 140 inbyggda realistiska datatyper
- Genererar data i flera utdataformat
- Ingen kodning krävs för att skapa datauppsättningar
Cons:
- Gratisnivån begränsar resultatet till 1 000 rader
- Saknar regelbaserade villkorade API-svar

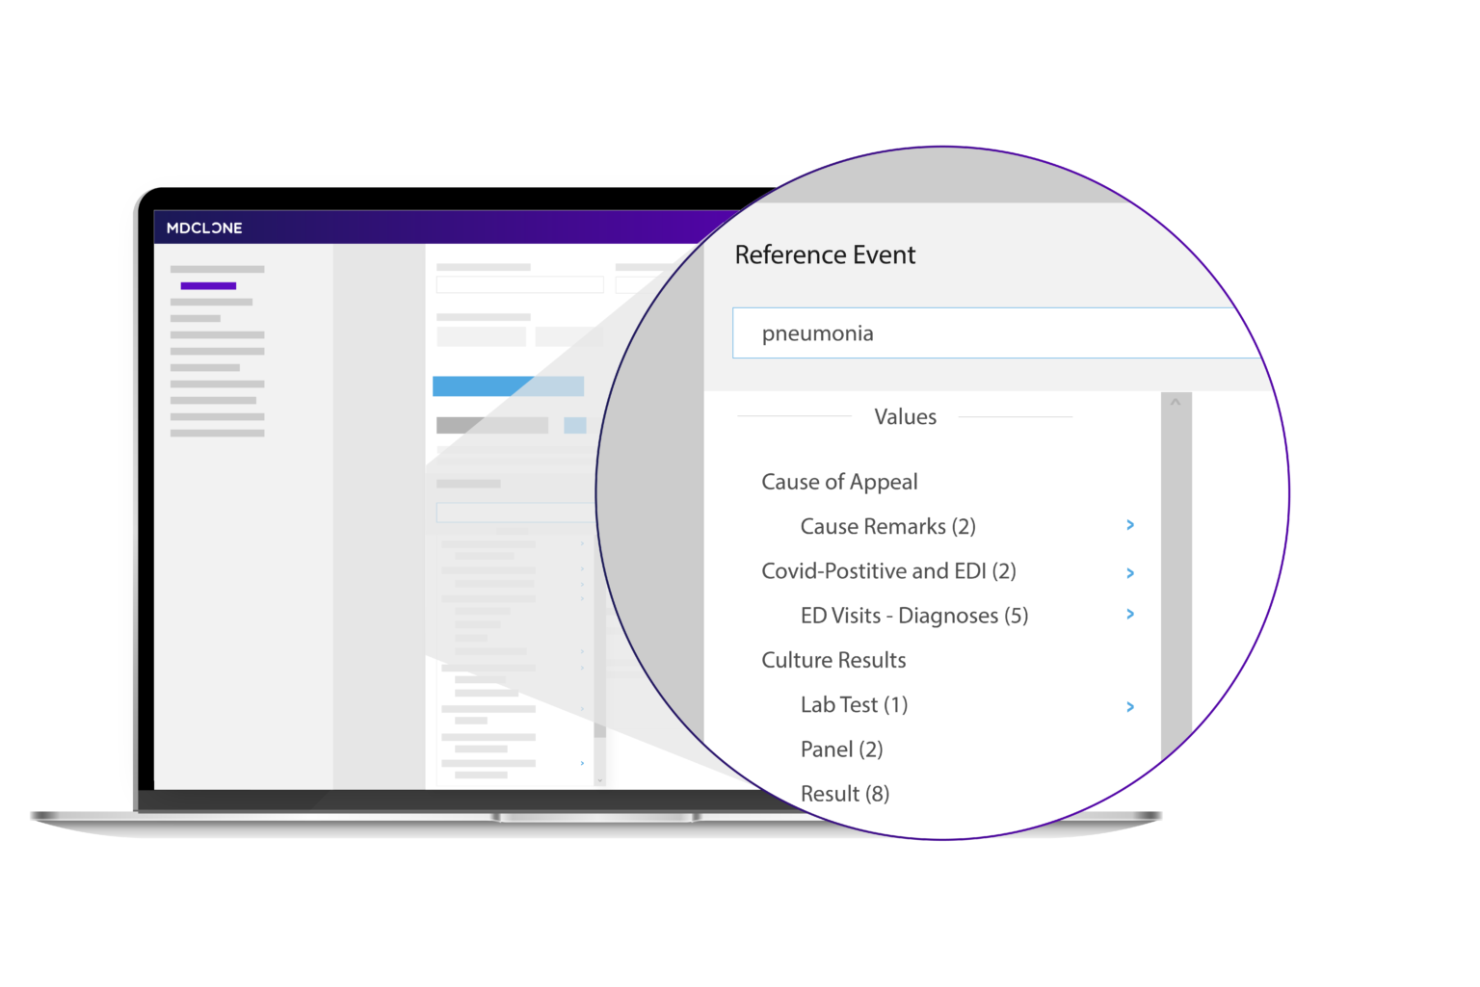
MDClone är en syntetisk dataplattform för hälso- och sjukvården, byggd kring sitt ADAMS-system, som genererar statistiskt korrekta, icke-reversibla kopior av verkliga patientdata för klinisk forskning, operativ analys och datadelning mellan organisationer.
Vem passar MDClone bäst för?
MDClone passar naturligt för vårdsystem, akademiska vårdcentrum och organisationer inom biovetenskap som arbetar med känsliga patientdata och behöver kompatibla syntetiska datamängder för forskning.
Varför jag valde MDClone
Jag valde MDClone som en av de bästa lösningarna eftersom det löser ett problem som de flesta generiska verktyg för syntetiska data inte kan lösa: att generera integritetssäkra kopior av verkliga patientdata utan någon risk för återidentifiering. Det är ADAMS-plattformen som jag tycker är särskilt övertygande här. Den låter forskare utforska syntetiska data direkt, förbi IRB-godkännandeprocessen, och sedan växla till originaldata med ett enda klick för att validera resultaten. Jag uppskattar också att den stöder datadelning mellan organisationer, så att kliniska team kan samarbeta med externa forskare världen över kring samma syntetiska datamängder.
Viktiga funktioner i MDClone
- Skapande av kohorter utan kod: Skapa patientkohorter med hjälp av filter, kategorier och händelsebaserade frågor utan programmeringskunskaper eller stöd från IT- eller datateam.
- Datainhämtning från flera källor: Hämta in och kombinera kliniska och icke-kliniska patientdata från flera källor, inklusive både strukturerade och ostrukturerade journaler, i en enda utforskningsmiljö.
- Visualisering av resultat: Jämför resultat, fastställ viktiga resultat och visualisera vårdluckor eller avvikelser för valfri händelse längs en patients vårdförlopp.
- Utforskning av data på egen hand: Kliniker och operativ personal kan självständigt söka i och utforska patientdata utan att vara beroende av mellanhänder eller dataanalytiker.
MDClone-integrationer
Inbyggda integrationer listas för närvarande inte. MDClones ADAMS-plattform ansluter till kliniska och icke-kliniska datakällor inom vårdsystem, inklusive EHR-system, skade- och ersättningsdatabaser samt administrativa register, men dessa fungerar som vägar för datainhämtning snarare än som traditionella programvaruintegrationer från tredje part.
Pros and Cons
Pros:
- Förhindrar helt återidentifiering av patientdata
- Forskare får tillgång till data utan tekniska mellanhänder
- Omedelbar växling mellan syntetiska data och originaldata
Cons:
- Plattformen kräver omfattande utbildning av slutanvändare
- Utformad uteslutande för användningsfall inom hälso- och sjukvården


Synthea, som har utvecklats av MITRE, är en syntetisk patientgenerator med öppen källkod som producerar fullständiga, kliniskt förankrade sjukdomshistoriker med hjälp av ett ramverk för sjukdomsmoduler och exporterar journaler i formaten HL7 FHIR, C-CDA och CSV.
Vem passar Synthea bäst för?
Synthea passar naturligt för akademiska forskare, team inom hälsoinformatik och utvecklare som behöver fritt tillgängliga syntetiska patientdata för modellering, algoritmträning eller systemtestning.
Varför jag valde Synthea
Synthea finns med på min kortlista eftersom dess arkitektur med sjukdomsmoduler genererar patientjournaler som återspeglar verkliga epidemiologiska mönster, inte slumpmässiga platshållare. Varje modul simulerar sjukdomsdebut, sjukdomsförlopp, läkemedel och kliniska möten under hela patientens livstid. Jag uppskattar att mitt team kan exportera direkt till HL7 FHIR R4 och mata in dessa journaler i testning av kliniskt beslutsstöd utan något mellanliggande omformateringssteg.
Syntheas viktigaste funktioner
- Generering i populationsskala: Generera tusentals syntetiska patienter i en enda körning, med konfigurerbar populationsstorlek och geografisk demografi.
- Export i flera format: Exporterar journaler i formaten C-CDA, CSV och CPCDS samt FHIR, vilket täcker en rad krav från efterföljande system.
- Anpassningsbara sjukdomsmoduler: Skriv eller ändra tillståndsmoduler med hjälp av en JSON-baserad tillståndsmaskin för att modellera specifika sjukdomar eller kliniska arbetsflöden.
- Reproducerbar datagenerering: Använd fasta slumpfrön för att återskapa identiska patientpopulationer, vilket möjliggör konsekventa testmiljöer.
Synthea-integreringar
Inbyggda integreringar listas för närvarande inte. Synthea är ett kommandoradsverktyg med öppen källkod som exporterar syntetiska patientdata i formaten HL7 FHIR (R4, STU3, DSTU2), Bulk FHIR (ndjson), C-CDA, CSV och CPCDS, som du sedan kan läsa in i valfri kompatibel FHIR-server eller hälso-IT-system.
Pros and Cons
Pros:
- Modellerar över 100 verkliga kliniska sjukdomsförlopp
- Helt öppen källkod utan licensavgifter
- Har inbyggt stöd för flera standarder för vårddata
Cons:
- Begränsat till data från hälso- och sjukvårdsdomänen
- Kräver Java och vana vid kommandoraden


NeMo Data Designer är NVIDIA:s ramverk för generering av syntetiska data som använder LLM-driven orkestrering, statistisk sampling och regelbaserad konfiguration för att producera strukturerade syntetiska dataset av hög kvalitet för träning och utvärdering av AI-modeller.
Vem passar NeMo Data Designer bäst för?
NeMo Data Designer passar bra för AI/ML-teknikteam som bygger och finjusterar LLM:er och agentbaserade system, särskilt team som behöver domänspecifika eller integritetssäkra träningsdata i stor skala.
Varför jag valde NeMo Data Designer
NeMo Data Designer är ett av mina främsta val eftersom jag uppskattar hur verktyget behandlar generering av syntetiska data som en utformad pipeline snarare än ett enstaka LLM-anrop — du konfigurerar kolumner, modeller och samplingslogik i förväg, förhandsgranskar sedan exempel och itererar innan du genererar hela datasetet i stor skala. Det som skiljer verktyget från mängden är att det erbjuder statistisk mångfald, fältkorrelationer, automatiserad validering och reproducerbara arbetsflöden, vilket råa instruktioner inte kan garantera. Dessutom kan genereringen initieras med dina egna verkliga dataset för att hålla resultaten i linje med faktiska produktionsmönster, vilket är mycket användbart för domänspecifika användningsområden.
Viktiga funktioner i NeMo Data Designer
- Kolumnbaserad konfiguration: Definiera samplingskolumner (t.ex. kategori och numeriska värden) och LLM-genererade kolumner tillsammans för att styra både datasetets struktur och innehåll.
- Stöd för startdata: Förankra syntetisk generering i befintliga verkliga data för att bevara mönster, fördelningar och domänsegenskaper.
- Multimodal generering: Generera och redigera inte bara text utan även bilder, med stöd för bild-till-bild-redigering och användning av bilder som kontext.
- Validerare och processorer: Tillämpa inbyggda validerings- och bearbetningssteg för att upptäcka kvalitetsproblem och säkerställa strukturerade resultat innan data färdigställs.
Integrationer med NeMo Data Designer
Data Designer ansluter till LLM-slutpunkter från NVIDIA, OpenAI och vLLM, med standardsupport för leverantörerna NVIDIA:s build.nvidia.com, OpenAI och OpenRouter. Det kan installeras som ett Python-bibliotek för anpassade pipelines eller distribueras som en NeMo-mikrotjänst i produktionsmiljöer, och har stöd för verktygsanvändning/MCP-integration i agentbaserade arbetsflöden.
Pros and Cons
Pros:
- Bevarar statistisk mångfald och fältkorrelationer
- Starkt stöd för multimodalitet och strukturerade resultat
- Öppen kärna med aktivt GitHub-arkiv
Cons:
- Kräver Python och teknisk konfiguration
- Inget alternativ med gränssnitt utan kod



Andra verktyg för generering av syntetiska data
Här är några ytterligare alternativ för verktyg för generering av syntetiska data som inte kom med på min kortlista, men som ändå är värda att undersöka:
- Betterdata
Bäst för syntetiska data från begränsade urval
- Synthetic Data Vault (SDV)
Bäst för utbyggbar modellering med öppen källkod
- Clearbox AI
Bäst för förklarbara AI-datapipelines


How I Evaluate Synthetic Data Generation Tools
I look at two layers: the baseline a tool must hit to handle real ML or QA workflows, and the differentiators—like conditional generation and privacy risk scoring—that separate vendors.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. Then, I calculate the tool's total score into a percentage. Each tool needs to achieve a minimum total score of 65% to be considered for inclusion.
- Synthetic data generation: I check whether the tool can produce artificial datasets across multiple data types, like tabular records for QA environments or time-series data for forecasting model training.
- Statistical fidelity controls: Preserving correlations and distributions matters, so I evaluate how well the tool replicates multivariate relationships from the source data in its output.
- Privacy preservation: I look for built-in techniques like differential privacy or k-anonymity that go beyond simple masking, especially for teams handling PII under GDPR or HIPAA.
- Multi-source data connectivity: The tool should connect to databases, warehouses, and cloud storage so teams can ingest reference data without manual file exports and reformatting.
- Referential integrity support: I evaluate how the tool handles primary and foreign key relationships across multi-table schemas, since broken references make synthetic datasets unusable for realistic testing.
- Data quality validation: Built-in fidelity and privacy reports help teams trust the output, so I look for utility scoring, distribution comparisons, and re-identification risk metrics.
Once I have a list of tools that meet this criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
Conditional generation is one of the first things I evaluate. Teams training fraud detection or anomaly models need to synthesize rare events on demand, and the tools that handle this well let you target specific attribute combinations without distorting the broader dataset. Privacy risk scoring also matters a lot here. I look for vendors that quantify re-identification risk and membership inference exposure per dataset, not just apply masking and call it done. Fidelity benchmarking ties directly into this—automated reports comparing correlations and ML utility scores between source and synthetic data help teams trust the output before it enters a pipeline.
Beyond Features
Deployment flexibility is a big differentiator. Teams in healthcare or financial services often can't send data to an external cloud, so I check whether a vendor supports on-premise, VPC, or air-gapped deployment. Compliance certifications matter just as much—SOC 2 Type II or ISO 27001 signal that the vendor's own security posture has been independently validated. I also evaluate how the tool fits into existing data pipelines, looking for native connectors to warehouses like Snowflake or BigQuery and Python SDK access for embedding generation directly into CI/CD or MLOps workflows.
Så väljer du verktyg för generering av syntetiska data
Det är lätt att fastna i långa funktionslistor och komplexa prismodeller. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för programvaruval kommer här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| Skalbarhet | Kan verktyget hantera dina förväntade datamängder, användarbelastning och pipelinevolym både nu och när efterfrågan ökar? |
| Integrationer | Erbjuder plattformen inbyggda anslutningar eller API:er för dina datalager, ML-pipelines, DevOps och molnstack? |
| Anpassningsbarhet | Hur mycket kontroll behöver du över datagenerering och integritetskonfiguration? Behöver du modelljustering, regler eller skript? |
| Användarvänlighet | Är användargränssnittet tillgängligt för både tekniska användare och verksamhetsanvändare, eller kommer utvecklarresurser alltid att krävas? |
| Implementering och introduktion | Hur snabbt kan ditt team komma igång? Krävs support från leverantören eller en partner för den inledande konfigurationen? |
| Kostnad | Hur förutsägbara är prisnivåerna i stor skala? Finns det dolda avgifter eller användningstoppar med stora datamängder? |
| Säkerhetsskydd | Vilka alternativ finns för lokal installation, VPC- eller luftgapsdistribution? Hur skyddar leverantören dina data? |
| Efterlevnadskrav | Behöver du stöd för GDPR, HIPAA, CCPA eller andra granskningar? Är dessa funktioner oberoende validerade eller certifierade? |
Vad är verktyg för generering av syntetiska data?
Verktyg för generering av syntetiska data är programvaruplattformar som skapar artificiella data som återspeglar strukturen, relationerna och de statistiska egenskaperna hos verkliga datamängder. Dessa verktyg använder tekniker som djupinlärning och generativa adversariella nätverk tillsammans med andra metoder för datagenerering för att skapa syntetiska data av hög kvalitet för maskininlärning, testning och analys. De hjälper organisationer att skydda dataintegriteten, bevara viktiga databeroenden och utveckla AI-modeller utan att exponera känslig eller reglerad information.
Funktioner i verktyg för generering av syntetiska data
När du väljer verktyg för generering av syntetiska data bör du hålla utkik efter följande viktiga funktioner:
- Stöd för datatyper: Möjlighet att generera syntetiska datamängder i olika format, inklusive tabellformat, tidsserier, text och bilder, för att stödja olika projektbehov.
- Kontroller för statistisk överensstämmelse: Bevarar underliggande fördelningar, korrelationer och relationer mellan datafält för mer realistiska och användbara datamängder.
- Integritetsskydd: Inbyggda metoder för att anonymisera och maskera känslig information, vilket hjälper team att uppfylla krav på integritet och efterlevnad.
- Anslutning till flera datakällor: Ansluter till databaser, datalager och fillagring, så att du enkelt kan importera referensdatamängder för modellering.
- Hantering av referensintegritet: Bevarar relationer mellan primärnycklar och främmande nycklar över flera tabeller, vilket är avgörande för att skapa giltiga datamängder med flera tabeller.
- Validering av datakvalitet: Erbjuder verktyg för att jämföra syntetiska data med ursprungliga datamängder, inklusive mått på användbarhet och likhet, för att bedöma datakvaliteten.
- Villkorsstyrd datagenerering: Låter användare rikta in sig på specifika attribut eller sällsynta händelser, vilket är idealiskt för att skapa data som återspeglar gränsfall eller obalanserade klasser.
- Automatisering och schemaläggning: Möjliggör återkommande datagenerering eller uppdateringar, vilket minskar manuella insatser och håller datamängderna aktuella.
- Åtkomsthantering: Stöder användarroller och behörigheter, så att administratörer kan styra vem som får generera, visa eller exportera datamängder.
Vanliga AI-funktioner i verktyg för generering av syntetiska data
Utöver de standardfunktioner i verktyg för generering av syntetiska data som anges ovan integrerar många av dessa lösningar AI med funktioner som:
- Generativ modellering: Använder avancerade AI-modeller som GAN eller VAE för att skapa mycket realistiska syntetiska data som återspeglar komplexa mönster i verkliga datamängder.
- Automatisk datamärkning: AI-algoritmer tilldelar automatiskt etiketter till genererade data, vilket effektiviserar skapandet av annoterade datamängder för övervakade maskininlärningsuppgifter.
- Adaptiv datasyntes: AI justerar dynamiskt genereringsparametrar baserat på återkoppling eller målfördelningar, vilket förbättrar de syntetiska datamängdernas kvalitet och relevans över tid.
- Simulering av avvikelser och sällsynta händelser: AI identifierar och återskapar sällsynta mönster eller avvikande värden, vilket gör det möjligt för team att stresstesta modeller och system mot gränsfall.
- Skapande av syntetisk text och syntetiska bilder: Använder modeller för naturlig språkbehandling och datorseende för att generera realistiska syntetiska dokument, bilder eller ostrukturerat innehåll för specialiserade användningsområden.
Fördelar med verktyg för generering av syntetiska data
Att implementera verktyg för generering av syntetiska data ger flera fördelar för ditt team och din verksamhet. Här är några av de fördelar du kan se fram emot:
- Minskad integritetsrisk: Team kan generera realistiska datamängder för utveckling eller träning utan att känslig personlig information exponeras eller delas.
- Snabbare åtkomst till data: Syntetiska data på begäran eliminerar flaskhalsar i samband med att produktionsdata ska säkras eller inväntas, vilket påskyndar projekttidsplanerna.
- Efterlevnad av regelverk: Inbyggda funktioner för integritet och anonymisering hjälper verksamheten att uppfylla krav som GDPR, HIPAA eller CCPA under analys och testning.
- Förbättrad modellprestanda: Syntetiska data kompletterar små eller obalanserade träningsdatamängder och bidrar till mer robusta och exakta maskininlärningsmodeller.
- Täckning av gränsfall: Villkorsstyrda genereringsfunktioner gör det möjligt att simulera sällsynta eller utmanande scenarier som kanske inte förekommer i verkliga data.
- Säkert samarbete: Syntetiska datamängder gör det möjligt för team eller partner att dela insikter och genomföra kvalitetssäkring utan att bryta mot krav på datahemvist eller konfidentialitet.
- Resurseffektivitet: Automatisering och integrationer förenklar tillhandahållandet av data, minskar manuellt arbete och frigör tekniska resurser för uppgifter med högre prioritet.
Kostnader och prissättning för verktyg för generering av syntetiska data
Att välja verktyg för generering av syntetiska data kräver en förståelse av de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar för verktyg för generering av syntetiska data:
Jämförelsetabell för abonnemang för verktyg för generering av syntetiska data
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisplan | $0 | Begränsat antal datarader, grundläggande integritetsverktyg, begränsad support och åtkomst till centrala genereringsfunktioner. |
| Personlig plan | $25-$75/månad | Utökade radgränser, ytterligare datatyper, enkla integrationer, personlig support och grundläggande rapporteringsverktyg. |
| Företagsplan | $200-$800/månad | Åtkomst för flera användare, samarbetskontroller, åtkomst till API och SDK, avancerad datavalidering och prioriterad support. |
| Plan för stora företag | $2,000-$10,000/månad | Anpassade distributionsalternativ, SSO och rollhantering, komplett integrationssvit, funktioner för regelefterlevnad och dedikerade tjänster. |
Vanliga frågor om verktyg för generering av syntetiska data
Här är några svar på vanliga frågor om verktyg för generering av syntetiska data:
Vilka branscher har störst nytta av verktyg för generering av syntetiska data?
Branscher som hälso- och sjukvård, finans, tillverkning och detaljhandel får störst nytta, eftersom dessa sektorer ofta hanterar känslig information och behöver säkra sätt att träna modeller, utveckla programvara eller dela data mellan team.
Kan syntetiska data användas för regelefterlevnad?
Ja, syntetiska data är ett effektivt sätt att uppfylla kraven i GDPR, HIPAA eller CCPA, eftersom de kan eliminera personliga identifierare och minska risken för att verkliga användardata exponeras under analys eller programvarutestning.
Hur exakta är syntetiska data jämfört med verkliga data?
Syntetiska data kan nära återspegla strukturen och de statistiska egenskaperna hos ursprungliga datamängder, särskilt vid användning av avancerade modelleringsmetoder, men team bör alltid validera kvaliteten för specifika användningsområden innan data tas i bruk.
Kräver generering av syntetiska data avancerade tekniska färdigheter?
De flesta verktyg erbjuder användarvänliga gränssnitt för att generera grundläggande datamängder, men anpassning av modeller eller hantering av komplexa behov kan kräva expertis inom datavetenskap eller teknik, särskilt vid villkorsstyrd generering och integritetskontroller.
Vilka är vanliga fallgropar vid implementering?
Några vanliga fallgropar är att underskatta den insats som krävs för integration, förbise risker för återidentifiering eller försumma att validera datans användbarhet för det avsedda användningsområdet, vilket kan leda till projektförseningar eller brister i regelefterlevnaden.