


Om ni har rullat ut AI-kodningsverktyg under det senaste året ser ni förmodligen samma sak som vi hör från utvecklingsteam överallt: verktygen fungerar. Funktioner levereras snabbare. Utvecklarna är mer produktiva. Resultatet är verkligen anmärkningsvärt.
Och ändå känns något fortfarande fastlåst. De ingenjörer som ni helst ville frigöra för svårare problem är överbelastade. Driftsättningar blottlägger en våg av buggar som tar dagar att arbeta igenom. Hastighetsvinsterna är verkliga, men de ackumuleras inte på det sätt de borde.
Det här är inte ett problem med AI-kodning. Det är ett tecken på att AI-kodning fungerar så bra att den har sprungit ifrån infrastrukturen runt omkring. AI-genererad kod ger ungefär 1,7 gånger fler fel än kod skriven av människor, och tiden för kodgranskning i branschen har ökat med 93 %. Genereringssidan av arbetsflödet har förändrats fullständigt. Verifieringssidan har inte hängt med.
Att överbrygga det gapet handlar inte om att sakta ner, utan om att bygga nästa lager av AI-infrastruktur som gör att team kan accelerera ytterligare.
Flaskhalsen har flyttats, men den har inte försvunnit
Det ursprungliga löftet med AI-kodning var enkelt: utvecklare lägger för mycket tid på att skriva standardkod. Låt AI:n hantera det, så kan ingenjörerna fokusera på svårare problem. Det fungerade. Men antagandet som var inbäddat i det löftet var felaktigt.
Antagandet var att det var en flaskhals att skriva kod. Det var det inte. Flaskhalsen var alltid hela cykeln: skriva, verifiera, driftsätta, upptäcka, felsöka, åtgärda, verifiera igen. AI accelererade en del av den loopen dramatiskt, samtidigt som resten lämnades orörd. Resultatet är ett eftersläpningproblem som ser annorlunda ut men i grunden är detsamma: ingenjörskapaciteten är begränsad, och begränsningen har helt enkelt flyttats nedströms.
Er kodningsagent kan skapa ett utkast till en funktion på några minuter. Men innan funktionen kan driftsättas måste någon fortfarande verifiera att den fungerar – inte bara i enhetstester, utan i hela systemet: databasfrågor, beteende hos tredjeparts-API:er, konfigurationstillstånd, behörighetslager och kantfall från verkliga användarmönster. Den personen är vanligtvis er mest erfarna ingenjör, och nu utför den personen mer av det här arbetet, inte mindre.
Och sedan driftsätts koden. Det som följer är en fas som de flesta tekniska ledare känner väl: en koncentrerad period av buggsökning när problem som var osynliga i granskningen visar sig under verkliga förhållanden. För varje två steg framåt upptäcker team att de tar ett steg tillbaka och släcker bränder orsakade av regressioner i stället för att bygga det som kommer härnäst. Lösningen är inte att sakta ner genereringssidan, utan att få verifieringssidan att komma ikapp.
Slutföra loopen
Svaret är att tillföra samma automatiseringslogik till verifieringen som redan finns på genereringssidan. Inte en AI-assistent som väntar på att en utvecklare ska be den skriva ett test. En autonom agent som verifierar kod kontinuerligt, i varje steg av livscykeln, utan att någon behöver uppmana den att starta.
Det är detta vi byggde Checksum för att göra. Checksum är en plattform för kontinuerlig kvalitet: ett lager som alltid är aktivt och körs parallellt med er CI/CD-pipeline och era kodningsagenter och som autonomt genererar, kör och underhåller tester, så att en pull request redan har körts mot realistiska produktionsförhållanden när den når en mänsklig granskare.
Det praktiska resultatet är att prompt-test-prompt-cykeln, som tar så mycket av ingenjörernas tid, antingen försvinner eller körs mellan maskiner. Era ingenjörer slutar vara verifieringslagret och återgår till att vara byggare.
Så fungerar det genom hela utvecklingslivscykeln
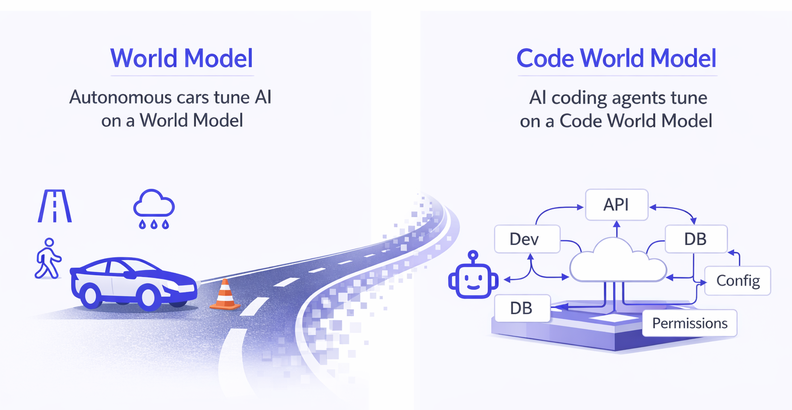
Checksums agenter bygger på det vi kallar kodvärldsmodellen: en simulering av den digitala miljö som er programvara faktiskt körs i. I stället för att testa kod isolerat tar den hänsyn till databastillstånd, API-beteenden, konfigurationsfiler, behörighetslager och verkliga användarinteraktionsmönster: hela den kontext som avgör om programvaran fungerar i produktion. Den grunden är det som gör agenterna nedan meningsfullt annorlunda än konventionella testverktyg.
Checksum täcker tre lager som tillsammans hanterar hela verifieringsgapet.
Testning från början till slut. E2E-agenten bygger en graf över hela er applikation, kartlägger varje skärm, interaktion och flöde och genererar produktionsklara Playwright-tester. Testerna finns i ert kodförråd som kod ni äger fullt ut, utan inlåsning hos leverantören. När ert användargränssnitt utvecklas läker agenten automatiskt de berörda testerna. Team som tidigare lade veckor på att bygga och underhålla testsviter får tillbaka den tiden.
CI-validering. CI-agenten genererar 50 till 200 riktade tester per pull request, specifika för den kod som ändrats. Den konfigurerar automatiskt den nödvändiga infrastrukturen, körs i er befintliga CI-pipeline med era befintliga ramverk och fångar logiska buggar som statisk analys missar helt. Varje PR körs innan den granskas.
API-täckning. API-agenten analyserar varje slutpunkt, parameter, rubrik och nyttolaststruktur i ert API och genererar tester som verifierar flöden från början till slut över flera system, inte bara om en slutpunkt returnerar 200. Ge den OpenAPI-specifikationer, Swagger-dokumentation eller fånga verkliga sessioner via SDK.
Alla tre agenter integreras direkt med Cursor, Claude Code och över hundra andra AI-kodningsverktyg via snedstreckskommandon. Er befintliga teknikstack förblir på plats, och verifieringen byggs in i loopen i stället för att läggas till i slutet.
Vad team som använder Checksum ser
Clearpoint Strategy utvecklar programvara för strategisk planering och rapportering för stora företag, en produktkategori där kompromisslös kvalitet vid lanseringar är ett måste. Deras utvecklingsteam hade fastnat i en välbekant fälla: testsviten kunde inte hålla jämna steg med utvecklingstakten, manuell validering fortsatte att falla på utvecklare som borde ha byggt vidare, och buggar nådde kunder som de inte hade råd att göra besvikna.
Genom samarbetet med Checksum gick de från en opålitlig testsvit till fler än 250 tester från början till slut på mindre än en månad, som alla körs automatiskt i deras befintliga arbetsflöde. När ändringar i användargränssnittet gjorde att tester gick sönder reparerade agenten dem utan att någon behövde skapa ett ärende. Teamet upptäcker nu sex kritiska buggar i veckan innan de lanseras och har återfått $500K per år som tidigare gick åt till kostnaderna för manuell testning.
Postilize är ett snabbväxande AI SaaS-företag, och under en period återspeglade deras lanseringsprocess det: lansera snabbt, åtgärda det som går sönder, upprepa. När plattformen blev mer komplex blev cykeln ohållbar. Varje steg framåt innebar ett steg tillbaka för att bekämpa regressioner, och det ständiga växlandet mellan arbete med nya funktioner och felkorrigering urholkade teamets förmåga att genomföra sin faktiska utvecklingsplan.
Efter implementeringen av Checksum testas varje ändringsförfrågan automatiskt innan den når produktion, och testsviten anpassas när nya funktioner lanseras i stället för att samla på sig teknisk skuld. Resultatet blev 70 % färre buggar och utvecklingscykler som körs 30 % snabbare, utan någon instabilitet i testerna. Att lansera till produktion varje dag gick från en ambition till en rutin.
Snabbare genom hela flödet
De team som drar ifrån just nu är inte de som började använda AI för kodning tidigast. Det är de som slöt flödet genom att kombinera snabb generering med automatiserad verifiering, så att vinsterna på den ena sidan förstärker varandra i stället för att skapa friktion på den andra.
AI-kodning har förändrat hur programvara skrivs. Kodvärldsmodellen förändrar hur den verifieras. Tillsammans gör de hela cykeln – från instruktion till produktion – till något som rör sig i den hastighet som AI alltid var tänkt att möjliggöra.
Se hur Checksum fungerar med din teknikstack på checksum.ai