A integração das capacidades de bases de dados vetoriais em bases de dados de código aberto amplamente utilizadas, como o PostgreSQL e o Apache Cassandra, representa um avanço significativo para a adoção da IA em ambientes empresariais.
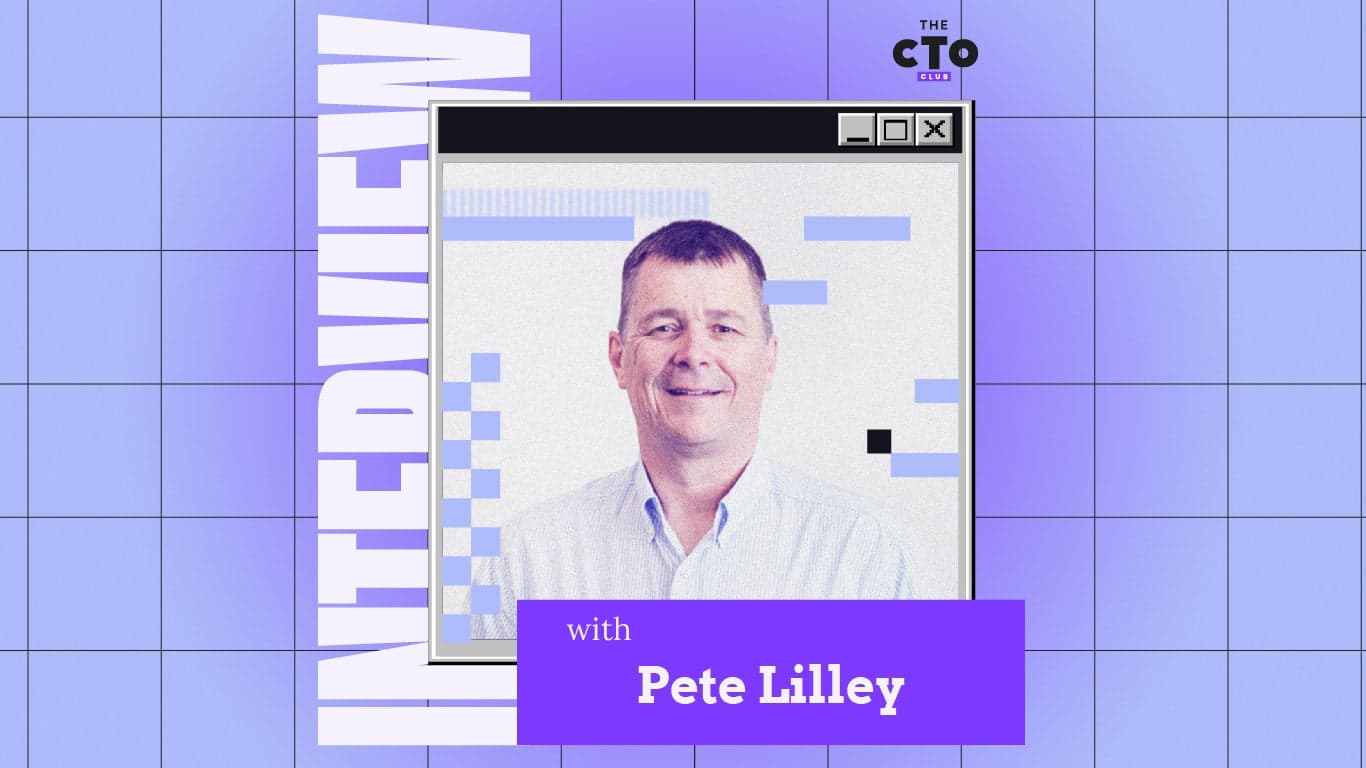
Pete Lilley, Vice-Presidente e Diretor-Geral da NetApp Instaclustr, traz para a discussão mais de 25 anos de experiência em serviços de TI e implementação de soluções. Com a sua profunda experiência em infraestruturas de dados escaláveis, Pete partilha informações sobre a forma como estes avanços de código aberto tornam a pesquisa vetorial e a Geração Aumentada por Recuperação (RAG) uma realidade prática e poderosa para empresas orientadas pela IA.
Estas tecnologias permitem aos CTO acelerar as iniciativas de IA, suportar um desempenho de nível empresarial e enfrentar as oportunidades e os desafios da incorporação de capacidades vetoriais nas infraestruturas de dados existentes.
- Como vê o impacto da integração de capacidades de bases de dados vetoriais em bases de dados de código aberto populares, como o PostgreSQL e o Apache Cassandra, na adoção de tecnologias de IA em ambientes empresariais?
A capacidade de tirar partido da pesquisa vetorial através de bases de dados de código aberto familiares, como o PostgreSQL (com a extensão pgvector), o novo Apache Cassandra 5.0 e o OpenSearch (como terceiro exemplo), significa um caminho mais fácil para implementar e escalar iniciativas empresariais de IA. Cada uma destas tecnologias totalmente de código aberto — tecnologias de código aberto que a maioria das empresas já possui como parte da sua pilha tecnológica — evoluiu e disponibiliza agora não apenas as capacidades de pesquisa vetorial de nível empresarial essenciais para permitir a precisão da IA, mas também a infraestrutura de dados subjacente necessária para garantir que os projetos de IA possam prosperar a longo prazo.
Os líderes tecnológicos compreendem que precisam de bases de dados vetoriais, mas muitos receiam adotar bases de dados vetoriais proprietárias e desenvolver competências à sua volta, uma vez que são dispendiosas e promovem a dependência do fornecedor. As alternativas totalmente de código aberto podem ser muito mais apelativas, tendo em conta a variedade de especialistas e serviços geridos disponíveis, bem como as comunidades de código aberto de apoio que envolvem cada um dos projetos anteriormente mencionados. Enquanto as bases de dados vetoriais proprietárias implicam custos iniciais e perda de flexibilidade, as bases de dados vetoriais de código aberto permitem às empresas começar imediatamente e avançar com os projetos de IA com maior confiança.
- Quais são algumas das vantagens específicas da implementação da Geração Aumentada por Recuperação (RAG) com bases de dados vetoriais de código aberto para casos de utilização de IA específicos de cada empresa?
Na ausência de uma arquitetura RAG e de pesquisa vetorial, os LLM empresariais têm de utilizar tecnologia tradicional de motores de pesquisa para tentar compreender as relações entre palavras-chave enquanto interpretam as consultas. O resultado é frequentemente ineficiência e falta de compreensão contextual — ou até uma incompreensão total do contexto da consulta, o que pode conduzir a alucinações da IA. Sem uma forma suficientemente sólida de compreender a intenção contextual da consulta de um utilizador, os projetos empresariais de IA ficam sujeitos a um desempenho fraco dos LLM e a resultados de baixa qualidade… quando não são simplesmente desastrosos e equivocados.
A pesquisa vetorial oferece um caminho mais eficaz para alcançar a compreensão contextual — especialmente quando apoiada pela utilização de RAG com armazenamentos de dados vetoriais. As bases de dados vetoriais armazenam vetores de incorporação que atribuem dados espaciais às palavras-chave sob a forma de conjuntos de coordenadas numéricas. Quanto mais próximos forem esses números, mais semelhantes serão os dois termos-chave. A pesquisa vetorial utiliza estas incorporações para concentrar as pesquisas em conjuntos limitados de dados mais relevantes para o contexto da consulta. Esse âmbito mais restrito permite tirar partido de vastos conjuntos de dados de forma mais eficiente. Isto reduz o risco de alucinações e proporciona simultaneamente um melhor desempenho.
- Quais são alguns dos principais desafios que os CTO podem enfrentar ao introduzir capacidades de bases de dados vetoriais na sua infraestrutura de dados existente e como podem preparar melhor as suas equipas para esta transição?
Os CTO devem antecipar uma curva de aprendizagem que as suas equipas terão de superar antes de uma base de dados vetorial proporcionar as operações e o desempenho eficientes em termos de custos que pretendem. O planeamento a longo prazo é essencial para garantir que as equipas recebem os recursos e o tempo necessários para implementar corretamente e otimizar continuamente a base de dados.
O cumprimento de práticas recomendadas específicas para os dados também influenciará fortemente os resultados dos projetos de IA. Estas devem incluir a utilização de dados de elevada qualidade, a divisão e incorporação corretas desses dados e a utilização de metadados e termos de pesquisa híbrida (combinando métodos de pesquisa tradicional e vetorial). Passar projetos de IA alimentados por LLM e pesquisa vetorial da fase de demonstração para uma produção de nível empresarial exige dedicação e esforço contínuo. Garantir a existência de profissionais experientes em funções de operações de bases de dados vetoriais e ciência de dados — ou dispor de conhecimentos especializados externos baseados em serviços geridos para prestar apoio — reduzirá a curva de aprendizagem e acelerará os projetos rumo à obtenção de resultados significativos.
- Como imagina o papel dos serviços geridos na ajuda às lideranças de TI para implementarem e otimizarem capacidades de bases de dados vetoriais, especialmente no caso de organizações com conhecimentos especializados internos limitados?
Os serviços geridos podem proporcionar às empresas uma via rápida para colocar a sua infraestrutura de dados inteligente em funcionamento e garantir que tudo é feito corretamente desde a primeira vez, mesmo sem especialistas internos. As empresas que utilizam tecnologias populares de código aberto, como PostgreSQL, Cassandra 5.0 ou OpenSearch, não terão dificuldade em encontrar serviços geridos prontos para ajudar a implementar e otimizar os seus projetos de IA, reduzindo simultaneamente alguns dos contratempos que as equipas inevitavelmente enfrentam enquanto se orientam.
- Olhando para o futuro, como pensa que irá evoluir o panorama das tecnologias de dados orientadas por IA e que medidas devem os CTO tomar agora para garantir que as suas organizações estão bem posicionadas para os desenvolvimentos futuros?
O aumento da procura por tecnologias de dados de IA mais performantes, flexíveis e capazes é praticamente garantido no futuro. Os CTO devem certamente analisar software de código aberto que já tenha demonstrado a sua fiabilidade, escalabilidade, segurança, eficiência e capacidade de se manter relevante ao nível empresarial no setor, e considerar de que forma essas opções podem ser utilizadas na infraestrutura de dados inteligente que suporta os seus projetos de IA. No final de contas, escolher as ferramentas certas para a camada de dados pode fazer toda a diferença quando se trata de alinhar a visão de IA da empresa com a realidade da IA empresarial.
O que se segue
À medida que as tecnologias orientadas por IA transformam a gestão e a análise de dados, a expansão das capacidades de pesquisa vetorial em bases de dados de código aberto, como PostgreSQL e Apache Cassandra, proporciona às empresas uma base acessível e poderosa para a inovação em IA.
Utilizar estas tecnologias com uma visão estratégica pode permitir às organizações expandir eficazmente a IA, minimizar os desafios comuns de implementação e garantir o alinhamento com os objetivos de IA a longo prazo.
Ao dar prioridade a opções de código aberto e a serviços geridos que suportem operações de bases de dados vetoriais, os CTO podem preparar a sua infraestrutura para o futuro e posicionar as suas organizações para tirarem partido da próxima vaga de avanços da IA na tecnologia de dados.
Subscreva a newsletter do The CTO Club para obter mais informações sobre código aberto.