


Hvis du har rullet ut AI-kodeverktøy det siste året, ser du sannsynligvis det samme som vi hører fra utviklingsteam overalt: Verktøyene fungerer. Funksjoner lanseres raskere. Utviklerne er mer produktive. Resultatet er virkelig bemerkelsesverdig.
Og likevel føles det som om noe fortsatt står fast. Ingeniørene du aller helst ville frigjøre til vanskeligere problemer, er strukket til bristepunktet. Distribueringer avdekker en bølge av feil som det tar flere dager å håndtere. Hastighetsgevinstene er reelle, men de bygger ikke videre på hverandre slik de burde.
Dette er ikke et problem med AI-koding. Det er et tegn på at AI-koding fungerer så godt at den har løpt fra infrastrukturen rundt seg. AI-generert kode produserer omtrent 1,7 ganger flere feil enn menneskeskrevet kode, og tiden som brukes på kodegjennomgang i bransjen har økt med 93 %. Genereringssiden av arbeidsflyten er blitt forvandlet. Verifiseringssiden har ikke holdt tritt.
Å lukke dette gapet handler ikke om å bremse ned, men om å bygge det neste laget med AI-infrastruktur som lar team akselerere ytterligere.
Flaskehalsen har flyttet seg, men den har ikke forsvunnet
Det opprinnelige løftet fra AI-koding var enkelt: Utviklere bruker for mye tid på å skrive standardkode. La AI håndtere det, så kan ingeniørene fokusere på vanskeligere problemer. Det fungerte. Men antakelsen som lå innbakt i dette løftet, var feil.
Antakelsen var at det å skrive kode var flaskehalsen. Det var det ikke. Flaskehalsen var alltid hele syklusen: skrive, verifisere, distribuere, oppdage, feilsøke, rette, verifisere på nytt. AI akselererte én del av denne syklusen dramatisk, mens resten forble urørt. Resultatet er et etterslepsproblem som ser annerledes ut, men som grunnleggende sett er det samme: Utviklingskapasiteten er begrenset, og begrensningen har ganske enkelt flyttet seg nedstrøms.
Den kodende agenten din kan utarbeide et utkast til en funksjon på minutter. Men før denne funksjonen lanseres, må noen fortsatt verifisere at den fungerer – ikke bare i enhetstester, men på tvers av hele systemet: databaseforespørsler, oppførsel i tredjeparts-API-er, konfigurasjonstilstand, tillatelseslag og spesialtilfeller fra reelle brukermønstre. Denne personen er vanligvis den mest erfarne ingeniøren din, og vedkommende gjør nå mer av dette arbeidet, ikke mindre.
Og så distribueres koden. Det som følger, er en fase de fleste utviklingsledere kjenner godt: en konsentrert periode med feiljakt når problemer som var usynlige under gjennomgangen, blir synlige under reelle forhold. For hvert skritt fremover opplever teamene at de må ta ett skritt tilbake og slukke branner forårsaket av regresjoner i stedet for å bygge det neste. Løsningen er ikke å bremse genereringssiden, men å få verifiseringssiden opp i fart.
Å fullføre syklusen
Svaret er å bruke den samme automatiseringslogikken på verifisering som allerede finnes på genereringssiden. Ikke en kopilot som venter på at en utvikler skal be den om å skrive en test. En autonom agent som verifiserer kode kontinuerlig, på hvert trinn i livssyklusen, uten at noen ber den om å starte.
Det er dette vi bygget Checksum for å gjøre. Checksum er en plattform for kontinuerlig kvalitet: et lag som alltid er på, og som fungerer parallelt med CI/CD-pipelinen og kodeagentene dine. Den genererer, kjører og vedlikeholder tester autonomt, slik at når en pull request når frem til en menneskelig gjennomgang, har den allerede blitt kjørt under realistiske produksjonsforhold.
Det praktiske resultatet er at prompt–test–prompt-syklusen som bruker så mye utviklingstid, enten forsvinner eller kjøres mellom maskiner. Ingeniørene dine slutter å være verifiseringslaget og går tilbake til å være byggere.
Want to learn more about Checksum?
Slik fungerer det gjennom hele utviklingslivssyklusen
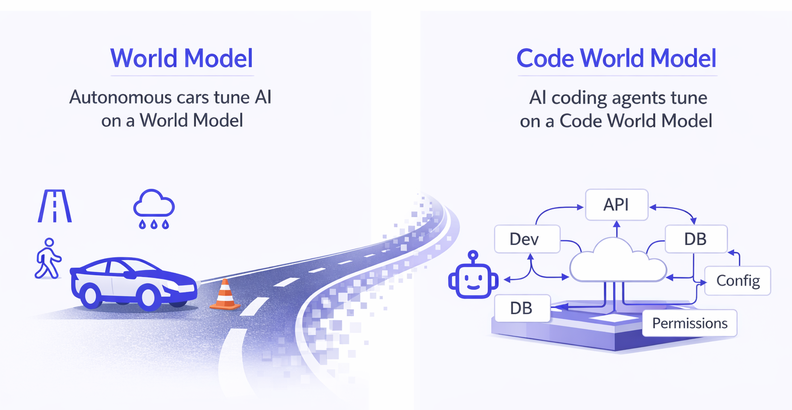
Checksum-agentene er bygget på det vi kaller Code World Model: en simulering av det digitale miljøet programvaren din faktisk kjører i. I stedet for å teste kode isolert tar den hensyn til databasetilstander, API-oppførsel, konfigurasjonsfiler, tillatelseslag og reelle brukerinteraksjonsmønstre: hele konteksten som avgjør om programvaren fungerer i produksjon. Dette fundamentet er det som gjør agentene nedenfor vesentlig annerledes enn konvensjonelle testverktøy.
Checksum dekker tre lag som til sammen håndterer hele verifiseringsgapet.
Testing fra ende til ende. E2E-agenten bygger en graf over hele applikasjonen din, kartlegger alle skjermer, interaksjoner og flyter, og genererer produksjonsklare Playwright-tester. Disse testene ligger i repositoriet ditt som kode du eier fullt ut, uten leverandørbinding. Når brukergrensesnittet ditt utvikler seg, reparerer agenten de berørte testene automatisk. Team som tidligere brukte uker på å bygge og vedlikeholde testserier, får tilbake denne tiden.
CI-validering. CI-agenten genererer 50 til 200 målrettede tester per pull request, spesifikke for koden som er endret. Den setter automatisk opp den nødvendige infrastrukturen, kjører i den eksisterende CI-pipelinen din ved hjelp av de eksisterende rammeverkene dine, og avdekker logiske feil som statisk analyse ikke fanger opp i det hele tatt. Hver PR kjøres før den gjennomgås.
API-dekning. API-agenten analyserer alle endepunkter, parametere, topptekster og nyttelaststrukturer i API-et ditt, og genererer tester som verifiserer flyter fra ende til ende på tvers av flere systemer – ikke bare om et endepunkt returnerer 200. Gi den OpenAPI-spesifikasjoner, Swagger-dokumentasjon, eller fang opp reelle økter via SDK.
Alle de tre agentene integreres direkte med Cursor, Claude Code og over hundre andre AI-kodeverktøy via skråstrekkommandoer. Den eksisterende stakken din forblir på plass, og verifisering bygges inn i syklusen i stedet for å bli lagt til på slutten.
Dette ser teamene som bruker Checksum
Clearpoint Strategy utvikler programvare for strategisk planlegging og rapportering for store virksomheter, en produktkategori der kvaliteten på utgivelser er ufravikelig. Ingeniørteamet deres hadde havnet i en velkjent felle: Testpakken klarte ikke å holde tritt med utviklingstempoet, manuell validering falt stadig på ingeniører som egentlig burde ha bygget, og feil nådde kunder de ikke hadde råd til å skuffe.
Ved å samarbeide med Checksum gikk de fra en upålitelig testpakke til mer enn 250 ende-til-ende-tester på under en måned, alle kjørende automatisk i den eksisterende leveringsprosessen. Når endringer i brukergrensesnittet ødela tester, reparerte agenten dem uten at noen opprettet en sak. Teamet oppdager nå seks kritiske feil per uke før de settes i produksjon, og har hentet inn igjen $500K årlig som tidligere gikk med til kostnader forbundet med manuell testing.
Postilize er et raskt voksende AI-SaaS-selskap, og en stund gjenspeilte lanseringsprosessen deres dette: lever raskt, fiks det som går galt, og gjenta. Etter hvert som plattformen ble mer kompleks, ble syklusen uholdbar. Hvert andre skritt fremover innebar et skritt tilbake for å håndtere regresjoner, og det konstante kontekstskiftet mellom arbeid med nye funksjoner og opprydding i feil svekket teamets evne til å gjennomføre det faktiske veikartet.
Etter implementeringen av Checksum blir hver kodeforespørsel automatisk testet før den når produksjon, og testpakken tilpasser seg når nye funksjoner lanseres, i stedet for å samle opp teknisk gjeld. Resultatet var 70 % færre feil og utviklingssykluser som går 30 % raskere, uten ustabile tester. Daglige lanseringer til produksjon gikk fra å være en ambisjon til å bli en rutine.
Få fart på hele kretsløpet
Teamene som ligger foran akkurat nå, er ikke de som tok i bruk AI-koding først. Det er de som lukket kretsløpet ved å kombinere rask generering med automatisert verifisering, slik at gevinstene på den ene siden forsterkes i stedet for å skape friksjon på den andre.
AI-koding har endret hvordan programvare blir skrevet. Code World Model endrer hvordan den blir verifisert. Sammen gjør de hele syklusen – fra instruksjon til produksjon – til noe som beveger seg i tempoet AI alltid skulle muliggjøre.
Se hvordan Checksum fungerer med teknologistakken din på checksum.ai


